第一章.大数据概论
1.大数据概念
大数据(Big Data) : 指无法在一定时间范围内用常规软件工具进行捕捉,管理和处理的数据集合,是需要新处理模式才能具有更强的决策力,洞察发现力和流程优化能力的海量,高增长率和多样化的信息资产
主要解决海量数据的存储和海量数据的分析计算问题
按顺序给出数据存储单位: bit,Byte,KB,MB,GB,TB,PB,EB
2.大数据特点
/*1.volume(大量)2.velocity(高速)3.variety(多样)4.value(低价值密度)/
3.大数据应用场景
- 物流仓储:大数据分析系统助力商家精细化经营,提升销量,节约成本.京东物流:上午下单下午送达,下午下单次日上午送达
- 零售:分析用户消费习惯,为用户购买商品提供方便,从而提升商品销量
- 旅游:深度结合大数据能力与旅游行业需求,共建旅游产业智慧管理,智慧服务和智慧营销的未来
- 商品广告推荐:给用户推荐可能喜欢的商品
- 保险:海量数据挖掘及风险预测,助力保险行业精准营销,提升精细化定价能力
- 金融:多维度体现用户特征,帮助金融机构推荐优质客户,防范欺诈风险
- 房产:大数据全面助力房地产行业,打造精准投策与营销,选出更合适的地,建造更合适的楼,卖给更合适的人
- 人工智能
第二章.Hadoop介绍
1.Hadoop是什么
- Hadoop是一个由Apache基金会所开发的分布式系统基础架构
- 主要解决海量数据的存储和分析计算问题
- 广义上来讲,Hadoop通常是指一个更广泛的概念—Hadoop生态圈
- 官网: http://hadoop.apache.org/
2.Hadoop三大发行版本
- Apache Hadoop:最原始(最基础)的版本,对于入门学习最好
- 官网地址: http://hadoop.apache.org/releases.html
- 下载地址: https://archive.apache.org/dist/hadoop/common/
- Cloudera Hadoop:内部集成了很多大数据框架,对应产品CDH
- 官网地址: https://www.cloudera.com/downloads/cdh/5-10-0.html
- 下载地址: http://archive-primary.cloudera.com/cdh5/cdh/5/
- Hortonworks:文档较好,对应产品HDP
- 官网地址: https://hortonworks.com/products/data-center/hdp/
- 下载地址: https://hortonworks.com/downloads/#data-platform
3.Hadoop的优势
- 高可靠性: Hadoop底层维护多个数据副本,所以即使Hadoop某个计算元素或存储出现故障,也不会导致数据的丢失
- 高扩展性:在集群间分配任务数据,可方便的扩展数以千计的节点
- 高效性:在MapReduce的思想下,Hadoop是并行工作的,以加快任务处理速度
- 高容错性:能够自动将失败的任务重新分配
4.Hadoop的组成
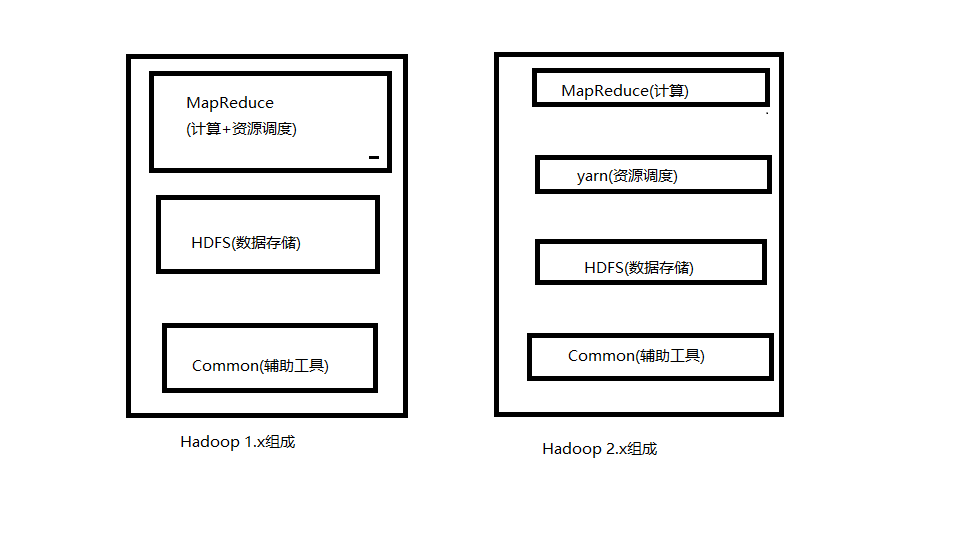
/*在Hadoop1.x 时代,Hadoop中的MapReduce同时处理业务逻辑运算和资源的调度,耦合性较大在Hadoop2.x时代,增加了Yarn,Yarn只负责资源的调度,MapReduce只负责运算/
4.1.HDFS架构概述
- NameNode: 存储文件的元数据,如文件名,文件目录结构,文件属性(生成时间,副本数,文件权限),以及每个文件的块列表和块所在的DateNode等
- DateNode:在本地文件系统存储文件块数据,以及块数据的校验和
- SecondaryNameNode:每隔一段时间对NameNode元数据备份
4.2.Yarn架构概述

- ResourceManager(RM)主要作用如下:
- 处理客户端请求
- 监控NodeManager
- 启动或监控ApplicationMaster
- 资源的分配与调度
- NodeManager(NM)主要作用如下
- 管理单个节点上的资源
- 处理来自ResourceManager的命令
- 处理来自ApplicationMaster的命令
- ApplicationMaster(AM)作用如下
- 负责数据的切分
- 为应用程序申请资源并分配给内部的任务
- 任务的监控与容错
- Container
Container是YARN中的资源抽象,它封装了某个节点上的多维度资源,如内存,CPU,磁盘网络等
4.3.Mapreduce架构概述
MapReduce将计算过程分为两个阶段:Map和Reduce
- Map阶段并行处理输入数据
- Reduce阶段对Map结果进行汇总

第三章.Hadoop运行环境搭建
1.虚拟机环境准备
- 先安装一台虚拟机(最小化安装)
配置ip地址
vi /etc/sysconfig/network-scripts/ifcfg-ens33
将BOOTPROTO=dhcp 修改成BOOTPROTO=static将ONBOOT=no修改成ONBOOT=yes添加IPADDR=192.168.1 or 10(根据自己的设置).102GATEWAY=192.168.1 or 10(根据自己的设置).2DNS1=114.114.114.114注意!!!!!!!单词别写错
systemctl restart network
检查是否和Windows可以通信,如果可以使用xshell连接
安装插件
yum install -y epel-release psmisc nc net-tools rsync vim lrzsz ntp libzstd openssl-static tree iotop git
修改hostname中的值,修改成hadoop001
vi /etc/hostname
修改hosts文件(linux)
vim /etc/hosts
#添加如下内容
192.168.10.102 hadoop102
192.168.10.103 hadoop103
192.168.10.104 hadoop104
192.168.10.105 hadoop105
192.168.10.106 hadoop106
修改hosts文件(Windows)
C:\Windows\System32\drivers\etc#添加如下内容 192.168.10.102 hadoop102 192.168.10.103 hadoop103 192.168.10.104 hadoop104 192.168.10.105 hadoop105 192.168.10.106 hadoop106添加用户
useradd atguigu #添加用户
passwd atguigu #设置密码(321074)
让atguigu可以借用root权限
(1)终端输入visudo
(2)搜索"/root"并在下面添加如下内容
atguigu ALL=(ALL)       NOPASSWD:ALL
在opt下创建两个目录
mkdir /opt/software  #后面用来存放需要的软件包
mkdir /opt/module   #后面用来存放需要使用的软件
将/opt/module和/opt/software的所属主和所属组全改成atguigu
chown atguigu:atguigu /opt/module
chown atguigu:atguigu /opt/software
将防火墙关掉
systemctl stop firewalld  #关掉防火墙
systemctl disable firewalld #禁止开机自启
重新用xshell进行连接,用atguigu登录
2.安装JDK和Hadoop
卸载原有JDK(没有可忽略)
rpm -qa | grep -i java | xargs -n1 sudo rpm -e --nodeps用文件上传工具(Xftp)将JDK和Hadoop的压缩文件导入到opt目录下的software文件夹下面

分别将JDK和Hadoop的压缩文件解压到/opt/module目录下
tar -zxvf jdk-8u212-linux-x64.tar.gz -C /opt/module/
tar -zxvf hadoop-3.1.3.tar.gz -C /opt/module/
配置环境变量
#1.新建/etc/profile.d/my_env.sh文件
sudo vim /etc/profile.d/my_env.sh
#2.添加如下内容
#JAVA_HOME
export JAVA_HOME=/opt/module/jdk1.8.0_212
#HADOOP_HOME
export HADOOP_HOME=/opt/module/hadoop-3.1.3
export PATH=$PATH:$JAVA_HOME/bin
export PATH=$PATH:$HADOOP_HOME/bin
export PATH=$PATH:$HADOOP_HOME/sbin
保存后退出 :wq
让修改后的文件生效
source /etc/profile.d/my_env.sh测试安装是否成功
java -version
hadoop version

若有收获,就点个赞吧
0 人点赞


