第一章.kafka概述
1.定义
- Kafka是一个分布式的基于发布/订阅模式的消息队列,主要应用于大数据实时处理领域- Kafka是一个开源的分布式事件流平台,被数千家公司用于高性能数据管道,流分析.数据集成和关键任务应用
2.消息队列
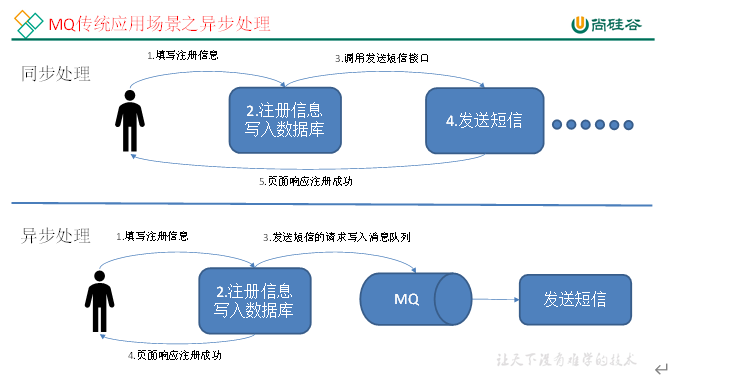
# 使用消息队列的好处1. 解耦:允许你独立的扩展或修改两边的处理过程,只要确保他们遵守同样的接口约束2. 可恢复性: 系统的一部分组件失效时,不会影响到整个系统,消息队列降低了进程之间的耦合度,所以即使一个处理消息的进程挂掉,加入队列中的消息仍然可以在系统恢复后被处理3. 缓冲: 有助于控制和优化数据流经过系统的速度,解决生产消息和消费消息的处理速度不一致的情况4. 灵活性&峰值处理能力: 在访问量剧增的情况下,应用仍然需要继续发挥作用,但是这样的突发流量并不常见,如果为以能处理这类峰值访问为标准来投入资源随时待命无疑是巨大的浪费,使用消息队列能够使关键组件顶住突发的访问能力,而不会因为突发的超负荷的请求而完全崩溃5. 异步通信: 很多时候,用户不想也不需要立即处理消息,消息队列提供了异步处理机制,允许用户把一个消息放入队列,但并不立即处理它,想让队列中放入多少消息就放多少,然后在需要的时候再去处理他们
# 消息队列的两种模式1. 点对点模式(一对一,消费者主动拉取数据,消息收到后消息清除)2. 发布订阅模式(一对多,消费者消费数据之后不会清除消息)
Kafka基础架构
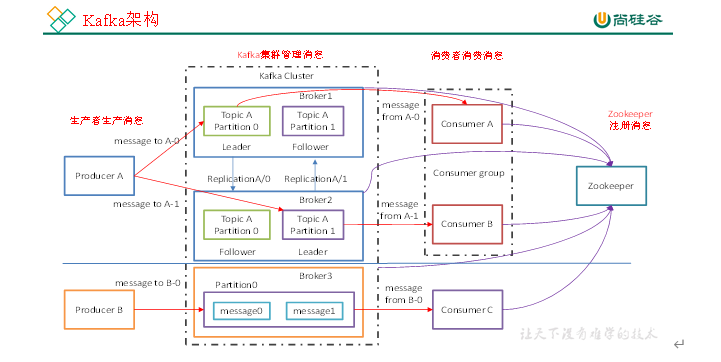
- Producer: 消息生产者,就是向Kafka broker 发消息的客户端- Consumer: 消息消费者,向kafka broker 取消息的客户端- Consumer Group(CG) : 消费者组,由多个consumer组成,消费者组内每个消费者负责消费不同分区的数据,一个分区只能由一个组内消费者消费,消费者组之间互不影响,所有的消费者都属于某个消费者组,,即消费者组是逻辑上的一个订阅者- Broker: 一台Kafka服务器就是一个broker,一个集群由多个broker组成,一个broker可以容纳多个topic- Topic: 可以理解为一个队列,生产者和消费者面向的都是一个Topic- Partition: 为了实现扩展性,一个非常大的topic可以分布在多个broker(服务器)上,一个topic可以分为多个partition,每个partition是一个有序的队列- Replica: 副本,为保证集群中某个节点发生故障时,该节点上的partition数据不丢失,且Kafka仍然能够继续工作,Kafka提供了副本机制,一个topic的每个分区都有若干个副本,一个leader和若干个follower- leader: 每个分区中多个副本的"主",生产者发送数据的对象,以及消费者消费数据的对象都是leader- follower: 每个分区多个副本的"从",实时从leader中同步数据,保持和leader数据的同步,leader发生故障时,某个follower会成为新的leader
第二章.Kafka快速入门
1.集群规划
| hadoop102 | hadoop103 | hadoop104 |
|---|---|---|
| zookeeper | zookeeper | zookeeper |
| kafka | kafka | kafka |
2.集群部署
- 上传压缩包到linux上并解压
tar -zxvf kafka_2.11-2.4.1.tgz -C /opt/module
- 修改解压后的文件名称
mv kafka_2.11-2.4.1 kafka-2.4.1
- 修改配置文件
cd config/sudo vim server.properties# 修改以下内容#broker的全局唯一编号,不能重复broker.id=2#kafka运行日志(数据)存放的路径log.dirs=/opt/module/kafka-2.4.1/datas#配置连接Zookeeper集群地址zookeeper.connect=hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka
- 配置环境变量
sudo vim /etc/profile.d/my_env.sh
# KAFKA_HOMEexport KAFKA_HOME=/opt/module/kafka-2.4.1export PATH=$PATH:$KAFKA_HOME/bin
xsync kafka-2.4.1
- 分别在hadoop103和hadoop104上修改配置文件 server.properties
# hadoop103broker.id = 3# hadoop104broker.id = 4
- 启动集群
1. 先启动Zookeeper集群(脚本启动)zkCluster.sh start2. 依次在hadoop102,hadoop103,hadoop104节点上启动Kafka[atguigu@hadoop102 kafka-2.4.1]$ bin/kafka-server-start.sh -daemon config/server.properties[atguigu@hadoop103 kafka-2.4.1]$ bin/kafka-server-start.sh -daemon config/server.properties[atguigu@hadoop104 kafka-2.4.1]$ bin/kafka-server-start.sh -daemon config/server.properties3. 关闭集群[atguigu@hadoop102 kafka-2.4.1]$ bin/kafka-server-stop.sh stop[atguigu@hadoop103 kafka-2.4.1]$ bin/kafka-server-stop.sh stop[atguigu@hadoop104 kafka-2.4.1]$ bin/kafka-server-stop.sh stop
- Kafka群起脚本(kafka.sh)
#! /bin/bashif (($#==0)); thenecho -e "请输入参数:\n start 启动kafka集群;\n stop 停止kafka集群;\n" && exitficase $1 in"start")for host in hadoop103 hadoop102 hadoop104doecho "---------- $1 $host 的kafka ----------"ssh $host "/opt/module/kafka-2.4.1/bin/kafka-server-start.sh -daemon /opt/module/kafka-2.4.1/config/server.properties"done;;"stop")for host in hadoop103 hadoop102 hadoop104doecho "---------- $1 $host 的kafka ----------"ssh $host "/opt/module/kafka-2.4.1/bin/kafka-server-stop.sh /opt/module/kafka-2.4.1/config/server.properties"done;;*)echo -e "---------- 请输入正确的参数 ----------\n"echo -e "start 启动kafka集群;\n stop 停止kafka集群;\n" && exit;;esac
添加可执行权限
chmod +x kafka.sh
3.Kafka命令行操作
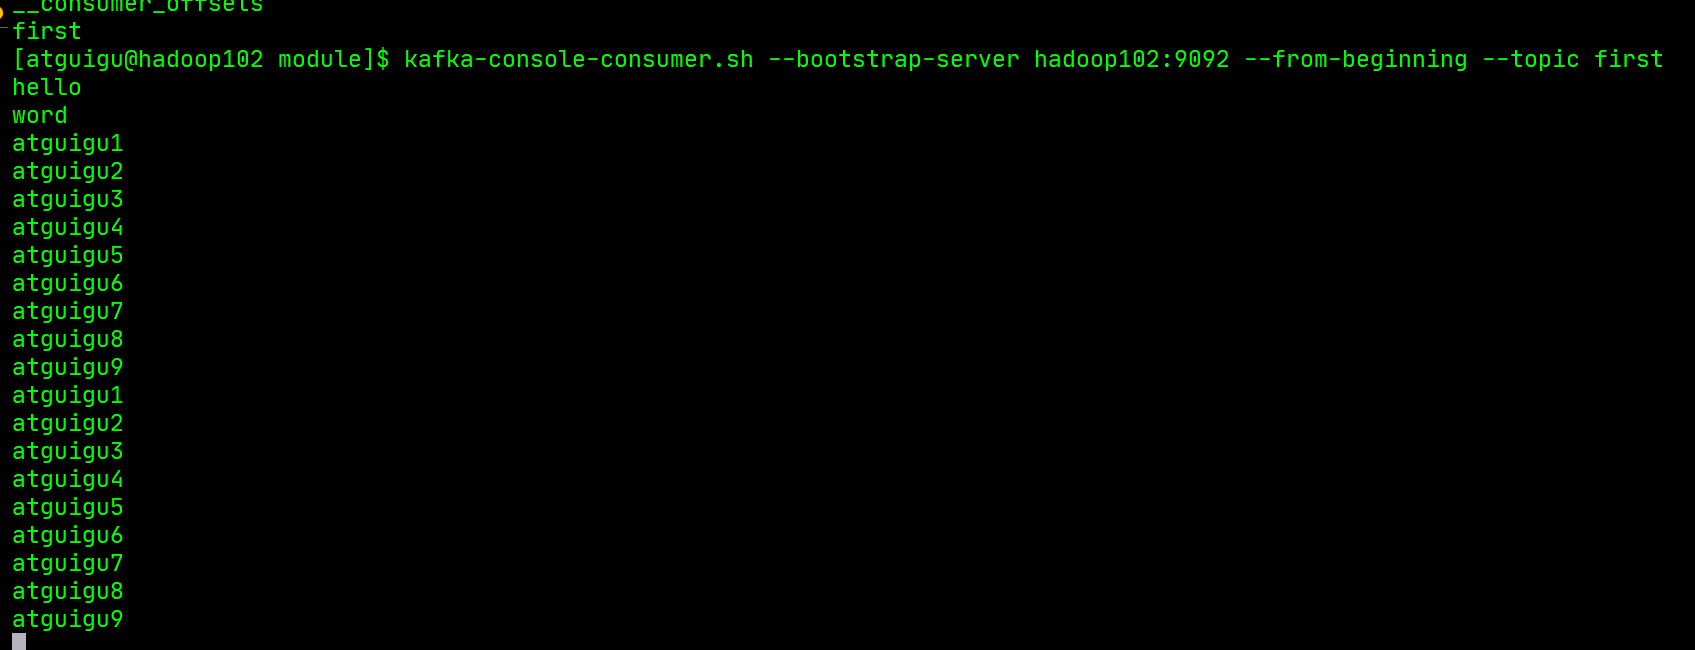
# 查看当前服务器中的所有topickafka-topics.sh --zookeeper hadoop102:2181/kafka --listkafka-topics.sh --bootstrap-server hadoop102:9092 --list# 创建topickafka-topics.sh --bootstrap-server hadoop102:9092 --create --replication-factor 2 --partitions 1 --topic atguigu# 删除topickafka-topics.sh --bootstrap-server hadoop102:9092 --delete --topic atguigu# 发送消息kafka-console-producer.sh --broker-list hadoop102:9092 --topic first# 消费消息kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --from-beginning --topic first# 查看某个Topic的详情kafka-topics.sh --bootstrap-server hadoop102:9092 --describe --topic first# 修改分区数kafka-topics.sh --bootstrap-server hadoop102:9092 --alter –-topic first --partitions 3
第三章.Kafka架构深入
1.kafka工作流程及文件存储机制
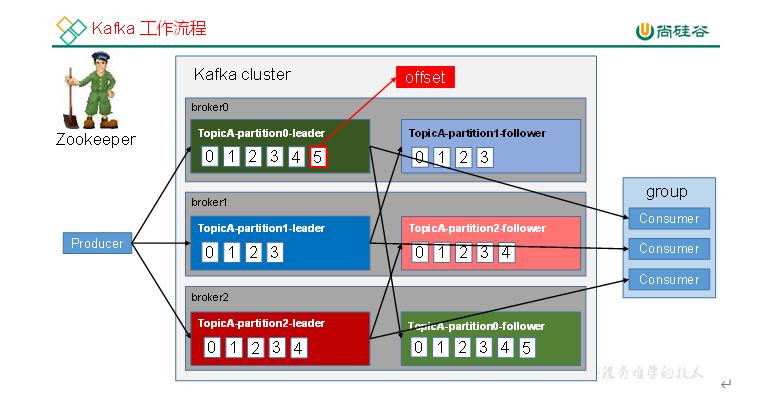
- kafka中消息是以topic进行分类的,生产者生产消息,消费者消费消息,都是面向topic的- 一个topic下的每一个分区都单独维护一个offset,所以分发到不同分区中的数据是不同的数据,消费者的分区维护是一个消费者组一个主题的一个分区维护一个offset- topic是逻辑上的概念,而partition是物理上的概念,每个partition对应于一个log文件,该log文件中存储的就是producer生产的数据,Producer生产的数据会被不断追加到该log文件末端,且每条数据都有自己的offect,消费者组中的每一个消费者,都会实时记录自己消费到了哪个offset,以便出错恢复时,从上次的位置继续消费
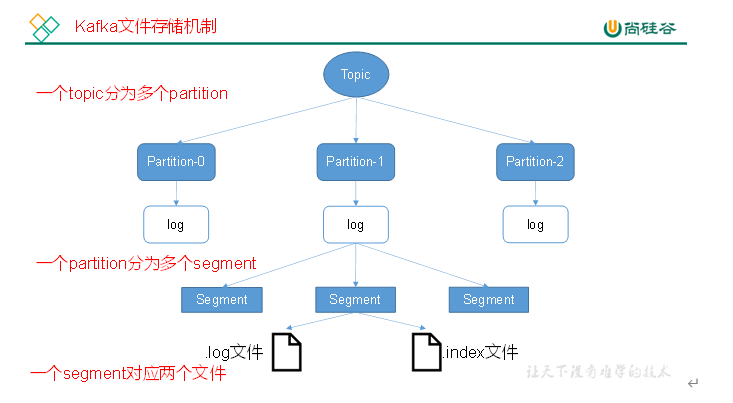
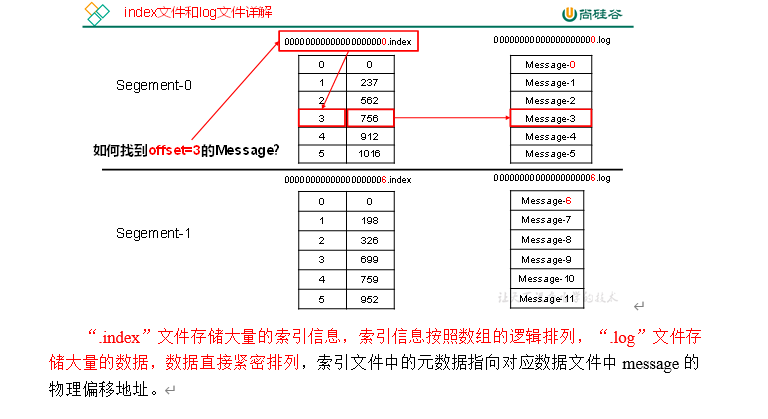
由于生产者生产的消息会不断追加到log文件末尾,为防止log文件过大导致数据定位效率低下,Kafka采取了分片和索引机制,将每个partition分为多个segment,每个segent对应两个文件--.index文件和.log文件,这些文件位于一个文件夹下,该文件夹的命名规则是:topic 名称 + 分区序号,例如,first这个topic有三个分区,则其对应的文件夹为first-0,first-1,first-2
00000000000000000000.index00000000000000000000.log00000000000000170410.index00000000000000170410.log00000000000000239430.index00000000000000239430.log
index和log文件以当前segment的第一条消息的offset命名,下图为index文件和log文件的结构示意图图
2.kafka生产者
2.1消息发送流程
kafka的Producer发送消息采用的是异步发送的方式,在消息发送的过程中,涉及到了两个线程--main线程和Sender线程,以及一个线程共享变量--RecordAccumulator,main线程将消息发送给RecordAccumulator,Sender线程不断从RecordAccumulator中拉取消息发送到Kafka broker
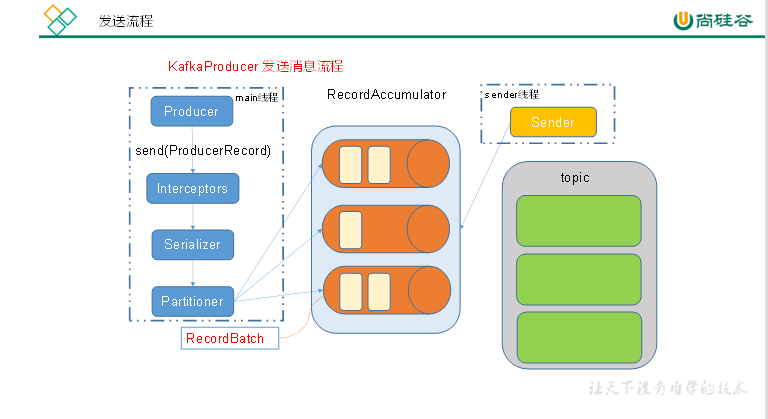
# 相关参数batch.size:只有数据积累到batch.size之后,sender才会发送数据linger.ms:如果数据迟迟未达到batch.size,sender等待linger.time之后就会发送数据
2.2生产者-简单的生产者
- 新建一个maven工程,并导入依赖
<dependencies><dependency><groupId>org.apache.kafka</groupId><artifactId>kafka-clients</artifactId><version>2.4.1</version></dependency></dependencies>
- 编写代码
需要用到的类:
- KafkaProducer : 需要创建一个生产者对象,用来发送数据
- ProducerConfig : 获取所需的一系列配置参数
- ProducerRecord: 每条数据都要封装成一个ProducerRecord对象
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.KafkaProducer;import org.apache.kafka.clients.producer.ProducerConfig;import org.apache.kafka.clients.producer.ProducerRecord;import java.util.Properties;import java.util.concurrent.TimeUnit;public class CustomProducer {public static void main(String[] args) {//1.创建kafka生产者的配置对象Properties properties = new Properties();//2.给kafka配置对象添加配置信息properties.put("bootstrap.servers","hadoop102:9092");properties.put(ProducerConfig.BATCH_SIZE_CONFIG,16384);properties.put(ProducerConfig.LINGER_MS_CONFIG,10);properties.put(ProducerConfig.BUFFER_MEMORY_CONFIG,33554432);//key,value序列化properties.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,"org.apache.kafka.common.serialization.StringSerializer");properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");//初始化生产者KafkaProducer<String, String> producer = new KafkaProducer<>(properties);ProducerRecord<String,String> producerRecord = null;for(int i =1;i<10;i++){//将数据包装为ProducerRecordproducerRecord = new ProducerRecord<String,String>("first",0,"aa" + i,"atguigu" + i);//发送数据producer.send(producerRecord);}try{TimeUnit.SECONDS.sleep(1);}catch(Exception e){e.printStackTrace();}}}

若有收获,就点个赞吧
0 人点赞


