第一章.函数
1.系统内置函数
# 查看系统自带的函数show function;# 显示自带函数的用法desc function upper;# 详细显示自带的函数用法desc function extended upper;
# 常用内置函数NVL :给值为null的数据赋值语法格式 : NVL(value,default_value)# 案例select NVL(null,1);
# case when then else end# 案例
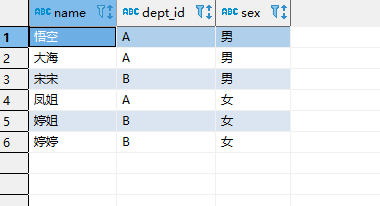
需求: 求出不同部门男女各多少人,结果如下
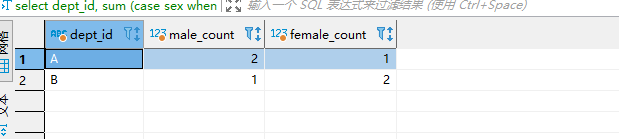
# 创建hive表并导入数据create table emp_sex(name string,dept_id string,sex string)row format delimited fields terminated by "\t";load data local inpath '/home/atguigu/data/emp_sex.txt' into table emp_sex;# 按需求查询数据select dept_id,sum (case sex when '男' then 1 else 0 end) male_count,sum (case sex when '女' then 1 else 0 end) female_countfrom emp_sexgroup by dept_id;
2.行转列和列转行
1.行转列
# 相关函数说明- CONCAT(string A/col, string B/col…):返回输入字符串连接后的结果,支持任意个输入字符串;- CONCAT_WS(separator, str1, str2,...):它是一个特殊形式的 CONCAT()。第一个参数剩余参数间的分隔符。分隔符可以是与剩余参数一样的字符串。如果分隔符是 NULL,返回值也将为 NULL。这个函数会跳过分隔符参数后的任何 NULL 和空字符串。分隔符将被加到被连接的字符串之间;- COLLECT_SET(col):函数只接受基本数据类型,它的主要作用是将某字段的值进行去重汇总,产生array类型字段。- COLLECT_LIST(col):函数只接受基本数据类型,它的主要作用是将某字段的值进行不去重汇总,产生array类型字段。
- 数据准备
孙悟空 白羊座 A大海 射手座 A宋宋 白羊座 B猪八戒 白羊座 A凤姐 射手座 A苍老师 白羊座 B
- 需求
把星座和血型一样的人归类到一起
# 创建表并导入数据create table person_info(name string,constellation string,blood_type string)row format delimited fields terminated by "\t";load data local inpath "/home/atguigu/data/constellation.txt" into table person_info;# 按需求查询数据select t1.c_b,concat_ws("|",collect_set(t1.name))from(select name,concat_ws(',',constellation,blood_type) c_bfrom person_info) t1group by t1.c_b;

2.列转行
# 相关函数说明- Split(str, separator):将字符串按照后面的分隔符切割,转换成字符array。- EXPLODE(col):将hive一列中复杂的array或者map结构拆分成多行。- LATERAL VIEW1. 用法:LATERAL VIEW udtf(expression) tableAlias AS columnAlias2. 解释:lateral view用于和split, explode等UDTF一起使用,它能够将一行数据拆成多行数据,在此基础上可以对拆分后的数据进行聚合。3. lateral view首先为原始表的每行调用UDTF,UTDF会把一行拆分成一或者多行,lateral view再把结果组合,产生一个支持别名表的虚拟表。
- 数据准备
《疑犯追踪》 悬疑,动作,科幻,剧情《Lie to me》 悬疑,警匪,动作,心理,剧情《战狼2》 战争,动作,灾难[
- 需求
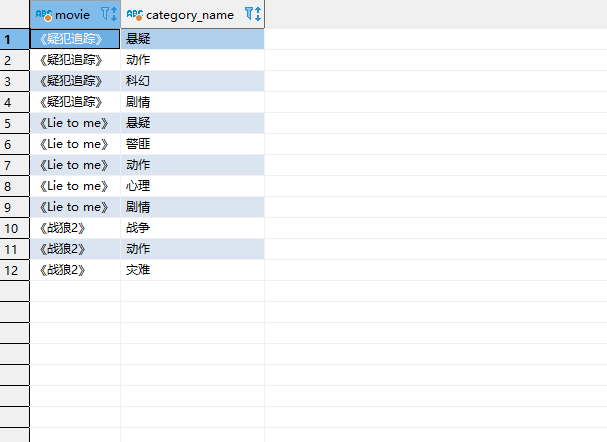
将电影分类中的数组数据展开
# 创建本地Hive表并导入数据create table movie_info(movie string,category string)row format delimited fields terminated by "\t";load data local inpath "/home/atguigu/data/movie_info.txt" into table movie_info;# 按照需求查询数据select movie,category_namefrom movie_infolateral viewexplode(split(category,",")) movie_info_tmp as category_name;
3.窗口函数
# 相关函数说明- OVER():指定分析函数工作的数据窗口大小,这个数据窗口大小可能会随着行的变而变化。- CURRENT ROW:当前行- n PRECEDING:往前n行数据- n FOLLOWING:往后n行数据- UNBOUNDED:无边界UNBOUNDED PRECEDING 前无边界,表示从前面的起点,UNBOUNDED FOLLOWING后无边界,表示到后面的终点- LAG(col,n,default_val):往前第n行数据- LEAD(col,n, default_val):往后第n行数据- FIRST_VALUE (col,true/false):当前窗口下的第一个值,第二个参数为true,跳过空值- LAST_VALUE (col,true/false):当前窗口下的最后一个值,第二个参数为true,跳过空值- NTILE(n):把有序窗口的行分发到指定数据的组中,各个组有编号,编号从1开始,对于每一行,NTILE返回此行所属的组的编号。注意:n必须为int类型。
- 数据准备
jack,2017-01-01,10tony,2017-01-02,15jack,2017-02-03,23tony,2017-01-04,29jack,2017-01-05,46jack,2017-04-06,42tony,2017-01-07,50jack,2017-01-08,55mart,2017-04-08,62mart,2017-04-09,68neil,2017-05-10,12mart,2017-04-11,75neil,2017-06-12,80mart,2017-04-13,94
- 创建Hive表并导入数据
create table business(name string,orderdate string,cost int)row format delimited fields terminated by ',';load data local inpath '/home/atguigu/data/business.txt' into table business;
- 按需求查询数据
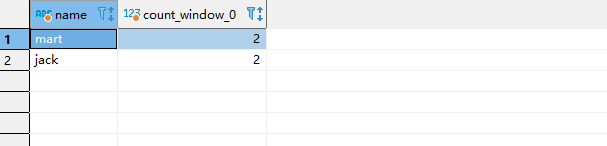
- 查询在2017年4月份购买过的顾客和总人数
select name,count(name) over()from businesswhere month(orderdate) = 4group by name;
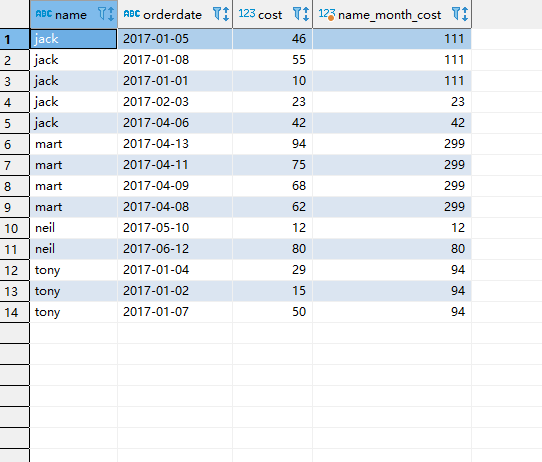
- 查询顾客的购买明细和购买总额
select name,orderdate,cost,sum(cost) over(partition by name,month(orderdate)) name_month_costfrom business;
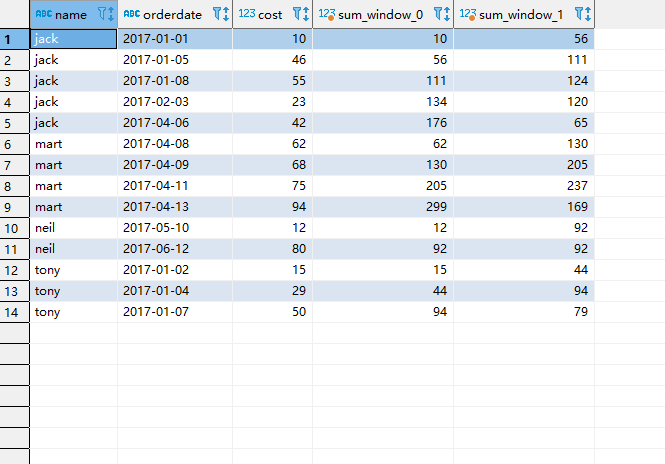
- 将每个顾客的cost按照日期进行累加
select name,orderdate,cost,sum(cost) over(partition by name order by orderdate rows between unbounded preceding and current row),sum(cost) over(partition by name order by orderdate rows between 1 preceding and 1 following)from business;
- 查询顾客购买明细以及上次的购买时间和下次购买时间
select name,orderdate,cost,lag(orderdate,1,'1990-01-01') over(partition by name order by orderdate) prev_time,lead(orderdate,1,'1970-01-01') over(partition by name order by orderdate) next_timefrom business;

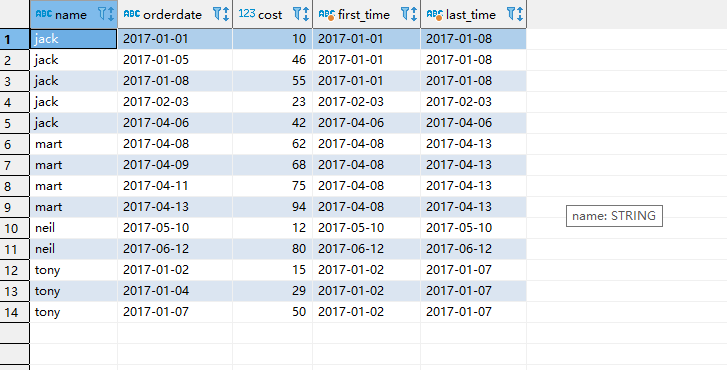
- 查询顾客每个月第一次的购买部时间和每个月的最后一次购买时间
select name,orderdate,cost,first_value(orderdate) over(partition by name,month(orderdate) order by orderdaterows between unbounded preceding and unbounded following) first_time,last_value(orderdate) over(partition by name,month(orderdate) order by orderdaterows between unbounded preceding and unbounded following) last_timefrom business;
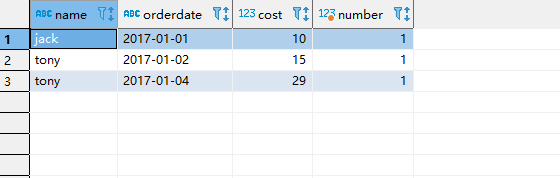
- 查询前20%时间的订单信息
select t1.name,t1.orderdate,t1.cost,t1.numberfrom(select name,orderdate,cost,ntile(5) over(order by orderdate) number from business ) t1where t1.number = 1;
4.Rank
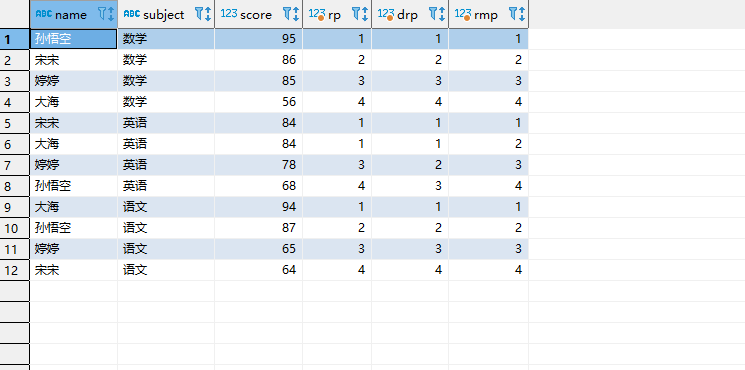
# 相关函数说明- Rank() 排序相同时会重复(考虑并列,会跳号),总数不会变- Dense_Rank() 排序相同时会有重复(考虑并列,不跳号),总数会减少- Row_Number 会根据顺序计算(不考虑并列,不跳号,行号)
- 数据准备
孙悟空 语文 87孙悟空 数学 95孙悟空 英语 68大海 语文 94大海 数学 56大海 英语 84宋宋 语文 64宋宋 数学 86宋宋 英语 84婷婷 语文 65婷婷 数学 85婷婷 英语 78
- 需求
计算每门学科成绩排名
# 创建hive表并导入数据create table score(name string,subject string,score int)row format delimited fields terminated by "\t";load data local inpath '/home/atguigu/data/score.txt' into table score;# 按照 需求查询数据select name,subject,score,rank() over(partition by subject order by score desc) rp,dense_rank() over(partition by subject order by score desc) drp,row_number() over(partition by subject order by score desc) rmpfrom score;
5.自定义函数(UDF)
- Hive自带了一些函数,比如max/min等,但是数量有限,自己可以通过自定义UDF来方便的扩展
- 根据用户自定义函数类别分为以下三种
- UDF(User-Defined-Function) 一进一出
- UDAF(User-Defined Aggregation Function) 用户自定义聚合函数,多进一出
- UDTF(User-Defined Table-Generating Functions) 用户自定义表生成函数,一进多出
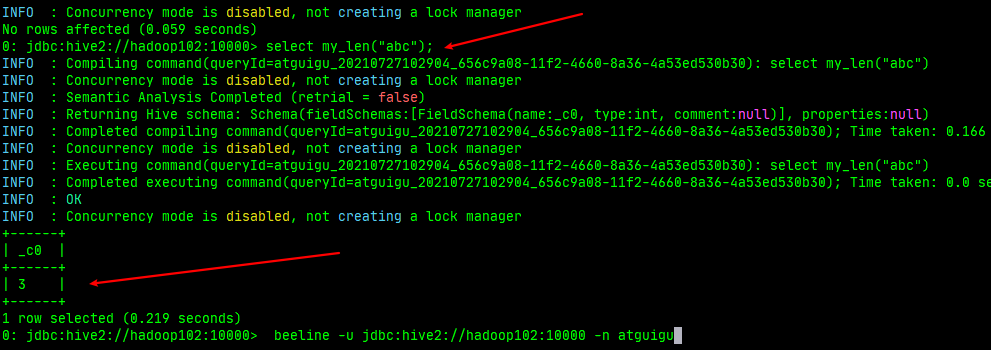
需求: 自定义一个UDF实现计算给定字符串的长度
- 在idea中创建一个maven工程
- 导入依赖
<dependencies><dependency><groupId>org.apache.hive</groupId><artifactId>hive-exec</artifactId><version>3.1.2</version></dependency></dependencies>
- 创建一个类
package com.atguigu.hive;


import org.apache.hadoop.hive.ql.exec.UDFArgumentException;
import org.apache.hadoop.hive.ql.exec.UDFArgumentLengthException;
import org.apache.hadoop.hive.ql.exec.UDFArgumentTypeException;
import org.apache.hadoop.hive.ql.metadata.HiveException;
import org.apache.hadoop.hive.ql.udf.generic.GenericUDF;
import org.apache.hadoop.hive.serde2.objectinspector.ObjectInspector;
import org.apache.hadoop.hive.serde2.objectinspector.primitive.PrimitiveObjectInspectorFactory;

public class MyLen extends GenericUDF{
    /**
    * @Description:  初始化  1.判断函数传入参数的个数   2.判断函数传入的参数的类型  3.定义返回值的类型
    * @Param: [objectInspectors]
    * @return: org.apache.hadoop.hive.serde2.objectinspector.ObjectInspector
    * @Author: jcsune
    * @Date: 2021/7/26
    */
    @Override
    public ObjectInspector initialize(ObjectInspector[] objectInspectors) throws UDFArgumentException {
        //判断函数传入的参数的个数
        if(objectInspectors.length != 1){
            throw new UDFArgumentLengthException("参数个数错误");
        }
        //判断函数传入的参数的类型
        if(!objectInspectors[0].getCategory().equals(ObjectInspector.Category.PRIMITIVE)){
            //判断是否为基本数据类型
            throw new UDFArgumentTypeException(0,"参数的类型错误");

        }
        //定义返回值的类型
        return PrimitiveObjectInspectorFactory.javaIntObjectInspector;//返回类型为int
    }

    /**
    * @Description:  在该方法中实现函数的功能: 返回内容的长度
    * @Param: [deferredObjects]
    * @return: java.lang.Object
    * @Author: jcsune
    * @Date: 2021/7/26
    */
    @Override
    public Object evaluate(DeferredObject[] deferredObjects) throws HiveException {
        //获取第一个参数的内容
        Object o = deferredObjects[0].get();
        //返回内容的长度
        return o.toString().length();
    }
    /**
    * @Description: 回显字符串在这不用管,返回一个空串即可
    * @Param: [strings]
    * @return: java.lang.String
    * @Author: jcsune
    * @Date: 2021/7/26
    */
    @Override
    public String getDisplayString(String[] strings) {
        return "";
    }
}
- 打成jar包上传至服务器 (/home/atguigu)
- 将jar包添加到hive的classpath,临时生效
beeline -u jdbc:hive2://hadoop102:10000 -n atguigu
add jar /home/atguigu/UDFDemo.jar;
- 创建临时函数与开发好的java class关联
create temporary function my_len as "com.atguigu.hive.MyLen";
- 测试自定义函数(临时生效)
select my_len("abc");
第二章.压缩和存储
1.MR支持的压缩编码
| 压缩格式 | 算法 | 文件扩展名 | 是否可切分 |
|---|---|---|---|
| DEFLATE | DEFLATE | .deflate | 否 |
| Gzip | DEFLATE | .gz | 否 |
| bzip2 | bzip2 | .bz2 | 是 |
| LZO | LZO | .lzo | 是 |
| Snappy | Snappy | .snappy | 否 |
为了支持多种压缩/解压缩算法,Hadoop引入了编码/解码器
| 压缩格式 | 对应的编码/解码器 |
|---|---|
| DEFLATE | org.apache.hadoop.io.compress.DefaultCodec |
| gzip | org.apache.hadoop.io.compress.GzipCodec |
| bzip2 | org.apache.hadoop.io.compress.BZip2Codec |
| LZO | com.hadoop.compression.lzo.LzopCodec |
| Snappy | org.apache.hadoop.io.compress.SnappyCodec |
压缩性能的比较
| 压缩算法 | 原始文件大小 | 压缩文件大小 | 压缩速度 | 解压速度 |
|---|---|---|---|---|
| gzip | 8.3GB | 1.8GB | 17.5MB/s | 58MB/s |
| bzip2 | 8.3GB | 1.1GB | 2.4MB/s | 9.5MB/s |
| LZO | 8.3GB | 2.9GB | 49.3MB/s | 74.6MB/s |
[
2.开启MAP输出阶段压缩
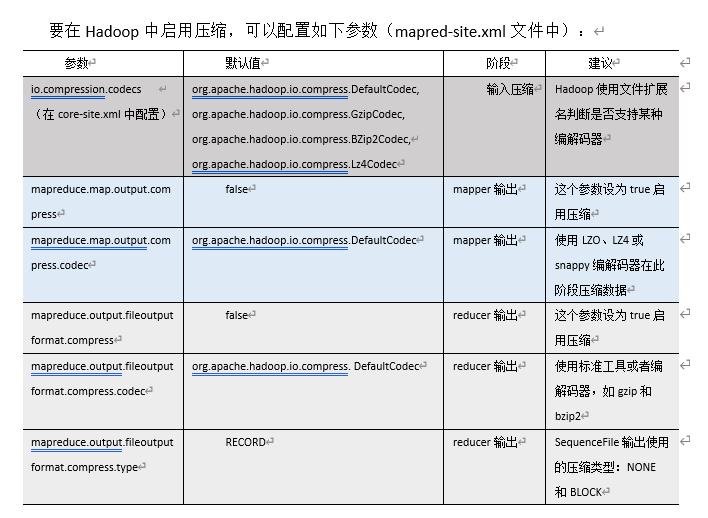
开启map输出阶段压缩可以减少job中map和reduce task间数据传输量
# 案例实操
(1)开启hive中间传输数据压缩功能
set hive.exec.compress.intermediate=true;
(2)开启mapreduce中map输出压缩功能
set mapreduce.map.output.compress=true;
(3)设置MapReduce中map输出数据的压缩格式
set mapreduce.map.output.compress.codec=org.apache.hadoop.io.compress.SnappyCodec;
(4)执行查询语句
select count(ename) name from emp;
3.开启Reduce输出阶段压缩
当Hive将输出写入到表中时,输出内容同样可以进行压缩。属性hive.exec.compress.output控制着这个功能。用户可能需要保持默认设置文件中的默认值false,这样默认的输出就是非压缩的纯文本文件了。用户可以通过在查询语句或执行脚本中设置这个值为true,来开启输出结果压缩功能。
# 案例实操
(1)开启hive最终输出数据压缩功能
set hive.exec.compress.output=true;
(2)开启MapReduce最终输出数据压缩
set mapreduce.output.fileoutputformat.compress=true;
(3)设置MapReduce最终数据输出压缩格式
set mapreduce.output.fileoutputformat.compress.codec  =org.apache.hadoop.io.compress.SnappyCodec;
(4)设置mapreduce最终数据输出压缩为块压缩
set mapreduce.output.fileoutputformat.compress.type=BLOCK;
(5)测试一下输出结果是否是压缩文件
insert overwrite local directory '/opt/module/hive/datas/compress/' select * from emp distribute by deptno sort by empno desc;

若有收获,就点个赞吧
0 人点赞


