第一章.shuffle机制
1.WritableComparable排序
# 排序概述- 排序是MapReduce框架中最重要的操作之一- MapTask和ReduceTask均会对数据按照key进行排序该操作属于hadoop的默认行为,任何应用程序中的数据均会被排序而不管逻辑上是否需要- 默认排序是按照字典顺序排序,且实现该排序的方法是快速排序- 对于MapTask,它会将处理的结果暂时放在环形缓冲区内,当环形缓冲区使用率达到一定阈值后,再对缓冲区中的数据进行一次快速排序,并将这些数据溢写到磁盘上,而当数据处理完毕后,它会对磁盘上的所有文件进行归并排序- 对于ReduceTask,它从每个MapTask上远程拷贝相应的数据文件,如果文件大小超过一定阈值,则溢写磁盘上,否则储存在内存中,如果磁盘上文件数目达到一定阈值,则进行一次归并排序以生成一个更大文件如果内存中文件大小或者数目超过一定阈值,则进行一次合并后将数据溢写到磁盘上,当所有的数据拷贝完毕后,ReduceTask统一对内存和磁盘上的所有数据进行一次归并排序
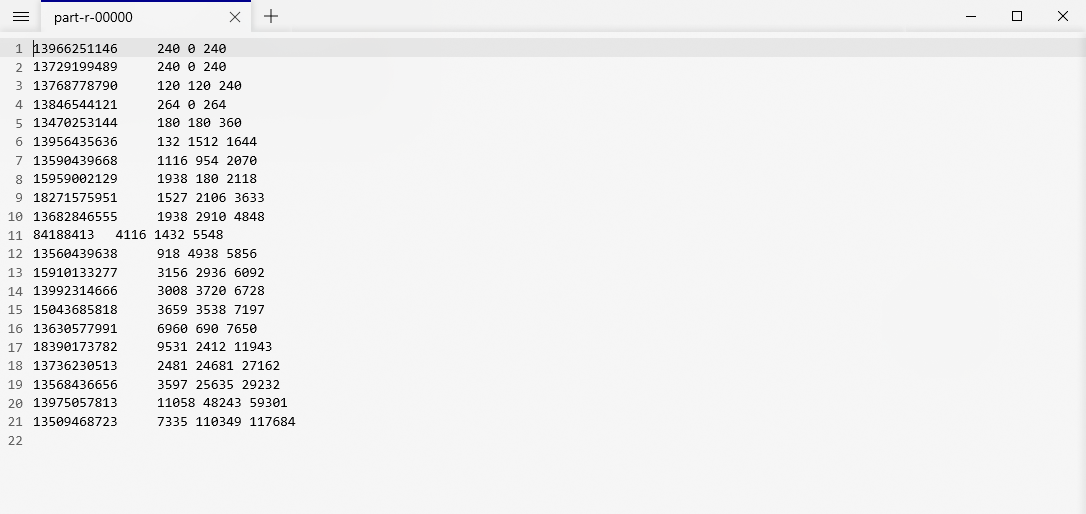
案例实操: 统计文件中手机号,上行流量,下行流量,总流量,并再对总流量进行排序

代码实现
- FlowBean对象在之前的基础上增加了比较功能
package com.atguigu.mr.comparable;import org.apache.hadoop.io.WritableComparable;import java.io.DataInput;import java.io.DataOutput;import java.io.IOException;/*自定义的类的对象作为key1.自定义的类 需要实现WritableComparable接口2. WritableComparable继承了Writable和Comparable3.重写Writable和Comparable接口中的抽象方法*/public class FlowBean implements WritableComparable<FlowBean> {private long upFlow;private long downFlow;private long sumFlow;public FlowBean(){}public FlowBean(long upFlow, long downFlow,long sumFlow) {this.upFlow=upFlow;this.downFlow=downFlow;this.sumFlow =sumFlow;}/*** @Description: 当序列化时调用此方法* @Param: [dataOutput]* @return: void* @Author: jcsune* @Date: 2021/7/12*/@Overridepublic void write(DataOutput out) throws IOException {out.writeLong(upFlow);out.writeLong(downFlow);out.writeLong(sumFlow);}/*** @Description: 当反序列化时调用此方法,注意反序列化时读取数据的顺序要和序列化时写数据的顺序保持一致* @Param: [in]* @return: void* @Author: jcsune* @Date: 2021/7/12*/@Overridepublic void readFields(DataInput in) throws IOException {upFlow = in.readLong();downFlow = in.readLong();sumFlow = in.readLong();}/*在该方法中指定按照哪个属性进行排序*/@Overridepublic int compareTo(FlowBean o){//按照总流量进行排序return Long.compare(this.sumFlow,o.sumFlow);}public long getUpFlow() {return upFlow;}public void setUpFlow(long upFlow) {this.upFlow = upFlow;}public long getDownFlow() {return downFlow;}public void setDownFlow(long downFlow) {this.downFlow = downFlow;}public long getSumFlow() {return sumFlow;}public void setSumFlow(long sumFlow) {this.sumFlow = sumFlow;}@Overridepublic String toString() {return upFlow + " " + downFlow + " " +sumFlow;}}
- Mapper类
package com.atguigu.mr.comparable;import org.apache.hadoop.io.LongWritable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Mapper;import java.io.IOException;/*注意:一定要让FlowBean作为key,因为只能对key进行排序*/public class FlowMapper extends Mapper<LongWritable,Text,FlowBean,Text> {@Overrideprotected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {//将value转成字符串String line = value.toString();//将数据切割String[] flowInfo = line.split("\t");//封装k,vFlowBean outkey =new FlowBean(Long.parseLong(flowInfo[1]),Long.parseLong(flowInfo[2]),Long.parseLong(flowInfo[3]));Text outValue = new Text(flowInfo[0]);//写出k,vcontext.write(outkey,outValue);}}
- Reducer类
package com.atguigu.mr.comparable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Reducer;import java.io.IOException;/*只是将k,v进行调换注意:一定要将泛型调换顺序*/public class FlowReducer extends Reducer< FlowBean,Text,Text, FlowBean> {@Overrideprotected void reduce(FlowBean key, Iterable<Text> values, Context context) throws IOException, InterruptedException {//遍历所有的valuefor(Text outKey: values){//将k,v写出去(原来的k变成v,原来的v变成k)context.write(outKey,key);}}}
- Driver类
package com.atguigu.mr.comparable;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Job;import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;public class FlowDriver {public static void main(String[] args) throws Exception{//创建Job对象Job job = Job.getInstance(new Configuration());//给Job对象的属性赋值job.setMapperClass(FlowMapper.class);job.setReducerClass(FlowReducer.class);//2.3设置Mapper输出的k,v的类型job.setMapOutputKeyClass(FlowBean.class);job.setMapOutputValueClass(Text.class);//2.4设置最终输出的K,V的类型(在这是Reducer输出的K,V类型)job.setOutputKeyClass(Text.class);job.setOutputValueClass(FlowBean.class);//2.5设置数据的输入和输出路径FileInputFormat.setInputPaths(job,new Path("C:\\io\\input5"));//注意:输出路径不能存在!!!!!!!!!!!!FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output5"));//3.提交Job对象(执行Job)/*参数 :是否打印进度返回值 :如果是true则表示job执行成功*/job.waitForCompletion(true);}}
- 执行程序,查看结果
2.WritableComparable扩展(区内排序)
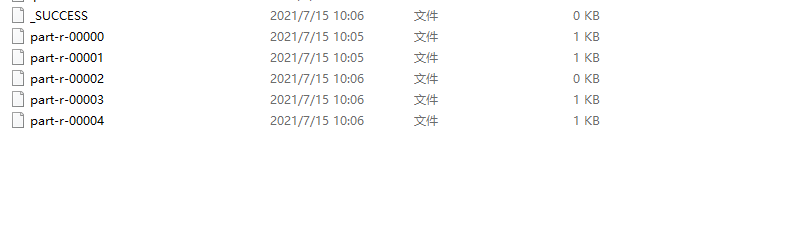
需求:要求每个省份手机号输出的文件中按照总流量内部排序
- 增加自定义分区类
package com.atguigu.mr.comparable2;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Partitioner;/*自定义分区类key:mapper输出的keyvalue:mapper输出的value*/public class MyPartitioner extends Partitioner<FlowBean, Text> {@Overridepublic int getPartition(FlowBean flowBean, Text text, int numPartitions) {//将Text转成StringString phoneNumber = text.toString();//匹配手机号if(phoneNumber.startsWith("136")){return 0;}else if(phoneNumber.startsWith("137")){return 1;}else if(phoneNumber.startsWith("137")){return 2;}else if(phoneNumber.startsWith("138")){return 3;}else {return 4;}}}
- 在驱动类中添加分区类
package com.atguigu.mr.comparable2;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Job;import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;public class FlowDriver {public static void main(String[] args) throws Exception{//创建Job对象Job job = Job.getInstance(new Configuration());//设置使用自定义分区类job.setPartitionerClass(MyPartitioner.class);//设置ReduceTask的数量job.setNumReduceTasks(5);//给Job对象的属性赋值job.setMapperClass(FlowMapper.class);job.setReducerClass(FlowReducer.class);//2.3设置Mapper输出的k,v的类型job.setMapOutputKeyClass(FlowBean.class);job.setMapOutputValueClass(Text.class);//2.4设置最终输出的K,V的类型(在这是Reducer输出的K,V类型)job.setOutputKeyClass(Text.class);job.setOutputValueClass(FlowBean.class);//2.5设置数据的输入和输出路径FileInputFormat.setInputPaths(job,new Path("C:\\io\\input6"));//注意:输出路径不能存在!!!!!!!!!!!!FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output6"));//3.提交Job对象(执行Job)/*参数 :是否打印进度返回值 :如果是true则表示job执行成功*/job.waitForCompletion(true);}}
3.Combiner合并及案例实现
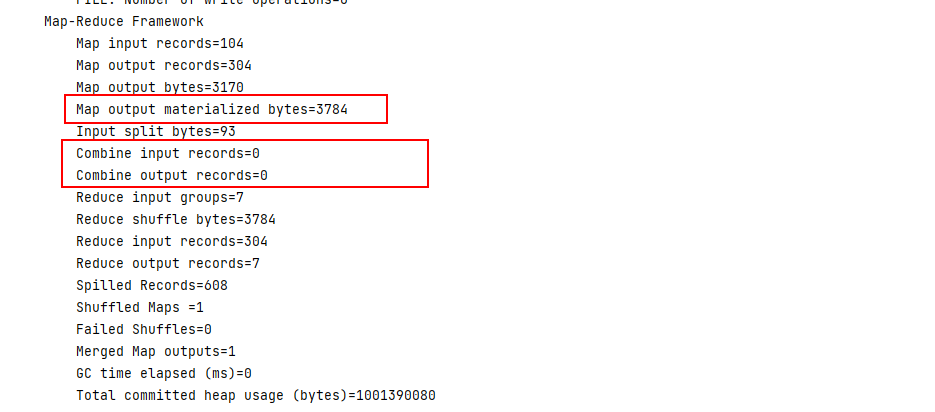
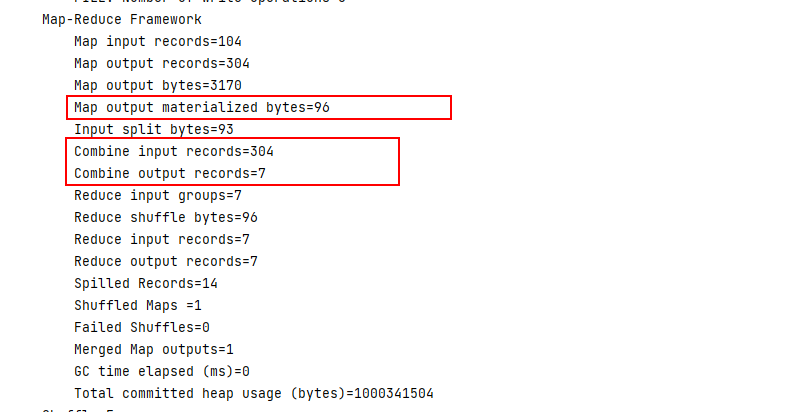
- Combiner是MR程序中MR程序中Mapper和Reducer之外的一种组件- Combiner组件的父类就是Reducer- Combiner与Reducer的区别在于运行的位置- Combiner是在每一个MapTask所在的节点运行- Reducer是接收全局所有Mapper的输出结果- Combiner的意义就是对每一个MapTask的输出进行局部汇总,以减少网络传输量- Combiner能够应用的前提下是不能影响最终的业务逻辑
案例实操: 统计过程中对每一个MapTask的输出进行局部汇总,以减少网络传输量即采用Combiner功能
未使用Combiner
使用Combiner
package com.atguigu.mr.combiner;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.IntWritable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Job;import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;public class WCDriver {public static void main(String[] args) throws Exception{//1.创建job对象Configuration conf = new Configuration();//可以在该对象中做一些设置Job job = Job.getInstance();//设置Combinerjob.setCombinerClass(WCCombiner.class);//2.给job对象的属性赋值//设置jar加载路径(如果是本地模式,可以不设置)job.setJarByClass(WCDriver.class);//设置Mapper和Reduce类job.setMapperClass(WCMapper.class);job.setReducerClass(WCReducer.class);//设置Mapper输出的k,v类型job.setMapOutputKeyClass(Text.class);job.setMapOutputValueClass(IntWritable.class);//设置最终输出的K,V类型job.setOutputKeyClass(Text.class);job.setOutputValueClass(IntWritable.class);//设置数据的输入和输出路径FileInputFormat.setInputPaths(job,new Path("C:\\io\\input7"));//注意输出路径不能存在FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output7"));//3.提交job对象/*参数:是否打印进度返回值:如果是true则表示job执行成功*/boolean b = job.waitForCompletion(true);System.exit(b ? 0 : 1);}}
4.outputFormat数据输出
# outputFormat接口实现类- outputFormat是MapReduce输出的基类,所有实现MapReduce输出都实现了OutputFormat接口- 文本输出TextOutputFormat:默认的输出格式是TextOutputFormat,它把每条记录写为文本行,它的键和值可以是任意类型,因为TextOutputFormat调用toString()方法把他们转换为字符串- SequenceFileOutputFormat:将SequerceFileOutputFormat输出作为后续MapReduce任务的输入,这便是好的一种输出格式,因为它的格式紧凑,很容易被压缩- 自定义OutputFormat1. 自定义一个类继承FileOutputFormat2. 改写RecordWriter,具体改写输出数据的方法write()
案例实操
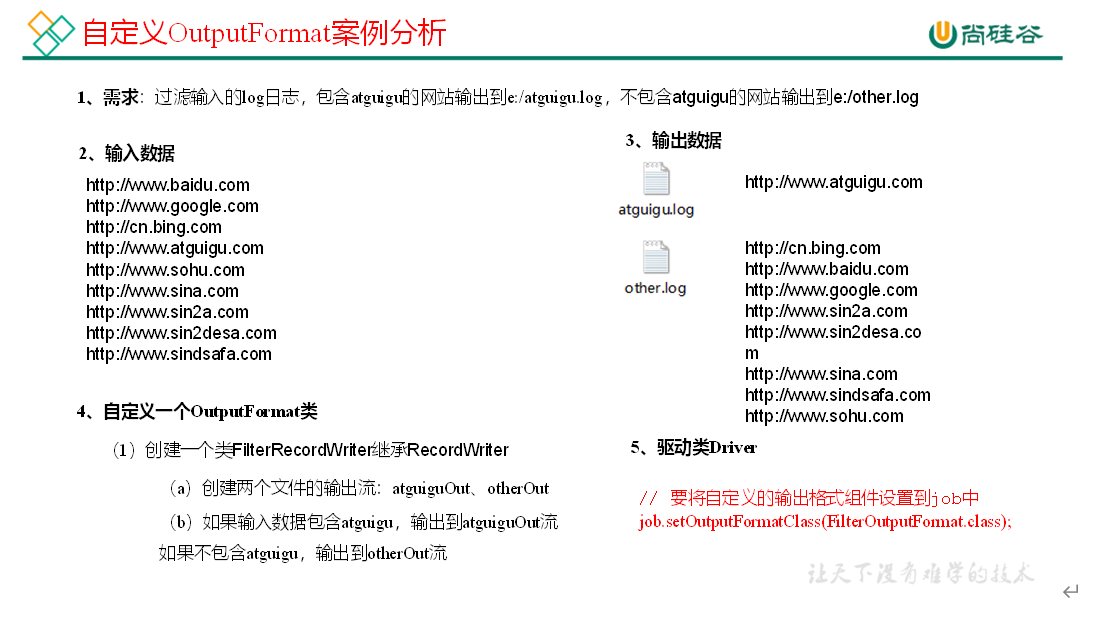
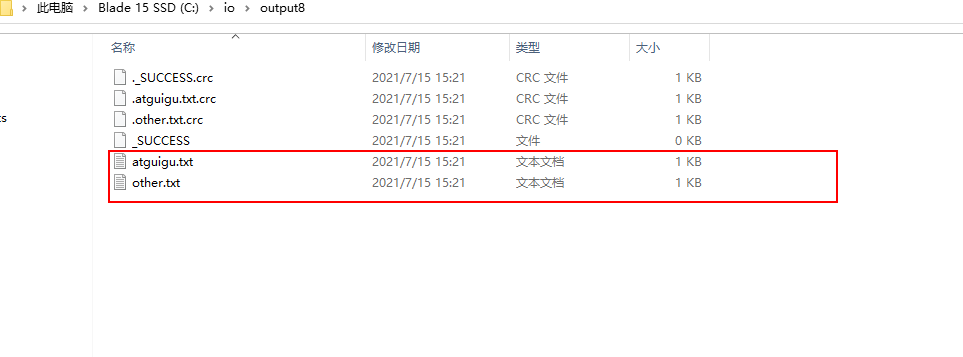
- 需求:过滤输入的log日志,包含atguigu的网站输出到atguigu.txt,不包含atguigu的网站输出到other.txt
- 需求分析
MyRecordWriter.java
package com.atguigu.mr.output;import org.apache.hadoop.fs.FSDataOutputStream;import org.apache.hadoop.fs.FileSystem;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.IOUtils;import org.apache.hadoop.io.LongWritable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.RecordWriter;import org.apache.hadoop.mapreduce.TaskAttemptContext;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;import java.io.IOException;/*自定义RecordWriter类*/public class MyRecordWriter extends RecordWriter<LongWritable, Text> {private FSDataOutputStream atguigu;private FSDataOutputStream other;/*创建流*/public MyRecordWriter(TaskAttemptContext job) {try{//1.创建流FileSystem fs = FileSystem.get(job.getConfiguration());//2.创建流--输出流//获取输出路径Path outputPath = FileOutputFormat.getOutputPath(job);atguigu =fs.create(new Path(outputPath,"atguigu.txt"));other = fs.create(new Path(outputPath,"other.txt"));}catch (Exception e){//终止程序运行throw new RuntimeException(e.getMessage());}}/*写数据*/@Overridepublic void write(LongWritable key, Text value) throws IOException, InterruptedException {//先判断网址有没有包含atguiguString address = value.toString() + "\n";if(address.contains("atguigu")){//写到atguigu.txtatguigu.write(address.getBytes());}else{//写到other.txtother.write(address.getBytes());}}/*在该方法中用来关闭资源---当写操作结束以后才会调用此方法(框架调用的)*/@Overridepublic void close(TaskAttemptContext context) throws IOException, InterruptedException {IOUtils.closeStream(atguigu);IOUtils.closeStream(other);}}
MyOutputFormat.java
package com.atguigu.mr.output;import org.apache.hadoop.io.LongWritable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.RecordWriter;import org.apache.hadoop.mapreduce.TaskAttemptContext;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;import java.io.IOException;public class MyOutputFormat extends FileOutputFormat<LongWritable,Text> {/*自定义OutputFormat类1. 自定义一个类并继承FileOutputFormat,因为继承此类只需要重写getRecordWriter方法而此方法正是我们所需要的2. FileOutputFormat泛型的类型Reducer输出的K,V类型没有Reducer是Mapper输出的K,V没有Mapper也没有那么是Inputformat输出的K,V类型*/@Overridepublic RecordWriter<LongWritable, Text> getRecordWriter(TaskAttemptContext job) throws IOException, InterruptedException {return new MyRecordWriter(job);}}
OutputDriver.java
package com.atguigu.mr.output;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.LongWritable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Job;import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;public class OutputDriver {public static void main(String[] args) throws Exception {Job job = Job.getInstance(new Configuration());job.setOutputKeyClass(LongWritable.class);job.setOutputValueClass(Text.class);//设置自定义的outputFormat类--如果不指定使用TextOutputFormatjob.setOutputFormatClass(MyOutputFormat.class);FileInputFormat.setInputPaths(job,new Path("C:\\io\\input8"));FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output8"));job.waitForCompletion(true);}}
输出结果
5.Join多种应用
1. ReduceJoin工作原理
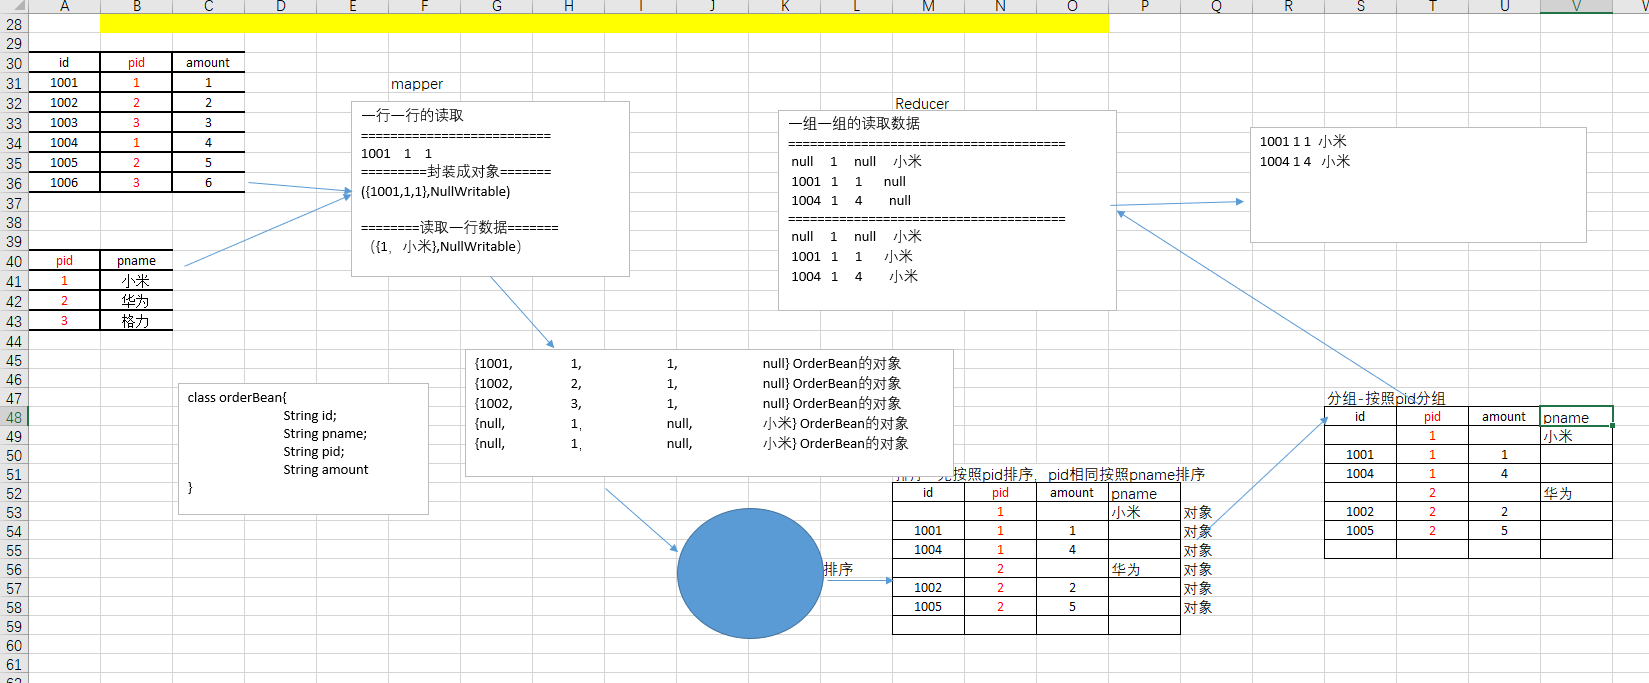
- Map端的主要工作:为来自不同表或文件的key/value对,打标签以区别不同的来源记录,然后用连接字段作为key,其余部分和新加的标志作为value,最后进行输出- Reduce端的主要工作:在Reduce端以连接字段作为key的分组已经完成.我们只需要在每一个分组当中将那些来源于不同文件的记录(在Map阶段已经打标志分开,)最后进行合并就OK了
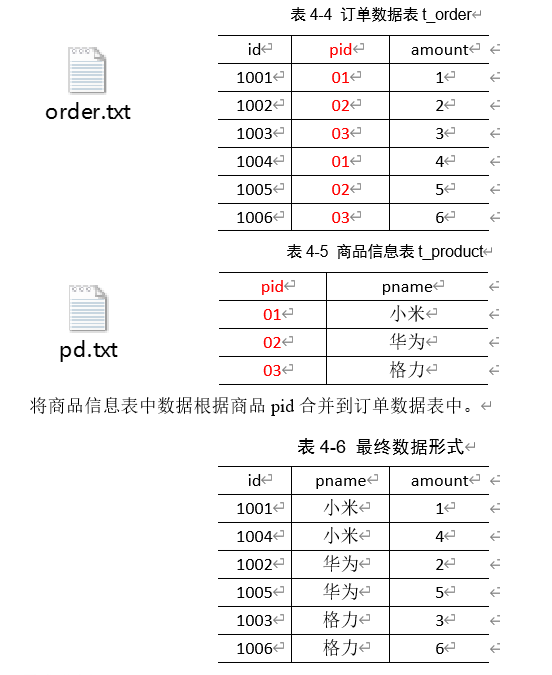
2. 案例实操
MyCompartor.java
package com.atguigu.mr.reducejoin;import org.apache.hadoop.io.WritableComparable;import org.apache.hadoop.io.WritableComparator;/*自定义分组1.自定义一个类并继承WritableComparator2.调用父类的有参构造器3.重写compare方法,并在该方法中指定分组的方式*/public class MyCompartor extends WritableComparator {/*WritableComparator(Class<? extends WritableComparable> keyClass,boolean createInstances)keyClass : Key对象所在的类的运行时类的对象createInstances : 是否实例化*/public MyCompartor(){super(OrderBean.class,true);}/*重写compare方法,并在该方法中指定分组的方式作用:在这里按照pid 进行分组*/@Overridepublic int compare(WritableComparable a, WritableComparable b) {//向下转型OrderBean o1 = (OrderBean) a;OrderBean o2 = (OrderBean) b;return o1.getPid().compareTo(o2.getPid());}}
OrderBean.java
package com.atguigu.mr.reducejoin;import org.apache.hadoop.io.WritableComparable;import java.io.DataInput;import java.io.DataOutput;import java.io.IOException;public class OrderBean implements WritableComparable<OrderBean> {private String id;private String pid;private String amount;private String pname;public OrderBean(){}public OrderBean(String id,String pid,String amount,String pname){this.id = id;this.pid = pid;this.amount = amount;this.pname = pname;}public String getId() {return id;}public void setId(String id) {this.id = id;}public String getPid() {return pid;}public void setPid(String pid) {this.pid = pid;}public String getAmount() {return amount;}public void setAmount(String amount) {this.amount = amount;}public String getPname() {return pname;}public void setPname(String pname) {this.pname = pname;}/*** @Description: 排序,先按照pid进行排序,pid相同再按照pname记性排序* @Param: [o]* @return: int* @Author: jcsune* @Date: 2021/7/15*/@Overridepublic int compareTo(OrderBean o) {int pidValue = this.pid.compareTo(o.pid);if(pidValue==0){//说明pid相同,在按照pname排序return -this.pname.compareTo(o.pname);}return pidValue;}/*** @Description: 序列化* @Param: [dataOutput]* @return: void* @Author: jcsune* @Date: 2021/7/15*/@Overridepublic void write(DataOutput dataOutput) throws IOException {dataOutput.writeUTF(id);dataOutput.writeUTF(pid);dataOutput.writeUTF(pname);dataOutput.writeUTF(amount);}/*** @Description: 反序列化* @Param: [dataInput]* @return: void* @Author: jcsune* @Date: 2021/7/15*/@Overridepublic void readFields(DataInput dataInput) throws IOException {id = dataInput.readUTF();pid = dataInput.readUTF();pname = dataInput.readUTF();amount = dataInput.readUTF();}@Overridepublic String toString() {return id + " " + pid + " " + amount + " " + pname;}}
RJmapper.java
package com.atguigu.mr.reducejoin;import org.apache.hadoop.io.LongWritable;import org.apache.hadoop.io.NullWritable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Mapper;import org.apache.hadoop.mapreduce.lib.input.FileSplit;import java.io.IOException;public class RJMapper extends Mapper<LongWritable, Text,OrderBean, NullWritable> {private String fileName;/*该方法在任务开始的时候只执行一次,在map方法调用前执行初始化*/@Overrideprotected void setup(Context context) throws IOException, InterruptedException {//获取切片信息FileSplit fs = (FileSplit) context.getInputSplit();//通过切片获取文件名fileName = fs.getPath().getName();}@Overrideprotected void cleanup(Context context) throws IOException, InterruptedException {super.cleanup(context);}@Overrideprotected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {String line = value.toString();//切割数据String[] info = line.split("\t");//创建对象OrderBean bean = new OrderBean();//封装if("order.txt".equals(fileName)){bean.setId(info[0]);bean.setPid(info[1]);bean.setAmount(info[2]);//注意:一定要给Pname一个空串,因为排序的时候先按照pid排序再按照pname排序bean.setPname("");}if("pd.txt".equals(fileName)){bean.setPid(info[0]);bean.setPname(info[1]);bean.setId("");bean.setAmount("");}//写出K,Vcontext.write(bean,NullWritable.get());}}
RJReducer.java
package com.atguigu.mr.reducejoin;import org.apache.hadoop.io.NullWritable;import org.apache.hadoop.mapreduce.Reducer;import java.io.IOException;import java.util.Iterator;public class RJReducer extends Reducer<OrderBean, NullWritable,OrderBean,NullWritable> {@Overrideprotected void reduce(OrderBean key, Iterable<NullWritable> values, Context context) throws IOException, InterruptedException {//获取迭代器对象Iterator<NullWritable> iterator = values.iterator();//获取该数据中的第一行iterator.next();//获取pnameString pname = key.getPname();//将剩余的所有数据的pname进行替换while(iterator.hasNext()){iterator.next();//替换pnamekey.setPname(pname);//将k,v写出去context.write(key,NullWritable.get());}}}
RJDriver.java
package com.atguigu.mr.reducejoin;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.NullWritable;import org.apache.hadoop.mapreduce.Job;import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;public class RJDriver {public static void main(String[] args) throws Exception {Job job = Job.getInstance();//设置自定义分组类job.setGroupingComparatorClass(MyCompartor.class);job.setMapperClass(RJMapper.class);job.setReducerClass(RJReducer.class);job.setMapOutputKeyClass(OrderBean.class);job.setMapOutputValueClass(NullWritable.class);job.setOutputKeyClass(OrderBean.class);job.setOutputValueClass(NullWritable.class);FileInputFormat.setInputPaths(job,new Path("C:\\io\\input9"));FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output9"));job.waitForCompletion(true);}}
3.MapJoin工作原理
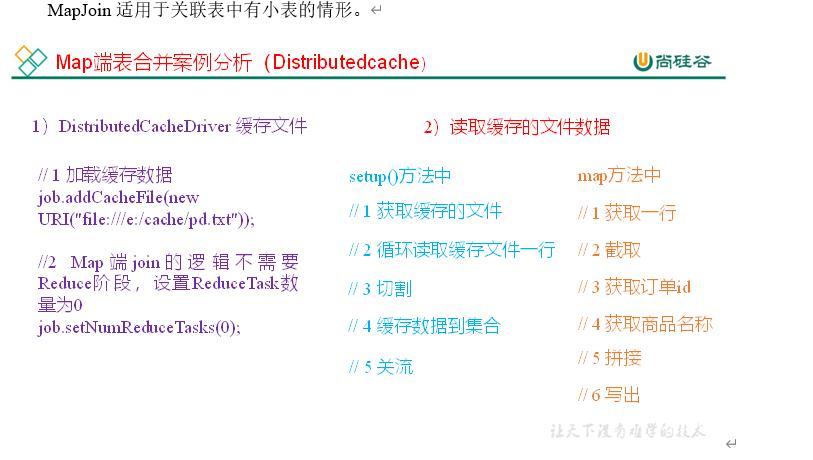
# 使用场景- Map join使用于一张表十分小,一张表很大的场景- 优点: 在Map端缓存多张表,提前处理业务逻辑,这样增加Map端业务,减少Reduce端数据的压力,尽可能的减少数据倾斜- 具体方法: 采用DistributedCache1. 在Mapper的Setup阶段,将文件读取到缓存集合中2. 在驱动函数中加载缓存// 缓存普通文件到Task运行节点job.addCacheFile(New URL("file://e:/cache/pd.txt");
4. 案例实操
需求:将商品信息表根据商品pid合并到订单数据表中
OrderBean.java
package com.atguigu.mr.mapjoin;import org.apache.hadoop.io.WritableComparable;import java.io.DataInput;import java.io.DataOutput;import java.io.IOException;public class OrderBean implements WritableComparable<OrderBean> {private String id;private String pid;private String amount;private String pname;public OrderBean(){}public OrderBean(String id, String pid, String amount, String pname){this.id = id;this.pid = pid;this.amount = amount;this.pname = pname;}public String getId() {return id;}public void setId(String id) {this.id = id;}public String getPid() {return pid;}public void setPid(String pid) {this.pid = pid;}public String getAmount() {return amount;}public void setAmount(String amount) {this.amount = amount;}public String getPname() {return pname;}public void setPname(String pname) {this.pname = pname;}/*** @Description: 排序,先按照pid进行排序,pid相同再按照pname记性排序* @Param: [o]* @return: int* @Author: jcsune* @Date: 2021/7/15*/@Overridepublic int compareTo(OrderBean o) {int pidValue = this.pid.compareTo(o.pid);if(pidValue==0){//说明pid相同,在按照pname排序return -this.pname.compareTo(o.pname);}return pidValue;}/*** @Description: 序列化* @Param: [dataOutput]* @return: void* @Author: jcsune* @Date: 2021/7/15*/@Overridepublic void write(DataOutput dataOutput) throws IOException {dataOutput.writeUTF(id);dataOutput.writeUTF(pid);dataOutput.writeUTF(pname);dataOutput.writeUTF(amount);}/*** @Description: 反序列化* @Param: [dataInput]* @return: void* @Author: jcsune* @Date: 2021/7/15*/@Overridepublic void readFields(DataInput dataInput) throws IOException {id = dataInput.readUTF();pid = dataInput.readUTF();pname = dataInput.readUTF();amount = dataInput.readUTF();}@Overridepublic String toString() {return id + " " + pid + " " + amount + " " + pname;}}
MJMapper.java
package com.atguigu.mr.mapjoin;import org.apache.hadoop.fs.FSDataInputStream;import org.apache.hadoop.fs.FileSystem;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.LongWritable;import org.apache.hadoop.io.NullWritable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Mapper;import java.io.BufferedReader;import java.io.IOException;import java.io.InputStreamReader;import java.net.URI;import java.util.HashMap;import java.util.Map;public class MJMapper extends Mapper<LongWritable, Text,OrderBean, NullWritable> {private Map<String,String> map = new HashMap<String,String>();/*在任务开始的时候,只执行一次在map方法之前执行作用 将pd.txt中的内容缓存起来*/@Overrideprotected void setup(Context context) throws IOException, InterruptedException {FileSystem fs = null;BufferedReader br =null;try {//创建流-读取pd.txtfs= FileSystem.get(context.getConfiguration());//获取缓存文件URI[] cacheFiles = context.getCacheFiles();//创建流FSDataInputStream fis = fs.open(new Path(cacheFiles[0]));//读数据-- 一行一行的读//字符缓冲流----将字节流转成字符流再套用字符缓冲流br = new BufferedReader(new InputStreamReader(fis,"utf-8"));//读数据String line = "";while((line = br.readLine())!= null){//将数据切割String[] split = line.split("\t");//将数据存放到map中map.put(split[0],split[1]);}} catch (IOException e) {e.printStackTrace();}finally {if (br != null){br.close();}if(fs != null){fs.close();}}}@Overrideprotected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {String line = value.toString();//切割数据String[] info = line.split("\t");//封装对象OrderBean orderBean = new OrderBean(info[0],info[1],info[2],map.get(info[1]));//写出k,vcontext.write(orderBean,NullWritable.get());}}
MJDriver.class
package com.atguigu.mr.mapjoin;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.NullWritable;import org.apache.hadoop.mapreduce.Job;import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;import java.net.URI;public class MJDriver {public static void main(String[] args) throws Exception {Job job = Job.getInstance(new Configuration());job.addCacheFile(new URI("file:///C:/io/input10/pd.txt"));//添加缓存文件的路径,一定要注意斜杠job.setMapperClass(MJMapper.class);job.setNumReduceTasks(0);//表示没有ReducerTaskjob.setMapOutputKeyClass(OrderBean.class);job.setMapOutputValueClass(NullWritable.class);job.setMapOutputKeyClass(OrderBean.class);job.setMapOutputValueClass(NullWritable.class);FileInputFormat.setInputPaths(job,new Path("C:\\io\\input10\\order.txt"));FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output10"));job.waitForCompletion(true);}}

若有收获,就点个赞吧
0 人点赞


