第一章.多表查询
1.SQL书写事项
(1)SQL 语言大小写不敏感。(2)SQL 可以写在一行或者多行(3)关键字不能被缩写也不能分行(4)各子句一般要分行写。(5)使用缩进提高语句的可读性。
2.字符串
- 日期和字符只能在单引号中出现
- 每当返回一行时,字符串被输出一次
3.多表查询
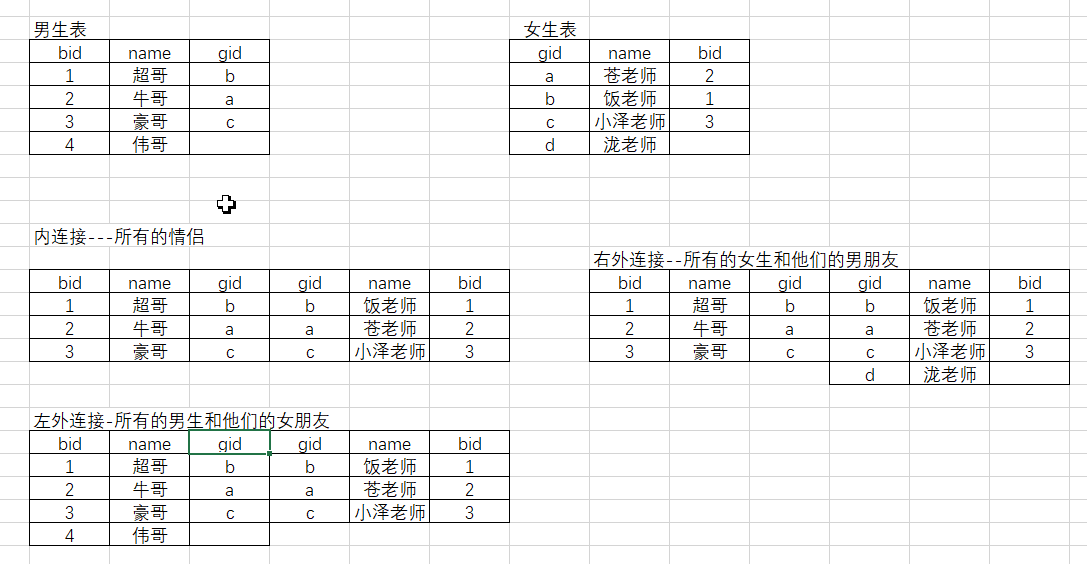
/*多表查询:将多张表进行连接查出需要的数据。多表连接分类:1.自连接 vs 非自连接2.内连接 vs 外连接3.等值连接 vs 非等值连接语法:sql92语法和sql99语法(重点)*/#sql92语法#需求:查询所有的员工姓名和员工所在的部门名称SELECT first_name,department_nameFROM employees,departmentsWHERE employees.department_id=departments.department_id;#连接条件#下面会发生笛卡尔集的错误(原因:因为缺少连接条件或连接条件错误)。SELECT first_name,department_nameFROM employees,departments;#需求:查询所有的员工姓名和员工所在的部门名称#注意:多表查询时,如果查询的字段在两张表中都存在那么字段名前要加表名。#如果字段可以区分最好也加上表名。因为效率高一些。SELECT employees.first_name,departments.department_name,employees.department_id,departments.`department_id`FROM employees,departmentsWHERE employees.department_id=departments.department_id;#连接条件#给表起别名SELECT e.first_name,d.department_name,e.department_id,d.`department_id`FROM employees e,departments dWHERE e.department_id=d.department_id;#连接条件#sql99语法/*select .....from 表1 join 表2on 连接条件join 表3on 连接条件......where 过滤条件order by ......*/#需求:查询所有的员工姓名和员工所在的部门名称#非自连接(不同的表进行连接)#等值连接(连接条件是一个等号)#内连接(所有匹配的数据)SELECT e.`first_name`,d.`department_name`FROM employees e JOIN departments d #可以写成 inner joinON e.`department_id` = d.`department_id`;#自连接#需求:获取所有的员工姓名及管理者的姓名SELECT e.`first_name` "员工姓名", m.`first_name` "管理者姓名"FROM employees e JOIN employees mON e.`manager_id`=m.`employee_id`;#非等值连接#需求:获取所有员工的薪水等级SELECT e.`first_name`,e.`salary`,j.gradeFROM employees e JOIN job_grades jON e.salary >= j.`LOWEST_SAL` AND e.`salary` <= j.`HIGHEST_SAL`;/*内连接: 合并具有同一列的两个以上的表的行, 结果集中不包含一个表与另一个表不匹配的行外连接: 两个表在连接过程中除了返回满足连接条件的行以外还返回左(或右)表中不满足条件的行 ,这种连接称为左(或右) 外连接。没有匹配的行时, 结果表中相应的列为空(NULL).*/#左外连接:#需求:获取所有的员工及员工的部门名称SELECT e.`first_name`,d.`department_name`FROM employees e LEFT JOIN departments d # 可以写成 left outer joinON e.`department_id` = d.`department_id`;#右外连接#需求:获取所有部门及部门中的员工SELECT e.`first_name`,d.`department_name`FROM employees e RIGHT JOIN departments d # 可以写成right outer join#from departments d left join employees eON e.`department_id`=d.`department_id`;#满外连接:full join(mysql不支持)#union(去重) :可以将两条sql语句的结果进行合并#union all(不去重)SELECT e.`first_name`,d.`department_name`FROM employees e LEFT JOIN departments dON e.`department_id` = d.`department_id`UNIONSELECT e.`first_name`,d.`department_name`FROM employees e RIGHT JOIN departments dON e.`department_id`=d.`department_id`;#需求:查询员工的姓名,部门名称,部门所在的城市。SELECT e.`first_name`,d.`department_name`,l.`city`FROM employees e JOIN departments dON e.`department_id`=d.`department_id`JOIN locations lON d.`location_id`=l.`location_id`;
第二章.单行函数
1.单行函数的定义
- 操作数据对象
- 接受参数返回一个结果
- 只对一行进行变换
- 每行返回一个结果
- 可以嵌套
- 参数可以是一列或一个值
2.字符函数
/*LOWER('SQL Course') :将所有的字母变成小写UPPER('SQL Course') :将所有的字母变成大写*/SELECT LOWER('AaBc');SELECT UPPER('AaBc');SELECT LOWER(first_name),UPPER(last_name)FROM employees;/*CONCAT('Hello', 'World') : 字符串拼接SUBSTR('HelloWorld',1,5) : 截取子串1 :指的是索引位置(索引从1开始)5 :指的是长度(偏移量)LENGTH('HelloWorld') :字符串长度INSTR('HelloWorld', 'W') : W字符在当前字符串中首次出现的位置注意:索引位置从1开始LPAD(salary,10,'*') :向右对齐10 : 指的是内容的长度如果不够用指定的字符补齐'*' : 用来补内容的字符RPAD(salary, 10, '*') :向左对齐10 : 指的是内容的长度如果不够用指定的字符补齐'*' : 用来补内容的字符TRIM('H' FROM 'HelloWorld') :指定去除字符串两端的字符REPLACE('abcd','b','m') : 替换字符串所有的指定字符*/SELECT REPLACE('abcaaa','a','A');SELECT TRIM('H' FROM 'HHHHHh HHH aHHHHHH');SELECT LPAD(salary,10,' '),RPAD(salary,10,' ')FROM employees;SELECT CONCAT('hello','longge');SELECT CONCAT(first_name,last_name)FROM employees;SELECT SUBSTR('hellolong',3,3);SELECT LENGTH('hello');SELECT INSTR('heollo','o');
3.数字函数
/*ROUND: 四舍五入ROUND(45.926, 2) 45.93TRUNCATE: 截断TRUNCATE(45.926) 45MOD: 求余MOD(1600, 300) 100*/SELECT ROUND(45.926,2), #45.93ROUND(45.926,1), #45.9ROUND(45.926,0), #46ROUND(45.926,-1);#50SELECT TRUNCATE(45.926,2), #45.92TRUNCATE(45.926,1), #45.9TRUNCATE(45.926,0), #45TRUNCATE(45.926,-1);#40#正负和被模数(第一个参数)的正负有关。SELECT MOD(4,3),MOD(-4,3),MOD(4,-3),MOD(-4,-3);
4.日期函数
#日期函数SELECT NOW();#查看Mysql版本SELECT VERSION();
5.通用函数
/*通用函数 :ifnull(字段名,值) : 如果字段的内容为null就返回指定的值*/#需求:获取所有人的薪水(工资+奖金)SELECT salary+salary* IFNULL(commission_pct,0),commission_pctFROM employees;
6.case表达式
/*case表达式:格式1:case 字段名when 匹配的内容1 then 返回值1when 匹配的内容2 then 返回值2when 匹配的内容3 then 返回值3......else 返回值nend格式2casewhen 表达式1 then 返回值1when 表达式2 then 返回值2else 返回值nend*//*练习:查询部门号为 10, 20, 30 的员工信息, 若部门号为 10,则打印其工资的 1.1 倍, 20 号部门, 则打印其工资的 1.2 倍,30 号部门打印其工资的 1.3 倍数*/SELECT salary,department_id,CASE department_idWHEN 10 THEN salary*1.1WHEN 20 THEN salary*1.2WHEN 30 THEN salary*1.3ELSE salaryEND AS new_salaryFROM employees;#练习 :如果薪水大于等于1万输出"高"否则输出"低"SELECT salary,CASEWHEN salary>=10000 THEN "高"ELSE "低"END AS "h_l"FROM employees;
第三章.组函数
1.什么是分组函数?
分组函数作用于一组数据,并对一组数据返回一个值
2.组函数语法
/*AVG() :求平均值SUM() :求和注意:上面运算的数据类型只能是数值型MAX() :求最大值MIN() :求最小值COUNT() :统计数据的个数*/SELECT AVG(salary),SUM(salary),MAX(salary),MIN(salary),COUNT(salary)FROM employees;/*avg() :思考:求平均值时是否包含了null?没有包括nullsum(),max(),min()在运算时都会忽略掉null值*/SELECT COUNT(commission_pct)FROM employees;SELECT commission_pctFROM employeesWHERE commission_pct IS NOT NULL;#注意:avg在做运算时不包括nullSELECT SUM(commission_pct)/35,SUM(commission_pct/107),AVG(commission_pct)FROM employees;#sum,max,min在运算时都会忽略掉null值SELECT SUM(commission_pct),MAX(commission_pct),MIN(commission_pct)FROM employees;/*count(字段名) : 不包括null在内 --字段中的内容不为null的有多少条count(*) : 统计整张表中所有数据有多少条count(数值) : 统计整张表中所有数据有多少条比count(*)效率高*/SELECT COUNT(commission_pct),COUNT(*),COUNT(1),COUNT(2)FROM employees;
第四章.分组和过滤
1.group by
/*注意:一旦select后面出现组函数,就不能再出现其它字段。除非出现的字段也出现在group by的后面。*/SELECT first_name,AVG(salary)FROM employees;/*格式:select ......from 表名where 过滤条件group by 字段名1,字段名2.......order by ......*/#需求:查询各部门中最高薪水是多少#注意:一旦select后面出现组函数,就不能再出现其它字段。# 除非出现的字段也出现在group by的后面。SELECT department_id,MAX(salary)FROM employeesWHERE department_id IS NOT NULLGROUP BY department_id;#需求:查询各工种中平均薪水是多少,并按照平均薪水进行排序-降序SELECT job_id,AVG(salary) a_sFROM employeesGROUP BY job_id#order by avg(salary) desc;ORDER BY a_s DESC;#需求:查询各部门中不同工种的最高薪水是多少,并按照最高薪水进行排序-降序SELECT department_id,job_id,MAX(salary)FROM employeesWHERE department_id IS NOT NULLGROUP BY department_id,job_idORDER BY MAX(salary) DESC;
2.having子句
使用having过滤分组
- 行已经被分组
- 使用了组函数
- 满足Having子句中条件的分组将被显示
/*having :过滤格式:select .......from 表名where 过滤条件group by .....having 过滤条件order by ......where和having的区别?1.where后面不能出现组函数,having后面可以出现组函数2.where在group by的前面,having在group by的后面*/#需求:求各管理者手下员工的最高薪水大于6000的管理者有哪些,SELECT manager_id,MAX(salary)FROM employees#where max(salary)>6000 #注意:where不能跟组函数。where是在group by之前执行。GROUP BY manager_idHAVING MAX(salary)>6000ORDER BY MAX(salary) DESC;#需求:求部门号为50,90,100中各员工的平均薪水#先求出各部门的平均薪水再过滤SELECT department_id,AVG(salary)FROM employeesGROUP BY department_idHAVING department_id IN(50,90,100);#先过滤出50,90,100然后再进行分组---这种方式效率最高SELECT department_id,AVG(salary)FROM employeesWHERE department_id IN(50,90,100)GROUP BY department_id;
第五章.子查询
1.定义
- 子查询 :在一个查询语句a中再嵌套另一个查询语b.
b语句叫作子查询,a语句叫作外查询(主查询)- 子查询分类 : 单行子查询 vs 多行子查询
- 单行子查询 :子查询的结果只有一条
多行子查询 :子查询的结果有多条- 单行子查询使用的运算符 := > >= < <= <>
- 多行子查询使用的运算符 : IN ANY ALL
INT 等于列表中的任意一个
ANY 和子查询返回的某一个值比较
ALL 和子查询返回的所有值比较
2.使用(单行子查询)
*/#需求:谁的工资比 Abel 高?#第一种方式:查两次①先查出Abel的工资是多少 ②再用其它用工的薪水做对比SELECT salaryFROM employeesWHERE last_name='Abel'; #11000SELECT last_name,salaryFROM employeesWHERE salary>11000;#第二种方式:自连接SELECT e1.last_name,e1.`salary`FROM employees e1 JOIN employees e2ON e2.last_name='Abel' AND e1.`salary`>e2.salary;#第三种方式:子查询SELECT last_name,salaryFROM employeesWHERE salary>(SELECT salaryFROM employeesWHERE last_name='Abel');#需求:题目:返回job_id与141号员工相同,salary比143号员工多的员工# 姓名,job_id 和工资#1.求出141号员工的job_idSELECT job_idFROM employeesWHERE employee_id=141;#ST_CLERK#2.求出143号员工的薪水SELECT salaryFROM employeesWHERE employee_id=143;#2600#3.求job_id为ST_CLERK薪水比2600多的员工有哪些SELECT last_name,job_id,salaryFROM employeesWHERE job_id='ST_CLERK' AND salary>2600;#子查询SELECT last_name,job_id,salaryFROM employeesWHERE job_id=(SELECT job_idFROM employeesWHERE employee_id=141) AND salary>(SELECT salaryFROM employeesWHERE employee_id=143);#需求:返回公司工资最少的员工的last_name,job_id和salary#1.求最少工资SELECT MIN(salary)FROM employees;#2100#2.查询工资为2100的员工的信息last_name,job_id和salarySELECT last_name,job_id,salaryFROM employeesWHERE salary=2100;#子查询SELECT last_name,job_id,salaryFROM employeesWHERE salary=(SELECT MIN(salary)FROM employees);#需求:查询最低工资大于50号部门最低工资的部门id和其最低工资SELECT department_id,MIN(salary)FROM employeesWHERE department_id IS NOT NULLGROUP BY department_idHAVING MIN(salary)>(#50号部门最低工资SELECT MIN(salary)FROM employeesWHERE department_id=50);SELECT commission_pctFROM employeesWHERE commission_pct > (#如果子查询结果为null那么查不出数据SELECT commission_pctFROM employeesWHERE employee_id=100)
3.使用(多行子查询)
/*多行子查询使用的运算符 : IN ANY ALLINT 等于列表中的任意一个ANY 和子查询返回的某一个值比较ALL 和子查询返回的所有值比较*/#需求:题目:返回其它部门中比job_id为‘IT_PROG’部门任一工资低的员工的员# 工号、姓名、job_id 以及salarySELECT employee_id,last_name,job_id,salaryFROM employeesWHERE job_id<>'IT_PROG' AND salary <ANY (#获取IT_PROG部门所有员工的薪水SELECT DISTINCT salaryFROM employeesWHERE job_id='IT_PROG');#需求:返回其它部门中比job_id为‘IT_PROG’部门所有工资都低的员工# 的员工号、姓名、job_id 以及salarySELECT employee_id,last_name,job_id,salaryFROM employeesWHERE job_id<>'IT_PROG' AND salary <ALL (#获取IT_PROG部门所有员工的薪水SELECT DISTINCT salaryFROM employeesWHERE job_id='IT_PROG');#去重:distinctSELECT DISTINCT salaryFROM employeesWHERE job_id='IT_PROG'

若有收获,就点个赞吧
0 人点赞


