第一章.MapReduce概述
1.MapReduce介绍
# 定义- MapReduce是一个分布式运算程序的编程框架,是用户开发"基于Hadoop的数据分析应用的核心框架- MapReduce核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并发运行在一个Hadoop集群上# 优点1. MapReduce易于编程,它简单的实现了一些接口,就可以完成一个分布式程序2. 良好的扩展性,当你的计算资源不能得到满足的时候,你可以通过简单的增加机器来扩展它的计算能力3. 高容错性,比如如果其中一台机器挂了,它可以把上面的计算任务转移到另外一个节点上来运行,不至于这个任务运行失败4. 适合PB级以上海量数据的离线处理# 缺点1. 不擅长实时计算,MapReduce无法像MySQL一样,在毫秒或者秒级内返回结果2. 不擅长流式计算,流式计算的输入数据是动态的,而MapReduce的输入数据集是静态的,不能动态变化,这是因为MapReduce自身的设计特点决定了数据源必须是静态的3. 不擅长有向图计算,多个应用程序存在依赖关系,后一个应用程序的输入为前一个的输出,在这种情况下,MapReduce并不是不能做,而是使用后,每个MapReduce作业的输出结果都会写入到磁盘,会造成大量的磁盘IO,导致性能非常的低下
2.MapReduce核心思想
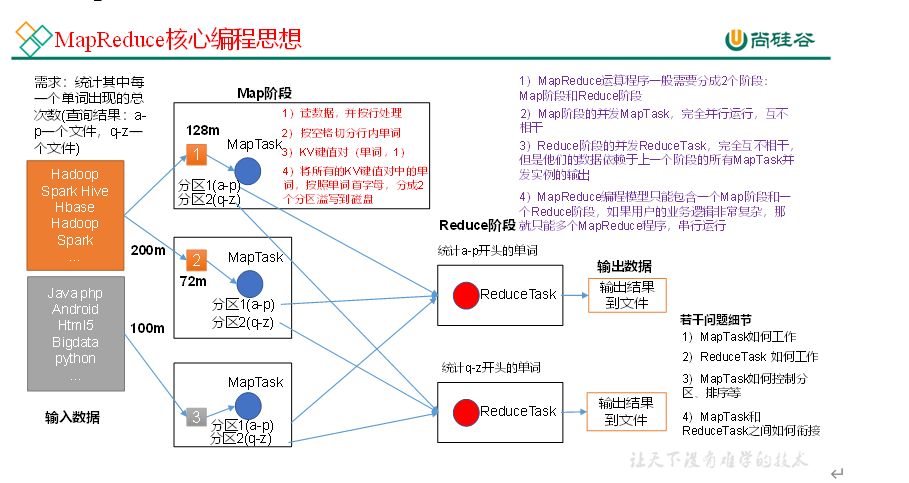
# MapReduce核心思想
1. 分布式的运算程序往往需要分成至少两个阶段
2. 第一个阶段的MapTask并发实例,完全并行运行,互不相干
3. 第二个阶段的ReduceTask并发实例互不相干,但是他们的数据依赖于上一个阶段的所有MapTesk并发实例的输出
4. MapReduce编程模型只能包含一个Map阶段和一个Reduce阶段,如果用户的业务逻辑非常复杂,那就只能多个MapReduce程序,串行运行
# MapReduce进程
1. MrAPPMaster:负责整个程序的过程调度及状态协调
2. MapTesk: 负责Map阶段的整个数据流程
3. ReduceTask: 负责Reduce阶段的整个数据处理流程
3.常用数据序列化类型
| Java类型 | HadoopWritable类型 |
|---|---|
| Boolean | BooleanWritable |
| Byte | ByteWritable |
| Integer | IntWritable |
| Float | FloatWritable |
| Long | LongWritable |
| Double | DoubleWritable |
| String | Test |
| Map | MapWritable |
| Array | ArrayWritable |
4.WordCount案例实操
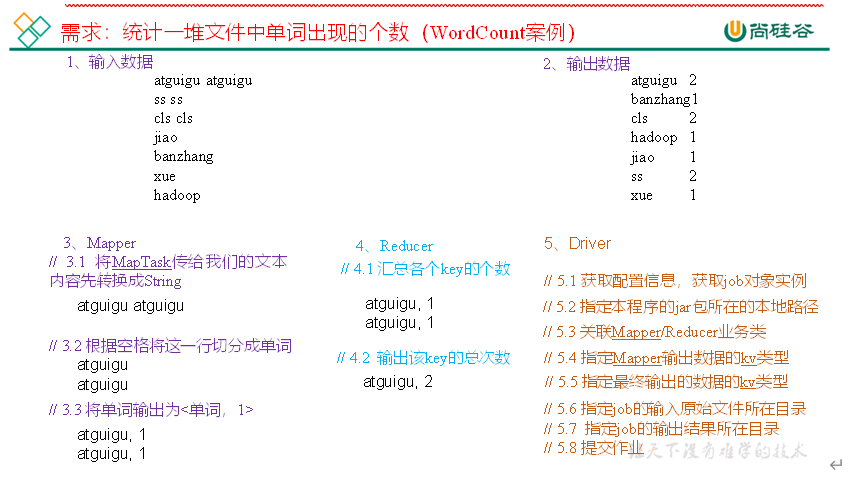
- 需求:在给定的文本文件中统计输出每一个单词出现的总次数
- 输入数据: hello.txt
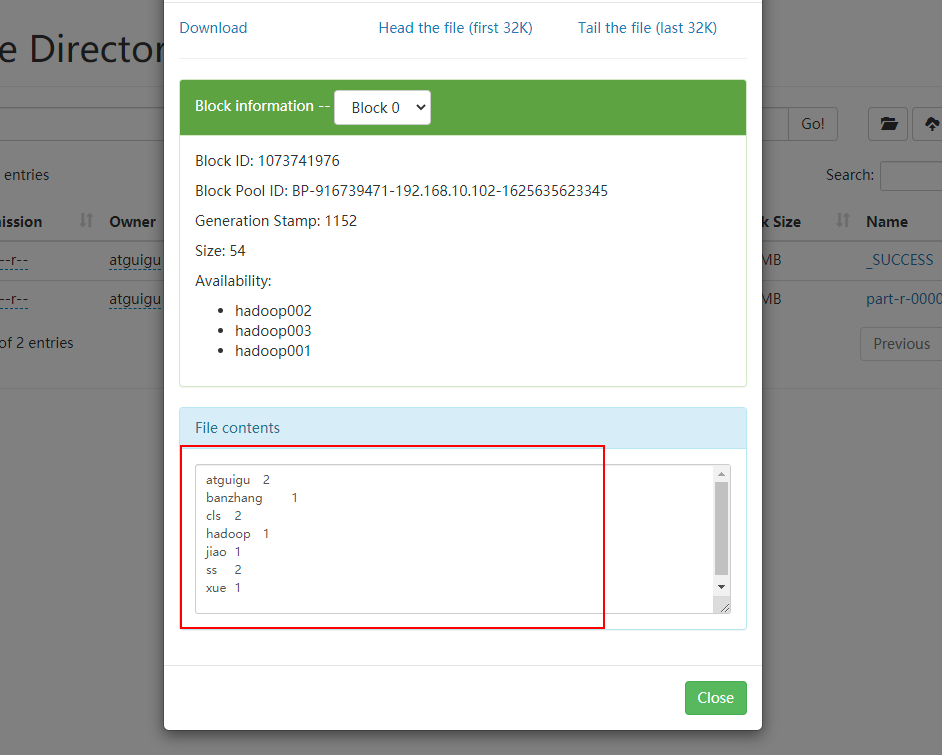
- 期望输出数据
atguigu 2
banzhang 1
cls 2
hadoop 1
jiao 1
ss 2
xue 1
- 需求分析
- 环境准备
一.创建Maven工程
二.在pom.xml中添加以下依赖
<dependencies>
    <dependency>
        <groupId>junit</groupId>
        <artifactId>junit</artifactId>
        <version>4.12</version>
    </dependency>
    <dependency>
        <groupId>org.apache.logging.log4j</groupId>
        <artifactId>log4j-slf4j-impl</artifactId>
        <version>2.12.0</version>
    </dependency>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-client</artifactId>
        <version>3.1.3</version>
    </dependency>
</dependencies>
三.在项目的src/main/resources目录下,新建一个文件,命名为”log4j2.xml”,在文件中填入
<?xml version="1.0" encoding="UTF-8"?>
<Configuration status="error" strict="true" name="XMLConfig">
    <Appenders>
        <!-- 类型名为Console,名称为必须属性 -->
        <Appender type="Console" name="STDOUT">
            <!-- 布局为PatternLayout的方式,
            输出样式为[INFO] [2018-01-22 17:34:01][org.test.Console]I'm here -->
            <Layout type="PatternLayout"
                    pattern="[%p] [%d{yyyy-MM-dd HH:mm:ss}][%c{10}]%m%n" />
        </Appender>

    </Appenders>

    <Loggers>
        <!-- 可加性为false -->
        <Logger name="test" level="info" additivity="false">
            <AppenderRef ref="STDOUT" />
        </Logger>

        <!-- root loggerConfig设置 -->
        <Root level="info">
            <AppenderRef ref="STDOUT" />
        </Root>
    </Loggers>

</Configuration>
四.编写程序
Mapper类
package com.atguigu.mr.wordcount;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class WCMapper extends Mapper<LongWritable,Text,Text,IntWritable> {
    private Text outKey = new Text();//封装的key
    private IntWritable outValue = new IntWritable();//封装的value
    /**
    * @Description:  实现MapTesk中需要实现的业务逻辑代码
    * @Param: [key, value, context] [读取数据的偏移量,读取的数据(一行一行的数据),上下文(这里用于将数据写出去)]
    * @return: void
    * @Author: jcsune
    * @Date: 2021/7/10
    */
    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        //将value转成String
        String line = value.toString();
        //切割数据
        String[] words = line.split(" ");
        //遍历数组
        for (String word: words) {
            //封装key
            outKey.set(word);
            //封装value
            outValue.set(1);
            //将K,V写出去
            context.write(outKey,outValue);
        }
    }
}
Reducer类
package com.atguigu.mr.wordcount;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class WCReducer extends Reducer<Text,IntWritable,Text,IntWritable> {
    private IntWritable outValue = new IntWritable();//封装的value
    /**
    * @Description: 实现ReduceTask需要实现的业务逻辑代码
    * @Param: [key, values, context] [读取的key的值,读取的所有的value,上下文]
    * @return: void
    * @Author: jcsune
    * @Date: 2021/7/10
    */
    @Override
    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

        int sum = 0;//所有value的和
        //遍历所有的value
        for (IntWritable value : values){
            int v = value.get();
            sum += v;
        }
        //封装k,v
        outValue.set(sum);
        //写出k,v
        context.write(key,outValue);
    }


    }
Driver类(WCDriver)
package com.atguigu.mr.wordcount;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class WCDriver {
    public static void main(String[] args) throws Exception{
        //1.创建job对象
        Configuration conf = new Configuration();//可以在该对象中做一些设置
        Job job = Job.getInstance();
        //2.给job对象的属性赋值
        //设置jar加载路径(如果是本地模式,可以不设置)
        job.setJarByClass(WCDriver.class);

        //设置Mapper和Reduce类
        job.setMapperClass(WCMapper.class);
        job.setReducerClass(WCReducer.class);
        //设置Mapper输出的k,v类型
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(IntWritable.class);
        //设置最终输出的K,V类型
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);
        //设置数据的输入和输出路径
        FileInputFormat.setInputPaths(job,new Path("C:\\io\\input"));
        //注意输出路径不能存在
        FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output"));
        //3.提交job对象
        /*
        参数:是否打印进度
        返回值:如果是true则表示job执行成功
         */
        boolean b = job.waitForCompletion(true);
        System.exit(b ? 0 : 1);
    }
}
五.本地测试
- 需要事先准备好HadoopHome变量以及Windows运行依赖
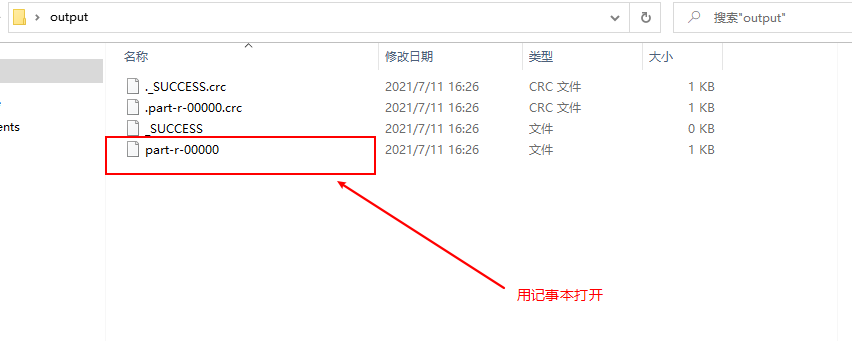
- 在Idea上运行程序

六.集群测试(只修改Driver类即可)
- Driver类(WCDriver2)
package com.atguigu.mr.wordcount;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
/*
将MR打包在集群上运行
hadoop jar xxx.jar com.atguigu.mr.wordcount.WCDriver2 参数1 参数2
 */
public class WCDriver2 {
    public static void main(String[] args) throws Exception{
        //1.创建job对象
        Configuration conf = new Configuration();//可以在该对象中做一些设置
        Job job = Job.getInstance();
        //2.给job对象的属性赋值
        //设置jar加载路径(如果是本地模式,可以不设置)
        job.setJarByClass(WCDriver2.class);

        //设置Mapper和Reduce类
        job.setMapperClass(WCMapper.class);
        job.setReducerClass(WCReducer.class);
        //设置Mapper输出的k,v类型
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(IntWritable.class);
        //设置最终输出的K,V类型
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);
        //设置数据的输入和输出路径
        FileInputFormat.setInputPaths(job,new Path(args[0]));
        //注意输出路径不能存在
        FileOutputFormat.setOutputPath(job,new Path(args[1]));
        //3.提交job对象
        /*
        参数:是否打印进度
        返回值:如果是true则表示job执行成功
         */
        boolean b = job.waitForCompletion(true);
        System.exit(b ? 0 : 1);
    }
}
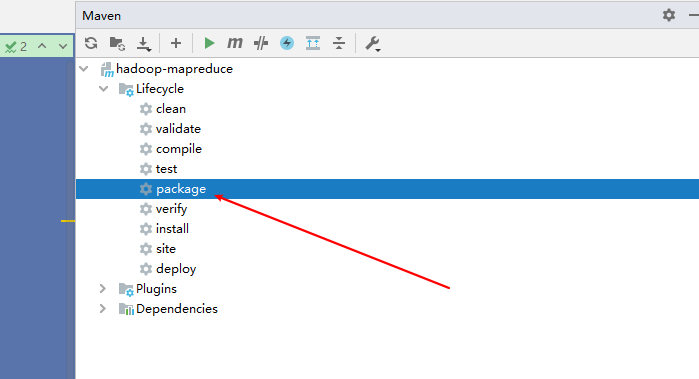
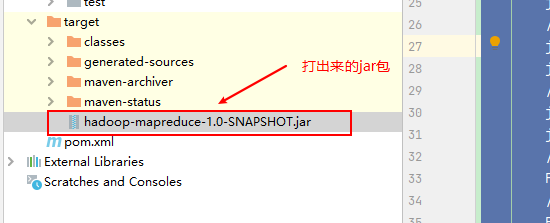
- 打包并上传到虚拟机上
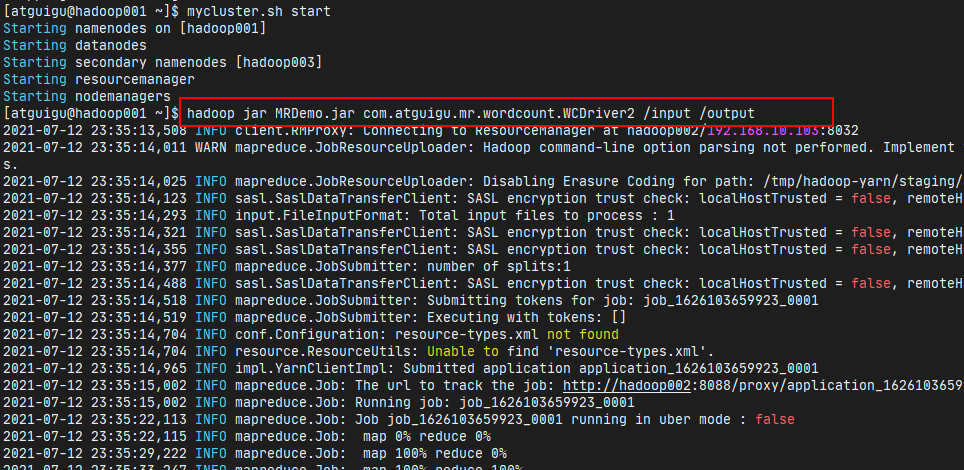
- 群起集群后测试
- 去web端查看结果
)
七.本地向集群提交
Driver(WCDriver3)
package com.atguigu.mr.wordcount;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

/*
将MR打包在集群上运行
hadoop jar xxx.jar com.atguigu.mr.wordcount.WCDriver2 参数1 参数2
 */
/*
1. Configuration conf = new Configuration();//可以在该对象中做一些设置
        //设置在集群运行的相关参数-设置HDFS,NAMENODE的地址
        conf.set("fs.defaultFS", "hdfs://hadoop001:9820");
        //指定MR运行在Yarn上
        conf.set("mapreduce.framework.name","yarn");
        //指定MR可以在远程集群运行
        conf.set(
                "mapreduce.app-submission.cross-platform","true");
        //指定yarn resourcemanager的位置
        conf.set("yarn.resourcemanager.hostname",
                "hadoop002");
2.打包
3.设置jar包的路径
4.将job.setJarByClass(WCDriver3.class);注释掉
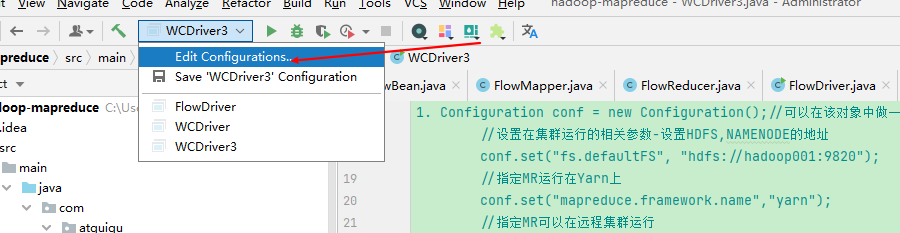
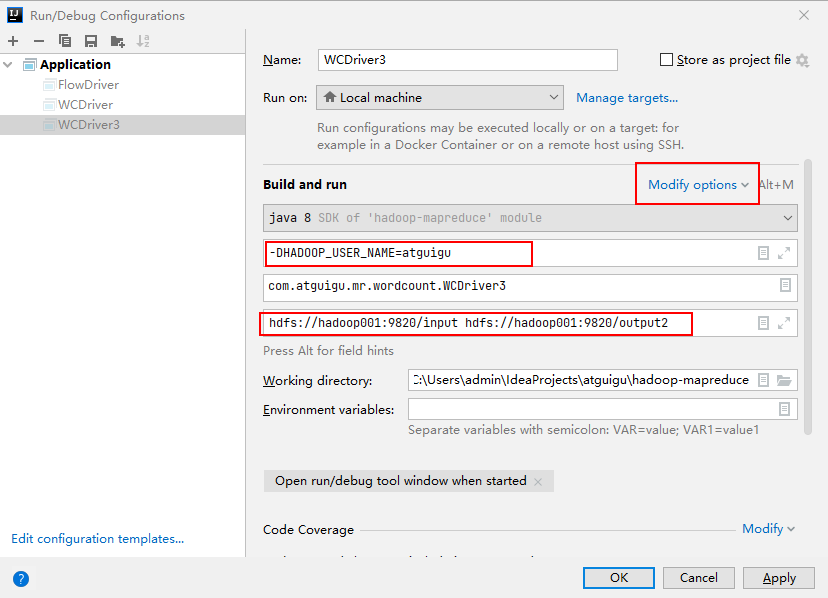
5.进行idea的设置,详情看图

 */
public class WCDriver3 {
    public static void main(String[] args) throws Exception{
        //1.创建job对象
        Configuration conf = new Configuration();//可以在该对象中做一些设置
        //设置在集群运行的相关参数-设置HDFS,NAMENODE的地址
        conf.set("fs.defaultFS", "hdfs://hadoop001:9820");
        //指定MR运行在Yarn上
        conf.set("mapreduce.framework.name","yarn");
        //指定MR可以在远程集群运行
        conf.set(
                "mapreduce.app-submission.cross-platform","true");
        //指定yarn resourcemanager的位置
        conf.set("yarn.resourcemanager.hostname",
                "hadoop002");


        Job job = Job.getInstance();
        //2.给job对象的属性赋值
        //设置jar加载路径(如果是本地模式,可以不设置)
        //job.setJarByClass(WCDriver3.class);
        //设置Jar包的路径
        job.setJar("C:\\Users\\admin\\IdeaProjects\\atguigu\\hadoop-mapreduce\\target\\hadoop-mapreduce-1.0-SNAPSHOT.jar");
        //设置Mapper和Reduce类
        job.setMapperClass(WCMapper.class);
        job.setReducerClass(WCReducer.class);
        //设置Mapper输出的k,v类型
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(IntWritable.class);
        //设置最终输出的K,V类型
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);
        //设置数据的输入和输出路径
        FileInputFormat.setInputPaths(job,new Path(args[0]));
        //注意输出路径不能存在
        FileOutputFormat.setOutputPath(job,new Path(args[1]));
        //3.提交job对象
        /*
        参数:是否打印进度
        返回值:如果是true则表示job执行成功
         */
        boolean b = job.waitForCompletion(true);
        System.exit(b ? 0 : 1);
    }
}

第二章 Hadoop序列化
1.序列化概述
# 什么是序列化
- 序列化就是将内存中的对象,转换成字节序列(或其他数据传输协议)以便存储到磁盘(持久化和网络传输)
- 反序列化就是将收到字节序列(或其他数据传输协议)或者是磁盘的持久化数据,转换成内存中的对象
# 为什么要序列化
- 一般来说,活的对象只生存在内存里,关机断电就没有了,而且活的对象只能由本地的进程使用,不能被发送到网络上的另一台计算机,然而序列化可以存储活的对象,可以将活的对象发送到远程计算机
# 为什么不用Java的序列化
- Java的序列化框架是一个重量级序列化框架(Serializable),一个对象被序列化以后,会附带很多额外的信息(各种校验信息,Header,继承体等等),不便于在网络中高效传输,所以Hadoop就自己开发了一套序列化机制
# Hadoop序列化特点
1. 紧凑:高效使用存储空间
2. 快速:读写数据的额外开销小
3. 可扩展:随着通信协议的升级可升级
4. 互操作:支持多语言的交互
2.自定义bean对象实现序列化接口(Writable)
在企业开发中往往常用的基本序列化类型不能满足所有的需求,比如在Hadoop框架内部传递一个bean对象,那么该对象就需要实现序列化接口
具体实现bean对象序列化步骤有如下7步
# 实现bean对象序列化步骤
1. 必须实现Writable接口
2. 反序列化时,需要反射调用空参构造函数,所以必须有空参构造
3. 重写序列化方法
4. 重写反序列化方法(注意反序列化的顺序和序列化的顺序完全一致)
5. 要想把结果显示在文件中,需要重写toString(),可用"\t"分开,方便后调用
7. 如果需要将自定义的bean放在key中传输,则还需要实现Comparable接口,因为MapReduce框中的Shuffle过程要求对key必须能排序
3.案例实操
需求:统计每一个手机号耗费的总上行流量,下行流量,总流量
输入数据 : phone_data.txt
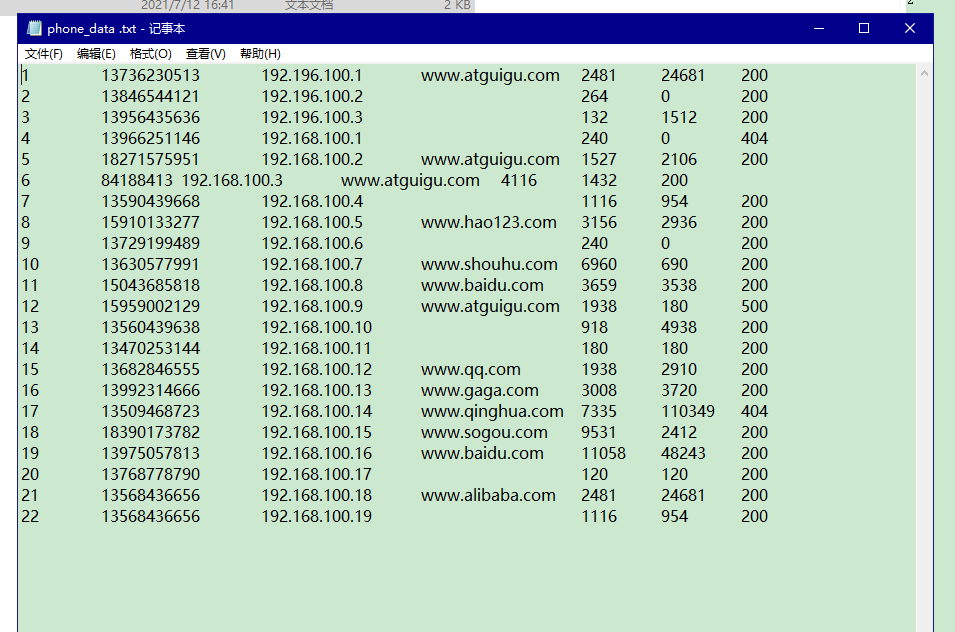
输入数据格式
| id | 手机号码 | 网络ip | 上行流量 | 下行流量 | 网络状态码 |
|---|---|---|---|---|---|
| 7 | 13560436666 | 120.196.100.99 | 1116 | 954 | 200 |
期望输出数据格式
| 手机号码 | 上行流量 | 下行流量 | 总流量 |
|---|---|---|---|
| 13560436666 | 1116 | 954 | 2070 |
一.需求分析

二.编写用于流量统计的Bean对象
package com.atguigu.mr.writable;

import org.apache.hadoop.io.Writable;

import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;

/*
Hadoop序列化框架
1.自定义一个类并实现Writable接口
2.重写write和readFile方法
3,当序列化时调用write方法
当反序列化时调用readFiles方法
4.反序列化时读取数据的顺序要和序列化时写数据的顺序保持一致
 */
public class FlowBean implements Writable {
    private long upFlow;
    private long downFlow;
    private long sumFlow;

    public FlowBean(){

    }

    public FlowBean(long upFlow, long downFlow) {
        this.upFlow=upFlow;
        this.downFlow=downFlow;
        this.sumFlow =upFlow+downFlow;
    }
    /**
    * @Description: 当序列化时调用此方法
    * @Param: [dataOutput]
    * @return: void
    * @Author: jcsune
    * @Date: 2021/7/12
    */
    @Override
    public void write(DataOutput out) throws IOException {
        out.writeLong(upFlow);
        out.writeLong(downFlow);
        out.writeLong(sumFlow);
    }
    /**
    * @Description: 当反序列化时调用此方法,注意反序列化时读取数据的顺序要和序列化时写数据的顺序保持一致
    * @Param: [in]
    * @return: void
    * @Author: jcsune
    * @Date: 2021/7/12
    */
    @Override
    public void readFields(DataInput in) throws IOException {
       upFlow = in.readLong();
       downFlow = in.readLong();
       sumFlow = in.readLong();

    }

    public long getUpFlow() {
        return upFlow;
    }

    public void setUpFlow(long upFlow) {
        this.upFlow = upFlow;
    }

    public long getDownFlow() {
        return downFlow;
    }

    public void setDownFlow(long downFlow) {
        this.downFlow = downFlow;
    }

    public long getSumFlow() {
        return sumFlow;
    }

    public void setSumFlow(long sumFlow) {
        this.sumFlow = sumFlow;
    }

    @Override
    public String toString() {
        return upFlow + " " + downFlow + " " +sumFlow;
    }
}
三.编写Mapper类
package com.atguigu.mr.writable;

import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;
/*
    作用:实现MapTesk中需要实现的业务逻辑代码
    说明: 1.MapTask会调用Mapper类
 */

public class FlowMapper extends Mapper<LongWritable, Text,Text,FlowBean> {
    /**
    * @Description: 实现MapTesk 中需要实现的业务逻辑代码
    * @Param: [key, value, context] [读取的数据的偏移量,读取的数据的类型(一行一行的数据),上下文(在这用于将数据写出去)]
    * @return: void
    * @Author: jcsune
    * @Date: 2021/7/12
    */
    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        //将value转成字符串
        String line = value.toString();
        //将数据切割
        String[] flowInfo = line.split("\t");
        //封装k,v
        Text outkey = new Text(flowInfo[1]);
        FlowBean outValue = new FlowBean(Long.parseLong(flowInfo[flowInfo.length -3]),Long.parseLong(flowInfo[flowInfo.length -2]));
        //写出k,v
        context.write(outkey,outValue);

    }
}
四.编写Reducer类
package com.atguigu.mr.writable;

import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;


/*
作用:实现ReduceTask需要实现的业务逻辑代码
Reducer<KEYIN, VALUEIN, KEYOUT, VALUEOUT>
KEYIN:读取数据的key类型(Mapper输出的key的类型)
VALUEIN:读取数据时的value的类型(Mapper输出的value类型)
KeyOut:写出数据的key的类型,(在这里就是单词的类型)
ValueOut:写出数据时的value类型(在这里就是单词数量的类型)

 */
public class FlowReducer extends Reducer<Text,FlowBean,Text,FlowBean> {


    @Override
    protected void reduce(Text key, Iterable<FlowBean> values, Context context) throws IOException, InterruptedException {
       int sumUpFlow = 0;
       int sumDownFlow = 0;

       //i遍历所有的value
        for(FlowBean value : values){
            //将上行流量,下行流量进行累加
            sumUpFlow += value.getUpFlow();
            sumDownFlow += value.getDownFlow();


        }
        //封装k,v
        FlowBean outValue = new FlowBean(sumUpFlow,sumDownFlow);
        //写出k,v
        context.write(key,outValue);
    }
}
五.编写Driver类
package com.atguigu.mr.writable;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class FlowDriver {
    public static void main(String[] args) throws Exception{
        //创建Job对象
        Job job = Job.getInstance(new Configuration());
        //给Job对象的属性赋值
        job.setJarByClass(FlowDriver.class);
        job.setMapperClass(FlowMapper.class);
        job.setReducerClass(FlowReducer.class);
        //2.3设置Mapper输出的k,v的类型
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(FlowBean.class);
        //2.4设置最终输出的K,V的类型(在这是Reducer输出的K,V类型)
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(FlowBean.class);
        //2.5设置数据的输入和输出路径
        FileInputFormat.setInputPaths(job,new Path("C:\\io\\input2"));
        //注意:输出路径不能存在!!!!!!!!!!!!
        FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output2"));

        //3.提交Job对象(执行Job)
        /*
            参数 :是否打印进度
            返回值 :如果是true则表示job执行成功
         */
        job.waitForCompletion(true);
    }
}
六.执行程序后查看结果


若有收获,就点个赞吧
0 人点赞


