第一章.Kafka架构深入
1.kafka生产者
1.带回调函数的API
回调函数会在producer收到ack时调用,为异步调用,该方法有两个参数,分别是RecordMetaData 和Exception,如果Exception为null,说明消息发送成功,如果Exception不为null,说明消息发送失败
注意:消息发送失败会自动重试,不需要我们在回调函数中手动重试
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.*;import java.util.Properties;import java.util.concurrent.TimeUnit;public class CustomProducerWithCallBack {public static void main(String[] args) {//1.创建kafka生产者的配置对象Properties properties = new Properties();//2.给kafka配置对象添加配置信息properties.put("bootstrap.servers","hadoop102:9092");properties.put(ProducerConfig.BATCH_SIZE_CONFIG,16384);properties.put(ProducerConfig.LINGER_MS_CONFIG,10);properties.put(ProducerConfig.BUFFER_MEMORY_CONFIG,33554432);properties.put(ProducerConfig.ACKS_CONFIG,"all");properties.put(ProducerConfig.RETRIES_CONFIG,3);//key,value序列化properties.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,"org.apache.kafka.common.serialization.StringSerializer");properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");//初始化生产者KafkaProducer<String, String> producer = new KafkaProducer<>(properties);ProducerRecord<String,String> producerRecord = null;for(int i =1;i<10;i++){//将数据包装为ProducerRecordproducerRecord = new ProducerRecord<String,String>("first",0,"aa" + i,"尚硅谷" + i);//发送数据producer.send(producerRecord, new Callback() {@Overridepublic void onCompletion(RecordMetadata recordMetadata, Exception e) {if(e == null){long offset = recordMetadata.offset();int partition = recordMetadata.partition();System.out.println("partition:"+ partition+",offset:" + offset);}else{e.printStackTrace();}}});}try{TimeUnit.SECONDS.sleep(1);}catch(Exception e){e.printStackTrace();}}}
2.同步发送API
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.*;import java.util.Properties;import java.util.concurrent.TimeUnit;public class CustomProducerWithCallBackSync {public static void main(String[] args) {//1.创建kafka生产者的配置对象Properties properties = new Properties();//2.给kafka配置对象添加配置信息properties.put("bootstrap.servers","hadoop102:9092");properties.put(ProducerConfig.BATCH_SIZE_CONFIG,16384);properties.put(ProducerConfig.LINGER_MS_CONFIG,10);properties.put(ProducerConfig.BUFFER_MEMORY_CONFIG,33554432);properties.put(ProducerConfig.ACKS_CONFIG,"all");properties.put(ProducerConfig.RETRIES_CONFIG,3);//key,value序列化properties.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,"org.apache.kafka.common.serialization.StringSerializer");properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");//初始化生产者KafkaProducer<String, String> producer = new KafkaProducer<>(properties);ProducerRecord<String,String> producerRecord = null;try{for(int i =1;i<10;i++){//将数据包装为ProducerRecordproducerRecord = new ProducerRecord<String,String>("first",0,"aa" + i,"尚硅谷" + i);//发送数据producer.send(producerRecord, new Callback() {@Overridepublic void onCompletion(RecordMetadata recordMetadata, Exception e) {if(e == null){long offset = recordMetadata.offset();int partition = recordMetadata.partition();System.out.println("partition:"+ partition+",offset:" + offset);}else{e.printStackTrace();}}}).get();System.out.println("你看看我在哪");}TimeUnit.SECONDS.sleep(1);}catch(Exception e){e.printStackTrace();}}}
3.分区策略
分区的原因:
- 方便在集群中扩展,每个Partition可以通过调整以适应它所在的机器,而一个topic又可以有多个Partition租成,因此整个集群就可以适应任意大小的数据了
- 可以提高并发,因为可以以Partition为单位读写了
分区的原则:我们需要将producer发送的数据封装成一个ProducerRecord对象
- 指明partition的情况下,直接将指明的值直接作为Partition值
- 没有指明partition值但有key的情况下,将key的hash值与topic的partition数进行取余得到partition
- 既没有partition值又没有key值的情况下,kafka采用StickyPartition(黏性分区器),会随机选择一个分区,并尽可能一直使用该分区,待该分区的batch已满或者已完成,kafka再随机一个分区进行使用
4.分区器
默认的分区器: Defaultpartitioner
自定义分区器: CustomPartitioner
package com.atguigu.kafka.partitioner;import org.apache.kafka.clients.producer.Partitioner;import org.apache.kafka.common.Cluster;import java.util.Map;public class CustomPartitioner implements Partitioner {@Overridepublic int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) {String KeyStr = (String) key;Integer KeyInt = Integer.valueOf(KeyStr);return KeyInt % 2;}@Overridepublic void close() {}@Overridepublic void configure(Map<String, ?> configs) {}}
使用分区器的方法,在生产者的配置中添加分区器参数
//设置自定义分区器properties.put(ProducerConfig.PARTITIONER_CLASS_CONFIG,"com.atguigu.kafka.partitioner.CustomPartitioner");
5.数据可靠性保证
# 生产者发送数据到topic partition的可靠性保证- 为保证producer发送的数据能可靠的发送到指定的topic,topic的每个partition收到producer发送的数据后,都需要向producer发送ack(acknowledgement 确认收到),如果producer收到ack,就会进行下一轮的发送,否则重新发送数据
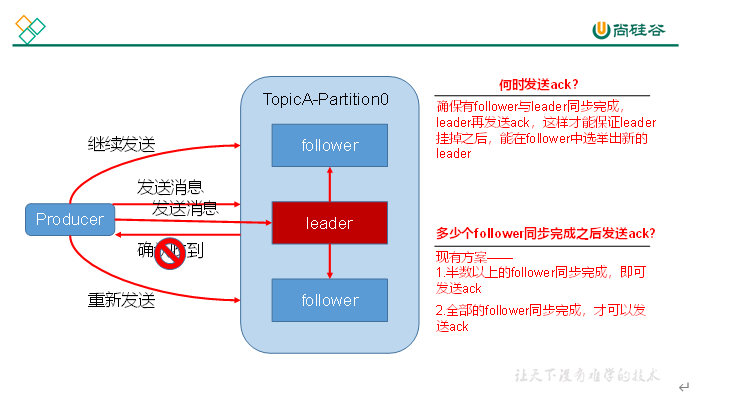
Topic partition 存储数据的可靠性保证
- 副本数据同步策略 | 方案 | 优点 | 缺点 | | —- | —- | —- | | 半数以上完成同步,就发送ack | 延迟低 | 选取新的leader时,容忍n台节点的故障,需要2n+1个副本 | | 全部完成同步,才发送ack | 选取新的leader时,容忍n台节点的故障,需要n+1个副本 | 延迟高 |
kafka选择了第二种方案,原因如下
- 同样是为了容忍n台节点的故障,第一种方案需要2n+1个副本,而第二种方案只需要n+1个副本,而Kafka的每个分区都有大量的数据,第一种方案会造成大量数据的冗余
- 虽然第二种方案的网络延迟会比较高,但网络延迟对kafka的影响较小
- ISR
- 采用第二种方案之后,设想以下情景:leader收到数据,所有follower都开始同步数据,但有一个follower,因为某种故障,迟迟不能与leader进行同步,那leader就要一直等下去,直到它完成同步,才能发送ack。这个问题怎么解决呢?- Leader维护了一个动态的in-sync replica set (ISR),意为和leader保持同步的follower集合。当ISR中的follower完成数据的同步之后,leader就会给producer发送ack。如果follower长时间未向leader同步数据,则该follower将被踢出ISR,该时间阈值由replica.lag.time.max.ms参数设定。Leader发生故障之后,就会从ISR中选举新的leader。
- ack问答级别
- 对于某些不太重要的数据,对数据的可靠性要求不是很高,能够容忍数据的少量丢失,所以没必要等ISR中的follower全部接收成功- 所以kafka为用户提供了三种可靠性级别,用户根据对可靠性和延迟的要求进行权衡,选择以下的配置
ack参数配置:
- 0 : 这一操作提供了一个最低的延迟,partition的leader接收到消息还没有写入到磁盘就已经返回ack,当leader故障时有可能丢失数据
- 1 : partition的leader落盘成功后返回ack,如果在follower同步之前leader故障,那么将会丢失数据
- -1(all) : partition的leader和follower全部落盘成功后才返回ack,但是如果在follower同步完成后,broker发送ack之前,leader发生故障,那么 会造成数据重复
- leader和follower故障处理细节

LEO: 指的是每个副本最大的offset
HW :指的是消费者能见到的最大的offset,ISR队列中最小的LEO
# follower 故障follower发生故障后会被临时踢出ISR,待该follower恢复后,follower会读取本地磁盘记录的上次的HW,并将log文件高于HW的部分截取掉,从HW开始向leader进行同步。等该follower的LEO大于等于该Partition的HW,即follower追上leader之后,就可以重新加入ISR了。# leader 故障leader发生故障之后,会从ISR中选出一个新的leader,之后,为保证多个副本之间的数据一致性,其余的follower会先将各自的log文件高于HW的部分截掉,然后从新的leader同步数据。注意:这只能保证副本之间的数据一致性,并不能保证数据不丢失或者不重复。
6.Exactly Once语义
将服务器的ACK级别设置为-1,可以保证Producer到Server之间不会丢失数据,即At Least Once语义。相对的,将服务器ACK级别设置为0,可以保证生产者每条消息只会被发送一次,即At Most Once语义。At Least Once可以保证数据不丢失,但是不能保证数据不重复;相对的,At Most Once可以保证数据不重复,但是不能保证数据不丢失。但是,对于一些非常重要的信息,比如说交易数据,下游数据消费者要求数据既不重复也不丢失,即Exactly Once语义。在0.11版本以前的Kafka,对此是无能为力的,只能保证数据不丢失,再在下游消费者对数据做全局去重。对于多个下游应用的情况,每个都需要单独做全局去重,这就对性能造成了很大影响。0.11版本的Kafka,引入了一项重大特性:幂等性。所谓的幂等性就是指Producer不论向Server发送多少次重复数据,Server端都只会持久化一条。幂等性结合At Least Once语义,就构成了Kafka的Exactly Once语义。即:At Least Once + 幂等性 = Exactly Once要启用幂等性,只需要将Producer的参数中enable.idempotence设置为true即可。Kafka的幂等性实现其实就是将原来下游需要做的去重放在了数据上游。开启幂等性的Producer在初始化的时候会被分配一个PID,发往同一Partition的消息会附带Sequence Number。而Broker端会对<PID, Partition, SeqNumber>做缓存,当具有相同主键的消息提交时,Broker只会持久化一条。但是PID重启就会变化,同时不同的Partition也具有不同主键,所以幂等性无法保证跨分区跨会话的Exactly Once。
7.Producer事务
0.11版本的Kafka同时引入了事务的特性,为了实现跨分区跨会话的事务,需要引入一个全局唯一的Transaction ID,并将Producer获得的PID和Transaction ID绑定。这样当Producer重启后就可以通过正在进行的Transaction ID获得原来的PID。为了管理Transaction,Kafka引入了一个新的组件Transaction Coordinator。Producer就是通过和Transaction Coordinator交互获得Transaction ID对应的任务状态。Transaction Coordinator还负责将事务所有写入Kafka的一个内部Topic,这样即使整个服务重启,由于事务状态得到保存,进行中的事务状态可以得到恢复,从而继续进行。
2.kafka消费者
1. 消费方式
consumer采用pull(拉)模式从broker中读取数据push(推)模式很难适应消费速率不同的消费者,因为消息发送速率是由broker决定的,它的目标是尽可能以最快速度传递消息,但是这样很容易造成consumer来不及处理消息,典型的表现就是拒绝服务以及网络拥塞,而pull模式则可以根据consumer的消费能力以适当的速率消费消息pull模式不足之处是,如果kafka没有数据,消费者可能会陷入循环中,一直返回空数据,针对这一点,kafka的消费者在消费数据时会传入一个时长参数timeout,如果当前没有数据可供消费,consumer会等待一段时间之后再返回,这段时长即为timeout
2.简单消费者
注意: 在消费者代码中必须配置消费者组,命令行启动消费者不填写消费者组会被自动填写随机的消费者组
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.ConsumerRecord;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.KafkaConsumer;import java.time.Duration;import java.util.ArrayList;import java.util.Properties;public class CustomConsumer01 {public static void main(String[] args) {//配置配置对象Properties properties = new Properties();properties.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop102:9092,hadoop103:9092,hadoop104:9092");properties.put(ConsumerConfig.GROUP_ID_CONFIG,"test");properties.put(ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG,"org.apache.kafka.clients.consumer.StickyAssignor");properties.put(ConsumerConfig.EXCLUDE_INTERNAL_TOPICS_CONFIG,"false");properties.put(ConsumerConfig.AUTO_COMMIT_INTERVAL_MS_CONFIG,100);properties.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG,false);properties.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"earliest");properties.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG,"org.apache.kafka.common.serialization.StringDeserializer");properties.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG,"org.apache.kafka.common.serialization.StringDeserializer");//创建consumer对象KafkaConsumer<String, String> consumer = new KafkaConsumer<String, String>(properties);//订阅topicArrayList<String> topics = new ArrayList<String>();topics.add("first");consumer.subscribe(topics);while(true){ConsumerRecords<String, String> consumerRecords = consumer.poll(Duration.ofSeconds(5));for (ConsumerRecord<String, String> consumerRecord : consumerRecords) {String value = consumerRecord.value();int partition = consumerRecord.partition();long offset = consumerRecord.offset();//提交 数据丢失System.out.println("数据 : " + value + ", 分区:" + partition + ", 偏移量:" + offset);}consumer.commitSync();}}}
3.消费者组案例
需求: 测试同一个主题的分区,同一个时刻只能有一个消费者消费
复制3份基础消费者的代码
当只启动一个消费者时
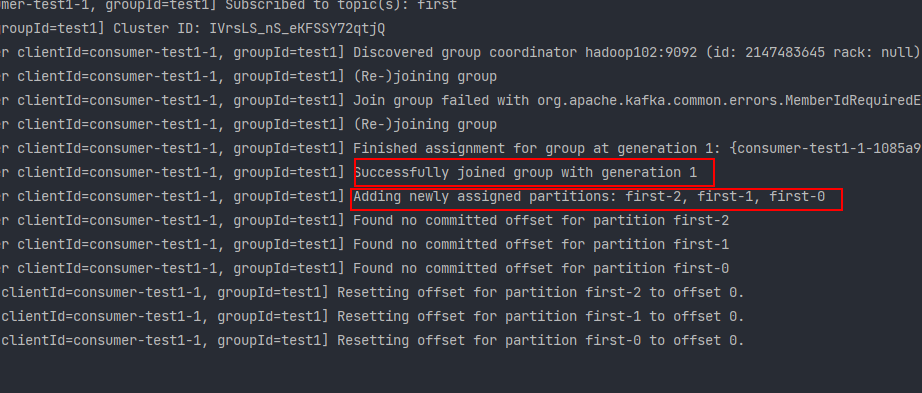
加入二号消费者
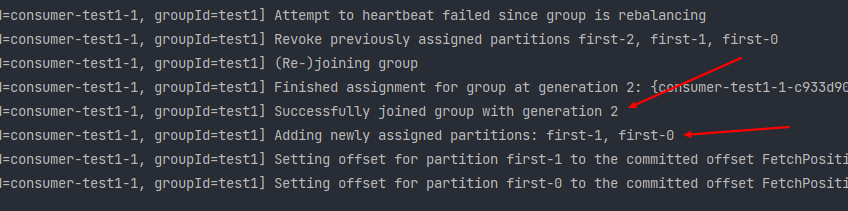
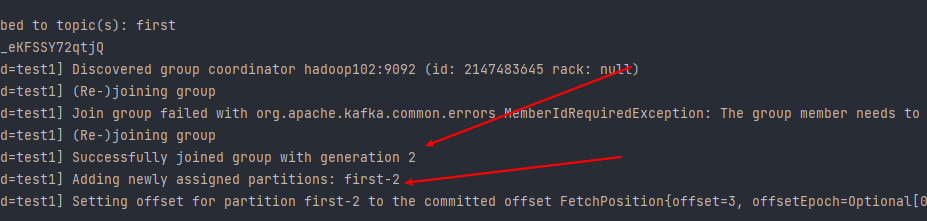
加入三号消费者
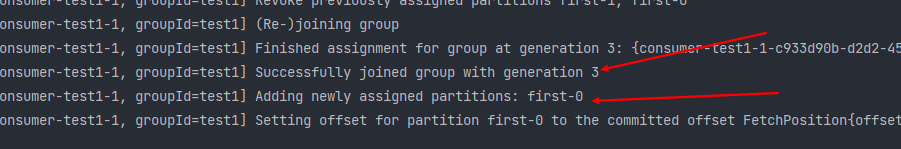

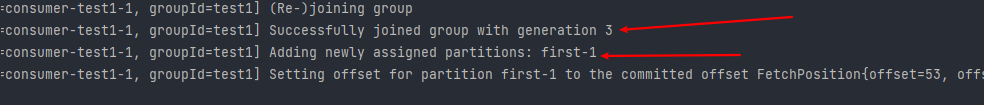
加入四号消费者
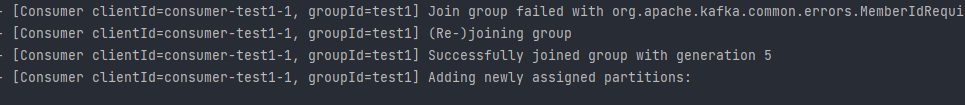
4.分区分配策略
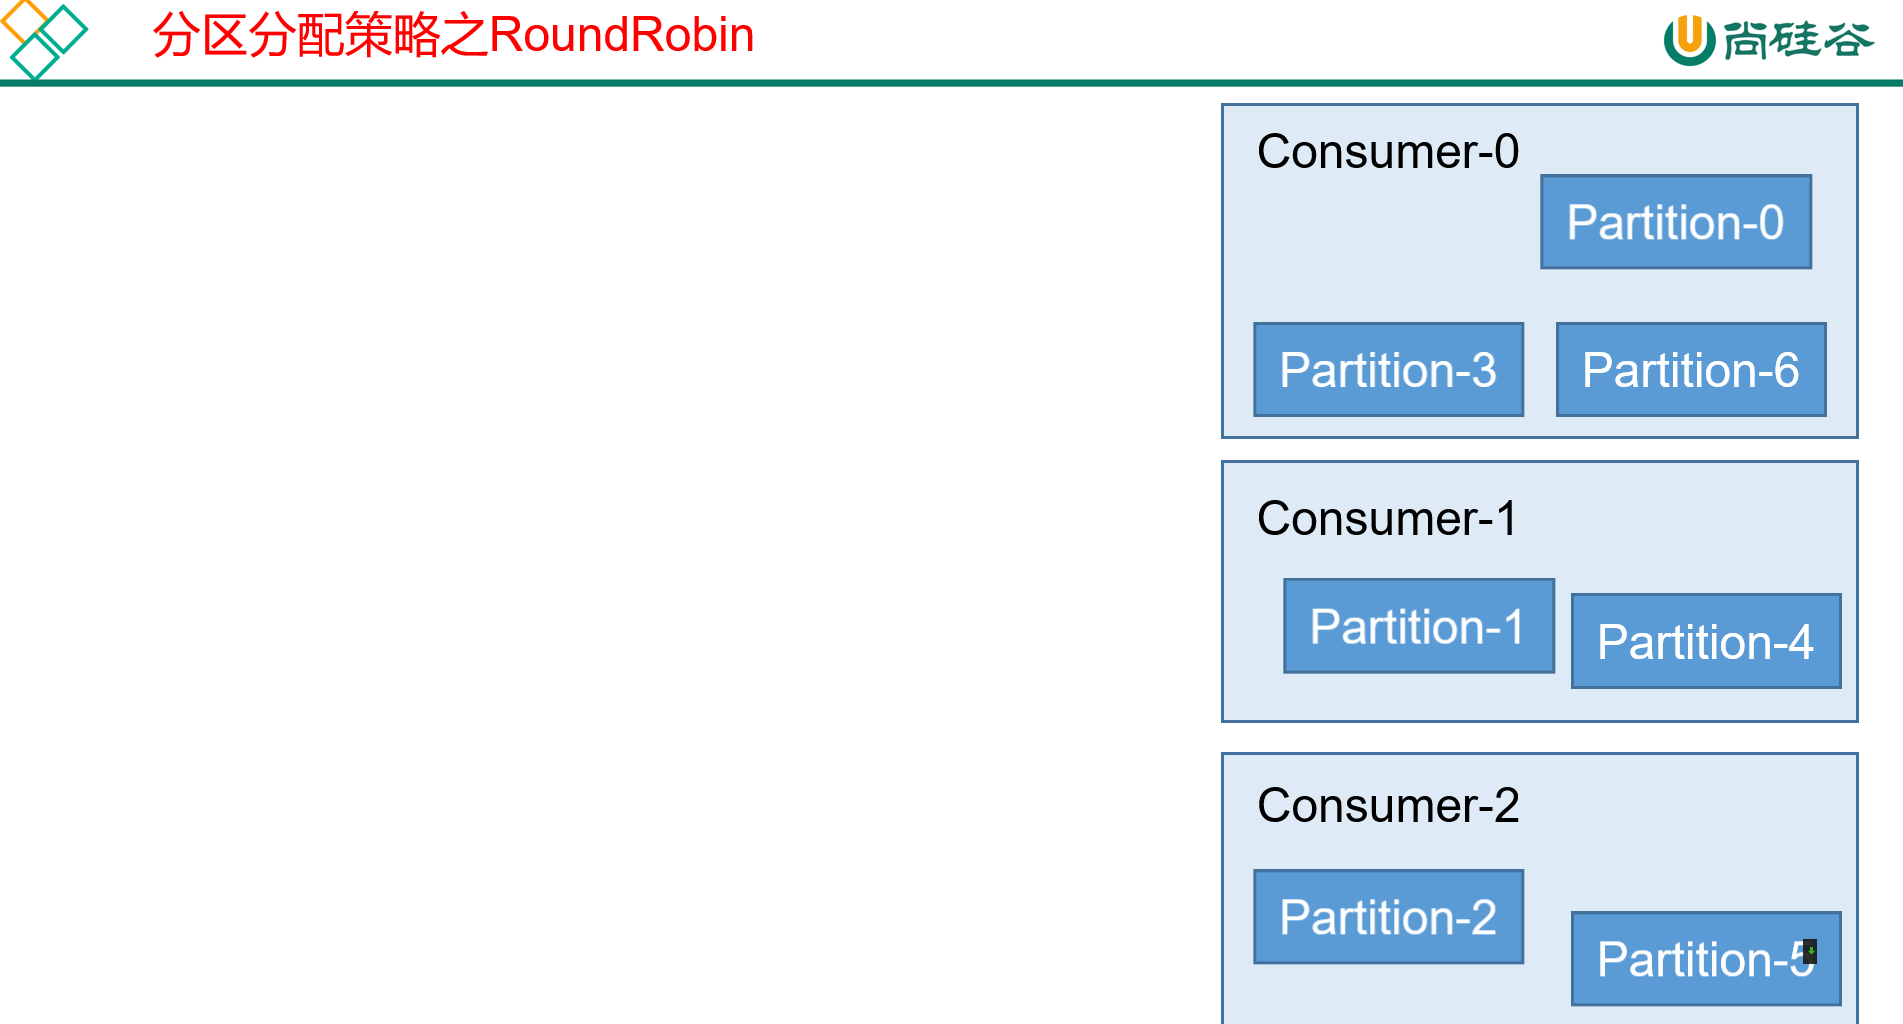
一个consumer group 中有多个consumer,一个topic中有多个partition.所以必然会涉及到partition的分配问题,即确定哪个partition由哪个consumer来消费
kafka有两种分配策略,RoundRobin ,Range
- Roundrobin(轮询)

- Range(范围)
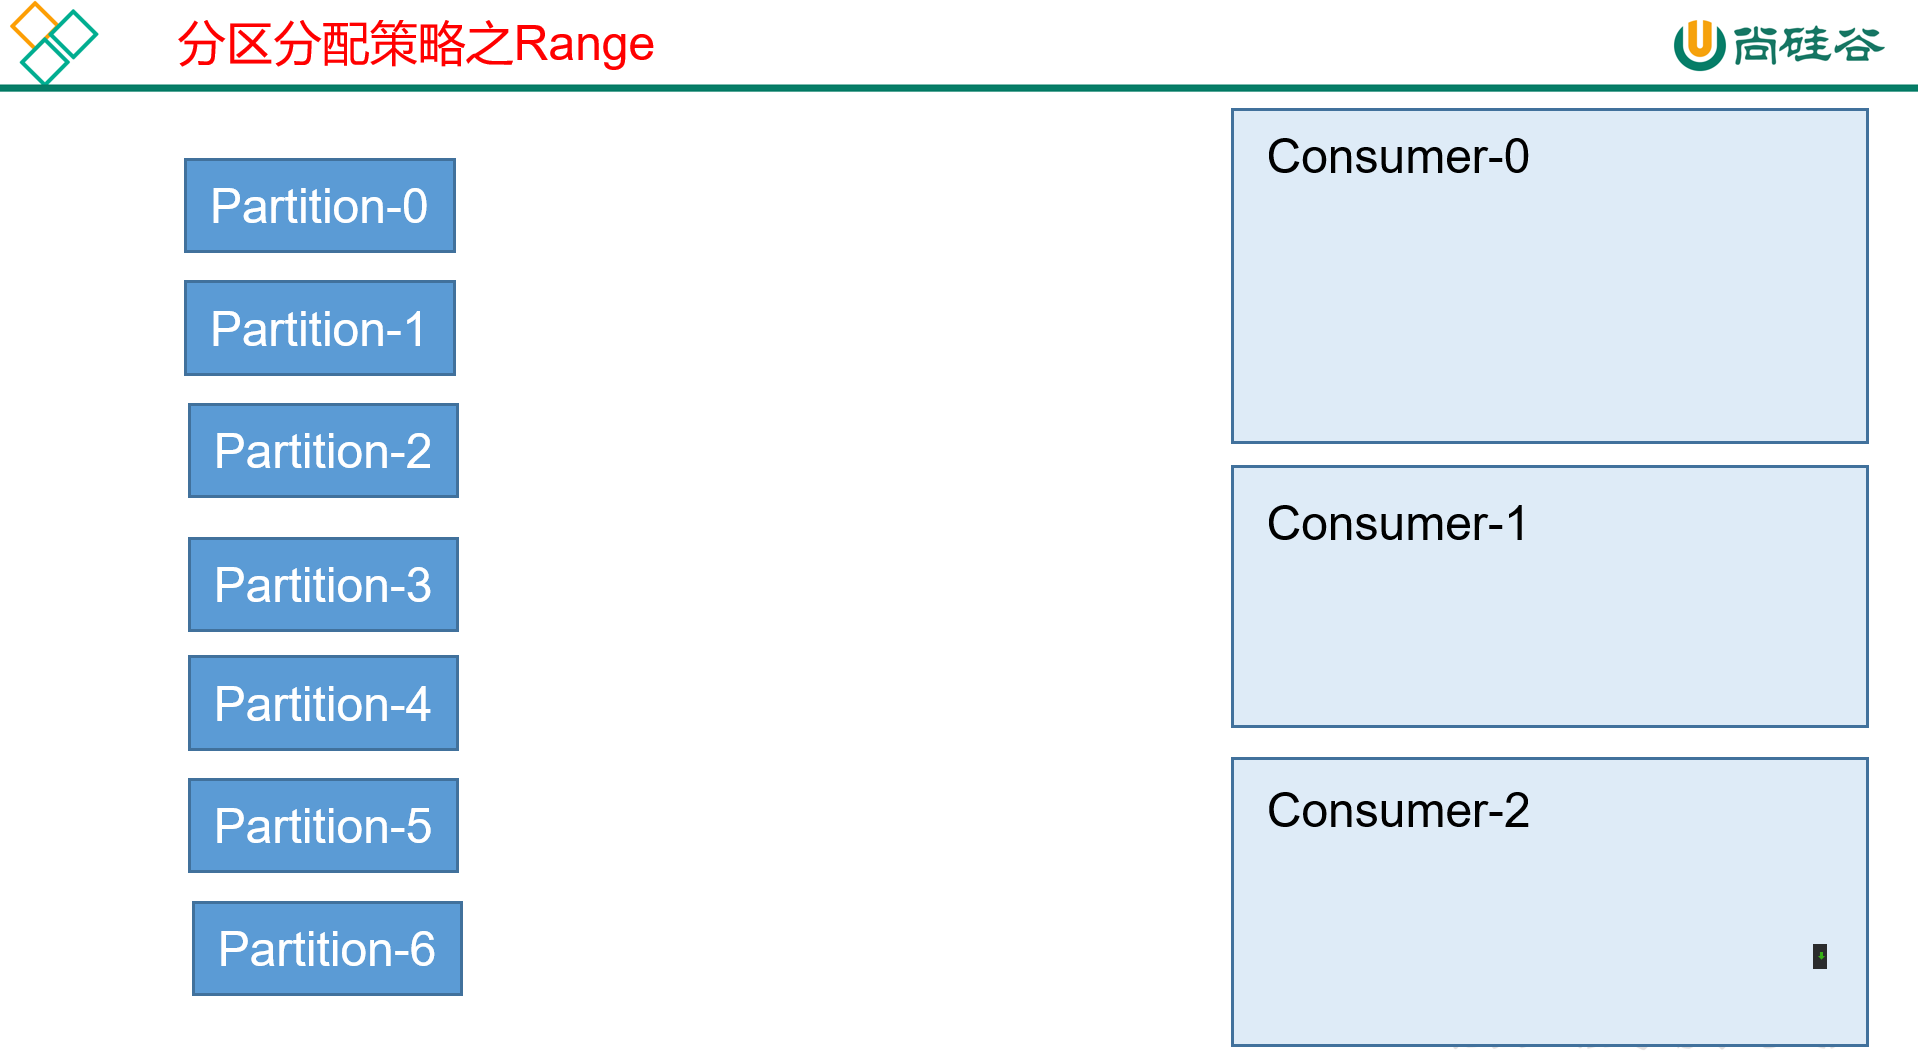

- Sticky(黏性分区策略)
特殊的分配策略StickyAssignor,Kafka从0.11x版本开始引入这种分配策略,在出现同一消费者组内出现问题的时候,会进行使用
# 修改分区分配策略properties.put(ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG, "org.apache.kafka.clients.consumer.StickyAssignor");
5.offset的维护
由于consumer在消费过程中可能会出现断电宕机等故障,consumer恢复后,需要从故障前的位置继续消费,所以consumer需要实时记录自己消费到了哪个offset,以便故障恢复后继续消费Kafka0.9版本之前,consumer默认将offset保存在Zookeeper中,从0.9版本开始.consumer默认将offset保存在kafka一个内置的topic中,该topic为_consumer_offsets
消费offset的案例
- 在命令行中创建一个新的topic
kafka-topics.sh --create --topic atguigu --bootstrap-server hadoop102:9092 --partitions2 --replication-factor 2
- 添加配置参数
// 不排除内部offset,不然看不到__consumer_offsetsproperties.put(ConsumerConfig.EXCLUDE_INTERNAL_TOPICS_CONFIG,"false");
- 在配置文件中添加配置(config/consumer.properties)
exclude.internal.topics=false
- 启动消费者消费主题
kafka-console-consumer.sh --topic __consumer_offsets --bootstrap-server hadoop102:9092 --consumer.config config/consumer.properties --formatter "kafka.coordinator.group.GroupMetadataManager\$OffsetsMessageFormatter" --from-beginning
6.自动提交offset
// 是否自动提交offsetproperties.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "true");// 提交offset的时间周期properties.put(ConsumerConfig.AUTO_COMMIT_INTERVAL_MS_CONFIG, "1000");
7.重置offset
auto.offset.reset=earliest|latest|none|
当kafka中没有初始偏移量(消费者组第一次消费)或服务器上不再存在当前偏移量时(例如该数据已被删除),该怎么办(1) earliest:自动将偏移量重置为最早的偏移量(2) latest(默认值):自动将偏移量重置为最新偏移量(3) none:如果未找到消费者组的先前偏移量,则向消费者抛出异常
3.kafka高效读写数据
1.顺序写磁盘
Kafka的producer生产数据,要写入到log文件中,写的过程中是一直追加到文件末端,为顺序写,官网有数据表明,同样的磁盘,顺序写能到600MB/s,而随机写只有100k/s,这与磁盘的机械结构有关,顺序写之所以快,是因为其省去了大量磁头寻址的时间
2.应用页缓存技术
kafka数据持久化时直接持久化到Pagecache中,这样会产生以下几个好处
- I/O Scheduler 会将连续的小块写组装成大块的物理写从而提高性能
- I/O Scheduler 会尝试将一些写操作重新按顺序排好,从而减少磁盘头的移动时间
- 充分利用所有空闲内存(非JVM内存),如果使用应用层Cache(即JVM堆内存),会增加GC负担
- 读操作可直接在Page Cache内进行,如果消费和生产速度相当,甚至不需要通过物理磁盘(直接通过Page Cache)交换数据
- 如果进程重启,JVM内的Cache会失效,但page cache仍然可用
尽管持久化到pagecache上可能造成宕机丢失数据的情况,但这可以被kafka的Replication机制解决,如果为了保证这种情况下数据不丢失而强制将Page cache中的数据Flush到磁盘,反而会降低性能
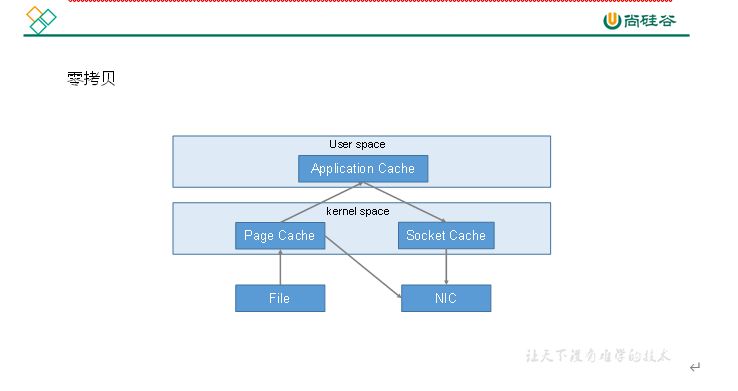
3.零复制技术
4.Zookeeper在kafka中的作用
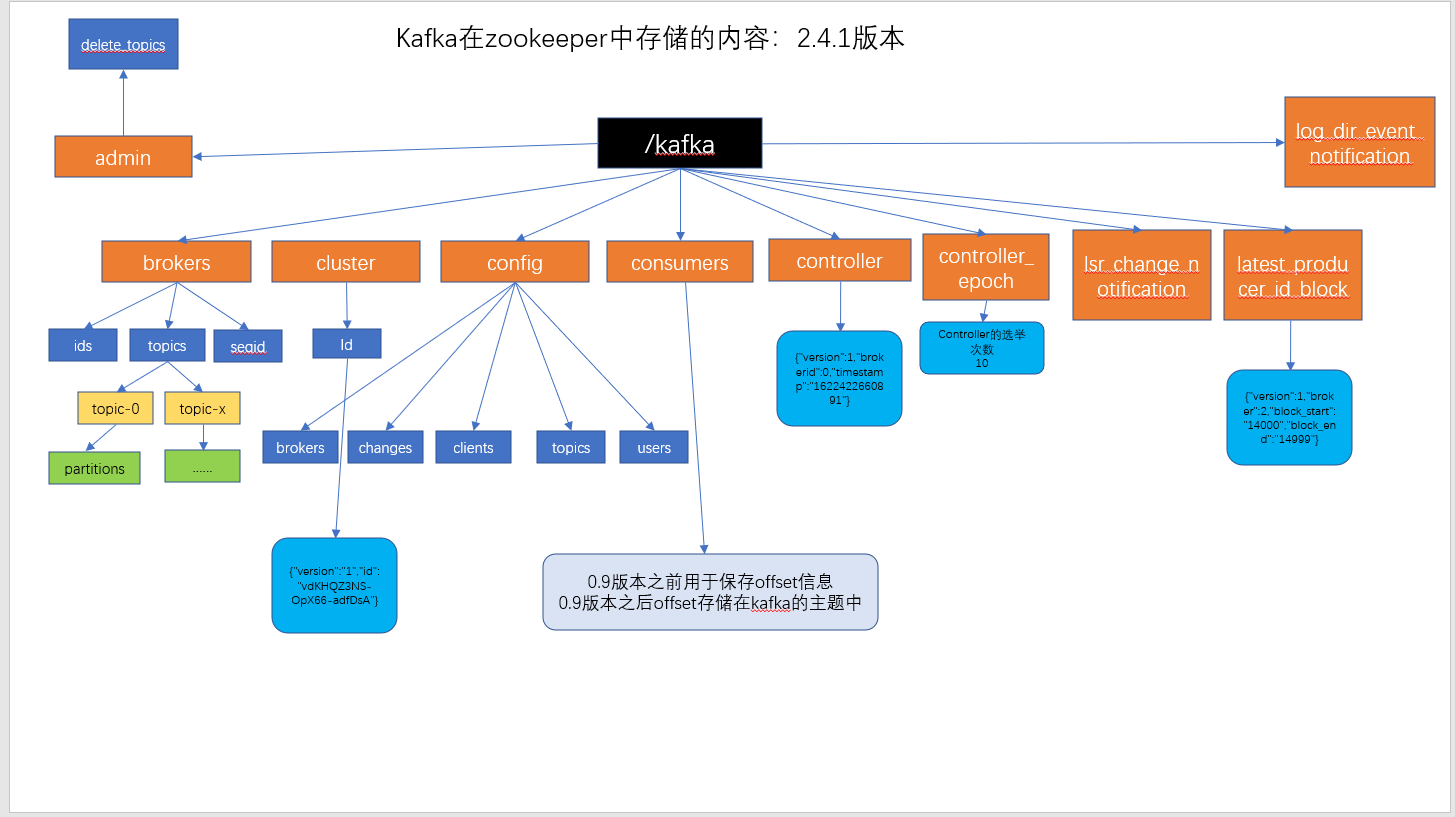
kafka集群中有一个broker会被选举为Controller,负责管理集群broker的上下线,所有topic的分区副本分配和leader选举等工作Controller的管理工作都是依赖于Zookeeper
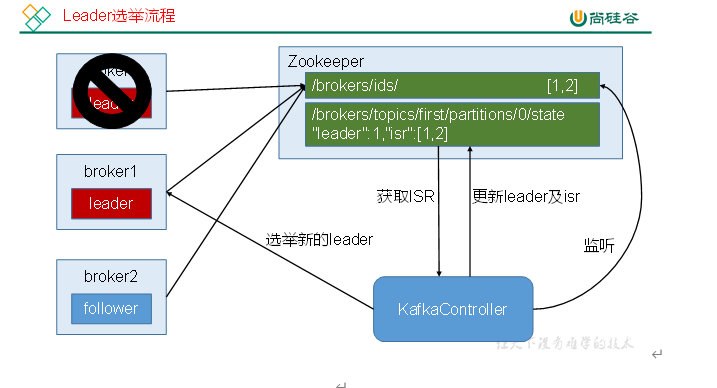
partition的leader选举过程
第二章.Kafka监控
1.kafka-eagle
- 修改/opt/module/kafka-2.4.1/bin/kafka-server-start.sh
# 修改前if [ "x$KAFKA_HEAP_OPTS" = "x" ]; thenexport KAFKA_HEAP_OPTS="-Xmx1G -Xms1G"fi# 修改后if [ "x$KAFKA_HEAP_OPTS" = "x" ]; thenexport KAFKA_HEAP_OPTS="-server -Xms2G -Xmx2G -XX:PermSize=128m -XX:+UseG1GC -XX:MaxGCPauseMillis=200 -XX:ParallelGCThreads=8 -XX:ConcGCThreads=5 -XX:InitiatingHeapOccupancyPercent=70"export JMX_PORT="9999"#export KAFKA_HEAP_OPTS="-Xmx1G -Xms1G"fi
注意: 修改完之后在启动Kafka之前要分发至其他节点
xsync ./kafka-server-start.sh
- 上传压缩包 kafka-eagle-bin-2.0.5.tar.gz 到集群/opt/software目录
- 解压到本地
tar -zxvf kafka-eagle-bin-2.0.5.tar.gz
- 进入到刚刚解压好的目录
cd kafka-eagle-bin-2.0.5
- 将kafka-eagle-web-2.0.5-bin.tar.gz解压至/opt/module
tar -zxvf kafka-eagle-web-2.0.5-bin.tar.gz -C /opt/module
- 修改名称
mv kafka-eagle-web-2.0.5/ eagle-2.0.5
- 进去bin目录,给启动文件添加执行权限
sudo chmod u+x ke.sh
- 修改配置文件 /opt/module/eagle-2.0.5/conf/system-config.properties
####################################### multi zookeeper & kafka cluster list######################################kafka.eagle.zk.cluster.alias=cluster1cluster1.zk.list=hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka####################################### zookeeper enable acl######################################cluster1.zk.acl.enable=falsecluster1.zk.acl.schema=digestcluster1.zk.acl.username=testcluster1.zk.acl.password=test123####################################### broker size online list######################################cluster1.kafka.eagle.broker.size=20####################################### zk client thread limit######################################kafka.zk.limit.size=32####################################### kafka eagle webui port######################################kafka.eagle.webui.port=8048####################################### kafka jmx acl and ssl authenticate######################################cluster1.kafka.eagle.jmx.acl=falsecluster1.kafka.eagle.jmx.user=keadmincluster1.kafka.eagle.jmx.password=keadmin123cluster1.kafka.eagle.jmx.ssl=falsecluster1.kafka.eagle.jmx.truststore.location=/Users/dengjie/workspace/ssl/certificates/kafka.truststorecluster1.kafka.eagle.jmx.truststore.password=ke123456####################################### kafka offset storage######################################cluster1.kafka.eagle.offset.storage=kafka####################################### kafka jmx uri######################################cluster1.kafka.eagle.jmx.uri=service:jmx:rmi:///jndi/rmi://%s/jmxrmi####################################### kafka metrics, 15 days by default######################################kafka.eagle.metrics.charts=truekafka.eagle.metrics.retain=15####################################### kafka sql topic records max######################################kafka.eagle.sql.topic.records.max=5000####################################### delete kafka topic token######################################kafka.eagle.topic.token=keadmin####################################### kafka sasl authenticate######################################cluster1.kafka.eagle.sasl.enable=falsecluster1.kafka.eagle.sasl.protocol=SASL_PLAINTEXTcluster1.kafka.eagle.sasl.mechanism=SCRAM-SHA-256cluster1.kafka.eagle.sasl.jaas.config=org.apache.kafka.common.security.scram.ScramLoginModule required username="kafka" password="kafka-eagle";cluster1.kafka.eagle.sasl.client.id=cluster1.kafka.eagle.blacklist.topics=cluster1.kafka.eagle.sasl.cgroup.enable=falsecluster1.kafka.eagle.sasl.cgroup.topics=cluster2.kafka.eagle.sasl.enable=falsecluster2.kafka.eagle.sasl.protocol=SASL_PLAINTEXTcluster2.kafka.eagle.sasl.mechanism=PLAINcluster2.kafka.eagle.sasl.jaas.config=org.apache.kafka.common.security.plain.PlainLoginModule required username="kafka" password="kafka-eagle";cluster2.kafka.eagle.sasl.client.id=cluster2.kafka.eagle.blacklist.topics=cluster2.kafka.eagle.sasl.cgroup.enable=falsecluster2.kafka.eagle.sasl.cgroup.topics=####################################### kafka ssl authenticate######################################cluster3.kafka.eagle.ssl.enable=falsecluster3.kafka.eagle.ssl.protocol=SSLcluster3.kafka.eagle.ssl.truststore.location=cluster3.kafka.eagle.ssl.truststore.password=cluster3.kafka.eagle.ssl.keystore.location=cluster3.kafka.eagle.ssl.keystore.password=cluster3.kafka.eagle.ssl.key.password=cluster3.kafka.eagle.ssl.endpoint.identification.algorithm=httpscluster3.kafka.eagle.blacklist.topics=cluster3.kafka.eagle.ssl.cgroup.enable=falsecluster3.kafka.eagle.ssl.cgroup.topics=####################################### kafka sqlite jdbc driver address#######################################kafka.eagle.driver=org.sqlite.JDBC#kafka.eagle.url=jdbc:sqlite:/hadoop/kafka-eagle/db/ke.db#kafka.eagle.username=root#kafka.eagle.password=www.kafka-eagle.orgkafka.eagle.driver=com.mysql.cj.jdbc.Driverkafka.eagle.url=jdbc:mysql://hadoop102:3306/ke?useUnicode=true&characterEncoding=UTF-8&zeroDateTimeBehavior=convertToNullkafka.eagle.username=rootkafka.eagle.password=321074####################################### kafka mysql jdbc driver address#######################################kafka.eagle.driver=com.mysql.cj.jdbc.Driver#kafka.eagle.url=jdbc:mysql://127.0.0.1:3306/ke?useUnicode=true&characterEncoding=UTF-8&zeroDateTimeBehavior=convertToNull#kafka.eagle.username=root#kafka.eagle.password=123456
- 添加环境变量
sudo vim /etc/profile.d/my_env.sh# 添加如下内容# kafkaEagleexport KE_HOME=/opt/module/eagle-2.0.5export PATH=$PATH:$KE-HOME/bin
注意 ,修改完配置文件后要source一下
source /etc/profile.d/my_env.sh
- 启动(注意,启动之前需先启动Zookeeper和Kafka)
ke.sh start

- 登录web端访问


若有收获,就点个赞吧
0 人点赞


