第一章.HDFS的数据流
1.HDFS写数据流程
1.剖析文件写入

1. 客户端通过Distributed FileSystem模块向NameNode请求上传文件,NameNode检查目标是否已存在,父目录是否存在2. NameNode返回是否可以上传3. 客户端请求第一个Block上传到哪几个DateNode服务器上4. NameNode 返回三个DataNode节点,分别为dn1,dn2,dn35. 客户端通过FSDateOutputStream模块请求dn1上传,dn1收到请求会继续调用dn2,然后dn2调用dn3,将这个通信管道建立完成6. dn1,dn2,dn3逐步应答客户端7. 客户端开始往dn1上传第一个Block(先从磁盘读取数据放到一个本地内存缓存),以packet为单位,dn1收到一个packet就会传给dn2,dn2会传给dn3,dn1每传一个packet会放入一个应答序列等待应答8. 当一个Block传输完成以后,客户端再次请求NameNode上传第二个Block的服务器(重复执行3~7步)
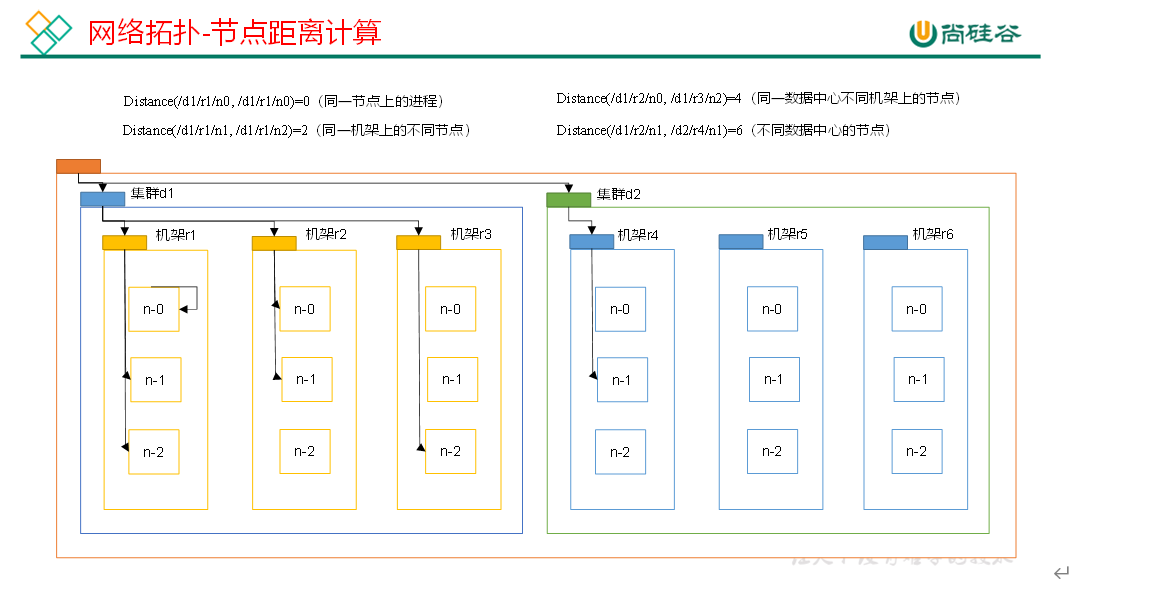
2.网络拓扑-节点距离计算
在HDFS写数据的过程中,NameNode会选择距离待上传数据最近距离的DataNode接收数据
节点距离:两个祖先到达最近的共同祖先的距离之和
3.Hadoop3.1.3副本节点选择
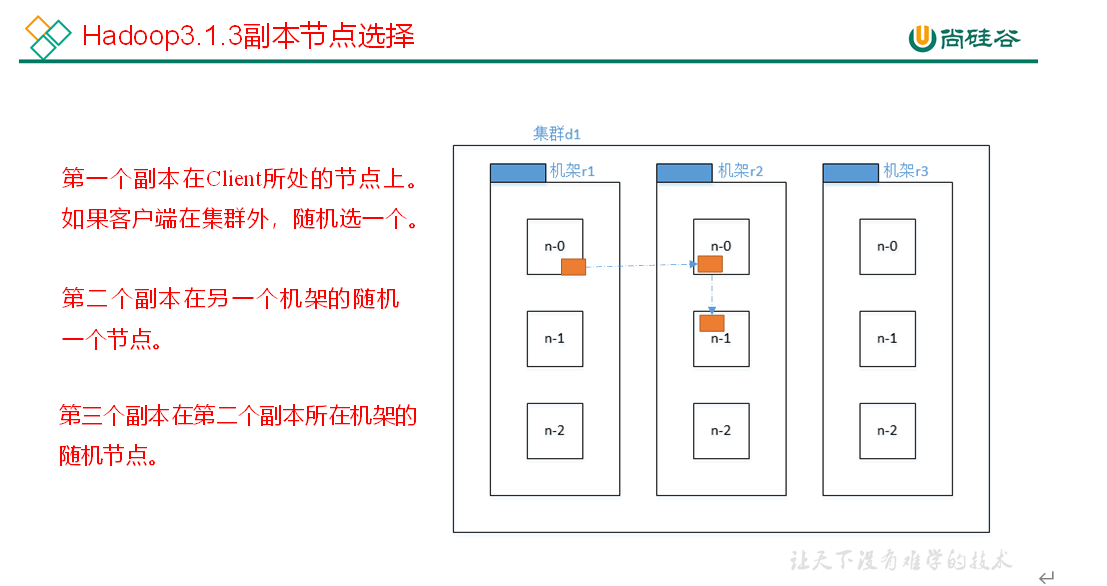
1. 第一个副本在client所处的节点上,如果客户端在集群外,随机选一个
2. 第二个副本在另一个机架的随机一个节点
3. 第三个副本在第二个副本所在机架的随机节点
2.HDFS读数据流程
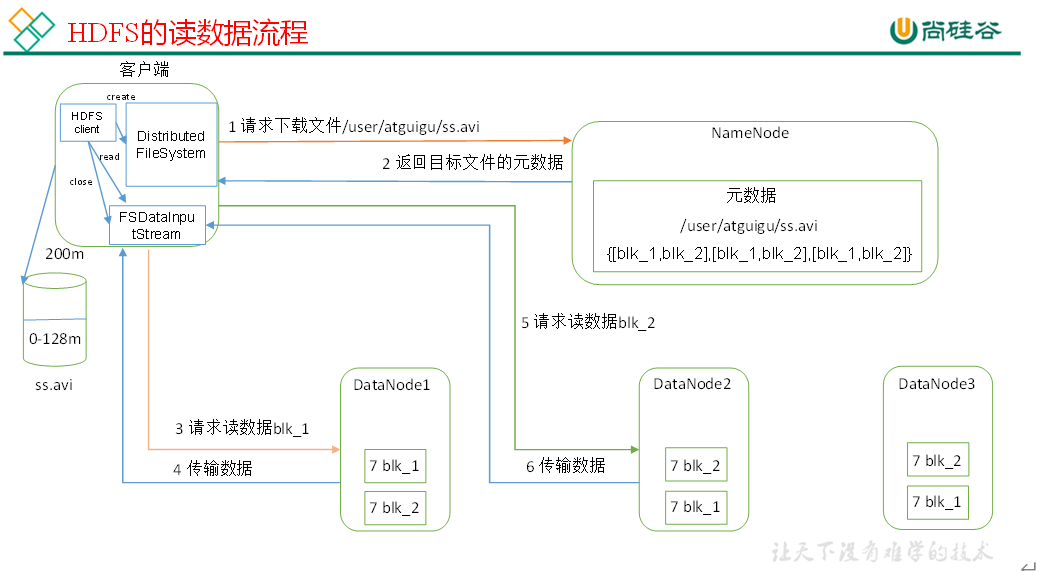
1. 客户端通过Distributed FileSystem向NameNode请求下载文件,NameNode通过查询元数据,找到文件块所在的DataNode地址
2. 挑选一台DataNode服务器(就近原则,然后随机),请求读取数据
3. DataNode开始传输数据给客户端(从磁盘里面读取数据输入流,以packet为单位来做校验)
4. 客户端以packet为单位接收,先在本地缓存,然后写入目标文件
第二章.NameNode和SecondaryNameNode
1.NN和2NN工作机制
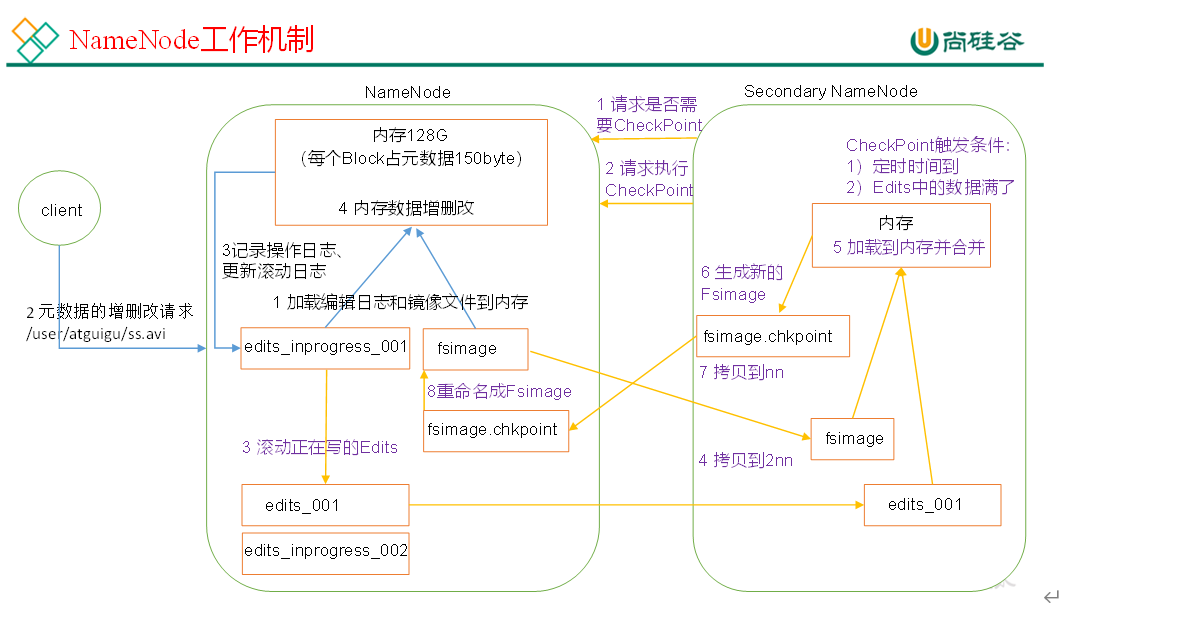
# 第一阶段:NameNode启动
1. 第一次启动NameNode格式化后,创建Fsimage和Edits文件,如果不是第一次启动,直接加载编辑日志文件和镜像文件到内存
2. 客户端对元数据进行增删改的请求
3. NameNode记录操作日志,更新滚动日志
4. NameNode在内存中对元数据进行增删改
# 第二阶段:Secondary NameNode工作
1. Secondary NameNode 询问NameNode是否需要CheckPoint,直接带回NameNode是否检查结果
2. Secondary NameNode 请求执行CheckPoint
3. NameNode滚动正在写的Edits日志
4. 将滚动前的编辑日志和镜像文件拷贝到Secondary NameNode
5. Secondary NameNode加载编辑日志和镜像文件到内存,再合并
6. 生成新的镜像文件 fsimage.chkpoint
7. 拷贝fsimage.chkpoint到NameNode
8. NameNode将fsimage.chkpoint重新命名为fsimage
2.Fsimage和Edits解析
NameNode格式化以后,将在/opt/module/hadoop-3.1.3/data/tmp/dfs/name/current产生如下文件
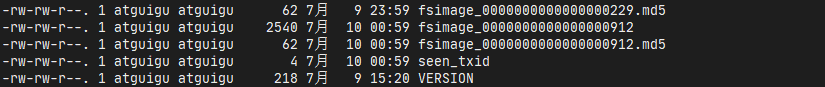
1. Fsimage文件:HDFS文件系统元数据的一个永久性的检查点,其中包含HDFS文件系统的所有目录和文件inode的序列化信息
2. Edits文件: 存放HDFS文件系统的所有更新操作的路径,文件系统客户端执行的所有写操作首先会被记录到Edits文件中
3. seen_txid文件保存的是一个数字,就是最后一个edit的数字
4. 每次NameNode启动的时候都会将Fsimag文件读入内存,加载Edits里面的更新操作,保证内存中的元数据信息是最新的,同步的,可以看成NameNode启动的时候就将Fsimage和Edits文件进行了合并
3.CheckPoint时间设置
通常情况下,SecondaryaryNameNode每隔一小时执行一次
hdfs-default.xml
<property>
  <name>dfs.namenode.checkpoint.period</name>
  <value>3600</value>
</property>
一分钟检查一次操作次数,当操作次数达到100万时,SecondaryNameNode执行一次
<property>
  <name>dfs.namenode.checkpoint.txns</name>
  <value>1000000</value>
<description>操作动作次数</description>
</property>

<property>
  <name>dfs.namenode.checkpoint.check.period</name>
  <value>60</value>
<description> 1分钟检查一次操作次数</description>
</property >
4.集群安全模式
# NameNode启动时
NameNode启动时,首先将镜像文件载入内存,并执行编辑日志的各项操作,一旦在内存中成功建立文件系统元数据的映像,则创建一个新的Fsimage文件和一个空的编辑日志此时NameNode开始监听DataNode请求,这个过程期间,NameNode一直运行在安全模式,即NameNode的文件系统对于客户端来说是只读的
# DataNode启动时
系统中数据块的位置并不是由NameNode维护的,而是以块列表的形式存储在DateNode中,在系统的正常操作间,NameNode
会在内存中保留所有块位置的映射信息,在安全模式下,各个DataNode会向NameNode发送最新的块列表信息,NameNode了解到足够多的块位置信息之后,即可高效运行文件系统
# 安全模式退出判断
如果满足最小副本条件,NameNode会在30s之后退出安全模式,所谓的最小副本条件指的是在整个文件系统中99.9%的块满足最小副本级别(默认值: dfs.replication.min=1),在启动一个刚刚格式化的HDFS集群时,因为系统中还没有任何块,所以NameNode 不会进入安全模式
基本语法
hdfs dfsadmin -safemode get #查看安全模式状态
hdfs dfsadmin -safemode enter #进入安全模式状态
hdfs dfsadmin -safemode leave #离开安全模式
hdfs dfsadmin -safemode wait #等待安全模式状态
hdfs dfsadmin -safemode forceExit #强制退出安全模式
第三章.DataNode
1.DataNode工作机制
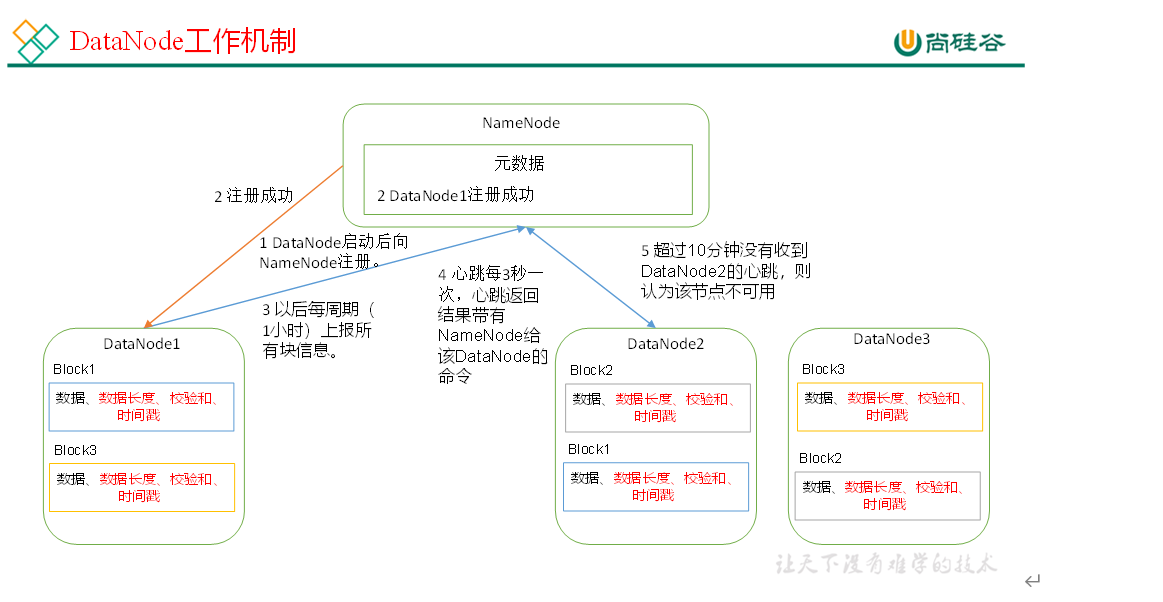
# DataNode工作机制
1. 一个数据块在DateNode上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据包括数据块的长度,块数据的校验和,以及时间戳
2. DataNode启动后向NameNode注册,通过后,周期性(1小时)的向NameNode上报所有的块信息
3. 心跳是每3秒一次,心跳返回结果带有NameNode给该DataNode的命令,如复制块数据到另一台机器,如果超过10分钟没有收到某个DateNode的心跳,则认为该节点不可用
4. 集群运行中可以安全加入和退出一些机器
2.数据完整性
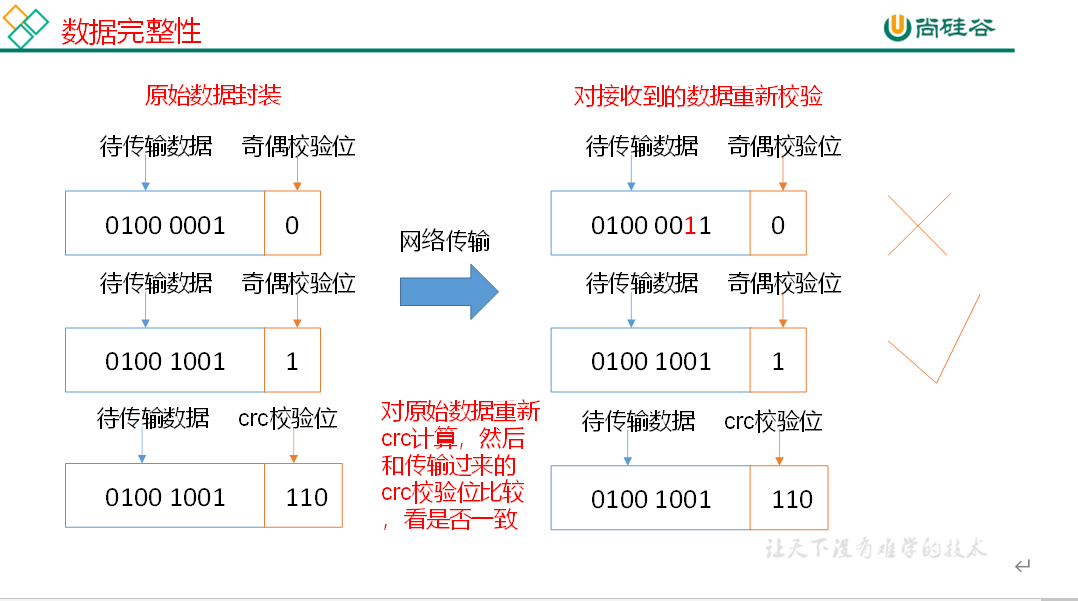
# DateNode节点保证数据完整性的方法
1. 当DataNode读取block的时候,他会计算CheckSum
2. 如果计算后的CheckSum与创建时的值不一样,说明block已经损坏
3. Client读取其他DataNode上的block
4. DataNode在其文件创建后周期验证CheckSum
3.掉线时限参数设置

hdfs-site.xml
<property>
    <name>dfs.namenode.heartbeat.recheck-interval</name>
    <--单位:ms--/>
    <value>300000</value>
</property>
<property>
    <name>dfs.heartbeat.interval</name>
    <--单位:s--/>
    <value>3</value>
</property>
4.服役新数据节点
- 环境准备:
1. 在hadoop104主机上克隆一台hadoop105主机
2. 修改IP地址和主机名称
3. 删除原来HDFS文件系统留存的文件/opt/module/hadoop-3.1.3/data和logs)
4. source一下配置文件 :source /etc/profile
- 服役新节点具体步骤
直接启动DataNode,即可关联到集群
hdfs -daemon start datanode
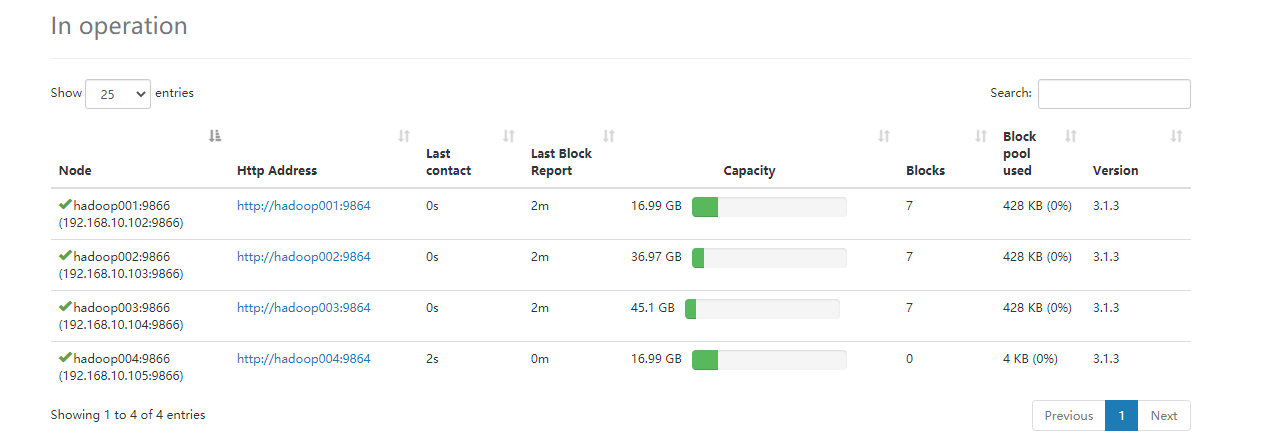
如果数据不均衡,可以用命令实现集群的再平衡
start-balance.sh
5.退役旧数据节点
5.1添加白名单
添加到白名单的主机节点都允许访问NameNode,不在白名单的主机节点,都会被退出
- 在NameNode的/opt/module/hadoop-3.1.3/etc/hadoop目录下创建dfs.hosts
cd /opt/module/hadoop-3.1.3/etc/hadoop
touch dfs.hosts
vi dfs.hosts
- 添加如下主机名称(不添加hadoop004)
hadoop102
hadoop103
hadoop104
- 在NameNode的hdfs-site.xml配置文件中增加dfs.hosts属性
<property>
<name>dfs.hosts</name>
<value>/opt/module/hadoop-3.1.3/etc/hadoop/dfs.hosts</value>
</property>
- 重启NameNode
hdfs -daemon stop namenode
hdfs -daemon start namenode
- 配置文件分发
xsync hdfs-site.xml
- 刷新NameNode
hdfs dfsadmin -refreshNodes
- 更新ResourceManager节点
yarn rmadmin -refreshNodes
- 在web端查看

- 如果数据不均衡,可以用命令实现集群的再平衡
start-balancer.sh
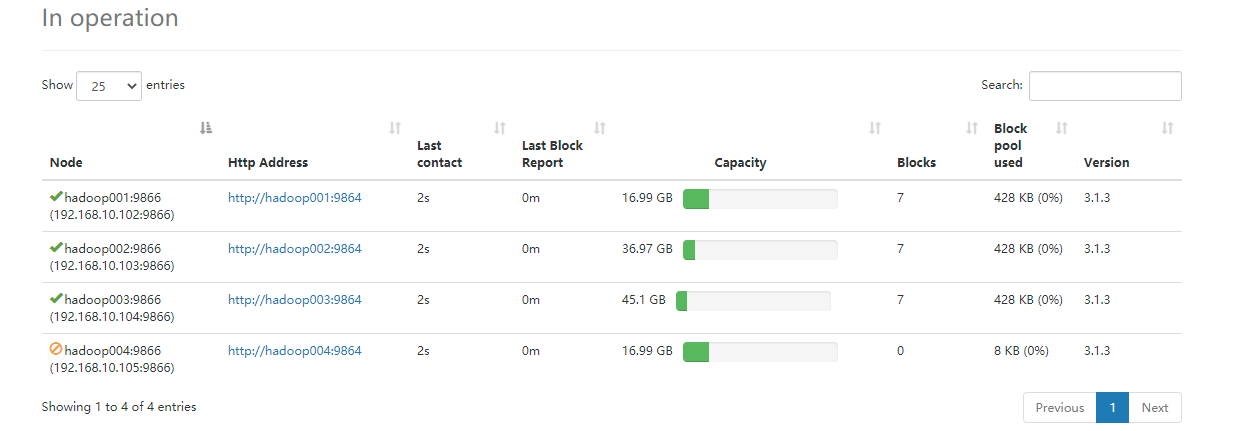
5.2黑名单退役
在黑名单上的主机都会被强制退出
- 在NameNode的/opt/module/hadoop-3.1.3/etc/hadoop目录下创建dfs.hosts.exclude文件
cd /opt/module/hadoop-3.1.3/etc/hadoop
touch dfs.hosts.exclude
vi dfs.hosts.excude
- 添加如下主机名称
hadoop105
- 在NameNode的hdfs-site.xml配置文件中增加dfs.hosts.exclude属性(并重启NameNode)
<property>
<name>dfs.hosts.exclude</name>
      <value>/opt/module/hadoop-3.1.3/etc/hadoop/dfs.hosts.exclude</value>
</property>
hdfs -daemon stop namenode
hdfs -daemon start namenode
- 刷新NameNode,刷新ResourceManager
hdfs dfsadmin -refreshNodes
yarn rmadmin -refreshNodes
- web端查看
6.多目录配置
DataNode也可以配置成多个目录,每个目录存储的数据不一样。即:数据不是副本
hdfs-site.xml
<property>
        <name>dfs.datanode.data.dir</name>
<value>file:///${hadoop.tmp.dir}/dfs/data1,file:///${hadoop.tmp.dir}/dfs/data2</value>
</property>

若有收获,就点个赞吧
0 人点赞


