第一章.Yarn基本架构
Yarn是一个资源调度平台,负责为运算程序提供服务器运算资源,相当于一个分布式的操作系统平台,而MapReduce运算程序则相当于运行于操作系统之上的应用程序Yarn主要由 ResourceManager,NodeManager,ApplicationMaster和Container等组件构成

第二章.Yarn工作机制
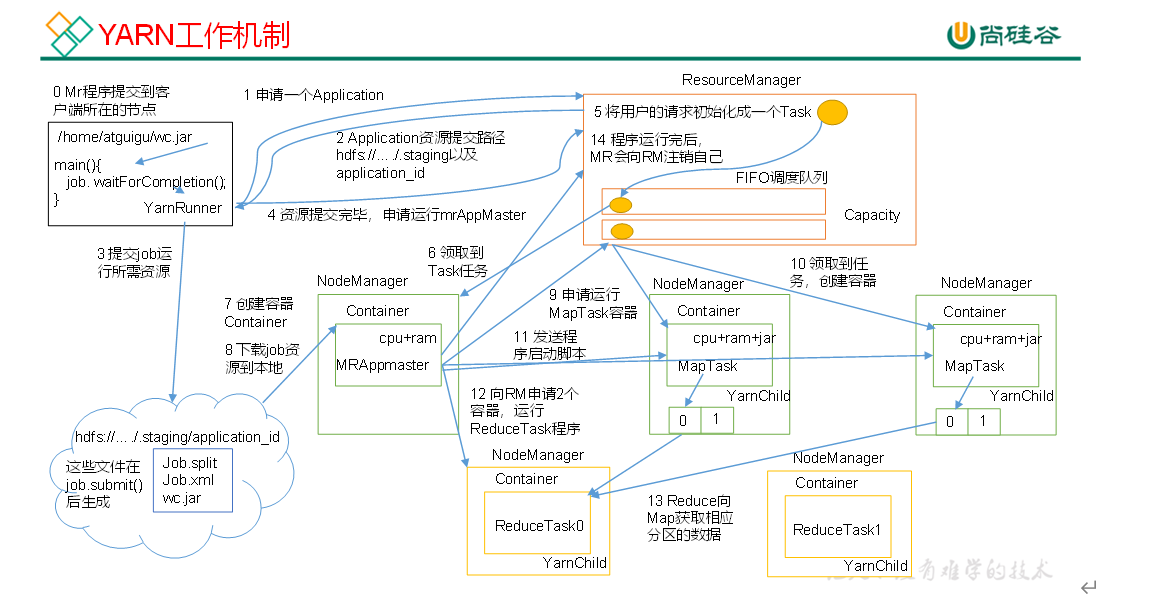
1. MR程序提交到客户端所在的节点2. YarnRunner向ResourceManager申请一个Application3. RM将该该应用程序的资源路径返回给YarnRunner4. 该程序将运行所需资源提交到HDFS上5. 程序资源提交完毕后,申请运行MRAPPMaster6. RM将用户的请求初始化成一个Task7. 其中一个NodeManager领取到Task任务8. 该NodeManager创建容器Container,并产生MRAPPmaster9. Container从HDFS上拷贝资源到本地10. MRAPPMaster向RM申请运行MapTask资源11. RM将运行MapTask任务分配给另外两个NodeManager,另两个NodeManager分别领取任务并创建容器12. MR向两个接收到任务的NodeManager发送程序启动脚本,这两个NodeManager分别启动MapTask,MapTask对数据分区排序13. MrAppMaster等待所有MapTask运行完毕后,向RM申请容器,运行ReduceTask14. ReduceTask向MapTask获取相应分区的数据15. 程序运行完毕后,MR会向RM申请注销自己
第三章.作业提交全流程
第一步 作业提交
1. Client调用job.waitForCompletion方法,向整个集群提交MapReduce作业
2. Client向RM申请一个作业id
3. RM给Client返回该job资源的提交路径和作业id
4. Client提交jar包,切片信息和配置文件到指定的资源提交路径
5. Client提交资源后,向RM申请运行MRAppMaster
第二步 作业初始化
6. 当RM收到Client的请求后,将该job添加到容量调度器中
7. 某一个空闲的NM领取到该job
8. 该NM创建Container,并产生MRAPPmaster
9. 下载Client提交的资源到本地
第三步 任务分配
10. MrAPPMaster向RM申请运行多个MapTask任务资源
11. RM将运行MapTask任务分配给另外两个NodeManager,另两个NodeManager分别领取任务并创建容器
第四步 任务运行
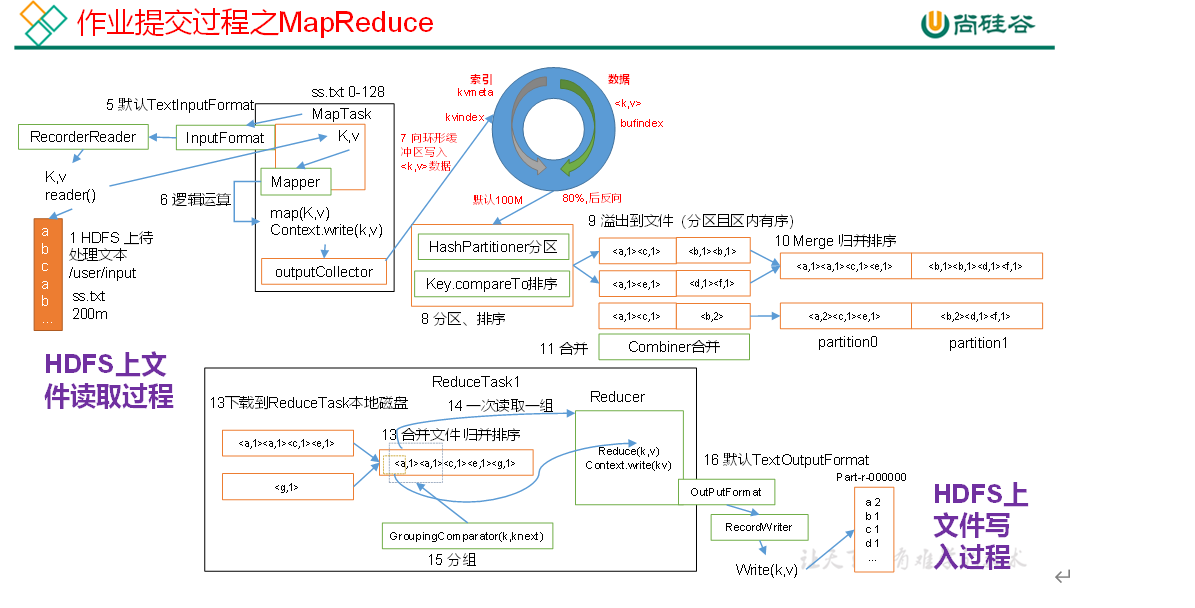
12. MR向两个接收到任务的NodeManager发送程序启动脚本,这两个NodeManager分别启动MapTask,MapTask对数据分区排序
13. MrAppMaster等待所有MapTask运行完毕后,向RM申请容器,运行ReduceTask
14. ReduceTask向MapTask获取相应分区的数据
15. 程序运行完毕后,MR会向RM申请注销自己
第五步 进度和状态更新
- YARN中的任务将其进度和状态(包括counter)返回给应用管理器, 客户端每秒(通过mapreduce.client.progressmonitor.pollinterval设置)向应用管理器请求进度更新, 展示给用户
第六步 作业完成
- 除了向应用管理器请求作业进度外, 客户端每5秒都会通过调用waitForCompletion()来检查作业是否完成。时间间隔可以通过mapreduce.client.completion.pollinterval来设置。作业完成之后, 应用管理器和Container会清理工作状态。作业的信息会被作业历史服务器存储以备之后用户核查
第四章.资源调度器
目前,Hadoop作业调度器主要有三种:FIFO,Capacity Scheduler和Fair Schemaduler

Hadoop3.1.3默认的资源调度器是Capacity Scheduler
具体设置祥见 yarn-default.xml文件
<property>
    <name>yarn.resourcemanager.scheduler.class</name>
<value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.CapacityScheduler</value>
    <description>The class to use as the resource scheduler.</description>
</property>
1.先进先出调度器(FIFO)

2.容量调度器(Capacity Scheduler)

3.公平调度器

4.容量调度器多队列提交案例
需求
- Yarn默认的容量调度器是一条单队列的调度器,在实际使用中会出现单个任务阻塞整个队列的情况,同时随着业务的增长,公司需要分业务限制集群使用率,这就需要我们按照业务种类配置多条任务队列
- 配置多队列的容量调度器
capacity-scheduler.xml
<!-- 红色是修改的部分 -->
<property>
    <name>yarn.scheduler.capacity.root.queues</name>
    <value>default,hive</value>
    <description>
      The queues at the this level (root is the root queue).
    </description>
</property>
<property>
    <name>yarn.scheduler.capacity.root.default.capacity</name>
    <value>40</value>
</property>
<!--  同时为新加队列添加必要属性:-->
<property>
    <name>yarn.scheduler.capacity.root.hive.capacity</name>
    <value>60</value>
</property>

<property>
    <name>yarn.scheduler.capacity.root.hive.user-limit-factor</name>
    <value>1</value>
</property>

<property>
    <name>yarn.scheduler.capacity.root.hive.maximum-capacity</name>
    <value>80</value>
</property>

<property>
    <name>yarn.scheduler.capacity.root.hive.state</name>
    <value>RUNNING</value>
</property>

<property>
    <name>yarn.scheduler.capacity.root.hive.acl_submit_applications</name>
    <value>*</value>
</property>

<property>
    <name>yarn.scheduler.capacity.root.hive.acl_administer_queue</name>
    <value>*</value>
</property>

<property>
    <name>yarn.scheduler.capacity.root.hive.acl_application_max_priority</name>
    <value>*</value>
</property>

<property>
    <name>yarn.scheduler.capacity.root.hive.maximum-application-lifetime</name>
    <value>-1</value>
</property>

<property>
    <name>yarn.scheduler.capacity.root.hive.default-application-lifetime</name>
    <value>-1</value>
</property>
在配置完成后,重启Yarn,就可以看到两条队列

- 向Hive队列提交任务
- 默认的任务提交都是提交到default队列的,如果希望向其他队列提交任务.需要在Driver中声明
public class WcDrvier {
    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {
        Configuration configuration = new Configuration();

        configuration.set("mapred.job.queue.name", "hive");

        //1. 获取一个Job实例
        Job job = Job.getInstance(configuration);

        //2. 设置类路径
        job.setJarByClass(WcDrvier.class);

        //3. 设置Mapper和Reducer
        job.setMapperClass(WcMapper.class);
        job.setReducerClass(WcReducer.class);

        //4. 设置Mapper和Reducer的输出类型
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(IntWritable.class);

        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);

        job.setCombinerClass(WcReducer.class);

        //5. 设置输入输出文件
        FileInputFormat.setInputPaths(job, new Path(args[0]));
        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        //6. 提交Job
        boolean b = job.waitForCompletion(true);
        System.exit(b ? 0 : 1);
    }
}
这样,这个任务在集群提交时,就会提交到hive队列


若有收获,就点个赞吧
0 人点赞


