第一章.Zookeeper入门
Zookeeper是一个开源的分布式的为分布式应用提供协调服务的Apache项目
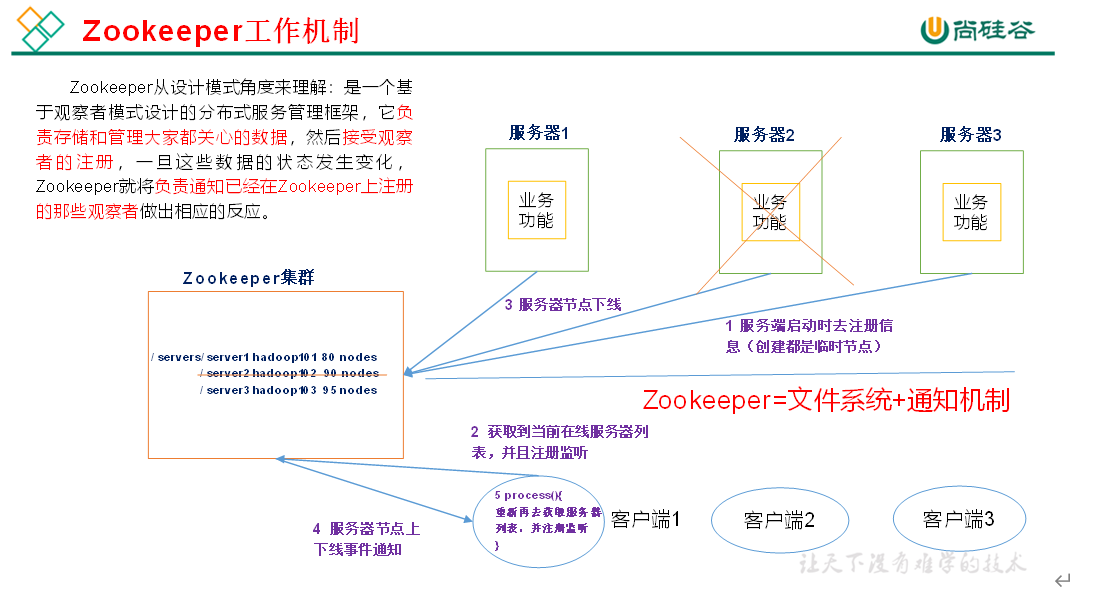
1.工作机制
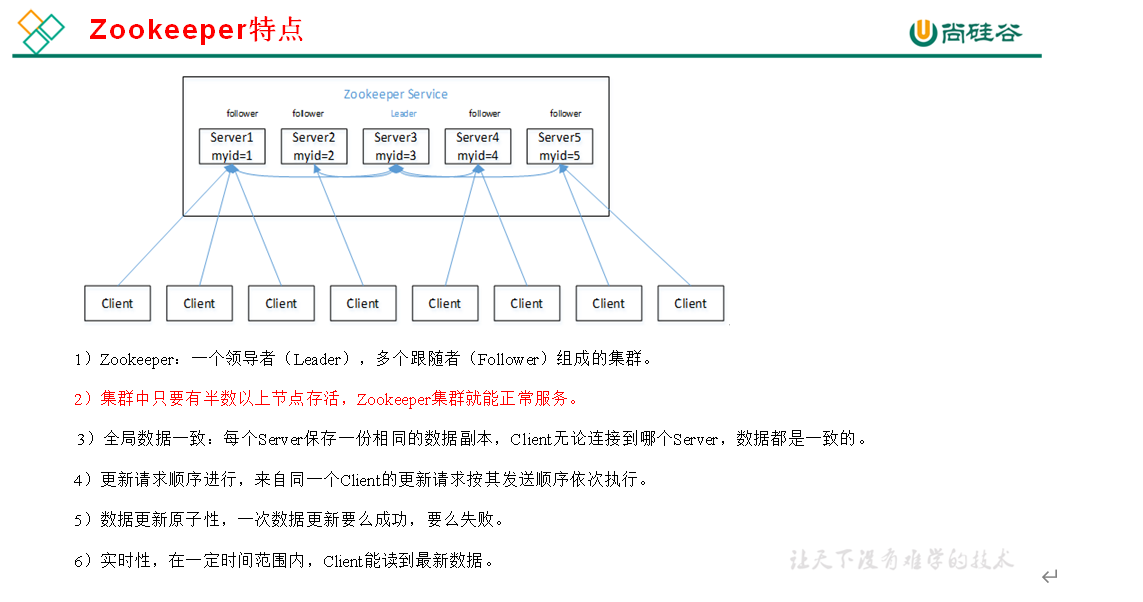
2. 特点
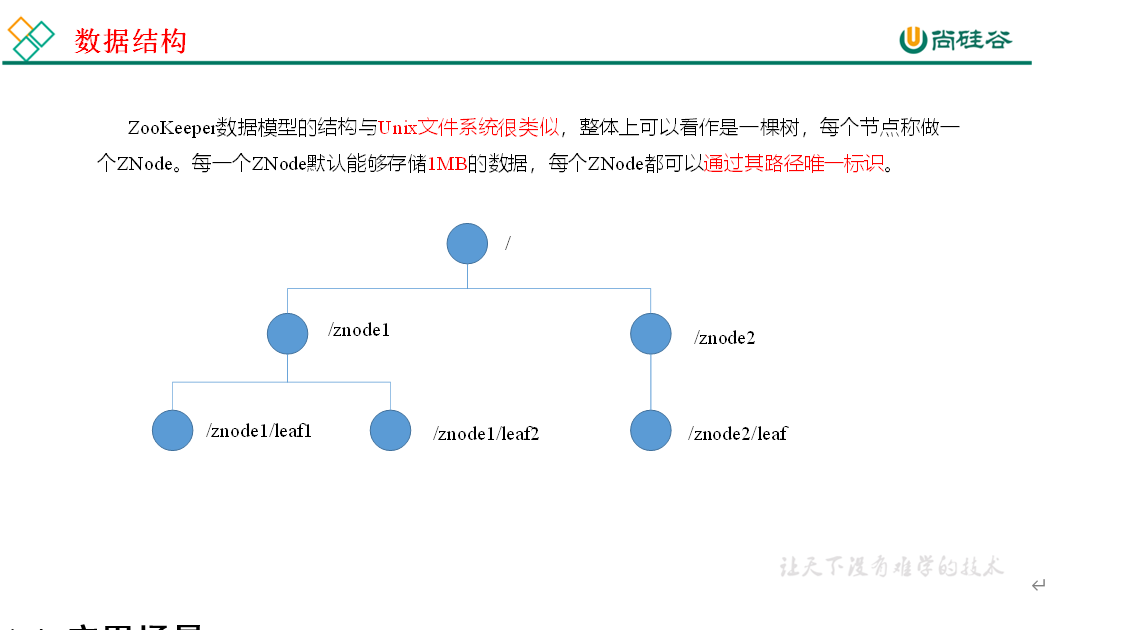
3.数据结构
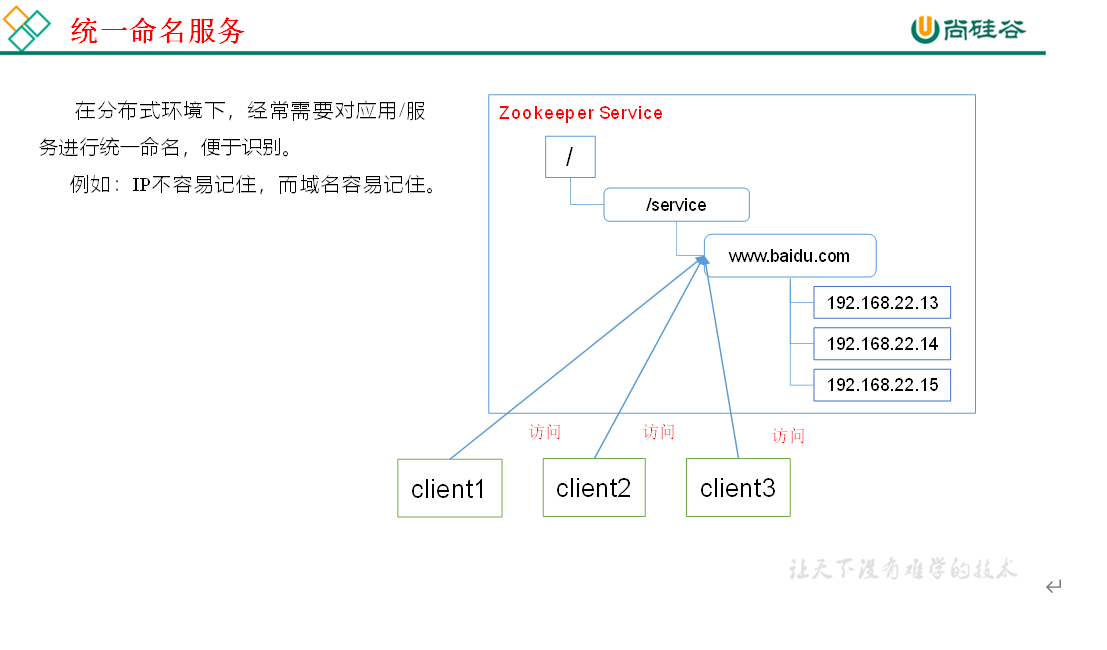
4.应用场景
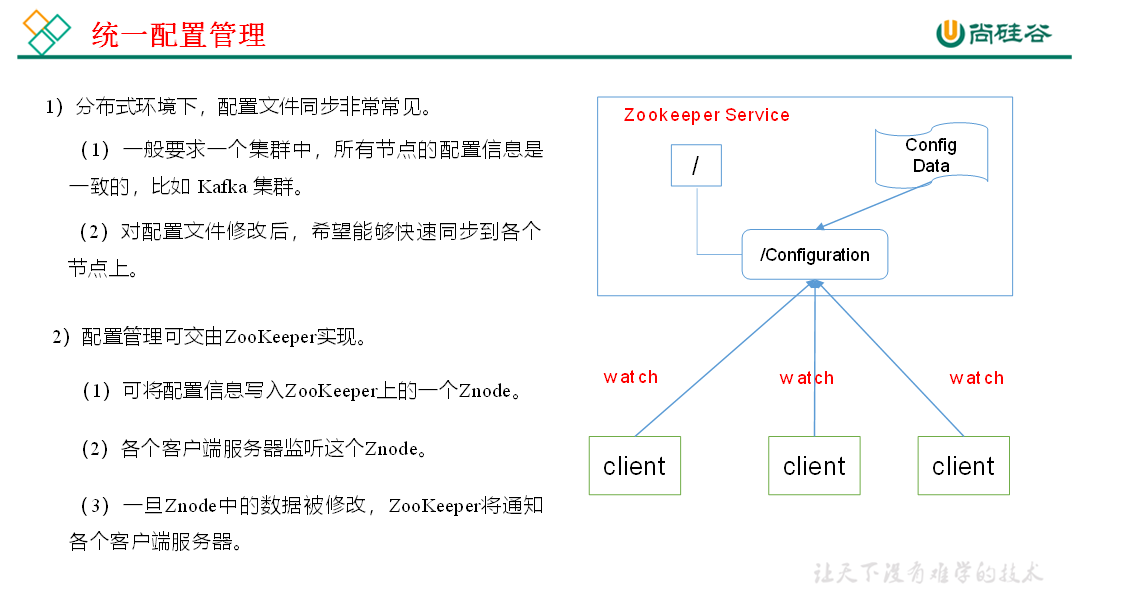
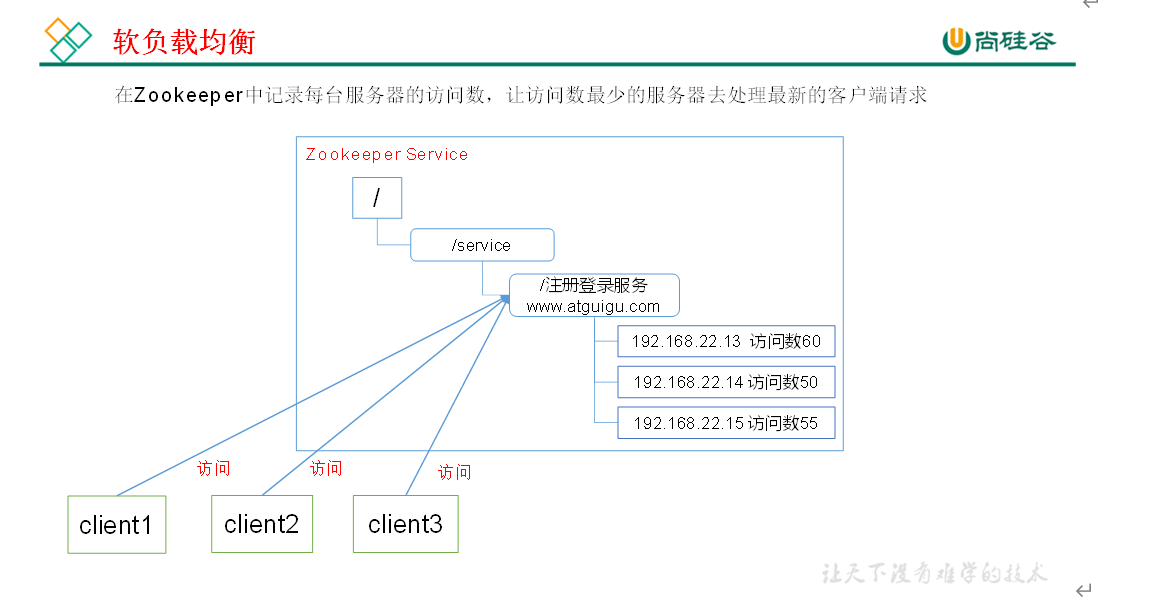
提供的服务包括: 统一命名服务,统计配置管理,统一集群管理,服务器节点动态上下线,软负载均衡等


第二章.Zookeeper安装
1.本地模式安装部署
# 1.安装前准备1. 安装JDK2. 拷贝Zookeeper安装包到Linux系统下3. 解压到指定目录tar -zxvf zookeeper-3.5.7.tar.gz -C /opt/module/
# 2.配置修改1. 将/opt/module/zookeeper-3.5.7/conf这个路径下的zoo_sample.cfg修改为zoo.cfgmv zoo_sample.cfg zoo.cfg2. 打开zoo.cfg文件,修改dataDir路径dataDir=/opt/module/zookeeper-3.5.7/zkData3. 在/opt/module/zookeeper-3.5.7/这个目录下创建zkData文件夹mkdir zkData4. 配置环境变量sudo vim /etc/profile.d/my_env.sh#添加如下内容export ZOOKEEPER_HOME=/opt/module/zookeeper-3.5.7export PATH=$PATH:$ZOOKEEPER_HOME/bin5. source环境变量source /etc/profile.d/my_env.sh
# 3.操作zookeeper
zkServer.sh start #启动zookeeper
zkServer.sh status #查看状态
zkCli.sh  #启动客户端
quit #退出客户端
zkServer.sh stop #停止Zookeeper
2.分布式安装部署
1. 先把服务给停掉,注意:一定要做
2. 进入到/opt/module/zookeeper-3.5.7/zkData将所有内容删除
rm -rf ./*
3. 在/opt/module/zookeeper-3.5.7/zkData创建一个文件myid
touch myid
4. 在myid中写一个数值(该值表示该节点在集群中的唯一id)
5. 编辑配置文件  /opt/module/zookeeper-3.5.7/conf/zoo.cfg
#添加如下内容
server.2=hadoop102:2888:3888
server.3=hadoop103:2888:3888
server.4=hadoop104:2888:3888
------------------------------
#说明:
#2表示的是myid中对应的数值
#hadoop102是myid中的值所对应的节点地址。
#2888是zookeeper内部通信使用的端口号
#3888是选举leader时使用的端口号
6. 分发到hadoop103和hadoop104
xsync /opt/module/zookeeper-3.5.7
7. 将hadoop103中的myid值改为3,hadoop104的myid的值改为4
8. 启动各节点
# 群起脚本(zkCluster.sh)
#!/bin/bash

var=""
case $1 in
"start")
        var="start"
        ;;
"stop")
        var="stop"
        ;;
"status")
        var="status"
        ;;
*)
        echo "args info error!!!!!!!!"
        exit
        ;;
esac

        for host in hadoop102 hadoop103 hadoop104
        do
                echo "=====================$host========================"
                ssh $host /opt/module/zookeeper-3.5.7/bin/zkServer.sh $var
        done
第三章.Zookeeper使用
1. 客户端命令行操作
| 命令基本语法 | 功能描述 |
|---|---|
| help | 显示所有操作命令 |
| ls path | 查看当前znode的子节点 -w 监听子节点变化 -s 附加次级信息 |
| create | 普通创建 -s 含有序列 -e临时(重启或者超时消失) |
| get path | 获取节点的值 -w监听节点内容变化 -s 附加次级信息 |
| set | 设置节点的具体值 |
| stat | 查看节点状态 |
| delete | 删除节点 |
| deleteall | 递归删除节点 |
zkCli.sh #启动客户端
help #显示所有操作命令
ls / #查看当前znode中包含的内容
ls -s / #查看当前节点详细数据
# 分别创建两个普通节点
create /sangguo "jinlian"
create /sangguo/shuguo "liubei"
# 获取节点的值
get /sangguo
get /sangguo/shuguo
# 创建短暂节点
create -e /sangguo/wuguo "zhouyu"
# 创建带序号的节点
1. 先创建一个普通的根节点
create /sangguo/weiguo "caocao"
2. 创建带序号的节点
create -s /sangguo/weiguo/xiaoqiao "jinlian"
# 修改节点数据值
set /sangguo/weiguo "simayi"
# 节点的值变化监听
get /sangguo watch
# 节点的子节点变化监听(路径变化)
ls /sangguo watch
# 删除节点
delete /sangguo/jin
# 递归删除节点
rmr /sangguo/shuguo
# 查看节点状态
stat /sangguo
2.API应用
一.idea环境搭建
- 创建一个新的maven工程
- 添加pom依赖
<dependencies>
        <dependency>
            <groupId>junit</groupId>
            <artifactId>junit</artifactId>
            <version>RELEASE</version>
        </dependency>
        <dependency>
            <groupId>org.apache.logging.log4j</groupId>
            <artifactId>log4j-core</artifactId>
            <version>2.8.2</version>
        </dependency>
        <!-- https://mvnrepository.com/artifact/org.apache.zookeeper/zookeeper -->
        <dependency>
            <groupId>org.apache.zookeeper</groupId>
            <artifactId>zookeeper</artifactId>
            <version>3.5.7</version>
        </dependency>
</dependencies>
- 拷贝log4j.properties文件到项目根目录
需要在项目的src/main/resources目录下,新建一个文件,命名为”log4j.properties”,在文件中填入
log4j.rootLogger=INFO, stdout
log4j.appender.stdout=org.apache.log4j.ConsoleAppender
log4j.appender.stdout.layout=org.apache.log4j.PatternLayout
log4j.appender.stdout.layout.ConversionPattern=%d %p [%c] - %m%n
log4j.appender.logfile=org.apache.log4j.FileAppender
log4j.appender.logfile.File=target/spring.log
log4j.appender.logfile.layout=org.apache.log4j.PatternLayout
log4j.appender.logfile.layout.ConversionPattern=%d %p [%c] - %m%n
二.创建zk对象
package com.atguigu.zk;

import org.apache.zookeeper.WatchedEvent;
import org.apache.zookeeper.Watcher;
import org.apache.zookeeper.ZooKeeper;
import org.junit.After;
import org.junit.Before;
import org.junit.Test;

import java.io.IOException;

public class ZkDemo {

    private ZooKeeper zk;

    @Before
    public void before() throws IOException {
        //创建zk对象
        String connectString = "hadoop102:2181,hadoop103:2181,hadoop104:2181";
        int sessionTimeOut = 4000;
        zk = new ZooKeeper(connectString, sessionTimeOut, new Watcher() {
            @Override
            public void process(WatchedEvent watchedEvent) {

            }
        });

    }


    @After
    public void after() throws Exception{
        //关闭资源
        if(zk != null){
            zk.close();
        }

    }


    @Test
    public void test(){

    }

}
三.创建子节点
 @Test
    public void test(){
        try {
            zk.create("/sangguo/liangliang","zhugeliang".getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.PERSISTENT);
        } catch (KeeperException e) {
            e.printStackTrace();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

    }
四.判断节点是否存在
@Test
    public void test02(){
        Stat exists = null;
        try {
            exists = zk.exists("/sangguo/liangliang2", false);
        } catch (KeeperException e) {
            e.printStackTrace();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

        System.out.println(exists != null? "存在":"不存在");
    }
五.获取子节点并监听子节点变化
@Test
    public void test03() throws InterruptedException, KeeperException {

        listener();
        //程序不能结束
        Thread.sleep(Long.MAX_VALUE);


    }
    public void listener() throws InterruptedException, KeeperException {
        List<String> children = zk.getChildren("/sangguo", new Watcher() {
            @Override
            public void process(WatchedEvent watchedEvent) {
                //当子节点发生变化时,那么会调用该方法

                    System.out.println("子节点发生变化了");
                    //再次监听
                    try {
                        listener();
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    } catch (KeeperException e) {
                        e.printStackTrace();
                    }
                }

        });
        //遍历所有的子节点
        for (String child : children) {
            System.out.println(child);
        }
    }
3.监听服务器节点动态上下线案例
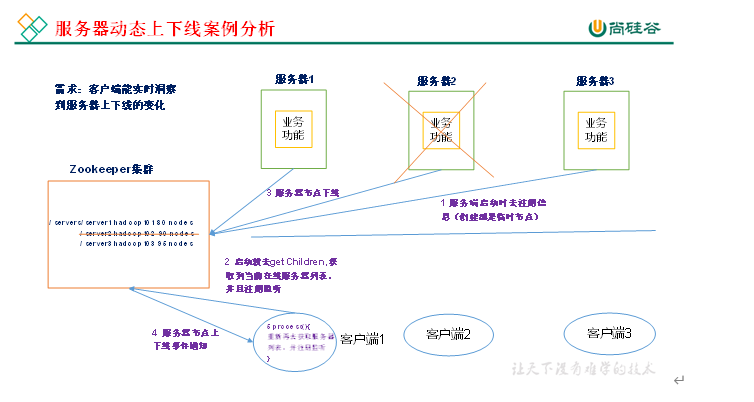
需求: 某分部式系统中,主节点可以有多台,可以动态上下线,任意一台客户端都能实时感知到主节点服务器的上下线
服务器:
package com.atguigu.zk;

import org.apache.zookeeper.*;
import org.apache.zookeeper.data.Stat;

public class ZKServer {
    public static void main(String[] args) throws Exception {
        //1.创建zk对象
        String connectString = "hadoop102:2181,hadoop103:2181,hadoop104:2181";
        int  sessionTimeOut = 4000;
        ZooKeeper zk = new ZooKeeper(connectString, sessionTimeOut, new Watcher() {
            //当zkServer向客户端通知时,那么客户端就会调用Watcher对象的process方法。
            //在该方法中去实现,事件响应后应该处理的业务逻辑代码即可
            public void process(WatchedEvent event) {

            }
        });
        //2.判断父节点是否存在
        Stat exists = zk.exists("/a", false);
        if (exists == null){//父节点不存在-则创建
            zk.create("/a","".getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE,
                    CreateMode.PERSISTENT);
        }
        //3.创建临时节点 - 当服务器关闭后临时节点就会消失
        zk.create("/a/" + args[0],args[1].getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE,
                CreateMode.EPHEMERAL);

        //4.让程序一直在运行
        Thread.sleep(Long.MAX_VALUE);
    }
}
客户端:
package com.atguigu.zk;

import org.apache.zookeeper.KeeperException;
import org.apache.zookeeper.WatchedEvent;
import org.apache.zookeeper.Watcher;
import org.apache.zookeeper.ZooKeeper;

import java.util.List;

public class ZKClient {
    private static ZooKeeper zk;
    public static void main(String[] args) throws Exception {
        //1.创建zk对象
        String connectString = "hadoop102:2181,hadoop103:2181,hadoop104:2181";
        int  sessionTimeOut = 4000;
        zk = new ZooKeeper(connectString, sessionTimeOut, new Watcher() {
            //当zkServer向客户端通知时,那么客户端就会调用Watcher对象的process方法。
            //在该方法中去实现,事件响应后应该处理的业务逻辑代码即可
            public void process(WatchedEvent event) {

            }
        });
        //2.获取/a子节点并监听/a
        listener();
        //3.不能让程序死掉
        Thread.sleep(Long.MAX_VALUE);
    }

    public static void listener() throws KeeperException, InterruptedException {
        List<String> children = zk.getChildren("/a", new Watcher() {
            //当/a节点发生变化时会调用该方法
            public void process(WatchedEvent event) {
                //1.获取子节点 -- 下面已经实现了
                //2.再次监听---因为监听只是一次有效
                System.out.println("==================================");
                try {
                    listener();
                } catch (KeeperException e) {
                    e.printStackTrace();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });
        //遍历子节点
        for (String c : children) {
            System.out.println(c);
        }
    }
}
第四章.Zookeeper内部原理
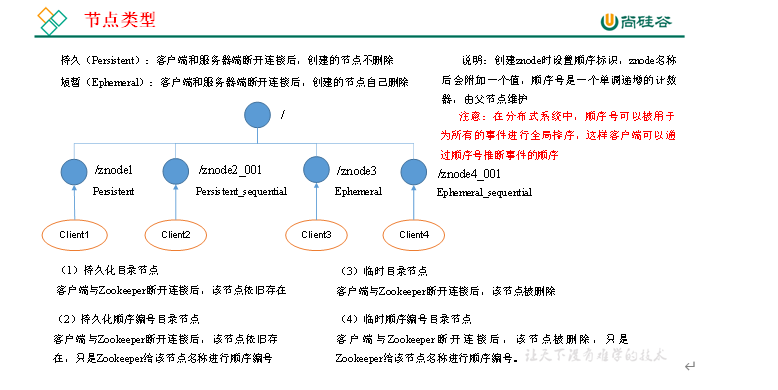
1.节点类型
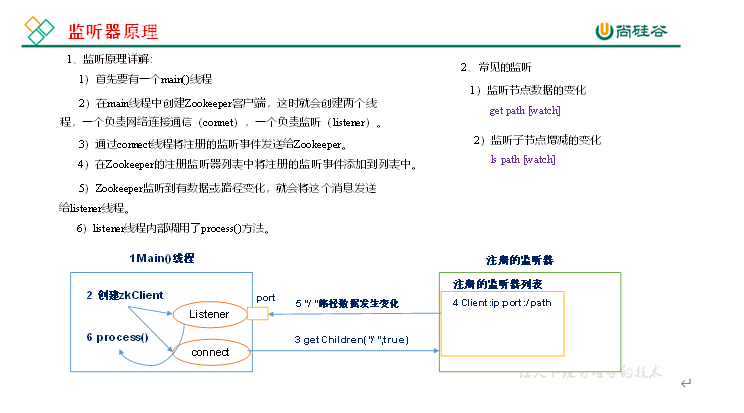
2.监听器原理
3.选举机制
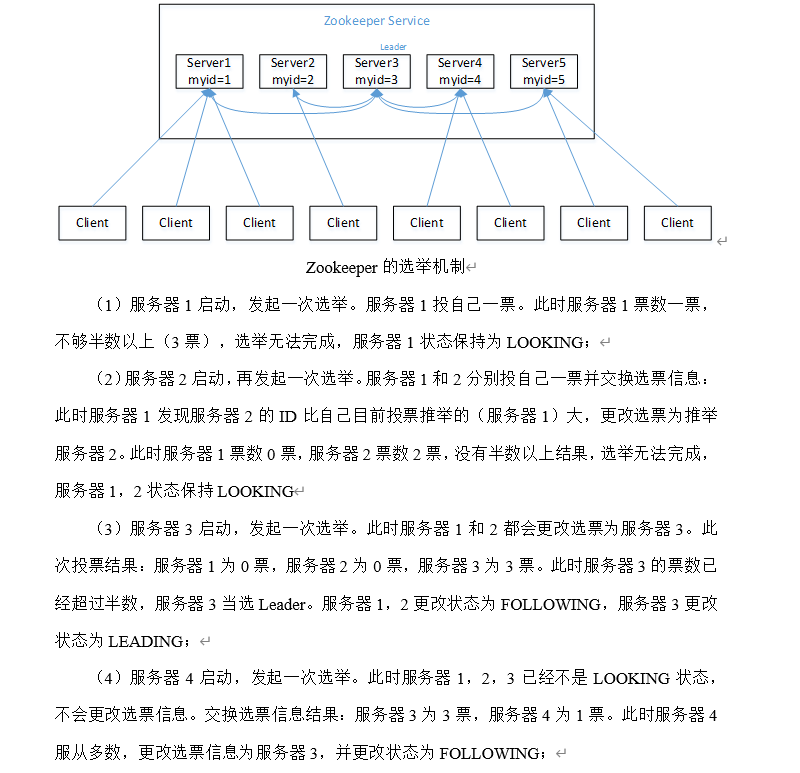
(1)半数机制:集群中半数以上机器存活,集群可用。所以Zookeeper适合安装奇数台服务器。
(2)Zookeeper虽然在配置文件中并没有指定Master和Slave。但是,Zookeeper工作时,是有一个节点为Leader,其他则为Follower,Leader是通过内部的选举机制临时产生的。
(3)以一个简单的例子来说明整个选举的过程。
假设有五台服务器组成的Zookeeper集群,它们的id从1-5,同时它们都是最新启动的,也就是没有历史数据,在存放数据量这一点上,都是一样的。假设这些服务器依序启动,来看看会发生什么。
4.写数据流程


若有收获,就点个赞吧
0 人点赞


