第一章.Hive数据类型
1.基本数据类型
| HIVE | MySQL | JAVA | 长度 | 例子 |
|---|---|---|---|---|
| TINYINT | TINYINT | byte | 1byte有符号整数 | 2 |
| SMALINT | SMALINT | short | 2byte有符号整数 | 20 |
| INT | INT | int | 4byte有符号整数 | 20 |
| BIGINT | BIGINT | long | 8byte有符号整数 | 20 |
| BOOLEAN | 无 | boolean | 布尔类型,true或者false | TRUE |
| FLOAT | FLOAT | float | 单精度浮点数 | 3.14159 |
| DOUBLE | DOUBLE | double | 双精度浮点数 | 3.14159 |
| STRING | VARCHAR | string | 字符序列,可以指定字符集,可以使用单引号或双引号 | “hello” |
| TIMESTEAP | TIMESTAMP | 时间类型 | ||
| BINARY | BINARY | 字节数组 |
对于Hive的String类型相当于数据库的varchar类型,该类型是一个可变的字符串,不过他不能声明其中最多能存储多少个字符,理论上它可以存储2GB的字符数
2.集合数据类型
| 数据类型 | 描述 | 语法示例 |
|---|---|---|
| STRUCT | 类似于java中的类都可以通过”.”访问元素内容 | structstreet:string,city:string |
| MAP | 键值对元组集合 | map |
| ARRAY | 数组是一组具有相同类型和名称的变量的集合 | array |
Hive有三种复杂数据类型ARRAY,MAP和STRUCT,ARRAY和MAP与Java的ARRAY和MAP类似,而STRUCT与C语言中的struct类似,它封装了一个命名字段集合,复杂数据类型允许任意层次的嵌套
2.1 案例实操
// 1.假设某表有如下一行,我们用JSON格式来表示其数据结构,在Hive下访问的格式为{"name":"songsong","friends":["bingbing" ,"lili"], //列表Array"children" : { //键值Map"xiao song":18"xiaoxiaosong":19}"address":{ //结构Struct"street":"hui long guan","city":"beijing","email":"10010"}}
# 2.基于上述数据结构,我们在Hive里创建对应的表,并导入数据# 创建本地测试文件 text.txtsongsong,bingbing_lili,xiao song:18_xiaoxiao song:19,hui long guan_beijingyangyang,caicai_susu,xiao yang:18_xiaoxiao yang:19,chao yang_beijing
注意MAP,STRUCT和ARRAY里的元素间关系都可以用同一个字符来表示,这里用”-“
#3.Hive上创建测试表testbeeline -u jdbc:hive2://hadoop102:10000 -n atguigu #HIVEJDBC访问create database db; #创建db数据库use db; #使用db数据库create table test(name string,friends array<string>,children map<string,int>,address struct<street:string,city:string,email:int>)row format delimited fields terminated by ','collection items terminated by "_"map keys terminated by ':'lines terminated by '\n';
#4.导入文本数据到测试表load data local inpath '/home/atguigu/test.txt' into table test;
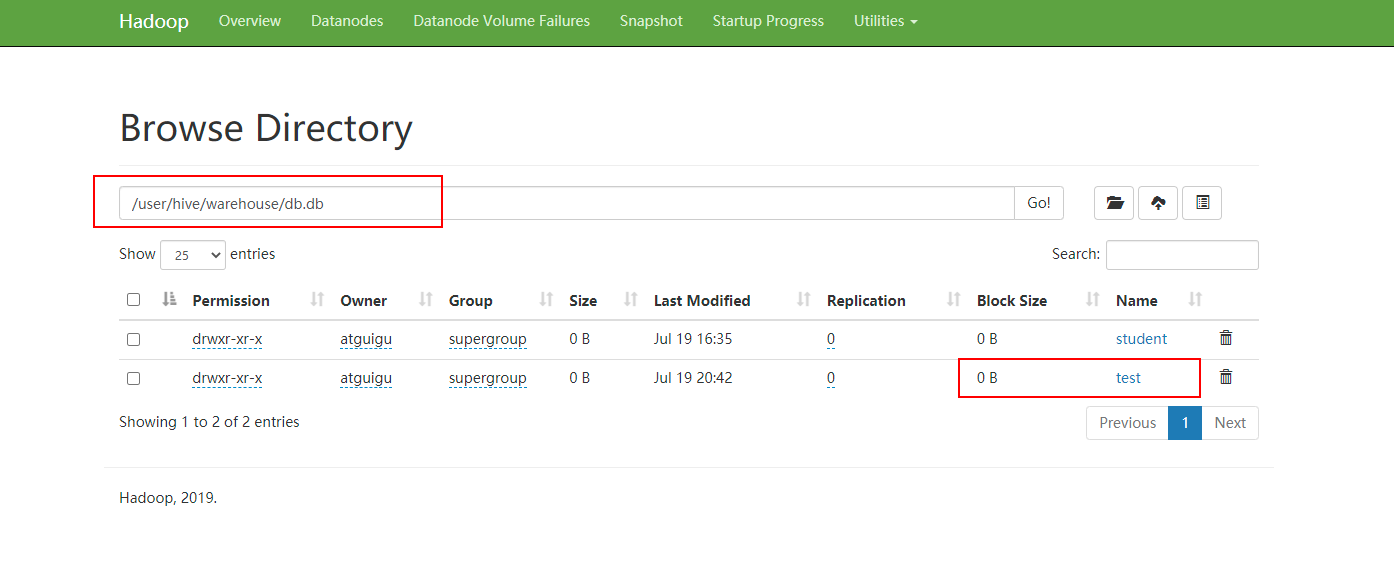
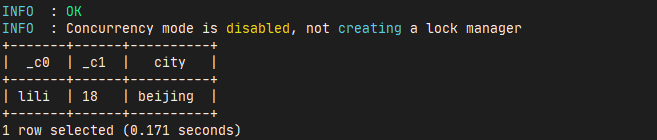
# 5.查询集合数据类型中的字段的内容select friends[1],children['xiao song'],address.city from test where name = "songsong";
2.2 类型转换
Hive的原子数据类型是可以进行隐式转换的,类似于java的类型转换,例如某表达式使用INT类型,TINYINT会自动转换为INT类型,但是HIve不会进行反向转化,例如,某表达式使用TINYINT类型,INT不会自动转换为TINYINT类型,它会返回错误,除非使用CAST操作
# 隐式类型转换规则(1)任何整数类型都可以隐式地转换为一个范围更广的类型,如TINYINT可以转换成INT,INT可以转换成BIGINT。(2)所有整数类型、FLOAT和STRING类型都可以隐式地转换成DOUBLE。(3)TINYINT、SMALLINT、INT都可以转换为FLOAT。(4)BOOLEAN类型不可以转换为任何其它的类型。# 可以使用CAST操作显示进行数据类型转换例如CAST('1' AS INT)将把字符串'1' 转换成整数1;如果强制类型转换失败,如执行CAST('X' AS INT),表达式返回空值 NULL。
第二章 DDL数据定义
1.库的操作
#创建库CREATE DATABASE [IF NOT EXISTS] 库名#IF NOT EXISTS :如果库不存在则创建,如果库存在则不创建。如果没该字段库存在时则报错[COMMENT 库的描述信息]#comment 定义库的描述信息[LOCATION 库在HDFS中所对应的路径]#LOCATION :库在HDFS中所对应的路径[WITH DBPROPERTIES ('key'='value', ...)];#WITH DBPROPERTIES :给库设置属性的值。#注意中括号中的内容是必须的
#创建库的语句create database if not exists db3comment 'this is database'location '/db3'with dbproperties('name'='longge');
#库的操作1.查看库:like:模糊查询show databases [like '匹配内容'];2.查看库详情 :extended可以查看库的属性desc database [extended] 库名;3.切换库:use 库名;4.修改数据库 : 只能修改属性alter database 库名 set dbproperties('key'='value');5.删库:cascade :删除非空的库#[if exists] : 如果库存在则删除,不存在则不删。如果没有该字段库不存在则报错。drop database [if exists] 库名 [cascade];
2.表的操作
# 创建表CREATE [EXTERNAL] TABLE [IF NOT EXISTS] 表名#[EXTERNAL] : 如果有该字段该表为外部表,如果没有该表为内部表(管理表)#[IF NOT EXISTS] :如果表不存在则创建,存在则不创建,没有该字段表存在则报错。[(字段名 字段类型 [COMMENT 字段的描述信息], ...)]#COMMENT :字段的描述信息[COMMENT 表的描述信息]#COMMENT :表的描述信息[PARTITIONED BY (分区字段名 字段类型 [COMMENT 字段的描述信息], ...)]#PARTITIONED BY :指定分区字段[CLUSTERED BY (分桶字段名1, 分桶字段名2, ...)#CLUSTERED BY :指定分桶字段[SORTED BY (排序字段 [ASC|DESC], ...)] INTO 桶的数量 BUCKETS]#SORTED BY :分桶时按照指字段进行排序,一般不用[ROW FORMAT row_format]#字段按照什么字符分隔开delimited fields terminated by ','#集合数据类(array,map,struct)型用什么分隔开collection items terminated by '_'#map的k,v用什么分隔开map keys terminated by ':'#每条数据用什么分隔开---默认就是按\n分开。lines terminated by '\n';[STORED AS 存储的格式]#STORED AS :存储格式默认为TextFile[LOCATION 表所在HDFS的路径]#LOCATION :指定表在HDFS所在的路径,如果不指定默认在库目录下面。[TBLPROPERTIES ('key'='value', ...)]#TBLPROPERTIES :给表指定属性[AS 查询语句]#as : 将查询的结果创建成一张新表[LIKE 存在的表的名称]#LIKE :根据现有的表结构创建一张新表(没有数据-只有表结构)
# 创建表语句:create table if not exists student2(id int comment 'this is id',name string comment 'this is name')comment 'this is table'row format delimited fields terminated by '\t'#1.默认情况下,表就在该库的下面。但是也可以不在一起需要指定。#2.表映射的路径的名字可以不和表名相同。location '/demo'tblproperties('version'='1.0');1.AS 查询语句create table if not exists stuasselect id,name from student2where id < 1010;2.LIKE 存在的表的名称create table if not exists stu2like stu;
# 管理表和外部表
1.创建管理表 --- 删除表时数据也会被删除掉
create table if not exists manager_tbl(
id int comment 'this is id',
name string comment 'this is name'
)
comment 'this is table'
row format delimited fields terminated by '\t'

2.创建外部表 --- 删除表时数据不会被删除
create external table if not exists external_tbl(
id int comment 'this is id',
name string comment 'this is name'
)
comment 'this is table'
row format delimited fields terminated by '\t'
# 表的操作
1.查看所有的表
show tables;
2.删除表
drop table 表名;
3.查看表结构:formatted-查看表的详情
desc [formatted] 表名;
4.内部表和外部表的转换(修改表的属性)
alter table 表名 set tblproperties('EXTERNAL'='TRUE/FALSE');
5.修改表名
ALTER TABLE 旧表名 RENAME TO 新表名;

 ===================1----6和7中当交换字段的顺序时一定要注意数据类型======================
 ===================2----6和7中当交换字段的顺序时数据不会交换位置=========================
6.修改列的类型 --- 修改的类型一定要能转化(比如int->string可以,反过来不行)。
ALTER TABLE 表名 CHANGE [COLUMN] 字段名 字段名 新的类型
[COMMENT 字段的描述信息] [FIRST|AFTER 字段名]
7.修改列的名字
ALTER TABLE 表名 CHANGE [COLUMN] 旧字段名 新字段名 原字段类型
[COMMENT 字段的描述信息] [FIRST|AFTER 字段名]
===========================================================================================

8.增加列
ALTER TABLE 表名 ADD COLUMNS (字段名 字段类型 [COMMENT 字段的描述信息], ...)

9.修改列
#①在替换列时,依次替换
#②如果替换的列少于原列,那么将会把没有被替换的列删除掉
#③替换列时一定要注意数据的类型。(原类型string替换的类型int是不可以的)
ALTER TABLE table_name REPLACE COLUMNS (字段名 字段类型 [COMMENT 字段的描述信息], ..., ...)

若有收获,就点个赞吧
0 人点赞


