第一章.Hadoop运行模式(本地运行模式)
Hadoop运行模式包括:本地模式,伪分布式模式以及完全分布式模式
- 在/opt/module/hadoop-3.1.3目录下面创建一个wcinput文件夹
mkdir wcinput
- 在wcinput目录下面创建一个wc.input文件并编辑
(1)cd wcinput(2)vi wcinput#添加如下内容hadoop yarnhadoop mapreduceatguiguatguigu#保存退出: wq
- 回到Hadoop目录
cd /opt/module/hadoop-3.1.3
- 执行程序
hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar wordcount wcinput wcoutput
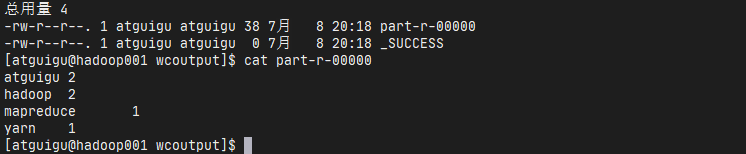
- 查看结果
cat wcoutput/part-r-00000
第二章.Hadoop运行模式(完全分布式运行模式)
1. 虚拟机准备
克隆两台虚拟机,修改ip以及hostname
2.编写集群分发脚本(xsync.sh)
2.1需求:循环复制文件到所有节点的相同目录下
2.2脚本实现:创建xsync文件,并编写如下代码
#!/bin/bash
#1. 判断参数个数
if [ $# -lt 1 ]
then
  echo Not Enough Arguement!
  exit;
fi
#2. 遍历集群所有机器
for host in hadoop102 hadoop103 hadoop104
do
  echo ====================  $host  ====================
  #3. 遍历所有目录,挨个发送
  for file in $@
  do
    #4 判断文件是否存在
    if [ -e $file ]
    then
      #5. 获取父目录
      pdir=$(cd -P $(dirname $file); pwd)
      #6. 获取当前文件的名称
      fname=$(basename $file)
      ssh $host "mkdir -p $pdir"
      rsync -av $pdir/$fname $host:$pdir
    else
      echo $file does not exists!
    fi
  done
done
2.3修改脚本xsync具有执行权限
chmod +x xsync
2.4将脚本移动到已经配备过环境变量的目录中,以使全局使用
sudo mv sysnc /opt/module/hadoop-3.1.3/bin
#说明:在/home/atguigu/bin这个目录下存放的脚本,atguigu用户可以在系统任何地方直接执行
3.SSH无密登录配置
3.1配置ssh
ssh 另一台电脑的IP地址
正常来说会要求输入密码
3.2无密钥配置
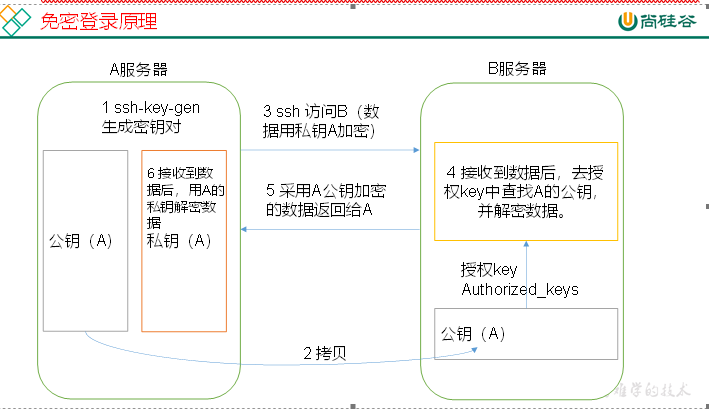
- 免密登录原理
- 在集群的各个节点上执行以下四个命令
ssh-keygen -t rsa #生成公钥和私钥
ssh-copy-id hadoop102 #将公钥拷贝到hadoop102上
ssh-copy-id hadoop103 #将公钥拷贝到hadoop103上
ssh-copy-id hadoop104 #将公钥拷贝到hadoop104上
4. 集群配置
4.1 集群部署规划
- NameNode和SecondaryNameNode不要安装在同一台机器上
- ResourceManager也很消耗内存,不要和NameNode,SecondaryNameNode配置在同一台机器上
| hadoop102 | hadoop103 | hadoop104 | |
|---|---|---|---|
| HDFS | NameNode DataNode | DataNode | SecondaryNameNode DataNode |
| YARN | NodeManager | NodeManager ResourceManager | NodeManager |
4.2配置集群
- core-site.xml(核心配置文件)
cd $HADOOP_HOME/etc/hadoop
vim core-site.xml
#文件内容如下
<configuration>
<!--指定HDFS中NameNode的地址 -->
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://hadoop102:9820</value>
</property>
<!-- 指定Hadoop运行时产生文件的存储目录 -->
    <property>
        <name>hadoop.tmp.dir</name>
        <value>/opt/module/hadoop-3.1.3/data</value>
</property>
<!--  通过web界面操作hdfs的权限 -->
<property>
        <name>hadoop.http.staticuser.user</name>
        <value>atguigu</value>
</property>
<!-- 后面hive的兼容性配置  -->
    <property>
        <name>hadoop.proxyuser.atguigu.hosts</name>
        <value>*</value>
    </property>
    <property>
        <name>hadoop.proxyuser.atguigu.groups</name>
        <value>*</value>
</property>
</configuration>
- hdfs-site.xml(HDFS配置文件)
vim hdfs-site.xml
<configuration>
    <property>
        <name>dfs.namenode.secondary.http-address</name>
        <value>hadoop104:9868</value>
    </property>
</configuration>
- yarn-site.xml(YARN配置文件)
vim yarn-site.xml
<configuration>
<!--  Reducer获取数据的方式-->
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
</property>
<!--  指定YARN的ResourceManager的地址-->
    <property>
        <name>yarn.resourcemanager.hostname</name>
        <value>hadoop103</value>
</property>
<!-- 环境变量通过从NodeManagers的容器继承的环境属性,对于mapreduce应用程序,除了默认值 hadoop op_mapred_home应该被添加外。属性值 还有如下-->
    <property>
        <name>yarn.nodemanager.env-whitelist</name>
<value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
</property>
<!-- 解决Yarn在执行程序遇到超出虚拟内存限制,Container被kill  -->
    <property>
        <name>yarn.nodemanager.pmem-check-enabled</name>
        <value>false</value>
    </property>
    <property>
        <name>yarn.nodemanager.vmem-check-enabled</name>
        <value>false</value>
    </property>
<!-- 后面hive的兼容性配置  -->
    <property>
        <name>yarn.scheduler.minimum-allocation-mb</name>
        <value>512</value>
    </property>
    <property>
        <name>yarn.scheduler.maximum-allocation-mb</name>
        <value>4096</value>
    </property>
    <property>
        <name>yarn.nodemanager.resource.memory-mb</name>
        <value>4096</value>
</property>
</configuration>
- MapReduce.xml(MapReduce配置文件)
vim mapred-site.xml
<configuration>
<!-- 指定MR运行在Yarn上 -->
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
</configuration>
- 在集群上分发配置好的Hadoop配置文件
xsync /opt/module/hadoop-3.1.3/etc/hadoop/
4.3群起集群
- 配置workers
vim /opt/module/hadoop-3.1.3/etc/hadoop/workers
在该文件中添加如下内容
hadoop102
hadoop103
hadoop104
注意: 该文件中添加的内容结尾不允许有空格,文件中不允许有空格
同步所有节点配置文件
xsync /opt/module/hadoop-3.1.3/etc
- 启动集群
1.如果集群是第一次启动,需要在hadoop001节点格式化NameNode(注意格式化之前一定要先停止上次启动的所有namenode和datanode进程,然后删除data和log数据)
hdfs namenode -format
2.启动HDFS(程序路径:$HADOOP_HOME/sbin)
start-dfs.sh
3.在配置了ResourceManager的节点(hadoop002)上启动YARN
start-yarn.sh
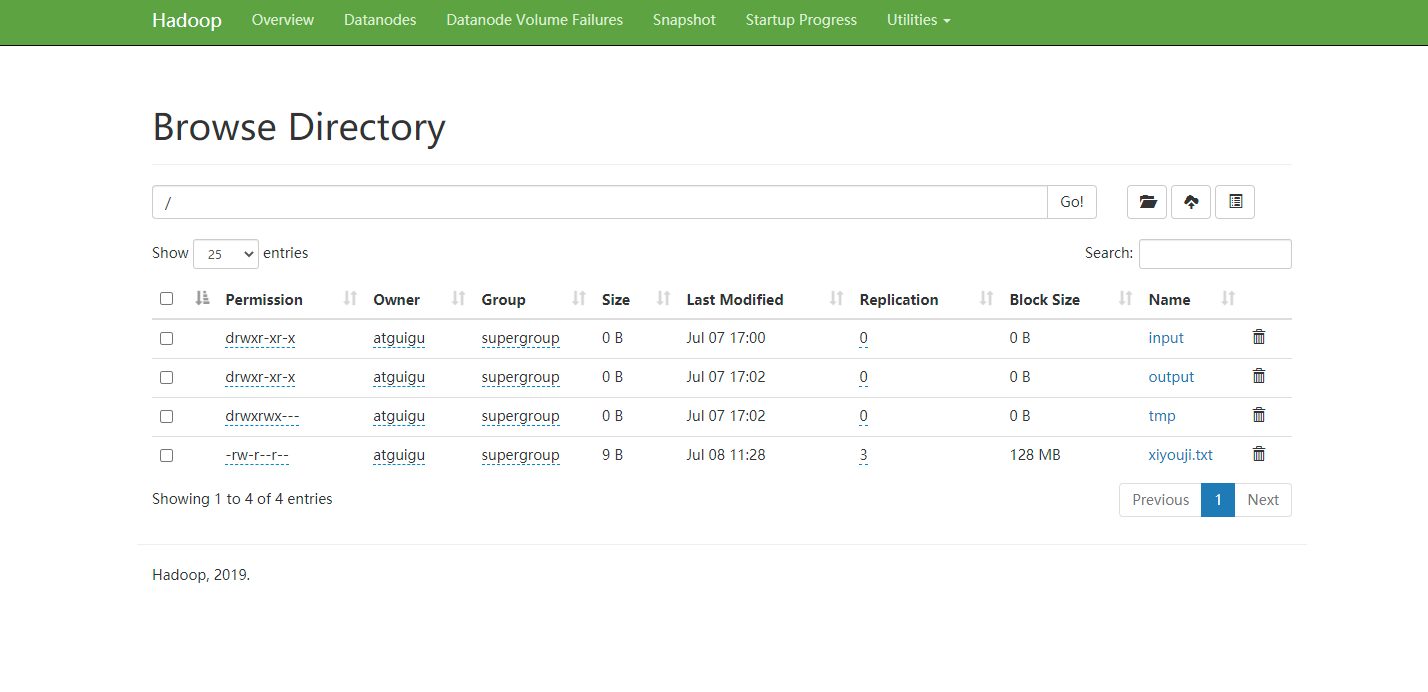
- Web端查看
http://hadoop102:9870/explorer.html#/
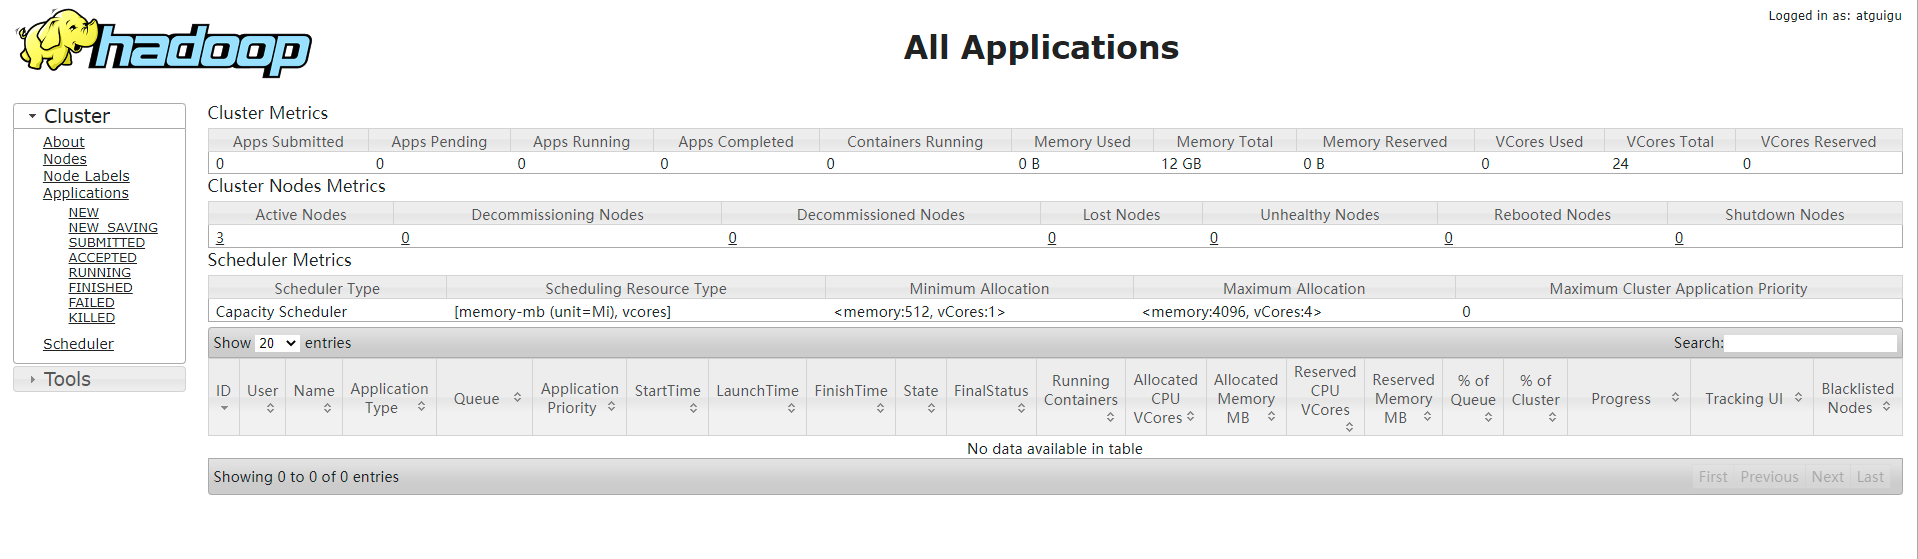
http://hadoop104:9868/status.html

解决看不到上面内容的方法
- 路径:$HADOOP_HOME/share/hadoop/hdfs/webapps/static
- 查看dfs-dust.js的第61行
        'date_tostring' : function (v) {

            return moment(Number(v)).format('ddd MMM DD HH:mm:ss ZZ YYYY');

},
- 修改函数返回值如下:
       date_tostring' : function (v) {

           return new Date(Number(v)).toLocaleString();
}
- 常用脚本
mycluster.sh(群起群停脚本)
#!/bin/bash
if [ $# -ne 1 ]
    then
        echo "args number error!!!!!!"
        exit
fi

case $1 in
"start")
    ssh hadoop102 start-dfs.sh
    ssh hadoop103 start-yarn.sh
    ;;
"stop")
    #必须保证hadoop102和hadoop103有HADOOP的环境变量
    ssh hadoop102 stop-dfs.sh
    ssh hadoop103 stop-yarn.sh
    ;;
*)
    echo "args info error!!!!!!"
    ;;
esac
clear.sh(清理脚本:解决多次格式化问题)
#!/bin/bash
for host in hadoop102 hadoop103 hadoop104
do
    ssh $host rm -rf $HADOOP_HOME/data $HADOOP_HOME/logs
    ssh $host sudo rm -rf /tmp/*
done
ssh hadoop102 hdfs namenode -format
jpsall.sh(查看所有java进程脚本)
#!/bin/bash
for host in hadoop102 hadoop103 hadoop104
do
    echo "========================$host======================"
    ssh $host jps
done
- 集群基本测试
上传文件测试
hadoop fs -put /opt/software/hadoop-3.1.3.tar.gz /
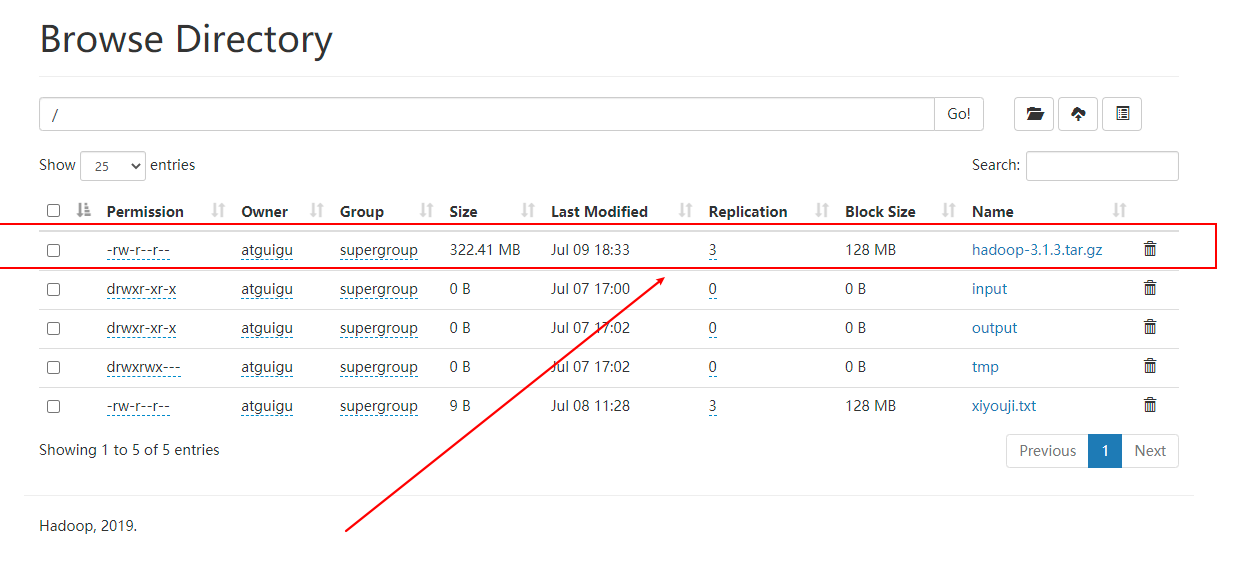
HDFS文件存储路径

/opt/module/hadoop-3.1.3/data/dfs/data/current/BP-916739471-192.168.10.102-1625635623345/current/finalized/subdir0/subdir0:
- 集群启动/停止方式总结
1.#各个服务组件逐一启动/停止
hdfs --daemon start/stop namenode/datanode/secondarynamenode #分别启动停止HDFS组件
yarn --daemon start/stop nodemanager/resourcemanager#启动停止YARN
2.#各个模块分开启动/停止(配置SSH是前提)
start-dfs.sh/stop-dfs.sh #整体启动停止HDFS
start-yarn.sh/stop-yarn.sh#整体启动停止YARN
第三章.其他配置
1.配置历史服务器
为了查看程序的历史运行情况,需要配置一下历史服务器
- 配置Mapred-site.xml($HADOOP_HOME/etc/hadoop)
<!-- 历史服务器端地址 -->
<property>
    <name>mapreduce.jobhistory.address</name>
    <value>hadoop102:10020</value>
</property>

<!-- 历史服务器web端地址 -->
<property>
    <name>mapreduce.jobhistory.webapp.address</name>
    <value>hadoop102:19888</value>
</property>
- 分发配置
xsync $HADOOP_HOME/etc/hadoop/mapred-site.xml
- 在hadoop102上启动历史服务器
mapred --daemon start historyserver
- 查看历史服务器是否启动
jps
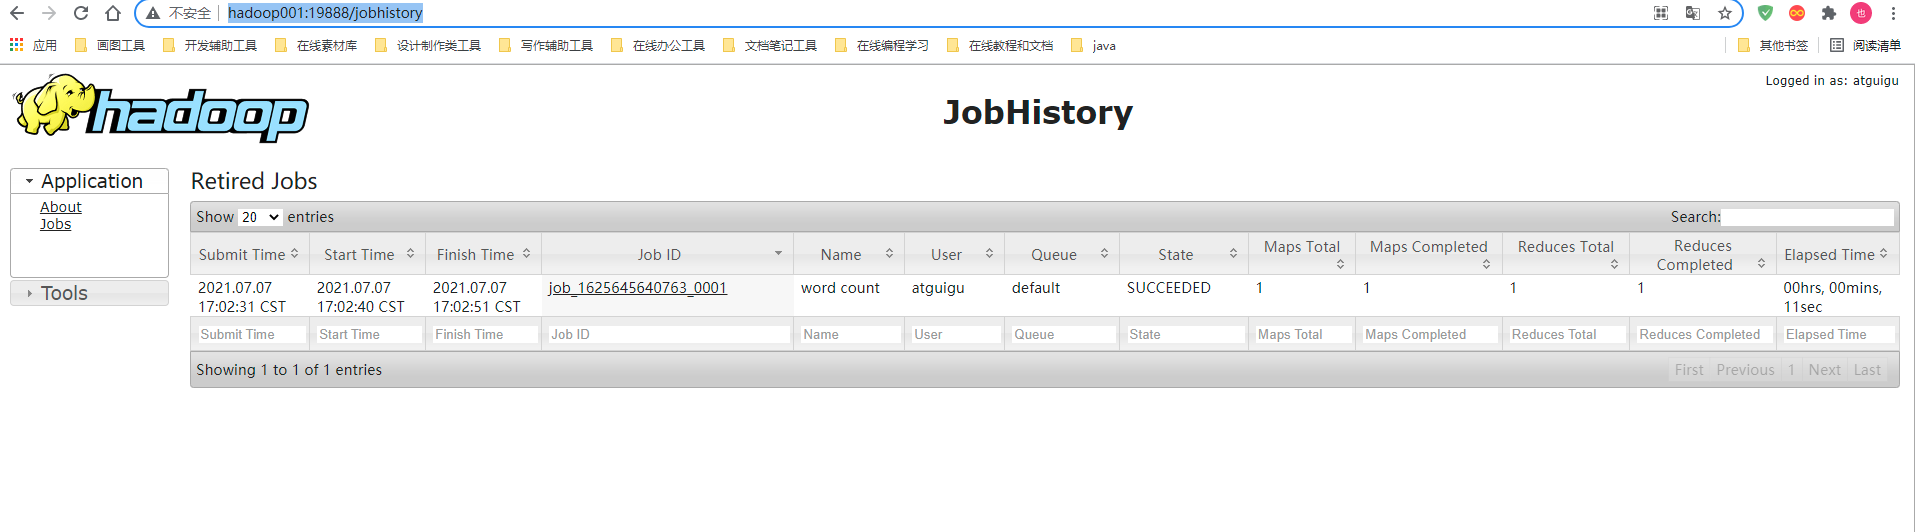
- 浏览器查看
http://hadoop102:19888/jobhistory
2.配置日志的聚集
- 日志聚集概念:应用运行完成以后,将程序运行日志信息上传到HDFS系统上
- 日志聚集好处:可以方便查看到程序运行详情,方便开发调试
- 注意:开启日志聚集功能,需要重新启动Nodemanager,Resourcemanager和HistoryManager
- 配置yarn-site.xml($HADOOP_HOME/etc/hadoop)
<!-- 开启日志聚集  -->
<property>
    <name>yarn.log-aggregation-enable</name>
    <value>true</value>
</property>
<!-- 访问路径-->
<property>
    <name>yarn.log.server.url</name>
    <value>http://hadoop102:19888/jobhistory/logs</value>
</property>
<!-- 保存的时间7天 -->
<property>
    <name>yarn.log-aggregation.retain-seconds</name>
    <value>604800</value>
</property>
- 分发配置
xsync $HADOOP_HOME/etc/hadoop/yarn-site.xml
- 关闭NodeManager 、ResourceManager和HistoryServer
在002上执行: stop-yarn.sh
在001上执行: mapred --daemon stop historyserver
- 启动NodeManager,Timelineserver和HistoryServer
在002上执行:start-yarn.sh
在002上执行:yarn --daemon start timelineserver
在001上执行:mapred --daemon start historyserver
- 删除HDFS已经存在的输出文件
hdfs dfs -rm -R /user/atguigu/output
- 执行WordCount程序
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar wordcount /user/atguigu/input /user/atguigu/output
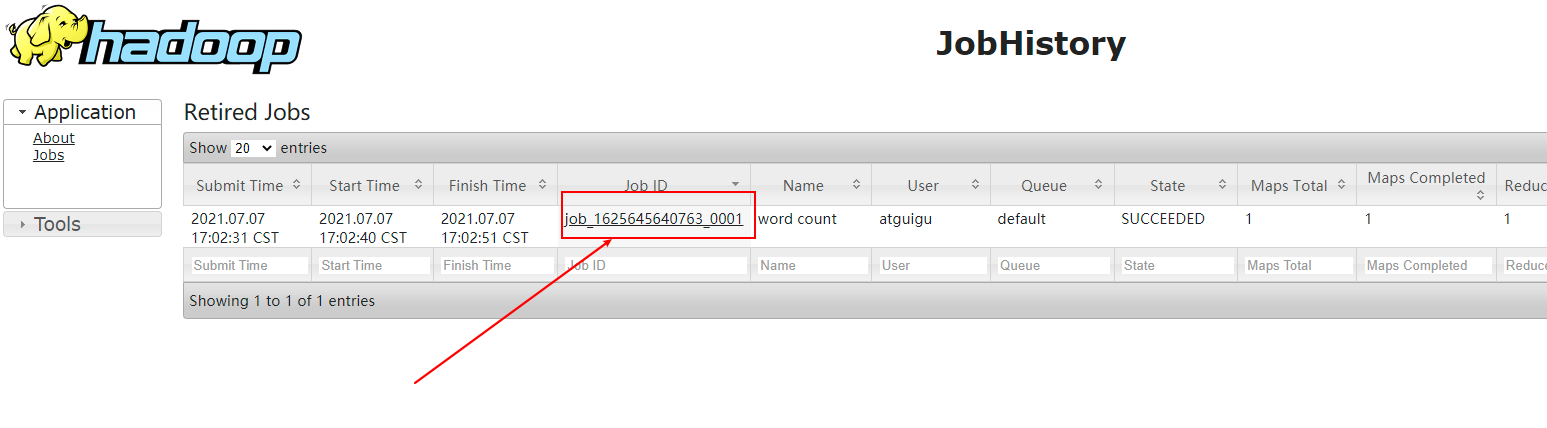
- 查看日志
http://hadoop102:19888/jobhistory


3.集群时间同步
时间同步概念:找一个机器,作为时间服务器,所有的机器与这台集群时间进行定时的同步,比如每隔十分钟,同步一次时间
具体步骤
- 时间服务器配置
- 在Hadoop001上关闭ntp服务和自启动
sudo systemctl stop ntpd
sudo systemctl disable ntpd
- 修改ntp配置文件
sudo vim/etc/ntp.conf
1.修改(授权192.168.1.0-192.168.1.255网段上的所有机器可以从这台机器上查询和同步时间)
#restrict 192.168.1.0 mask 255.255.255.0 nomodify notrap修改为
restrict 192.168.1.0 mask 255.255.255.0 nomodify notrap
2.集群在局域网中,不使用其他互联网上的时间
server 0.centos.pool.ntp.org iburst
server 1.centos.pool.ntp.org iburst
server 2.centos.pool.ntp.org iburst
server 3.centos.pool.ntp.org iburst
修改为
#server 0.centos.pool.ntp.org iburst
#server 1.centos.pool.ntp.org iburst
#server 2.centos.pool.ntp.org iburst
#server 3.centos.pool.ntp.org iburst
3.(当该节点丢失网络连接,依然可以采用本地时间作为时间服务器为集群中的其他节点提供时间同步)
server 127.127.1.0
fudge 127.127.1.0 stratum 10
- 修改/etc/sysconfig/ntpd文件
1.sudo vim etc/sysconfig/ntpd
2.增加如下内容
SYNC_HWCLOCK=yes
- 重新启动ntpd服务并设为开机自启
systemctl start ntpd
systemctl enable ntpd
- 其他机器配置(必须root用户)
- 在其他机器配置10分钟与时间服务器同步一次
crontab -e
编写定时任务如下
*/1 * * * * /usr/sbin/ntpdate hadoop102
- 修改机器时间
date -s "2017-9-11 11:11:11"
- 一分钟后查看机器是否与时间服务器同步
date

若有收获,就点个赞吧
0 人点赞


