第一章.HBase进阶
1.RegionServer架构

# storeFile- 保存实际数据的物理文件,StoreFile以Hfile的形式存储在HDFS 上,每个Store会有一个或多个StoreFile(Hfile),数据在每个StoreFile都是有序的# MemStore- 写缓存,由于Hfile中的数据要求是有序的,所以数据是先存储在MemStore中,排好序后,等到达刷写时机才会刷写到HFile,每次刷写都会形成一个新的HFile# WAL- 由于数据要经MemStore排序后才能刷写到HFile,但把数据保存在内存中会有很高的概率导致数据丢失,为了解决这个问题,数据会先写在一个叫做Write-Ahead logfile的文件中,然后再写入MemStore中,所以在系统出现故障的时候,数据可以通过这个日志文件重建# BlockCache- 读缓存,每次查询出的数据会缓存在BlockCache中,方便下次查询
2.写流程
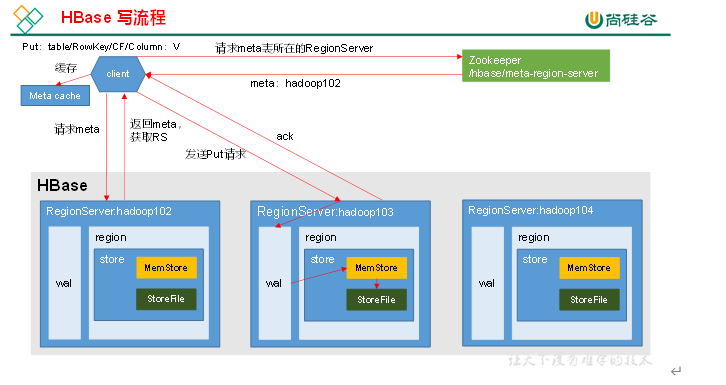
写流程:
- Client先访问zookeeper,获取hbase:meta表位于哪个Region Server
- 访问对应的Region Server,获取hbase:meta表根据读请求的namespace:table/rowkey,查询出目标数据位于哪个Region Server中的哪个Region中,并将该table的region信息以及meta表的位置信息缓存在客户端的meta cache,方便下次访问
- 与目标Region Server进行通讯
- 将数据顺序写入(追加)到WAL
- 将数据写入对应的MemStore,数据会在MemStore进行排序
- 向客户端发送ack
- 等到达MemStore的刷写时机后,将数据刷写到Hfile
3.MemStore Flush(刷写时机)

1. 当某个MemStore的大小达到了hbase.hregion.memstore.flush.size(默认值128M),其所在region的所有memstore都会刷写:当memstore的大小达到了 hbase.hregion.memstore.flush.size(默认值128M) *hbase.hregion.memstore.block.multiplier(默认值4)时,会阻止继续往memstore写数据2. 当region server中的memstore的总大小达到java_heapsize*hbase.regionserver.global.memstore.size(默认值0.4)*hbase.regionserver.global.memstore.size.lower.limit(默认值0.95)region会按照其所有的memstore大小顺序(由大到小)依次进行刷写,直到region server中所有的memstore的总大小减小到上述值以下当region server中memstore的总大小达到java_heapsize*hbase.regionserver.global.memstore.size(默认值0.4)时,会阻止继续往所有的memstore写数据3. 到达自动刷写的时间,也会触发memstore flush,自动刷新的时间间隔由该属性进行配置hbase.regionserver.optionalcacheflushinterval(默认1小时)4. 当WAL文件的数量超过hbase.regionserver.max.logs,region会按照时间顺序依次进行刷写,直到WAL文件数量减少到hbase.regionserver.max.logs以下(该属性名已经废弃,现无需手动设置,最大值为32)
4.读流程
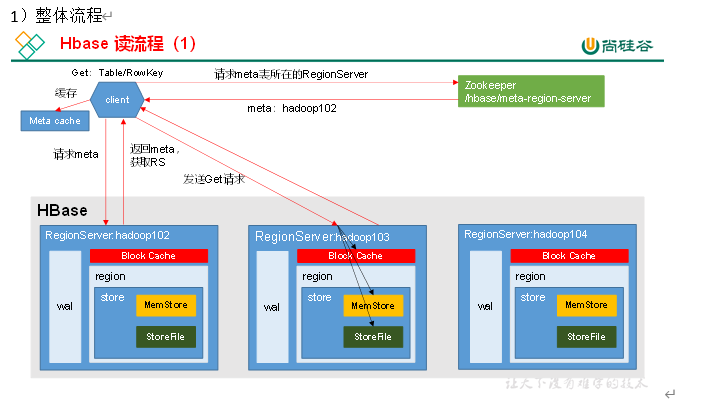
- 整体流程
- Merge细节
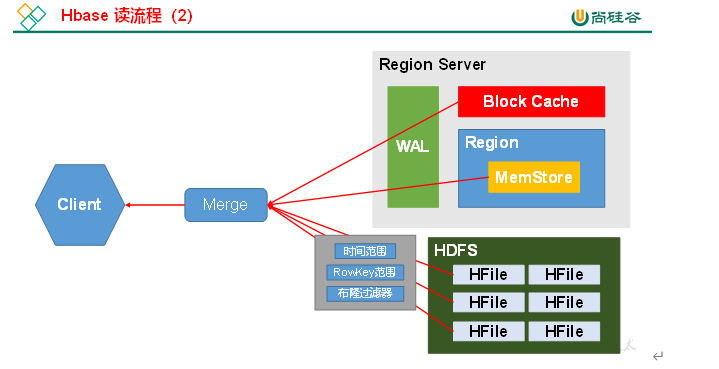
读流程:
- Client先访问zookeeper,获取hbase:meta表位于哪个Region Server
- 访问对应的Region Server, 获取hbase:meta表,根据读请求的namespace:table/rowkey,查询出目标数据位于哪个Region中,并将该table的region信息以及meta表的位置信息缓存在客户端的meta cache,方便下次访问
- 与目标Region Server进行通讯
- 分别在MemStore和Store File(Hfile)中查询目标数据,并将查到的所有数据进行合并,此处所有数据是指同一条数据的不同版本(time stamp)或者不同的类型(Put/Delete)
- 将查询到的新的数据块(Block,Hfile数据存储单元,默认大小为64kb)缓存到Block Cache
- 将合并后的最终结果返回给客户端
5.StoreFile Compaction
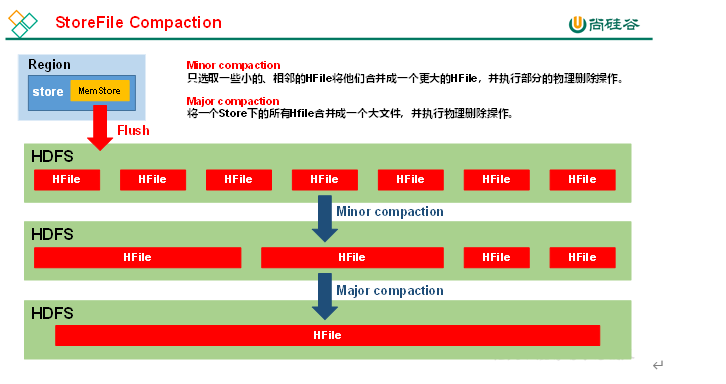
- 由于memstore每次刷写都会生成一个新的Hfile,且同一个字段的不同版本(timestamp)和不同类型(Put/Delete)有可能会分布在不同的hfile中,因此查询时需要遍历所有的Hfile,为了减少Hfile的个数,以及清理掉过期和删除的数据,会进行StoreFile Compaction- Compaction分为两种,分别是Minor Compaction 和 Major Compaction,Minor Compaction会将临近的若干个较小的Hfile合并成一个较大的Hfile,并清理掉部分过期和删除的数据,Major Compaction 会将一个Store下的所有Hfile合并成一个大的Hfile,并且会清理掉所有过期和删除的数据
6.Region Split
- 默认情况下,每个Table起初只有一个Region,随着数据的不断写入,Region会自动进行拆分,刚拆分时,两个子Region都位于当前的Region Server,但随着负载均衡的考虑,HMaster有可能会将某个Region转移给其他的Region Server- Region Split时机:1. 当一个Region中的某个Store下所有的StoreFile的总大小超过hbase.hregion.max.filesize,该Region就会进行拆分(0.94版本之前)2. 当一个region中的某个Store下所有StoreFile的总大小超过Min(initialSize*R^3,hbase.hregion.max.filesize),该region就会进行拆分,其中initialSize的默认值为2*hbase.hregion.memstore.flush.size,R为当前Region Server中属于该Table的Region个数(0.94版本之后)具体的切分策略为:第一次 split :1^3*256 =256MB第二次split:2^3 * 256 = 2048MB第三次split:3^3 * 256 = 6912MB第四次split:4^3 * 256 = 16384MB > 10GB,因此取较小的值10GB后面每次split的size都是10GB了3. HBase2.0引入了新的split策略,如果当前RegionServer上该表只有一个Region,按照2* hbase.hregion.memstore.flush.size分裂,否则按照hbase.hregion.max.filesize分裂

第二章.HBase API
1.环境准备
新建一个maven项目,并添加依赖
<dependency><groupId>org.apache.hbase</groupId><artifactId>hbase-server</artifactId><version>2.0.5</version></dependency><dependency><groupId>org.apache.hbase</groupId><artifactId>hbase-client</artifactId><version>2.0.5</version></dependency>
2.DDL
package com.atguigu.hbaseapi;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.hbase.HBaseConfiguration;import org.apache.hadoop.hbase.NamespaceDescriptor;import org.apache.hadoop.hbase.TableName;import org.apache.hadoop.hbase.client.*;import org.apache.hadoop.hbase.util.Bytes;import java.io.IOException;import java.util.List;public class HBaseDDL {public static Connection connection;static{try{//创建配置对象Configuration configuration = HBaseConfiguration.create();configuration.set("hbase.zookeeper.quorum","hadoop102:2181");//获取连接对象connection = ConnectionFactory.createConnection(configuration);}catch(IOException e){e.printStackTrace();}}/*** @Description: 创建命名空间* @Param: [nameSpace]* @return: void* @Author: jcsune* @Date: 2021/8/2*/public static void createNameSpace(String nameSpace) throws IOException{//获取adminAdmin admin = connection.getAdmin();//构建NameSpaceDescriptorNamespaceDescriptor.Builder builder = NamespaceDescriptor.create(nameSpace);NamespaceDescriptor namespaceDescriptor = builder.build();//利用admin创建命名空间admin.createNamespace(namespaceDescriptor);System.out.println("创建命名空间" + nameSpace + "成功");//关闭资源admin.close();}/*** @Description: 列出当前所有的命名空间* @Param: []* @return: void* @Author: jcsune* @Date: 2021/8/2*/public static void listNameSpace()throws IOException{//获取adminAdmin admin = connection.getAdmin();//获取所有命名空间的信息NamespaceDescriptor[] namespaceDescriptors = admin.listNamespaceDescriptors();System.out.println("所有的命名空间:");for (NamespaceDescriptor namespaceDescriptor : namespaceDescriptors) {System.out.println(namespaceDescriptor.getName());}//关闭命名空间admin.close();}/*** @Description: 删除命名空间* @Param: [nameSpace]* @return: void* @Author: jcsune* @Date: 2021/8/2*/public static void dropNameSpace(String nameSpace) throws IOException{//获取adminAdmin admin = connection.getAdmin();//删除命名空间admin.deleteNamespace(nameSpace);System.out.println("删除命名空间" + nameSpace + "成功");//关闭资源admin.close();}/*** @Description: 创建表* @Param: [tableName, cf]* @return: void* @Author: jcsune* @Date: 2021/8/2*/public static void createTable(String tableName,String cf) throws IOException{//获取adminAdmin admin = connection.getAdmin();//判断if(existsTable(tableName)){System.out.println(tableName+ "表已将存在了");return;}//构建表描述者构造器TableDescriptorBuilder tableDescriptorBuilder = TableDescriptorBuilder.newBuilder(TableName.valueOf(tableName));//创建一个列族描述者构造器ColumnFamilyDescriptorBuilder columnFamilyDescriptorBuilder = ColumnFamilyDescriptorBuilder.newBuilder(Bytes.toBytes(cf));ColumnFamilyDescriptor columnFamilyDescriptor = columnFamilyDescriptorBuilder.build();//向表描述者构造器设置列族信息tableDescriptorBuilder.setColumnFamily(columnFamilyDescriptor);TableDescriptor tableDescriptor = tableDescriptorBuilder.build();//创建表admin.createTable(tableDescriptor);System.out.println(tableName+"表创建成功");//关闭资源admin.close();}/*** @Description: 删除表* @Param: [tableName]* @return: void* @Author: jcsune* @Date: 2021/8/2*/public static void dropTable(String tableName) throws IOException{//获取adminAdmin admin = connection.getAdmin();//判断if (!existsTable(tableName)){System.out.println(tableName + "表不存在");admin.close();return;}//删除表admin.deleteTable(TableName.valueOf(tableName));System.out.println(tableName+"表删除成功");//关闭资源admin.close();}/*** @Description: 列出所有表* @Param: []* @return: void* @Author: jcsune* @Date: 2021/8/2*/public static void listTable() throws IOException{//获取adminAdmin admin = connection.getAdmin();//列出表List<TableDescriptor> tableDescriptors = admin.listTableDescriptors();//遍历System.out.println("所有的表:");for (TableDescriptor tableDescriptor : tableDescriptors) {System.out.println(tableDescriptor.getTableName());}//关闭资源admin.close();}/*** @Description: 判断表是否存在* @Param: [tableName]* @return: boolean* @Author: jcsune* @Date: 2021/8/2*/private static boolean existsTable(String tableName) throws IOException{//获取adminAdmin admin = connection.getAdmin();//判断boolean exists = admin.tableExists(TableName.valueOf(tableName));return exists;}public static void main(String[] args) {try {//HBaseDDL.createNameSpace("xiyouji");//listNameSpace();//dropNameSpace("xiyouji");listTable();createTable("xiyouji","info");dropTable("xiyouji");} catch (IOException e) {e.printStackTrace();}}}
3.DML
package com.atguigu.hbase.API.demo.DML;import com.atguigu.hbase.API.demo.DDL.HBaseDDL;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.hbase.Cell;import org.apache.hadoop.hbase.CellUtil;import org.apache.hadoop.hbase.HBaseConfiguration;import org.apache.hadoop.hbase.TableName;import org.apache.hadoop.hbase.client.*;import org.apache.hadoop.hbase.util.Bytes;import java.awt.event.WindowFocusListener;import java.io.IOException;/*** @author leon* @ClassName HBaseDML.java* @createTime 2021年07月31日 11:11:00*/public class HBaseDML {public static Connection connection;static {try {// 1.创建配置对象Configuration configuration = HBaseConfiguration.create();configuration.set("hbase.zookeeper.quorum", "hadoop102:2181");// 2. 获取连接对象connection = ConnectionFactory.createConnection(configuration);} catch (IOException e) {e.printStackTrace();}}/*** 插入/修改* @param tableName* @param rowkey* @param cf* @param cn* @param value*/public static void putData(String tableName, String rowkey, String cf, String cn, String value) throws IOException {// 1. 获取Table对象Table table = connection.getTable(TableName.valueOf(tableName));// 2. 构建put对象Put put = new Put(Bytes.toBytes(rowkey));// 3. 设置列族、列名属性put.addColumn(Bytes.toBytes(cf),Bytes.toBytes(cn),Bytes.toBytes(value));// 4. 执行插入table.put(put);System.out.println("数据插入成功");// 5. 关闭资源table.close();}/*** get* @param tableName* @param rowkey* @param cf* @param cn*/public static void getData(String tableName, String rowkey, String cf, String cn) throws IOException {// 1. 获取Table对象Table table = connection.getTable(TableName.valueOf(tableName));// 2. 构建get对象Get get = new Get(Bytes.toBytes(rowkey));// 3. 设置列族、列名属性if(cf == null && cn != null){System.out.println("输入有误");table.close();return;}if(cf != null && cn == null){// 查询某列族get.addFamily(Bytes.toBytes(cf));}if(cf != null && cn != null){// 查询cellget.addColumn(Bytes.toBytes(cf), Bytes.toBytes(cn));}// 4. 执行插入Result result = table.get(get);// 5. 解析resultCell[] cells = result.rawCells();// 6. 遍历System.out.println("数据是:");for (Cell cell : cells) {String rk = Bytes.toString(cell.getRowArray());String rowkey1 = Bytes.toString(CellUtil.cloneRow(cell));String cFamily = Bytes.toString(CellUtil.cloneFamily(cell));String cname = Bytes.toString(CellUtil.cloneQualifier(cell));String value = Bytes.toString(CellUtil.cloneValue(cell));System.out.println("rk:"+rk);System.out.println("rowkey1:"+rowkey1+", cf:cn"+cFamily+":"+cname+", value:"+value);}// 5. 关闭资源table.close();}/*** 扫描表* @param tableName*/public static void scanData(String tableName) throws IOException {// 1. 获取Table对象Table table = connection.getTable(TableName.valueOf(tableName));// 2. 创建scanScan scan = new Scan();// 3. 扫描ResultScanner scanner = table.getScanner(scan);System.out.println("数据是:");for (Result result : scanner) {Cell[] cells = result.rawCells();for (Cell cell : cells) {String rowkey1 = Bytes.toString(CellUtil.cloneRow(cell));String cFamily = Bytes.toString(CellUtil.cloneFamily(cell));String cname = Bytes.toString(CellUtil.cloneQualifier(cell));String value = Bytes.toString(CellUtil.cloneValue(cell));System.out.println("rowkey1:"+rowkey1+", cf:cn"+cFamily+":"+cname+", value:"+value);}}// 5. 关闭资源table.close();}/*** 删除数据*/public static void dropData(String tableName, String rowKey) throws IOException {// 1. 获取tableTable table = connection.getTable(TableName.valueOf(tableName));// 2. 创建delete对象Delete delete = new Delete(Bytes.toBytes(rowKey));// 3. 删除一行数据table.delete(delete);System.out.println("删除数据成功");// 4. 关闭资源table.close();}public static void main(String[] args) {try {// HBaseDDL.createTable("xixi", "info");// putData("xixi", "1001", "info","name", "张三");// putData("xixi", "1001", "info","age", "23");// putData("xixi", "1001", "info","sex", "难");// System.out.println("=====查询一行======");// getData("xixi", "1001", null, null);// System.out.println("=====查询一列族======");// getData("xixi", "1001", "info", null);// System.out.println("=====查cell======");// getData("xixi", "1001", "info", "sex");// scanData("xixi");// dropData("xixi", "1001");// scanData("xixi");getData("STUDENT", "1001", null, "name");} catch (IOException e) {e.printStackTrace();}}}
第三章.HBase优化
1.预分区
每一个region维护着startRow与endRow,如果加入的数据符合某个region维护的rowKey范围,则该数据交给这个region维护,那么依照这个原则,我们可以将数据将要投放的分区提前大致的规划好,以提高HBase性能
- 手动设定预分区
create 'xixi','info',SPILTS =>['1000','2000','3000','4000']
- 生成16进制序列预分区
create 'xixi','info',{NUMREGIONS => 15, SPLITALGO => 'HexStringSplit'}
- 按照文件设置的规则预分区
创建splits.txt,文件内容如下
aaaabbbbccccdddd
然后执行
create 'xixi','info',SPLITS FILE => 'splits.txt'
- 使用JavaAPI创建预分区
//自定义算法,产生一系列Hash散列值存储在二维数组中byte[][] splitKeys = 某个散列值函数//创建HbaseAdmin实例HBaseAdmin hAdmin = new HBaseAdmin(HbaseConfiguration.create());//创建HTableDescriptor实例HTableDescriptor tableDesc = new HTableDescriptor(tableName);//通过HTableDescriptor实例和散列值二维数组创建带有预分区的Hbase表hAdmin.createTable(tableDesc, splitKeys);
2.RowKey设计
一条数据的唯一标识就是rowkey,那么这条数据存储于哪个分区,取决于rowkey处于哪一个预分区的区间内,设计rowkey的主要目的,就是让数据均匀的分布于所有的region中,在一定程度上防止数据倾斜
3.内存优化
HBase操作过程中需要大量的内存开销,毕竟Table是可以缓存在内存中的,但是不建议分配非常大的堆内存,因为GC过程持续太久会导致RegionServer处于长期不可用状态,一般16G~36G内存就可以了,如果因为框架占用内存过高导致系统内存不足,框架一样会被系统服务拖死
4.基础优化
- zookeeper会话超时时间(hbase-site.xml)
# 属性:zookeeper.session.timeout# 解释:默认值为90000毫秒(90s)。当某个RegionServer挂掉,90s之后Master才能察觉到。可适当减小此值,以加快Master响应,可调整至60000毫秒。
- 设置RPC监听数量(hbase-site.xml)
# 属性:hbase.regionserver.handler.count# 解释:默认值为30,用于指定RPC监听的数量,可以根据客户端的请求数进行调整,读写请求较多时,增加此值
- 手动控制Major Compaction(hbase-site.xml)
# 属性:hbase.hregion.majorcompaction# 解释:默认值:604800000秒(7天), Major Compaction的周期,若关闭自动Major Compaction,可将其设为0
- 优化HStore文件大小(hbase-site.xml)
# 属性:hbase.hregion.max.filesize# 解释:默认值10737418240(10GB),如果需要运行HBase的MR任务,可以减小此值,因为一个region对应一个map任务,如果单个region过大,会导致map任务执行时间过长。该值的意思就是,如果HFile的大小达到这个数值,则这个region会被切分为两个Hfile。
- 优化Hbase客户端缓存(hbase-site.xml)
# 属性:hbase.client.write.buffer# 解释:默认值2097152bytes(2M)用于指定HBase客户端缓存,增大该值可以减少RPC调用次数,但是会消耗更多内存,反之则反之。一般我们需要设定一定的缓存大小,以达到减少RPC次数的目的。
- 指定scan.next扫描Hbase所获取的行数(hbase-site.xml)
# 属性:hbase.client.scanner.caching# 解释:用于指定scan.next方法获取的默认行数,值越大,消耗内存越大。
- BlockCache占用RegionServer堆内存的比例(hbase-site.xml)
# 属性:hfile.block.cache.size# 解释:默认0.4,读请求比较多的情况下,可适当调大
- MemStore占用RegionServer堆内存的比例
# 属性:hbase.regionserver.global.memstore.size# 解释:默认0.4,写请求较多的情况下,可适当调大

若有收获,就点个赞吧
0 人点赞


