第一章.InputFormat数据输入
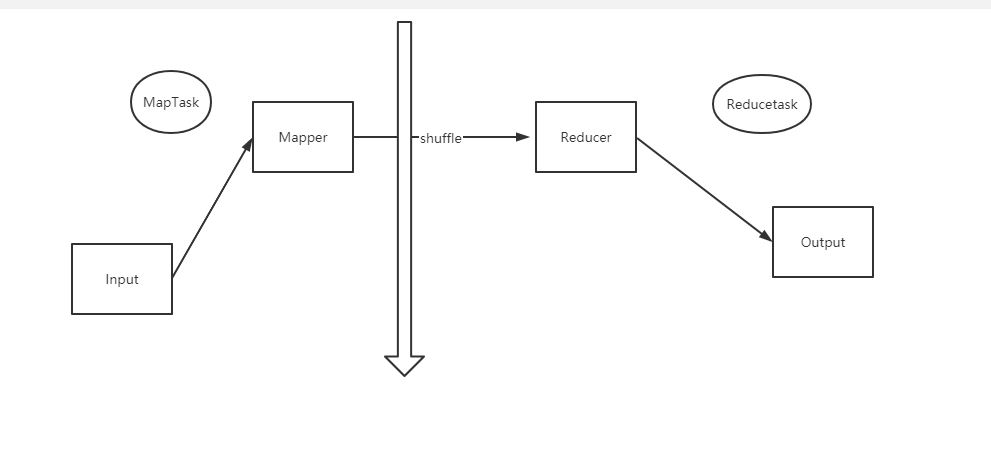
1.切片与MapTask并行度决定机制
# MapTesk并行度决定机制- 数据块:Block是HDFS物理上把数据分成一块一块- 数据切片只是在逻辑上对输入进行切片,并不会在磁盘上将其切成片进行存储
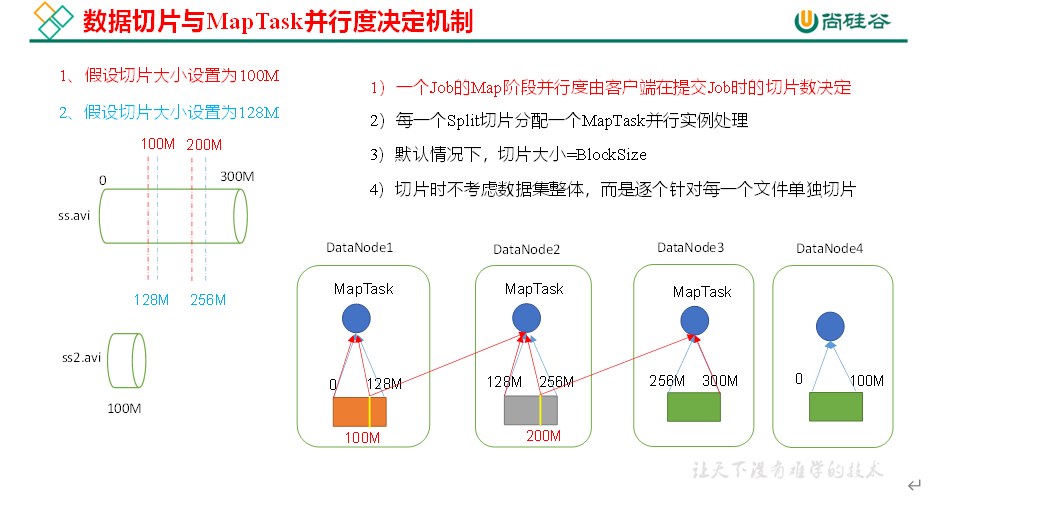
2.Job提交流程

# FileInputFormat切片源码解析1. 程序先找到你数据存储的目录2. 开始遍历处理(规划切片)目录下的每一个文件3. 遍历第一个文件ss.txta. 获取文件大小 fs.sizeOf(ss.txt)b. 计算切片大小c. 默认情况下,切片大小等于块的大小d. 开始切,每次切片时,要判断切完剩下的部分是否大于块的1.1倍,不大于1.1倍就划分一块切片e. 将切片信息写到一个切片规划文件中f. 整个切片的核心过程在getSpilt()方法中完成g. InputSpilt只记录了切片的元数据信息,比如起始位置,长度以及所在的节点列表等4. 提交切片规划文件到YARN上,Yarn上的MrAPPMaster就可以根据切片规划文件计算开启MapTask个数
3.FileInputFormat切片机制
# 切片机制1. 简单的按照文件的内容长度进行切片2. 切片大小默认等于块的大小3. 切片时不考虑数据集整体而是逐个针对每一个文件单独切片
4.CombineTextInputFormat切片机制
框架默认的TextInputFormat切片机制是对任务按文件规划切片,不管文件多小,都会是一个单独的切片,都会交给一个MapTask,这样如果有大量小文件,就会产生大量的MapTask,处理效率极其低下CombineTextInputFormat用于小文件过多的场景,它可以将多个小文件从逻辑上规划到一个切片中,这样多个小文件就可以交给一个MapTask处理
# 虚拟存储切片最大值设置CombineTextInputFormat.setMaxInputSplitSize(job,4194304);//4M
切片机制

5.CombineTextInputFormat案例实操
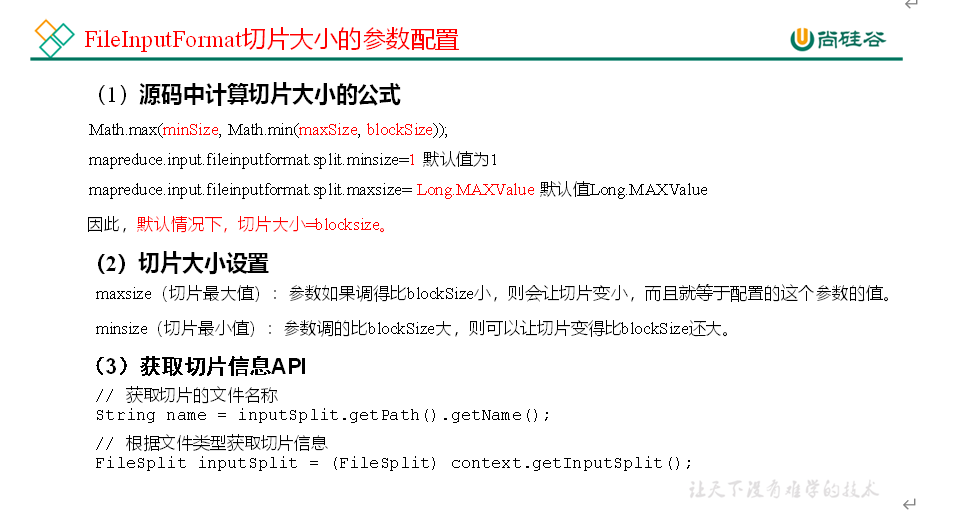
# 需求- 将输入的大量小文件合并成一个切片统一处理- 输入数据:准备四个小文件- 期望一个切片处理四个文件
实现过程:只需将驱动类中增加如下代码即可
//设置虚拟切片的最大值CombineTextInputFormat.setMaxInputSplitSize(job,4194304);//设置使用其他的InputFormatjob.setInputFormatClass(CombineTextInputFormat.class);
第二章.MapReducer工作流程
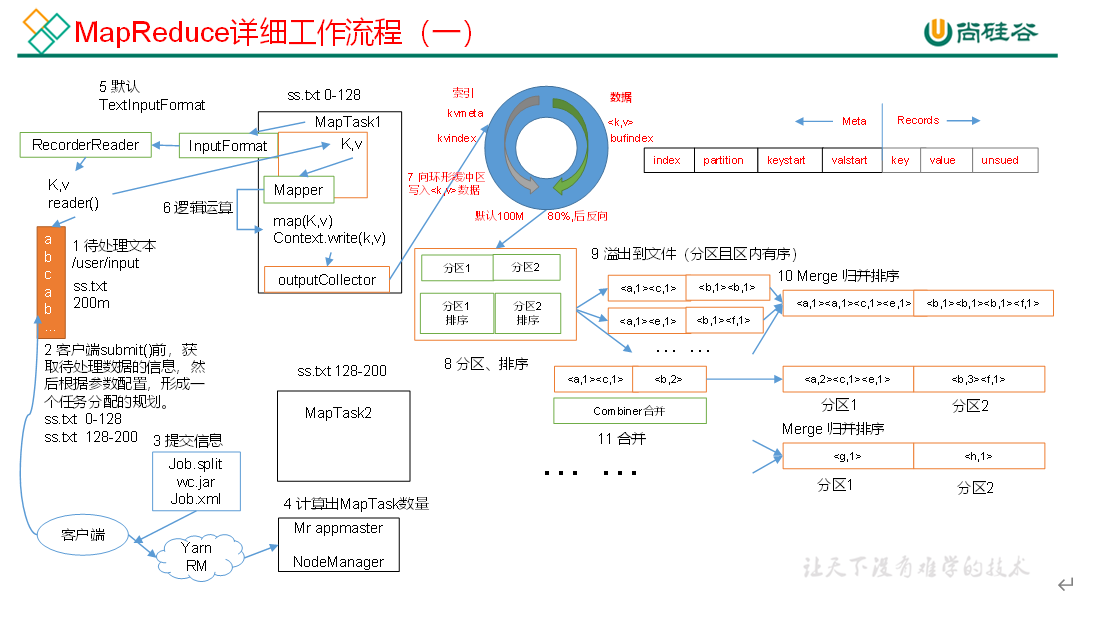
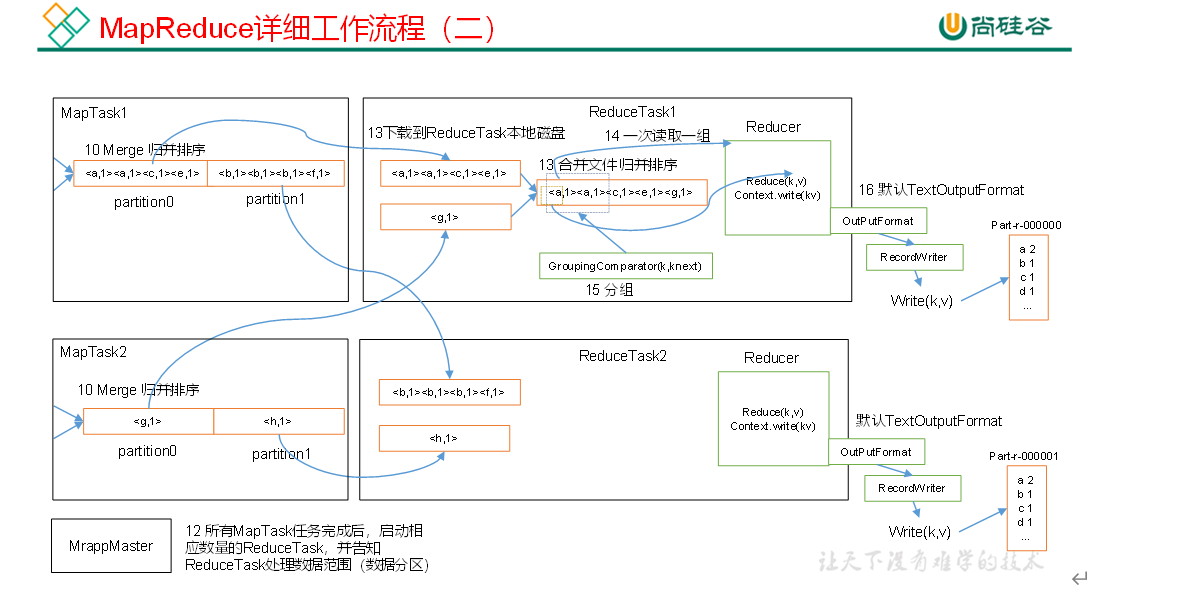
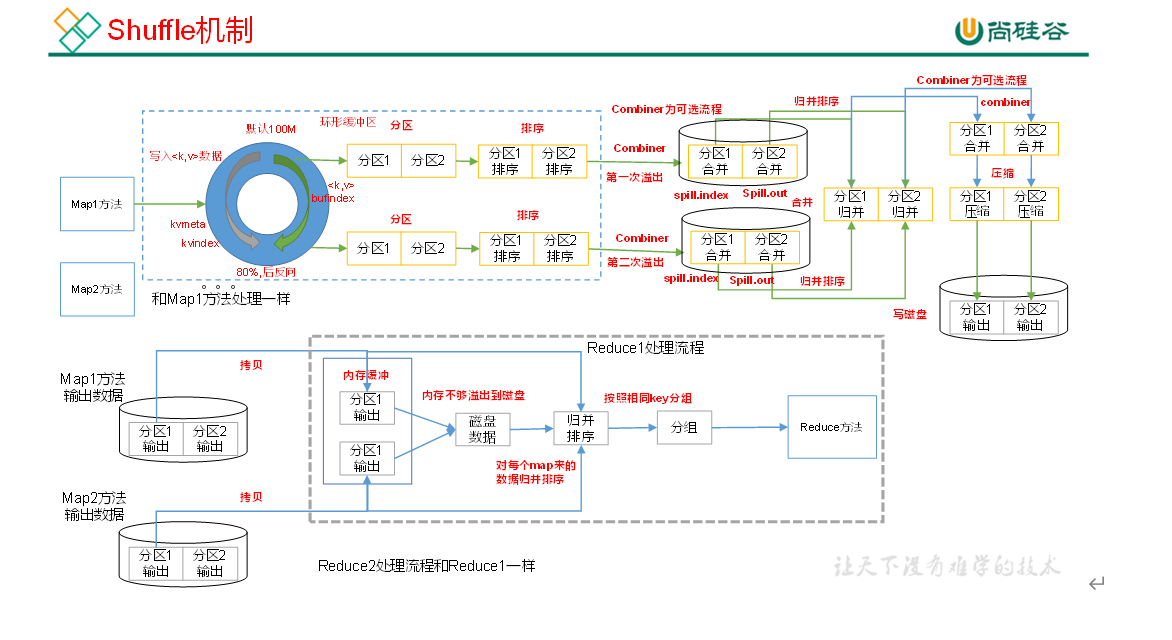
# 上面的流程是整个MapReduce最全工作流程,但是shuffle过程只是从第7步开始到第16步结束,具体Shuffle过程详解如下:- (1)MapTask收集我们的map()方法输出的kv对,放到内存缓冲区中- (2)从内存缓冲区不断溢出本地磁盘文件,可能会溢出多个文件- (3)多个溢出文件会被合并成大的溢出文件- (4)在溢出过程及合并的过程中,都要调用Partitioner进行分区和针对key进行排序- (5)ReduceTask根据自己的分区号,去各个MapTask机器上取相应的结果分区数据- (6)ReduceTask会取到同一个分区的来自不同MapTask的结果文件,ReduceTask会将这些文件再进行合并(归并排序)- (7)合并成大文件后,Shuffle的过程也就结束了,后面进入ReduceTask的逻辑运算过程(从文件中取出一个一个的键值对Group,调用用户自定义的reduce()方法)
# 注意1. shuffle中的缓冲区大小可以通过参数调整,参数: io.sort.mb默认100M2. shuffle缓冲区的大小会影响到MapReduce程序的执行效率,原则上说,缓冲区越大,磁盘io的次数越少,执行速度就越快
第三章.Shuffle 机制
Map方法之后,Reduce方法之前的数据处理过程称之为Shuffle
1.Shuffle机制
2.Partition分区
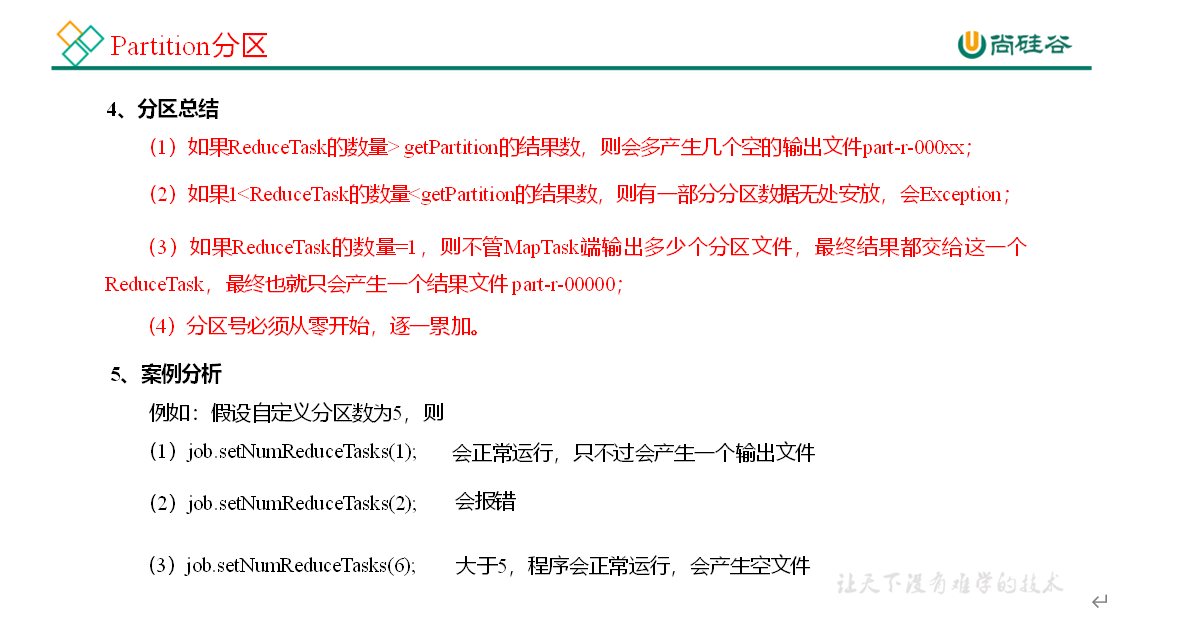
# 1.问题引出要求将统计结果按照输出条件输出到不同文件中(分区)# 2.默认Partitioner分区1.如果有多个ReduceTask时的默认分区:public class HashPartitioner<K, V> extends Partitioner<K, V> {/*作用 :返回分区号K : map输出的keyV : map输出的valuenumReduceTasks : ReduceTask的数量*/public int getPartition(K key, V value,int numReduceTasks) {/*分区号 = key.hashCode() % numReduceTaskskey.hashCode() & Integer.MAX_VALUE : 作用是用来保证结果为正数*/return (key.hashCode() & Integer.MAX_VALUE) % numReduceTasks;}2.如果只有1个ReduceTask时的默认分区:partitioner = new org.apache.hadoop.mapreduce.Partitioner<K,V>() {@Overridepublic int getPartition(K key, V value, int numPartitions) {return partitions - 1; //0}};
# 3.自定义Parttitioner步骤- 自定义类继承Parttitioner,重写getPartition方法- 在job驱动中,设置自定义parttitionerjob.setParttitionerClass(CustomPartitioner.class)- 自定义Partition后,要根据自定义Partitioner的逻辑设置相应数量的ReduceTaskjob.setNumReduceTasks(5)
3.Partition分区案例实操
需求:将统计结果按照手机归属地不同输出到不同文件中
需求分析

在之前案例的基础上,新增加一个分区类
package com.atguigu.mr.partition;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Partitioner;/*自定义分区类1.自定义类并继承PartitionerPartitioner<Key,Value>Key:mapper写出的key的类型value:mapper写出的value类型2.重写getpartition方法*/public class MyPartitioner extends Partitioner <Text,FlowBean>{/*返回分区号*/@Overridepublic int getPartition(Text text, FlowBean flowBean, int numPartitions) {String phoneNumber = text.toString();if(phoneNumber.startsWith("136")){return 0;}else if(phoneNumber.startsWith("137")){return 1;}else if(phoneNumber.startsWith("138")){return 2;}else if(phoneNumber.startsWith("139")){return 3;}else{return 4;}}}
package com.atguigu.mr.partition;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Job;import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;public class FlowDriver {public static void main(String[] args) throws Exception{//创建Job对象Job job = Job.getInstance(new Configuration());//设置ReduceTask的数量job.setNumReduceTasks(5);//设置自定义分区类job.setPartitionerClass(MyPartitioner.class);//给Job对象的属性赋值job.setJarByClass(FlowDriver.class);job.setMapperClass(FlowMapper.class);job.setReducerClass(FlowReducer.class);//2.3设置Mapper输出的k,v的类型job.setMapOutputKeyClass(Text.class);job.setMapOutputValueClass(FlowBean.class);//2.4设置最终输出的K,V的类型(在这是Reducer输出的K,V类型)job.setOutputKeyClass(Text.class);job.setOutputValueClass(FlowBean.class);//2.5设置数据的输入和输出路径FileInputFormat.setInputPaths(job,new Path("C:\\io\\input4"));//注意:输出路径不能存在!!!!!!!!!!!!FileOutputFormat.setOutputPath(job,new Path("C:\\io\\output4"));//3.提交Job对象(执行Job)/*参数 :是否打印进度返回值 :如果是true则表示job执行成功*/job.waitForCompletion(true);}}


若有收获,就点个赞吧
0 人点赞


