第一章.Shell概述
Shell是一个命令行解释器,它接收应用程序/用户命令,然后调用操作系统内核Shell还是一个功能相当强大的编程语言,易编写,易调试,灵活性强
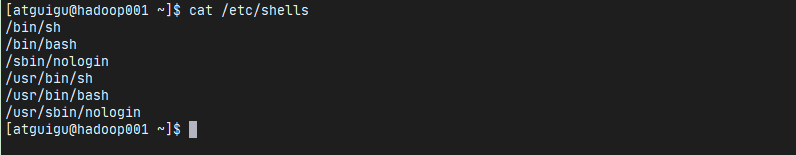
- Linux提供的Shell解析器有:
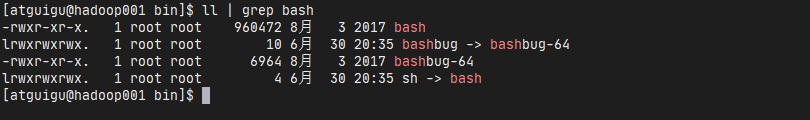
- bash和sh的关系
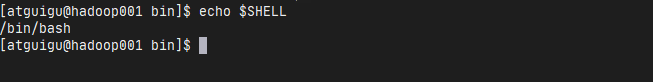
- Centos默认的解析器是bash
第二章.Shell脚本入门
- 脚本格式: 以#!/bin/bash开头(指定解析器)
- 第一个Shell脚本:helloworld
需求: 创建一个Shell脚本,输出helloworld
sudo touch helloworld.shsudo vim helloworld.sh

- 脚本的常用执行方式
#第一种:采用bash或sh+脚本的相对路径或绝对路径sh helloworld.sh #sh + 脚本的相对路径sh /opt/helloworld.sh #sh+脚本的绝对路径bash helloword.sh #bash+脚本的相对路径bash /opt/helloworld.sh #bash加脚本的绝对路径
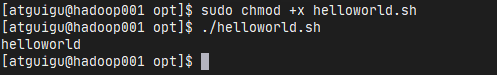
#第二种:采用输入脚本的绝对路径或相对路径执行脚本(必须具有可执行权限)1. 赋予helloworld.sh脚本的+x权限chmod +x helloworld.sh2. 执行脚本: 相对路径./helloworld.sh #不需要执行权限3. 执行脚本: 绝对路径/opt/helloworld.sh
注意:第一种方法,本质是bash解析器帮你执行脚本,所以脚本本身不需要执行权限
第二种执行方法,本质是脚本需要自己执行,所以需要执行权限
第三章.变量
1.系统预定义变量
# 常用系统变量- $HOME $PWD $SHELL $USER $PATH
案例实操:
- 查看系统变量的值
echo $HOME

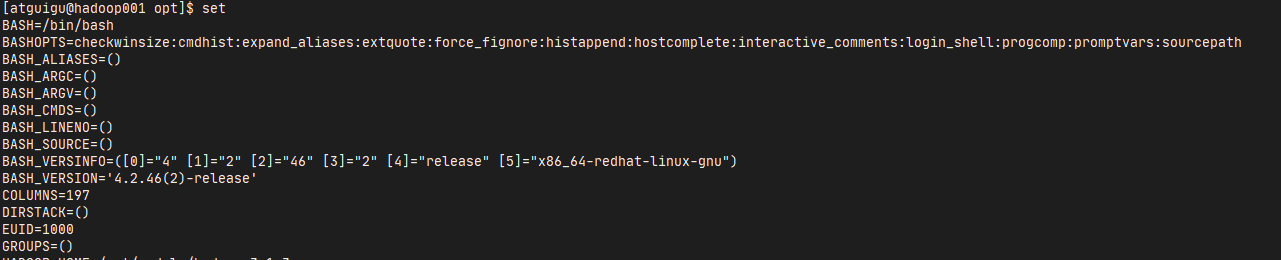
- 显示当前Shell中所有变量
set
2.自定义变量
# 基本语法1. 定义变量: 变量=值2. 撤销变量: unset 变量3. 声明静态变量: readonly 变量, 注意:不能unset# 变量定义规则1. 变量名称可以由字母数字和下划线组成,但是不能以数字开头,环境变量名建议大写2. 等号两侧不能有空格3. 在bash中,变量默认类型都是字符串类型,无法直接进行数值运算4. 变量的值如果有空格,需要使用双引号或单引号括起来
#案例实操1. 定义变量AA=5echo $A2. 给变量A重新赋值A=8echo $A3. 撤销变量Aunset Aecho $A4. 声明静态的变量B=2,不能unsetreadonly B=2echo $B5. 在bash中,变量默认类型都是字符串类型,无法直接进行数值计算C=1+2echo $C1+2 #输出结果6. 变量的值如果有空格,需要使用双引号或单引号括起来D=" I love dashuju "echo $D7. 可把变量提升为全局环境变量,可供其他shell程序使用export 变量名
3.特殊变量
- $n
$n (功能描述:n为数字,$0代表该脚本名称,$1-$9代表第一到第九个参数),十以上的参数需要用大括号包含如${10}
# 案例实操
[atguigu@hadoop101 datas]$ touch parameter.sh
[atguigu@hadoop101 datas]$ vim parameter.sh

#!/bin/bash
echo "$0  $1   $2"

[atguigu@hadoop101 datas]$ chmod 777 parameter.sh

[atguigu@hadoop101 datas]$ ./parameter.sh cls  xz
./parameter.sh  cls   xz
- $#
$#(功能描述:获取所有输入参数个数,常用于循环)
# 案例实操
[atguigu@hadoop101 datas]$ vim parameter.sh

#!/bin/bash
echo "$0  $1   $2"
echo $#

[atguigu@hadoop101 datas]$ chmod 777 parameter.sh

[atguigu@hadoop101 datas]$ ./parameter.sh cls  xz
parameter.sh cls xz
2
- $* $@
$*(功能描述:这个变量代表命令行中所有的参数,$*把所有的参数看成一个整体)
$@(功能描述:这个变量也代表命令行中所有的参数,不过$@把每个参数区分对待)
- $?
$?(功能描述: 最后一次执行命令的返回状态,如果这个变量的值为0,证明上一个命令正确执行,如果这个变量的值为非0(具体哪个数,由命令自己来决定),则证明上一个命令执行不正确了)
#案例实操   判断helloworld.sh脚本是否正确执行
[atguigu@hadoop101 datas]$ ./helloworld.sh
hello world
[atguigu@hadoop101 datas]$ echo $?
0
第四章.运算符
#基本语法
$((运算式)) 或 $[ 运算式 ]  注意:有空格!
#案例实操  计算(2+3)*4的值
[atguigu@hadoop101 datas]# S=$[(2+3)*4]
[atguigu@hadoop101 datas]# echo $S
第五章.条件判断
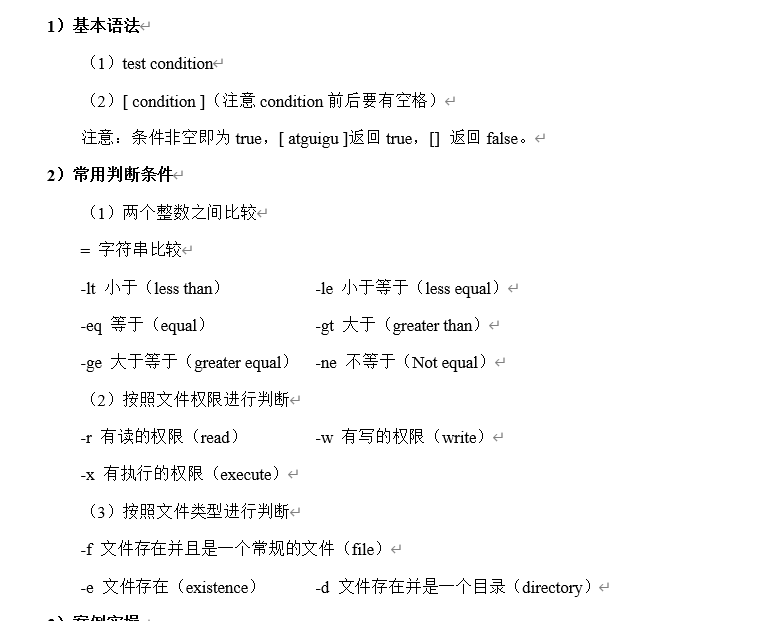
# 案例实操
#1.23是否大于等于23
[atguigu@hadoop101 datas]$ [ 23 -ge 22 ]
[atguigu@hadoop101 datas]$ echo $?
0
#2.helloworld.sh是否具有写权限
[atguigu@hadoop101 datas]$ [ -w helloworld.sh ]
[atguigu@hadoop101 datas]$ echo $?
0
#3./home/atguigu/cls.txt目录中的文件是否存在
[atguigu@hadoop101 datas]$ [ -e /home/atguigu/cls.txt ]
[atguigu@hadoop101 datas]$ echo $?
1
#4.多条件判断(&& 表示前一条命令执行成功时,才执行后一条命令,|| 表示上一条命令执行失败后,才执行下一条命令)
[atguigu@hadoop101 ~]$ [ condition ] && echo true || echo false
第六章.流程控制
1.if判断
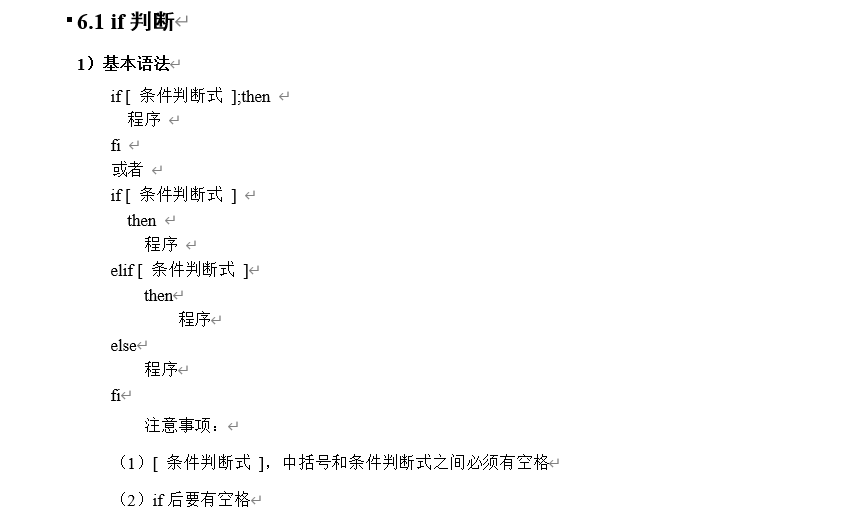
# 案例实操
输入一个数字,如果是1,则输出banzhang zhen shuai,如果是2,则输出cls zhen mei,如果是其它,什么也不输出。
[atguigu@hadoop101 datas]$ touch if.sh
[atguigu@hadoop101 datas]$ vim if.sh

#!/bin/bash

if [ $1 -eq "1" ]
then
        echo "banzhang zhen shuai"
elif [ $1 -eq "2" ]
then
        echo "cls zhen mei"
fi

[atguigu@hadoop101 datas]$ chmod 777 if.sh
[atguigu@hadoop101 datas]$ ./if.sh 1
banzhang zhen shuai
2.case语句

# 案例实操:输入一个数字,如果是1,则输出班长,如果是2,则输出cls,如果是其他,输出renyao
[atguigu@hadoop101 datas]$ touch case.sh
[atguigu@hadoop101 datas]$ vim case.sh

!/bin/bash

case $1 in
"1")
        echo "banzhang"
;;

"2")
        echo "cls"
;;
*)
        echo "renyao"
;;
esac

[atguigu@hadoop101 datas]$ chmod 777 case.sh
[atguigu@hadoop101 datas]$ ./case.sh 1
1
3.for循环
#基本语法1
for (( 初始值;循环控制条件;变量变化 ))
  do
    程序
  done
#案例:从1加到100
[atguigu@hadoop101 datas]$ touch for1.sh
[atguigu@hadoop101 datas]$ vim for1.sh

#!/bin/bash

s=0
for((i=0;i<=100;i++))
do
        s=$[$s+$i]
done
echo $s

[atguigu@hadoop101 datas]$ chmod 777 for1.sh
[atguigu@hadoop101 datas]$ ./for1.sh
“5050”
#基本语法2
for 变量 in 值1 值2 值3…
  do
    程序
  done
#案例:打印所有输入参数
[atguigu@hadoop101 datas]$ touch for2.sh
[atguigu@hadoop101 datas]$ vim for2.sh

#!/bin/bash
#打印数字

for i in $*
    do
      echo "ban zhang love $i "
    done

[atguigu@hadoop101 datas]$ chmod 777 for2.sh
[atguigu@hadoop101 datas]$ bash for2.sh cls xz bd
ban zhang love cls
ban zhang love xz
ban zhang love bd
4.while循环
#基本语法
while [ 条件判断式 ]
  do
    程序
  done
#案例:从1加到100
[atguigu@hadoop101 datas]$ touch while.sh
[atguigu@hadoop101 datas]$ vim while.sh

#!/bin/bash
s=0
i=1
while [ $i -le 100 ]
do
        s=$[$s+$i]
        i=$[$i+1]
done

echo $s

[atguigu@hadoop101 datas]$ chmod 777 while.sh
[atguigu@hadoop101 datas]$ ./while.sh
5050
第七章.read读取控制台输入
#基本语法
read(选项)(参数)
选项:
-p:指定读取值时的提示符;
-t:指定读取值时等待的时间(秒)。
参数
    变量:指定读取值的变量名
#案例:提示7秒内,读取控制台输入的名称
[atguigu@hadoop101 datas]$ touch read.sh
[atguigu@hadoop101 datas]$ vim read.sh

#!/bin/bash

read -t 7 -p "Enter your name in 7 seconds " NAME
echo $NAME

[atguigu@hadoop101 datas]$ ./read.sh
Enter your name in 7 seconds xiaoze
xiaoze
第八章.函数
# 系统函数
basename [string / pathname] [suffix]      (功能描述:basename命令会删掉所有的前缀包括最后一个(‘/’)字符,然后将字符串显示出来。
选项:
suffix为后缀,如果suffix被指定了,basename会将pathname或string中的suffix去掉。
---------------------------------------
#案例  截取该/home/atguigu/banzhang.txt路径的文件名称
[atguigu@hadoop101 datas]$ basename /home/atguigu/banzhang.txt
banzhang.txt
[atguigu@hadoop101 datas]$ basename /home/atguigu/banzhang.txt .txt
banzhang
-----------------------------------------
dirname 文件绝对路径        (功能描述:从给定的包含绝对路径的文件名中去除文件名(非目录的部分),然后返回剩下的路径(目录的部分))
--------------------------------------------------
#案例 获取banzhang.txt文件的路径
[atguigu@hadoop101 ~]$ dirname /home/atguigu/banzhang.txt
/home/atguigu
#自定义函数
#基本语法
[ function ] funname[()]
{
    Action;
    [return int;]
}
funname
-----------------------------------------
#经验技巧
(1)必须在调用函数地方之前,先声明函数,shell脚本是逐行运行。不会像其它语言一样先编译。
(2)函数返回值,只能通过$?系统变量获得,可以显示加:return返回,如果不加,将以最后一条命令运行结果,作为返回值。return后跟数值n(0-255)
#案例: 计算两个输入参数的和
[atguigu@hadoop101 datas]$ touch fun.sh
[atguigu@hadoop101 datas]$ vim fun.sh

#!/bin/bash
function sum()
{
    s=0
    s=$[ $1 + $2 ]
    echo "$s"
}

read -p "Please input the number1: " n1;
read -p "Please input the number2: " n2;
sum $n1 $n2;

[atguigu@hadoop101 datas]$ chmod 777 fun.sh
[atguigu@hadoop101 datas]$ ./fun.sh
Please input the number1: 2
Please input the number2: 5
7
第九章.Shell 工具
1.cut

#案例
(1)数据准备
[atguigu@hadoop101 datas]$ touch cut.txt
[atguigu@hadoop101 datas]$ vim cut.txt
dong shen
guan zhen
wo  wo
lai  lai
le  le
-----------------------------------------------
(2)切割cut.txt第一列
[atguigu@hadoop101 datas]$ cut -d " " -f 1 cut.txt
dong
guan
wo
lai
le
-------------------------------------------------------
(3)切割cut.txt第二、三列
[atguigu@hadoop101 datas]$ cut -d " " -f 2,3 cut.txt
shen
zhen
wo
lai
le
------------------------------------------------------
(4)在cut.txt文件中切割出guan
[atguigu@hadoop101 datas]$ cat cut.txt | grep "guan" | cut -d " " -f 1
guan
--------------------------------------------------------------
(5)选取系统PATH变量值,第2个“:”开始后的所有路径:
[atguigu@hadoop101 datas]$ echo $PATH
/usr/lib64/qt-3.3/bin:/usr/local/bin:/bin:/usr/bin:/usr/local/sbin:/usr/sbin:/sbin:/home/atguigu/bin

[atguigu@hadoop102 datas]$ echo $PATH | cut -d: -f 3-
/usr/local/bin:/bin:/usr/bin:/usr/local/sbin:/usr/sbin:/sbin:/home/atguigu/bin
------------------------------------------------------------
(6)切割ifconfig 后打印的IP地址
[atguigu@hadoop101 datas]$ ifconfig ens33 | grep netmask | cut -d "n" -f 2 | cut -d " " -f 2
192.168.1.102
2.awk
一个强大的文本分析工具,把文件逐行的读入,以空格作为默认分割符将每行切片,切开的部分在进行分析处理
#基本用法
awk [选项参数] ‘pattern1{action1}  pattern2{action2}...’ filename
pattern:表示AWK在数据中查找的内容,就是匹配模式
action:在找到匹配内容时所执行的一系列命令
| 选项参数 | 功能 |
|---|---|
| -F | 指定输入文件折分割符 |
| -V | 赋值一个用户定义变量 |
(1)数据准备
[atguigu@hadoop102 datas]$ sudo cp /etc/passwd ./
---------------------------------------------------------
(2)搜索passwd文件以root关键字开头的所有行,并输出该行的第7列。
[atguigu@hadoop102 datas]$ awk -F: '/^root/{print $7}' passwd
/bin/bash
----------------------------------------------------------------------
(3)搜索passwd文件以root关键字开头的所有行,并输出该行的第1列和第7列,中间以“,”号分割。
[atguigu@hadoop102 datas]$ awk -F: '/^root/{print $1","$7}' passwd
root,/bin/bash
注意:只有匹配了pattern的行才会执行action
----------------------------------------------------------------------
(4)只显示/etc/passwd的第一列和第七列,以逗号分割,且在所有行前面添加列名user,shell在最后一行添加"dahaige,/bin/zuishuai"。
[atguigu@hadoop102 datas]$ awk -F : 'BEGIN{print "user, shell"} {print $1","$7} END{print "dahaige,/bin/zuishuai"}' passwd
user, shell
root,/bin/bash
bin,/sbin/nologin
。。。
atguigu,/bin/bash
dahaige,/bin/zuishuai
注意:BEGIN 在所有数据读取行之前执行;END 在所有数据执行之后执行。
----------------------------------------------------------------------
(5)将passwd文件中的用户id增加数值1并输出
[atguigu@hadoop102 datas]$ awk -v i=1 -F: '{print $3+i} ' passwd
1
2
3
4
| 变量(内置) | 说明 |
|---|---|
| FILENAME | 文件名 |
| NR | 已读的记录数 |
| NF | 浏览记录的域的个数 |
(1)统计passwd文件名,每行的行号,每行的列数
[atguigu@hadoop102 datas]$ awk -F: '{print "filename:"  FILENAME ", linenumber:" NR  ",columns:" NF}' passwd
filename:passwd, linenumber:1,columns:7
filename:passwd, linenumber:2,columns:7
filename:passwd, linenumber:3,columns:7
------------------------------------------------------------------------------------
(2)切割IP
[atguigu@hadoop102 datas]$ ifconfig ens33 | grep netmask | awk -F " " '{print $2}'
192.168.1.102
--------------------------------------------------------------------------------------
(3)查询sed.txt中空行所在的行号
[atguigu@hadoop102 datas]$ awk '/^$/{print NR}' sed.txt
5
第十章.正则表达式
正则表达式使用单个字符串来描述、匹配一系列符合某个语法规则的字符串。在很多文本编辑器里,正则表达式通常被用来检索、替换那些符合某个模式的文本。在Linux中,grep,sed,awk等命令都支持通过正则表达式进行模式匹配。
#常规匹配
一串不包含特殊字符的正则表达式匹配它自己,例如:
[atguigu@hadoop102 datas]$ cat /etc/passwd | grep atguigu
就会匹配所有包含atguigu的行
#常用特殊字符
1)特殊字符:^
^ 匹配一行的开头,例如:
[atguigu@hadoop102 datas]$ cat /etc/passwd | grep ^a
会匹配出所有以a开头的行
------------------------------------------------------------------
2)特殊字符:$
$ 匹配一行的结束,例如
[atguigu@hadoop102 datas]$ cat /etc/passwd | grep t$
会匹配出所有以t结尾的行
思考:^$ 匹配什么?空格
-------------------------------------------------------
3)特殊字符:.
. 匹配一个任意的字符,例如
[atguigu@hadoop102 datas]$ cat /etc/passwd | grep r..t
会匹配包含rabt,rbbt,rxdt,root等的所有行
-------------------------------------------------------
4)特殊字符:*
* 不单独使用,他和上一个字符连用,表示匹配上一个字符0次或多次,例如
[atguigu@hadoop102 datas]$ cat /etc/passwd | grep ro*t
会匹配rt, rot, root, rooot, roooot等所有行
思考:.* 匹配什么?表示匹配n个任意字符
---------------------------------------------
5)特殊字符:[ ]
[ ] 表示匹配某个范围内的一个字符,例如
[6,8]------匹配6或者8
[a-z]------匹配一个a-z之间的字符
[a-z]*-----匹配任意字母字符串
[a-c, e-f]-匹配a-c或者e-f之间的任意字符
[atguigu@hadoop102 datas]$ cat /etc/passwd | grep r[a,b,c]*t
会匹配rat, rbt, rabt, rbact等等所有行
----------------------------------------------------
6)特殊字符:\
\ 表示转义,并不会单独使用。由于所有特殊字符都有其特定匹配模式,当我们想匹配某一特殊字符本身时(例如,我想找出所有包含 '$' 的行),就会碰到困难。此时我们就要将转义字符和特殊字符连用,来表示特殊字符本身,例如
[atguigu@hadoop102 datas]$ cat /etc/passwd | grep a\$b
就会匹配所有包含 a$b 的行

若有收获,就点个赞吧
0 人点赞


