第一章.Hadoop数据压缩
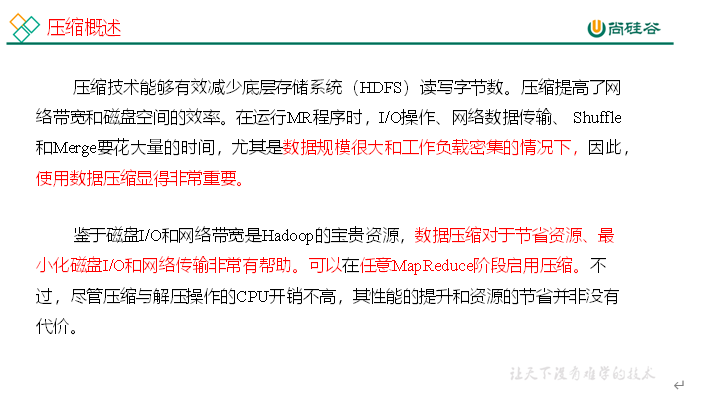
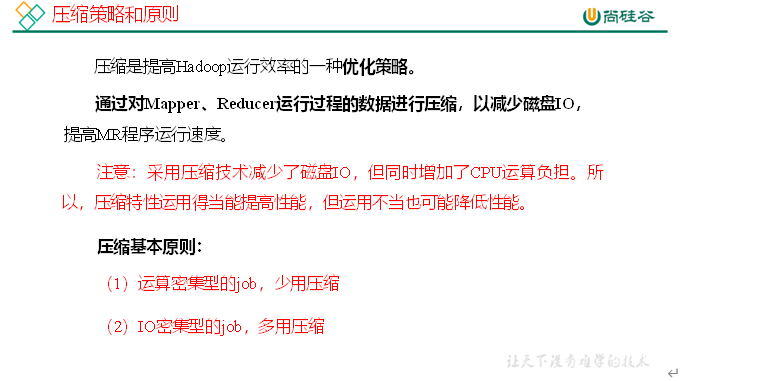
1.概述
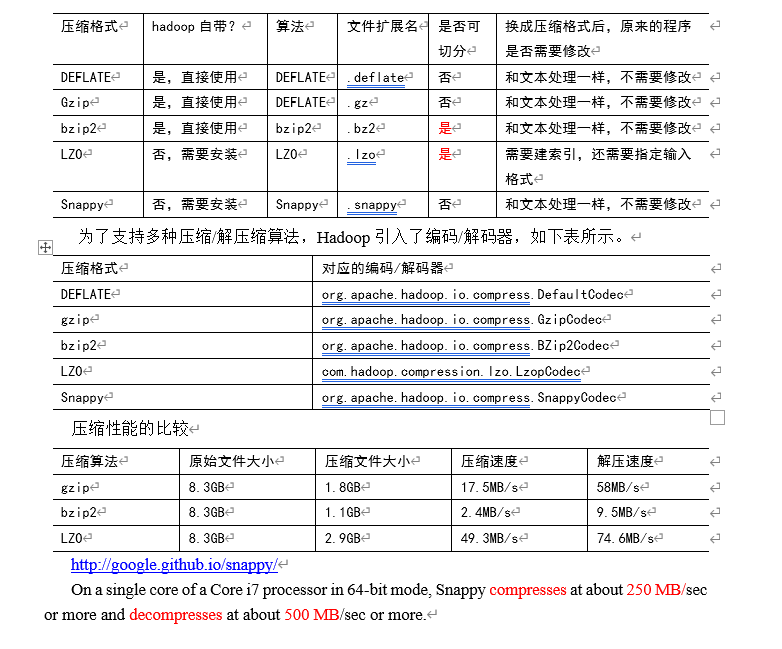
2.MR支持的压缩编码
3.压缩方式选择
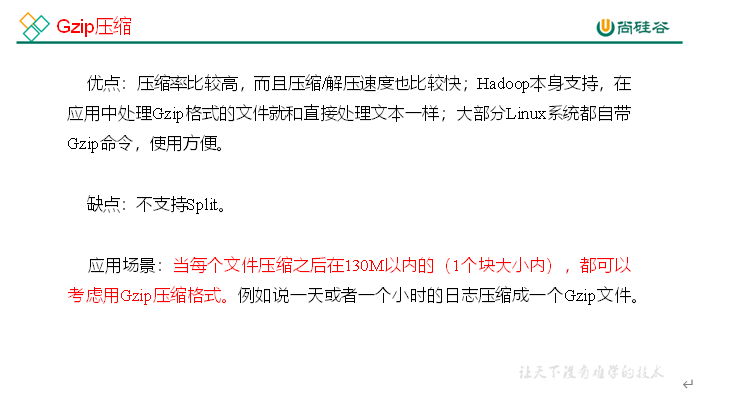
1.Gzip压缩
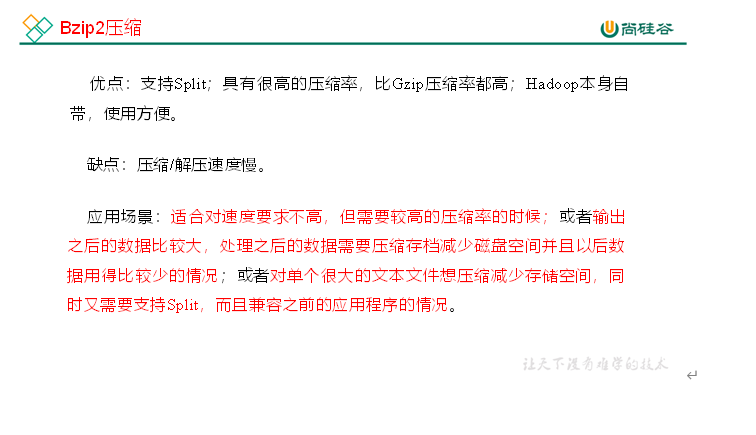
2.Bzip2压缩
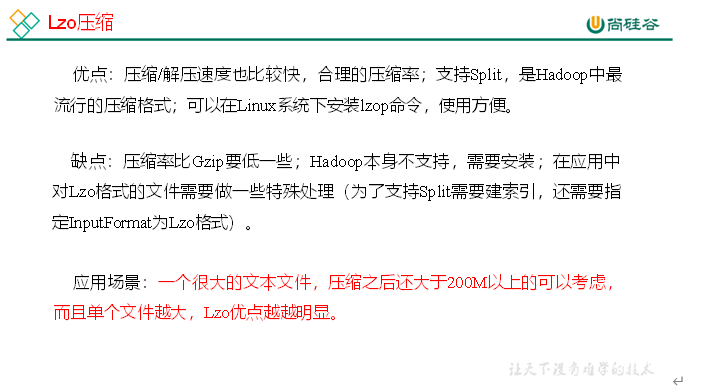
3.Lzo压缩
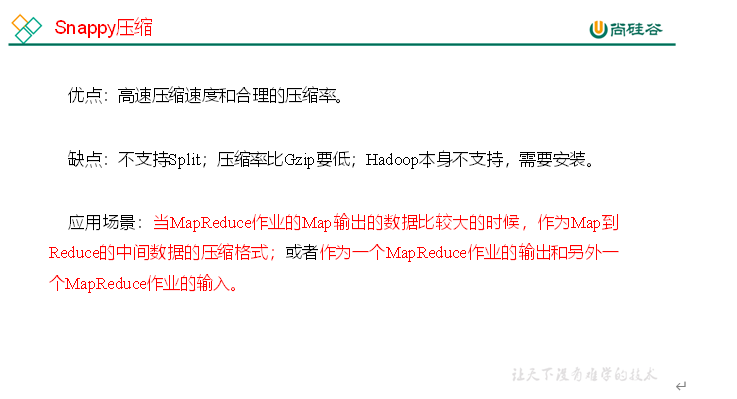
4.Snappy压缩
4.压缩位置选择
压缩可以在mapReduce作用的任意阶段启用

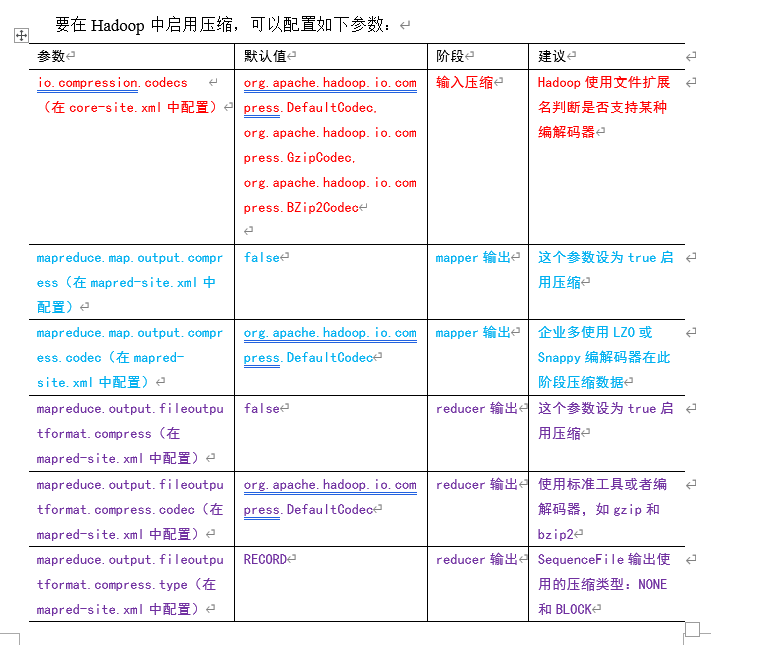
5.压缩参数配置
第二章.Hadoop企业优化
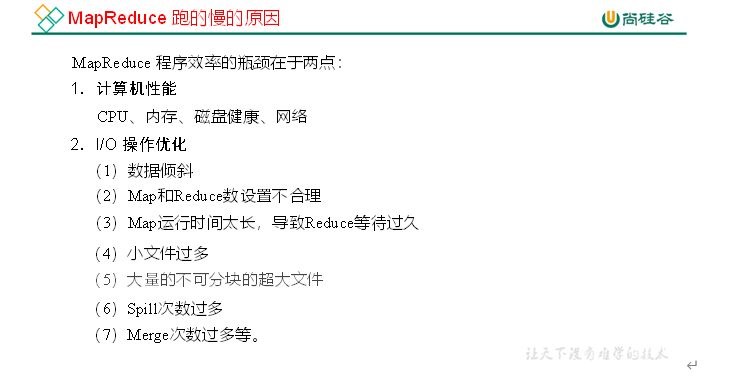
1.MapReduce跑的慢的原因
2.MapReduce优化方法
MapReduce优化方法主要从六个方面考虑:数据输入、Map阶段、Reduce阶段、IO传输、数据倾斜问题和常用的调优参数。
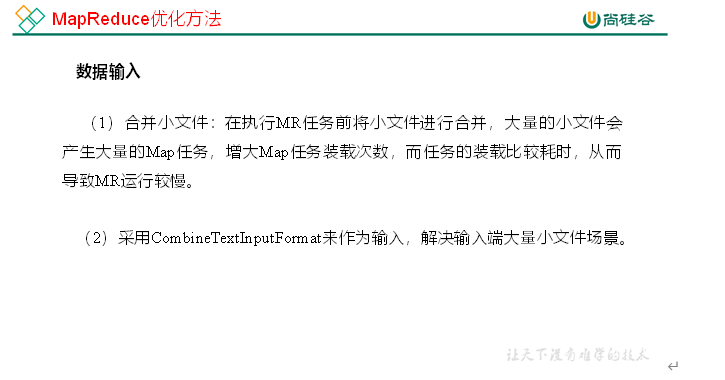
1.数据输入
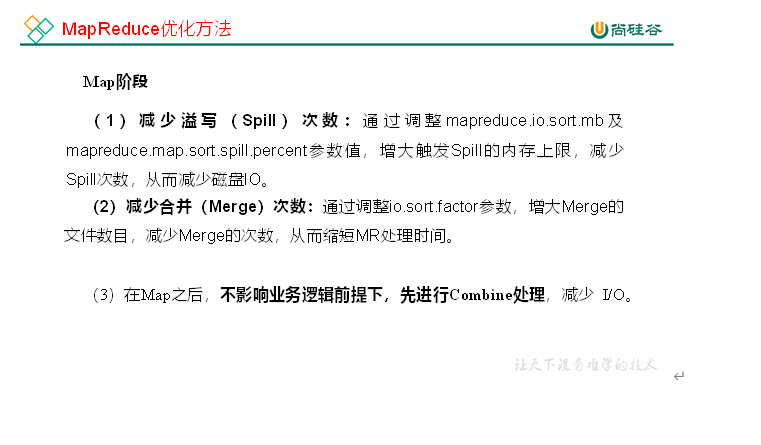
2.Map阶段
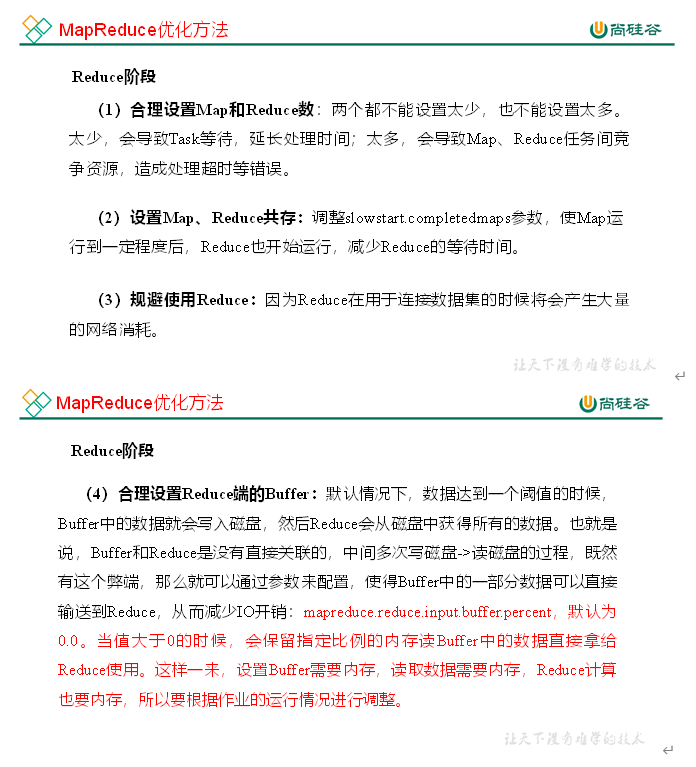
3.Reduce阶段
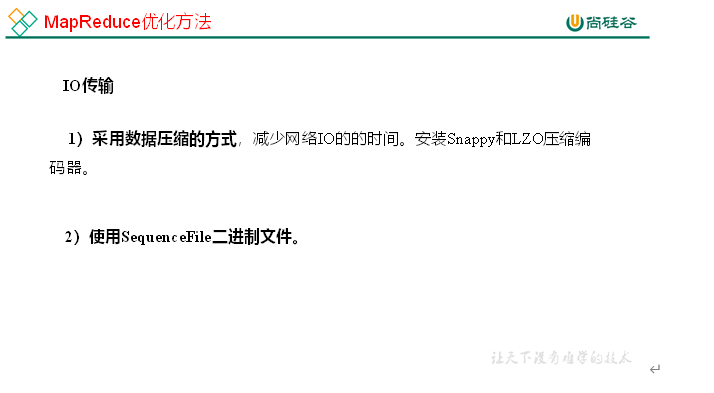
4.IO传输
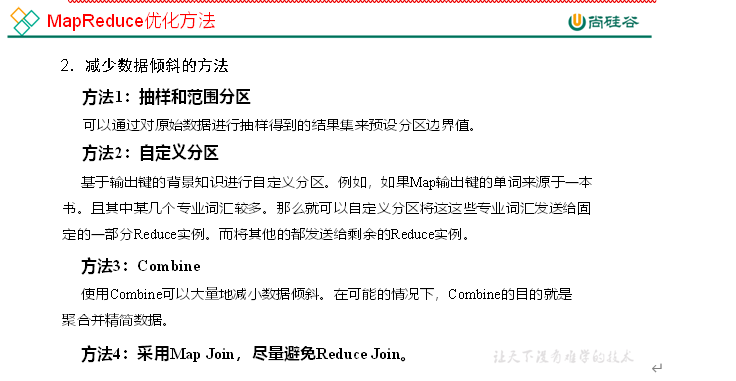
5.数据倾斜问题

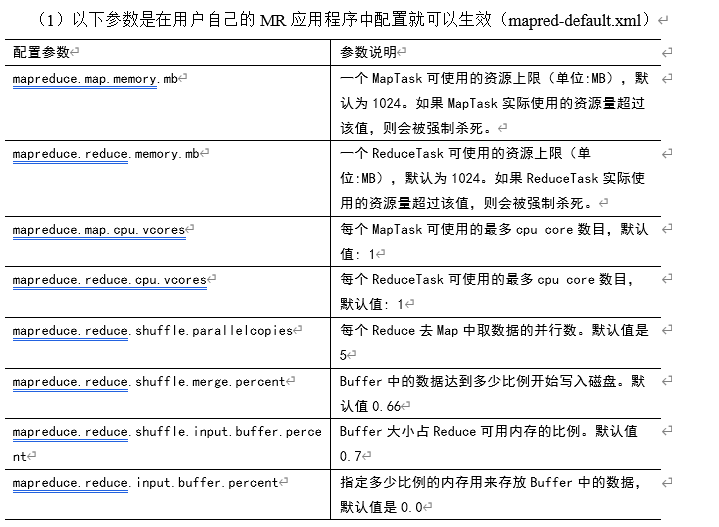
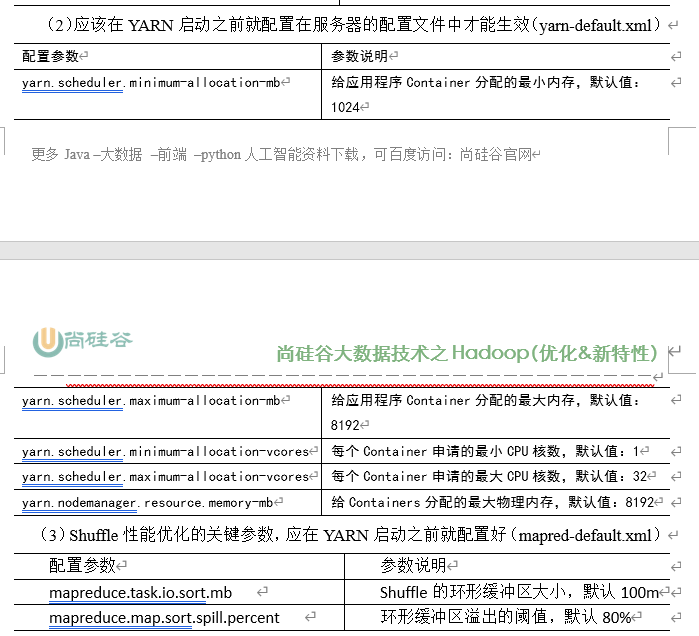
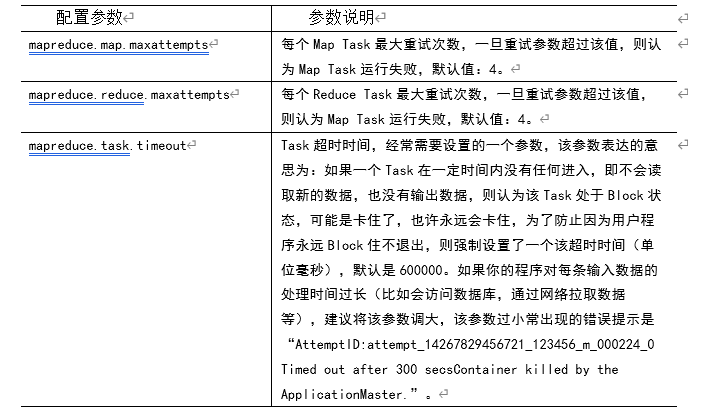
6.常用的调优参数
资源相关参数
容错相关参数
3.HDFS小文件优化方法
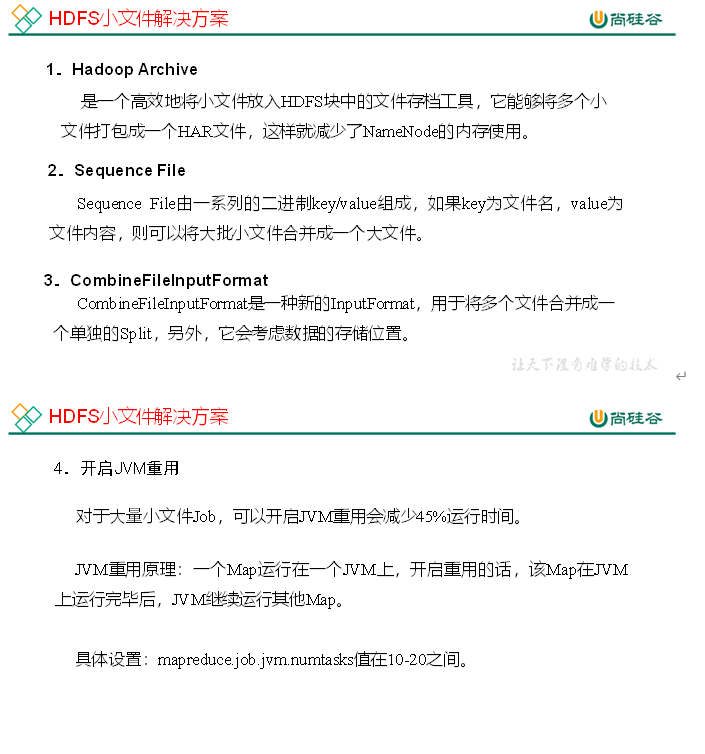
# HDFS小文件弊端HDFS上每个文件都要在NameNode上建立一个索引,这个索引的大小约为150byte,这样当小文件比较多的时候,就会产生很多的索引文件,一方面会大量占用NameNode的内存空间,另一方面就是索引文件过大使得索引速度变慢。# HDFS小文件解决方案小文件的优化无非以下几种方式:(1)在数据采集的时候,就将小文件或小批数据合成大文件再上传HDFS。(2)在业务处理之前,在HDFS上使用MapReduce程序对小文件进行合并。(3)在MapReduce处理时,可采用CombineTextInputFormat提高效率。
第三章.Hadoop新特性
1.集群间数据拷贝
1. scp 实现两个远程主机之间的文件复制scp -r hello.txt root@hadoop103:/user/atguigu/hello.txt // 推 pushscp -r root@hadoop103:/user/atguigu/hello.txt hello.txt // 拉 pullscp -r root@hadoop103:/user/atguigu/hello.txt root@hadoop104:/user/atguigu //是通过本地主机中转实现两个远程主机的文件复制;如果在两个远程主机之间ssh没有配置的情况下可以使用该方式。2. 采用distcp命令实现两个Hadoop集群之间的递归数据复制hadoop distcp hdfs://hadoop102:8020/user/atguigu/hello.txt hdfs://hadoop105:8020/user/atguigu/hello.txt
2.小文件存档
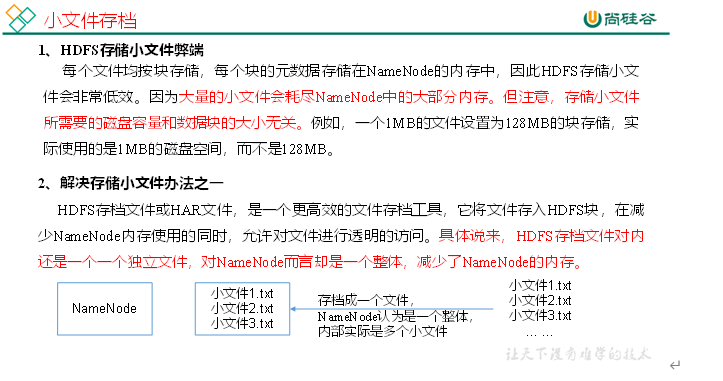
1. 需要启动YARN进程start-yarn.sh2. 归档文件bin/hadoop archive -archiveName input.har -p /user/atguigu/input /user/atguigu/output3. 查看归档hadoop fs -ls -r /user/atguigu/output/input.har[atguigu@hadoop102 hadoop-2.7.2]$ hadoop fs -ls -r har:///user/atguigu/output/input.har4. 解归档文件hadoop fs -cp har:/// user/atguigu/output/input.har/* /user/atguigu
3.回收站
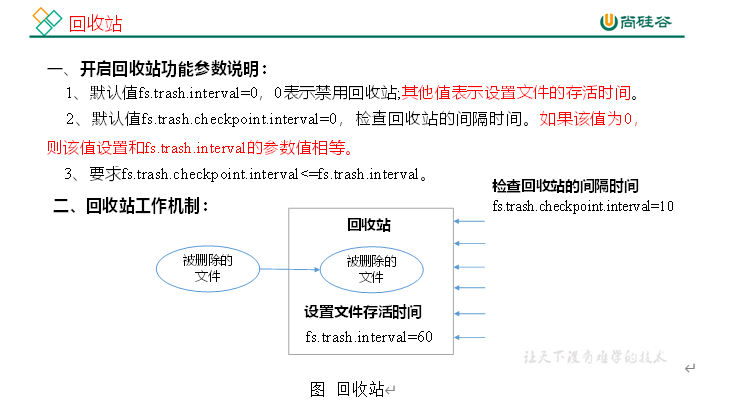
开启回收站功能,可以将删除的文件在不超时的情况下,恢复原数据,起到防止误删除,备份等作用
- 启用回收站
修改core-site.xml,配置垃圾回收时间为1分钟
<property><name>fs.trash.interval</name><value>1</value></property>
- 查看回收站
回收站在集群中的路径: /user/atguigu/_Trash/
- 修改访问垃圾回收站用户名称
进入垃圾回收站用户名称,默认是dr.who,修改为atguigu用户(core-site.xml)
<property>
  <name>hadoop.http.staticuser.user</name>
  <value>atguigu</value>
</property>
- 通过程序删除的文件不会经过回收站,需要调用moveToTrash()才进去回收站
Trash trash = New Trash(conf);
trash.moveToTrash(path);
- 恢复回收站数据
hadoop fs -mv
/user/atguigu/.Trash/Current/user/atguigu/input    /user/atguigu/input
- 清空回收站
hadoop fs -expunge
4.新特性
# 多NN的HA架构
- HDFS NameNode高可用性的初始实现为单个活动NameNode和单个备用NameNode,将edits复制到三个JournalNode。该体系结构能够容忍系统中一个NN或一个JN的故障。但是,某些部署需要更高程度的容错能力。Hadoop3.x允许用户运行多个备用NameNode。例如,通过配置三个NameNode和五个JournalNode,群集能够容忍两个节点而不是一个节点的故障。

# 纠删码

- HDFS中的默认3副本方案在存储空间和其他资源(例如,网络带宽)中具有200%的开销。但是,对于I / O活动相对较低暖和冷数据集,在正常操作期间很少访问其他块副本,但仍会消耗与第一个副本相同的资源量。纠删码(Erasure Coding)能够在不到50% 的数据冗余情况下提供和3副本相同的容错能力,因此,使用纠删码作为副本机制的改进是自然而然的。
第四章.HadoopHA高可用
1.HA概述
2.HA工作机制
通过双NameNode消除单点故障
3.集群配置
1.把原先的集群停掉

2.各节点做一个快照

3.将原Hadoop复制一份拷贝到/opt/ha
    ①创建/opt/ha目录 并修改所属主和所属组
    ②将hadoop拷贝过来后,需要将hadoop中的data,logs删除
    ③将/tmp/*内容也删除掉
    ④分发
4.修改HADOOP_HOME(一定一定要source)

5.在core-site.xml中配置
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://mycluster</value>
    </property>
    <!-- 自定义标签 -->
    <property>
        <name>hadoop.data.dir</name>
        <value>/opt/ha/hadoop-3.1.3/data</value>
    </property>

6.在hdfs-site.xml中配置
      <property>
        <name>dfs.namenode.name.dir</name>
        <value>file://${hadoop.data.dir}/name</value>
      </property>
      <property>
        <name>dfs.datanode.data.dir</name>
        <value>file://${hadoop.data.dir}/data</value>
      </property>
      <property>
        <name>dfs.nameservices</name>
        <value>mycluster</value>
      </property>
      <property>
        <name>dfs.ha.namenodes.mycluster</name>
        <value>nn1,nn2,nn3</value>
      </property>
      <property>
        <name>dfs.namenode.rpc-address.mycluster.nn1</name>
        <value>hadoop102:9820</value>
      </property>
      <property>
        <name>dfs.namenode.rpc-address.mycluster.nn2</name>
        <value>hadoop103:9820</value>
      </property>
      <property>
        <name>dfs.namenode.rpc-address.mycluster.nn3</name>
        <value>hadoop104:9820</value>
      </property>
      <property>
        <name>dfs.namenode.http-address.mycluster.nn1</name>
        <value>hadoop102:9870</value>
      </property>
      <property>
        <name>dfs.namenode.http-address.mycluster.nn2</name>
        <value>hadoop103:9870</value>
      </property>
      <property>
        <name>dfs.namenode.http-address.mycluster.nn3</name>
        <value>hadoop104:9870</value>
      </property>
      <property>
        <name>dfs.namenode.shared.edits.dir</name>
        <value>qjournal://hadoop102:8485;hadoop103:8485;hadoop104:8485/mycluster</value>
      </property>
    <!--  访问代理类,client用于确定哪个NN为Active -->
      <property>
        <name>dfs.client.failover.proxy.provider.mycluster</name>
        <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
      </property>
      <!-- 配制隔离机制,即同一时刻只能有一台服务器对外响应 -->
      <property>
        <name>dfs.ha.fencing.methods</name>
        <value>sshfence</value>
      </property>
      <!-- 使用隔离机制时需要ssh无密登录 -->
      <property>
        <name>dfs.ha.fencing.ssh.private-key-files</name>
        <value>/home/atguigu/.ssh/id_rsa</value>
      </property>
    <!--  指定NN的元数据在JournalNode的哪个位置存放 -->
      <property>
        <name>dfs.journalnode.edits.dir</name>
        <value>${hadoop.data.dir}/jn</value>
      </property>


1.在每台机器上输入以下命令启动journalnode服务
     注意:先将/tmp/下的内容清空
     hdfs --daemon start journalnode

2.在hadoop102上,对其进行格式化,并启动
    hdfs namenode -format
    hdfs --daemon start namenode

3. 在hadoop103和hadoop104上,同步nn1的元数据信息
    hdfs namenode -bootstrapStandby

4. 在hadoop103和hadoop104启动NameNode
    hdfs --daemon start namenode

5. 在hadoop102,hadoop103,hadoop104节点上上,启动datanode
    hdfs --daemon start datanode

6. 在任意一台节点上将nn1切换为Active
    hdfs haadmin -transitionToActive nn1

7. 在任意一台节点上查看是否Active
    hdfs haadmin -getServiceState nn1

以上是手动故障转移

------------------------------------------------------------------------------
自动故障转移的配置
    1.在hdfs-site.xml中增加
        <property>
            <name>dfs.ha.automatic-failover.enabled</name>
            <value>true</value>
        </property>
    2.在core-site.xml文件中增加
        <property>
            <name>ha.zookeeper.quorum</name>
            <value>hadoop102:2181,hadoop103:2181,hadoop104:2181</value>
        </property>


1.在任意一台节点上关闭所有HDFS服务:
    stop-dfs.sh
2.在任意一台节点上启动Zookeeper集群:
    zkCluster.sh start
3.在任意一台节点上初始化HA在Zookeeper中状态:
    hdfs zkfc -formatZK
4.在任意一台节点上启动HDFS服务:
    start-dfs.sh
5.在任意一台节点上验证
     将Active NameNode进程kill
      hdfs --daemon stop namenode
1.在NN的HA配置好的前提下
2.Yarn-site.xml (详见Yarn-site.xml--给你们发的)
3.分发
4.启动hdfs
    ①启动zookeeper集群 :zkCluster.sh start
    ②启动HDFS : start-dfs.sh
5.启动Yarn(任意一台即可-因为每台都有ResourceManager)
    start-yarn.sh
6.查看服务状态
    yarn rmadmin -getServiceState rm1

若有收获,就点个赞吧
0 人点赞


