第一章.Flume概述
1.定义
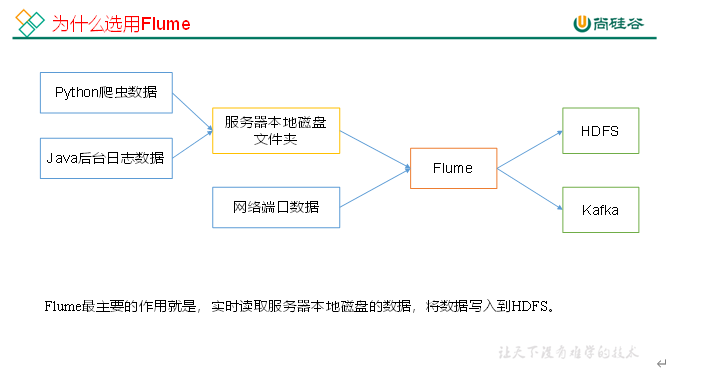
Flume是Cloudera提供的一个高可用的,高可靠的,分布式的海量日志采集,聚合和传输的系统,Flume基于流式架构,灵活简单
2.组成架构
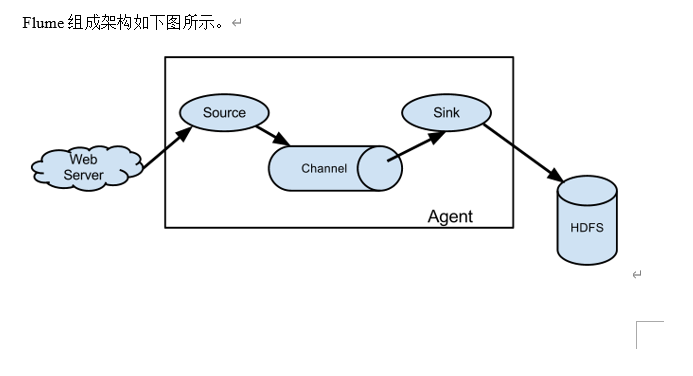
# Agent- Agent是一个JVM进程.它以事件的形式将数据从源头送至目的- Agent主要有我个部分组成: Source, Channel,Sink# Source- Source是负责接收数据到Flume Agent 的组件,Source组件可以处理各种类型,各种格式的日志数据,包括avro,thrift,exec,jms,spooling directory,netcat,taildir,sequence generator,syslog,http,legacy# Sink- Sink不断的轮询Channel中的事件且批量的移除它们,并将这些事件批量写入到存储或索引系统,或者被发送到另一个Flume Agent- Sink组件目的地包括HDFS,logger,avro,thrift,ipc,file,Hbase,solr,自定义# Channel- Channel是位于source与sink之间的缓冲区,因此,Channel允许Source和Sink运作在不同的频率上,Channel是线程安全的,可以同时处理几个source的写入操作和几个Sink的读取操作- Flume自带两种Channel: Memory Channel 和File Channel- Memory Channel是内存中的队列,Memory Channel在不需要关心数据丢失的情景下适用,如果需要关心数据丢失,那么Memory Channel就不应该使用,因为程序死亡,机器宕机或者重启就会导致数据丢失- File Channel将所有事件写到磁盘,因此在程序宕机或关闭的情况下不会丢失数据# Event- 传输单元,Flume数据传输的基本单元,以Event的形式经数据从源头送至目的地,Event由Header和Body两部分组成,Header用来存放该Event的一些属性,为K-V结构,Body用来存放该条数据,形式为字节数组
| Header | Body |
|---|---|
| K-V | byte array |
第二章.Flume入门
1. Flume安装
- Flume官网地址:http://flume.apache.org/
- 文档查看地址:http://flume.apache.org/FlumeUserGuide.html
- 下载地址:http://archive.apache.org/dist/flume/
安装部署
- 将apache-flume-1.9.0-bin.tar.gz上传到linux的/opt/software目录下
- 解压apache-flume-1.9.0-bin.tar.gz到/opt/module/目录下
tar -zxvf /opt/software/apache-flume-1.9.0-bin.tar.gz -C /opt/module/
- 修改apache-flume-1.9.0-bin的名称为flume-1.9.0
mv /opt/module/apache-flume-1.9.0-bin /opt/module/flume-1.9.0
- 配置环境变量
# 打开配置文件vim /etc/profile.d/my_env.sh# 添加如下内容export FLUME_HOME=/opt/module/flume-1.9.0export PATH=$PATH:$FLUME_HOME/bin# source 配置文件source /etc/profile.d/my_env.sh
- 将lib文件夹下的guava-11.0.2.jar删除以兼容Hadoop 3.1.3
rm -rf /opt/module/flume-1.9.0/lib/guava-11.0.2.jar
2.Flume入门案例
案例一:监控端口数据官方案例
需求 : 使用Flume监听一个端口,收集该端口数据,并打印到控制台
- 安装netcat工具
sudo yum install -y nc
- 在flume-1.9.0文件夹下创建目录object/simpleCase/config
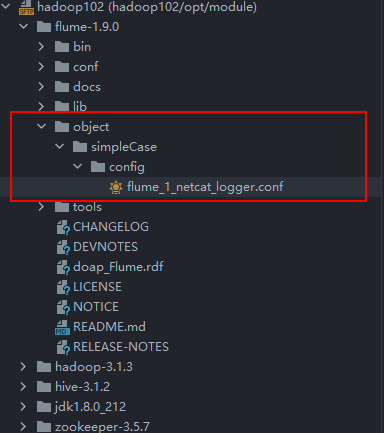
- 在config目录下创建配置文件flume_1_netcat_logger.conf,并添加如下内容
# 案例1 端口----->logger# agenta1.sources = r1a1.sinks = k1a1.channels = c1# sourcea1.sources.r1.type = netcata1.sources.r1.bind = hadoop102a1.sources.r1.port = 6666# sinka1.sinks.k1.type = logger# channela1.channels.c1.type = memorya1.channels.c1.capacity = 1000a1.channels.c1.transactionCapacity = 100# binda1.sources.r1.channels = c1a1.sinks.k1.channel = c1
- 开启Flume监听端口
flume-ng agent --name a1 --conf /opt/module/flume-1.9.0/conf/ --conf-file flume_1_netcat_logger.conf -Dflume.root.logger=INFO,console
- 使用netcat工具向本机的6666端口发送内容
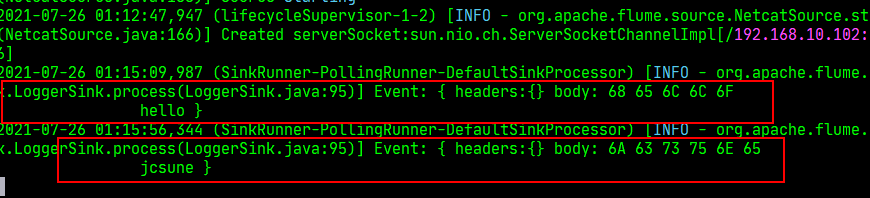
nc hadoop102 6666hellojcsune
- 在flume 监听页面观察接收数据情况
案例二:实时监控单个追加文件
需求:实时监控Hive日志,并上传到HDFS中
需求分析

实现步骤
- 确保Hadoop和java环境配置正确
- 创建flume_2_exec_hdfs.conf文件,并添加如下内容
# 案例2 实时监控单个追加文件# agenta2.sources=r1a2.sinks=k1a2.channels=c1# sourcea2.sources.r1.type = execa2.sources.r1.command = tail -F /opt/module/flume-1.9.0/object/simpleCase/data/case2.loga2.sources.r1.shell = /bin/bash -c# sinka2.sinks.k1.type = hdfsa2.sinks.k1.hdfs.path = hdfs://hadoop102:9820/flume-1.9.0/simpleCase/2/%Y%m%d/%H#上传文件的前缀a2.sinks.k1.hdfs.filePrefix = logs-#是否按照时间滚动文件夹a2.sinks.k1.hdfs.round = true#多少时间单位创建一个新的文件夹a2.sinks.k1.hdfs.roundValue = 1#重新定义时间单位a2.sinks.k1.hdfs.roundUnit = hour#是否使用本地时间戳a2.sinks.k1.hdfs.useLocalTimeStamp = true#积攒多少个Event才flush到HDFS一次a2.sinks.k1.hdfs.batchSize = 100#设置文件类型,可支持压缩a2.sinks.k1.hdfs.fileType = DataStream#多久生成一个新的文件a2.sinks.k1.hdfs.rollInterval = 60#设置每个文件的滚动大小a2.sinks.k1.hdfs.rollSize = 134217700#文件的滚动与Event数量无关a2.sinks.k1.hdfs.rollCount = 0# channela2.channels.c1.type = memorya2.channels.c1.capacity = 1000a2.channels.c1.transactionCapacity = 100# binda2.sources.r1.channels=c1a2.sinks.k1.channel=c1
- 运行Flume
flume-ng agent --name a2 --conf /opt/module/flume-1.9.0/conf/ --conf-file flume_2_exec_hdfs.conf -Dflume.root.logger=INFO,console
- 开启Hadoop和Hive并操作Hive产生日志
mycluster.sh start #开启Hadoophiveservice.sh start #开启Hive
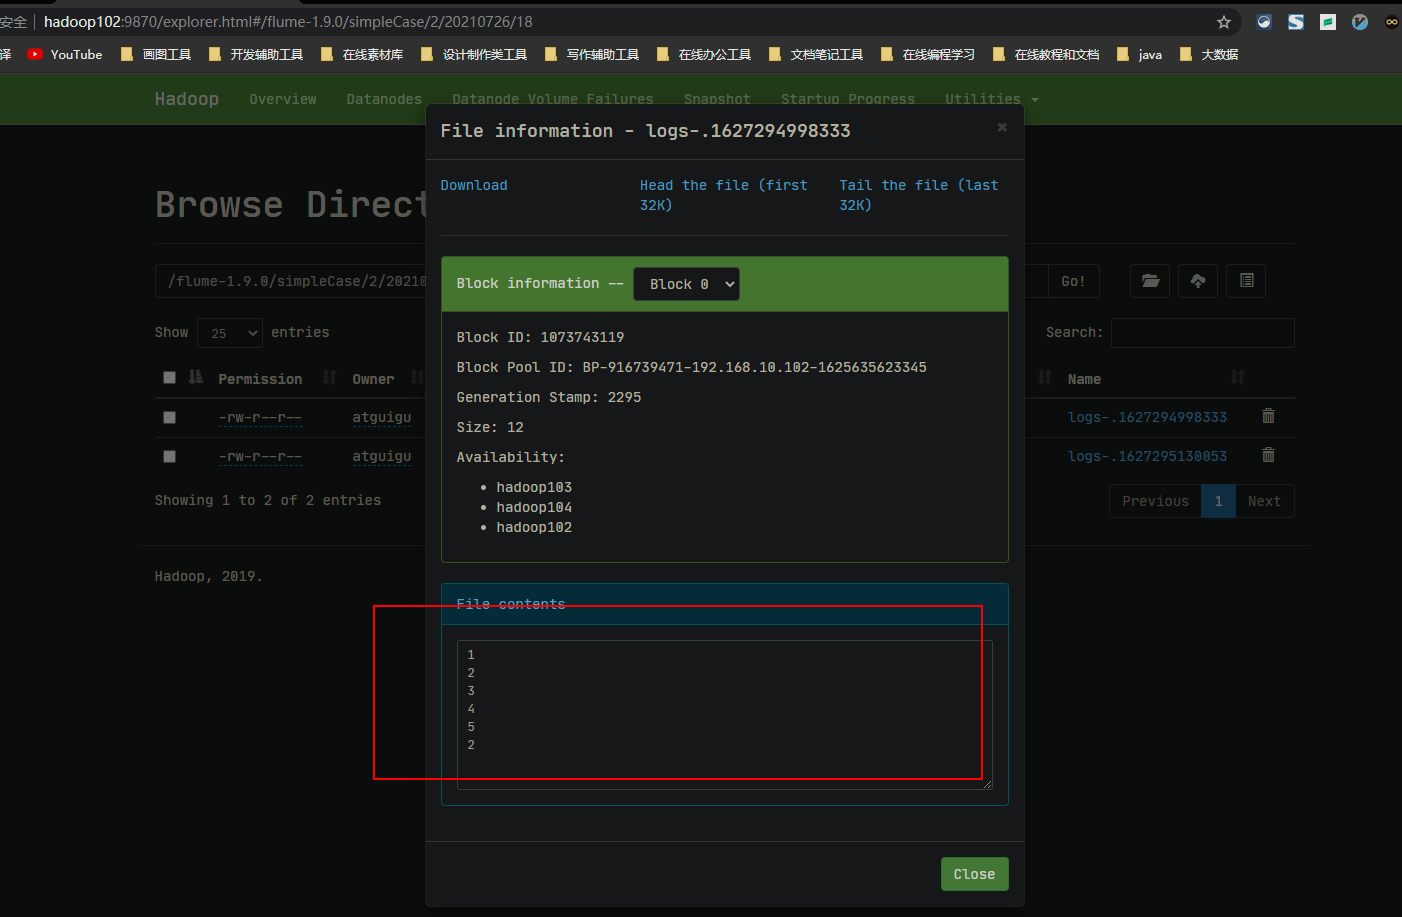
- 测试(/opt/module/flume-1.9.0/object/simpleCase/data)
echo 1 >> case2.logecho 2 >> case2.logecho 3 >> case2.logecho 4 >> case2.logecho 5 >> case2.log
- 浏览器查看
案例三:实时监控目录下多个新文件
案例需求: 使用Flume监听整个目录的文件,并上传至HDFS

实现步骤:
- 创建配置文件flume_3_spoolDir_hdfs.conf,并添加如下内容
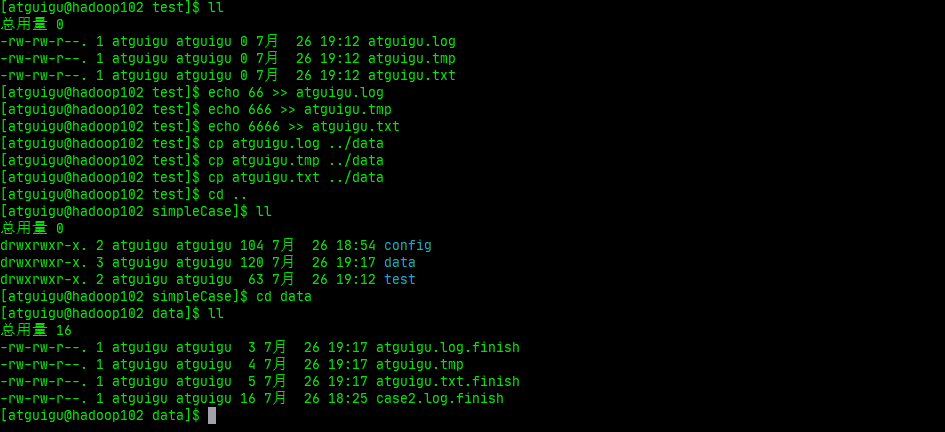
# 案例3 实时监控目录下多个文件# agenta3.sources=r1a3.sinks=k1a3.channels=c1# sourcea3.sources.r1.type = spooldira3.sources.r1.spoolDir = /opt/module/flume-1.9.0/object/simpleCase/data/a3.sources.r1.fileSuffix = .finisha3.sources.r1.fileHeader = true#忽略所有以.tmp结尾的文件,不上传a3.sources.r1.ignorePattern = ([^ ]*\.tmp)# sinka3.sinks.k1.type = hdfsa3.sinks.k1.hdfs.path = hdfs://hadoop102:9820/flume-1.9.0/simpleCase/3/%Y%m%d/%H#上传文件的前缀a3.sinks.k1.hdfs.filePrefix = logs-#是否按照时间滚动文件夹a3.sinks.k1.hdfs.round = true#多少时间单位创建一个新的文件夹a3.sinks.k1.hdfs.roundValue = 1#重新定义时间单位a3.sinks.k1.hdfs.roundUnit = hour#是否使用本地时间戳a3.sinks.k1.hdfs.useLocalTimeStamp = true#积攒多少个Event才flush到HDFS一次a3.sinks.k1.hdfs.batchSize = 100#设置文件类型,可支持压缩a3.sinks.k1.hdfs.fileType = DataStream#多久生成一个新的文件a3.sinks.k1.hdfs.rollInterval = 60#设置每个文件的滚动大小a3.sinks.k1.hdfs.rollSize = 134217702#文件的滚动与Event数量无关a3.sinks.k1.hdfs.rollCount = 0# channela3.channels.c1.type = memorya3.channels.c1.capacity = 1000a3.channels.c1.transactionCapacity = 100# binda3.sources.r1.channels=c1a3.sinks.k1.channel=c1
- 启动监控文件夹命令
flume-ng agent --name a3 --conf /opt/module/flume-1.9.0/conf/ --conf-file flume_3_spoolDir_hdfs.conf -Dflume.root.logger=INFO,console
- 在/opt/module/flume-1.9.0/object/simpleCase下新建test文件夹并添加文件
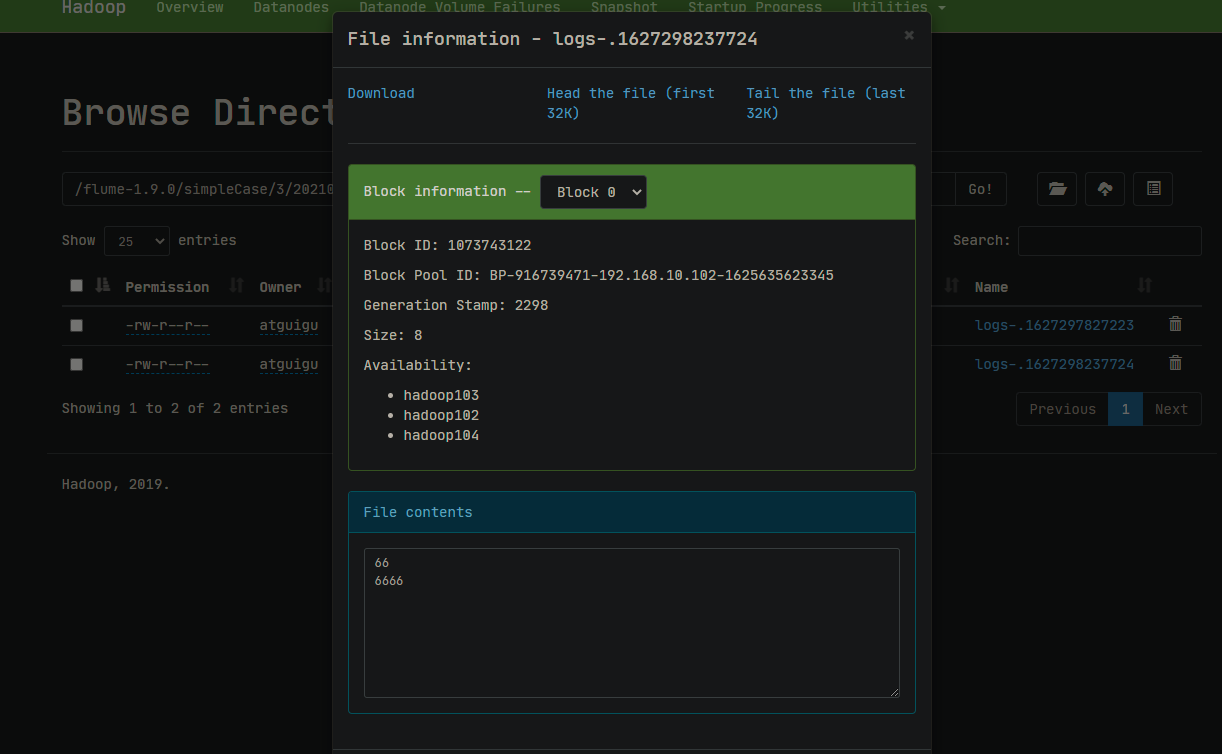
- 浏览器端查看
案例四:实时监控目录下多个追加文件
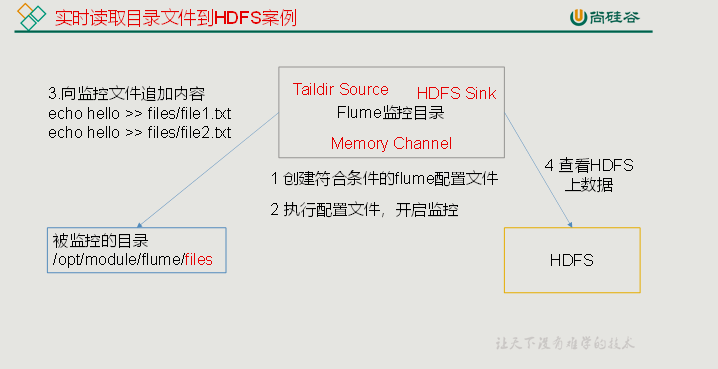
Exec source适用于监控一个实时追加的文件,不能实现断点续传;Spooldir Source适合用于同步新文件,但不适合对实时追加日志的文件进行监听并同步;而Taildir Source适合用于监听多个实时追加的文件,并且能够实现断点续传。
案例需求:使用Flume监听整个目录的实时追加文件,并上传到HDFS
实现步骤:
- 创建配置文件flume_4_tailDir_hdfs.conf ,并添加如下内容
# 案例四 实时监控目录下多个追加文件# agenta4.sources=r1a4.sinks=k1a4.channels=c1# sourcea4.sources.r1.type = TAILDIRa4.sources.r1.positionFile = /opt/module/flume-1.9.0/tail_dir.jsona4.sources.r1.filegroups = f1 f2a4.sources.r1.filegroups.f1 = /opt/module/flume-1.9.0/object/simpleCase/file/.*file.*a4.sources.r1.filegroups.f2 = /opt/module/flume-1.9.0/object/simpleCase/log/.*log.*# sinka4.sinks.k1.type = hdfsa4.sinks.k1.hdfs.path = hdfs://hadoop102:9820/flume-1.9.0/simpleCase/4/%Y%m%d/%H#上传文件的前缀a4.sinks.k1.hdfs.filePrefix = case4-#是否按照时间滚动文件夹a4.sinks.k1.hdfs.round = true#多少时间单位创建一个新的文件夹a4.sinks.k1.hdfs.roundValue = 1#重新定义时间单位a4.sinks.k1.hdfs.roundUnit = hour#是否使用本地时间戳a4.sinks.k1.hdfs.useLocalTimeStamp = true#积攒多少个Event才flush到HDFS一次a4.sinks.k1.hdfs.batchSize = 100#设置文件类型,可支持压缩a4.sinks.k1.hdfs.fileType = DataStream#多久生成一个新的文件a4.sinks.k1.hdfs.rollInterval = 60#设置每个文件的滚动大小a4.sinks.k1.hdfs.rollSize = 134217700#文件的滚动与Event数量无关a4.sinks.k1.hdfs.rollCount = 0# channela4.channels.c1.type = memorya4.channels.c1.capacity = 1000a4.channels.c1.transactionCapacity = 100# binda4.sources.r1.channels=c1a4.sinks.k1.channel=c1
- 启动监控文件夹命令
flume-ng agent --name a4 --conf /opt/module/flume-1.9.0/conf/ --conf-file flume_4_tailDir_hdfs.conf -Dflume.root.logger=INFO,console
- 分别创建好测试文件
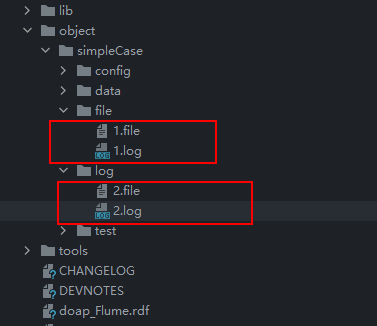
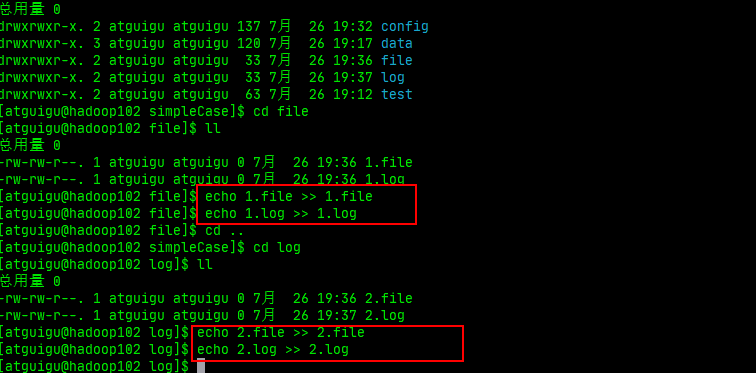
- 浏览器查看


若有收获,就点个赞吧
0 人点赞


