第一章 HDFS概述
1.HDFS产生背景和定义
- HDFS产生背景
随着数据量越来越大,在一个操作系统存不下所有数据,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需要一种系统来管理多台机器上的文件,这就是分布式文件管理系统,HDFS只是分布式文件管理系统中的一种
- HDFS意义
- HDFS(Hadoop Distributed FileSystem),它是一个文件系统,用于存储文件,通过目录树来定义文件,其次,它是分布式的,由很多服务器联合起来实现其功能,集群中的服务器有各自的角色
- HDFS的使用场景:适合一次写入,多次读出的场景,且不支持文件的修改,适合用来做数据分析,并不适合用来做网盘应用
2.HDFS的优缺点
- 优点
1.高容错性:(1)数据自动保存多个副本,它通过增加副本的形式,提高容错性
          (2)某一个副本丢失以后,它可以自动恢复
2.适合处理大数据:(1)数据规模:能够处理数据规模达到GB,TB,甚至PB级别的数据
               (2)文件规模:能够处理百万规模以上的文件数量,数量相当之大
3.可构建在廉价机器上
- 缺点
1.不适合低延时数据访问,比如毫秒级的存储数据,是做不到的
2.无法高效的对大量小文件进行存储
    (1)存储大量小文件的话,它会占用NameNode大量的内存来存储文件目录和块信息,这样是不可取的,因为NameNode的内存总是有限的
    (2)小文件存储的寻址时间会超过读取时间,它违反了HDFS的设计目标
3.不支持并发写入,文件随机修改
    (1)一个文件只能有一个写,不允许多个线程同时写
    (2)仅支持数据append(追加)不支持文件的随机修改
3.HDFS组成架构
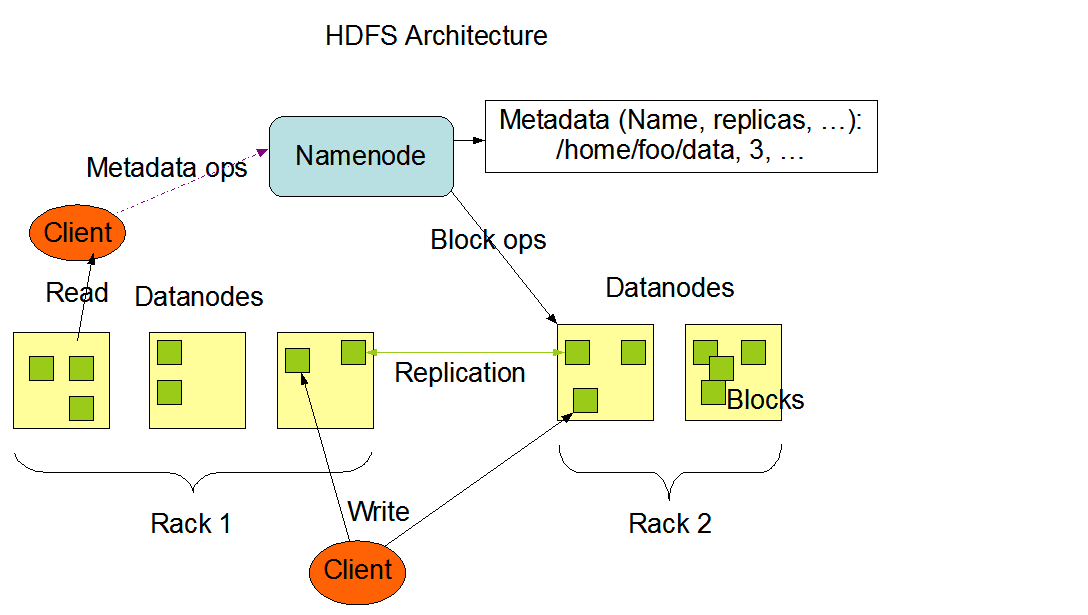
- NameNode(nn):就是Master,它是一个主管,管理者
1.管理HDFS的名称空间
2.配置副本策略
3.管理数据块(Block)映射信息
4.处理客户端读写请求
- DataNode:就是slave,NameNode下达命令,DataNode执行实际的操作
1.存储实际的数据块
2.执行数据块的读写操作
- Client: 就是客户端
1.文件切分,文件上传HDFS的时候,Client将文件切分成一个一个的Block,然后进行上传
2.与NameNode交互,获取文件的位置信息
3.与DataNode交互,读取或者写入数据
4.提供一些命令来管理HDFS,比如NameNOde格式化
5.Client可以通过一些命令来访问HDFS,比如对HDFS增删查改操作
- Secondary NameNode: 并非NameNode的热备,当NameNode挂掉的时候,它并不能马上替换NameNode并提供服务
1.辅助NameNode,分担其工作量,比如定期合并Fsimage和Edits,并推送给NameNode
2.在紧急情况下,可辅助恢复NameNode
4.HDFS文件块大小
HDFS的文件在物理上是分块存储(Block),块的大小可以通过配置参数(dfs.blocksize)来规定,默认大小在Hadoop2.x版本中是128M,老版本中是64M>
1.集群中的block(block1,block2,....blockn)
2.如果寻址时间为10ms,即查找目标块的时间为10ms
3.寻址时间为传输时间的1%时,则为最佳状态,因此传输时间=10ms/0.01=1s
4.目前磁盘的传输速率普遍为100MB/s
思考:为什么块的大小不能设置太小,也不能设置太大
- HDFS的块设置太小,会增加寻址时间,程序一直在找块的开始位置
- 如果块设置的太大,从磁盘传输数据的时间会明显大于定位这个块开始位置所需的时间,导致程序在处理这块数据时,会非常慢
- HDFS块的大小设置主要取决于磁盘传输速率
第二章.HDFS的Shell操作
1.基本语法
hadoop fs 具体指令 或者 hdfs dfs 具体指令 (两个是完全相同的)
2.常用命令实操(事先启动好集群)
- 上传
1.-moveFromLocal:从本地剪切粘贴到HDFS
touch aa.txt
hadoop fs -moveFromLocal ./aa.txt /input
2.-copyFromLocal:从本地文件系统中拷贝文件到HDFS路径中
hadoop fs -copyFromLocal ./bb.txt /
3.-appendToFile:追加一个文件到已经存在的文件末尾
hadoop fs -appendToFile ./cc.txt /input/aa.txt
4.-put:等同于copyFromLocal
hadoop fs -put ./dd.txt /
- 下载
1.-copyToLocal:从HDFS拷贝到本地
hadoop fs -copyToLocal /input/aa.txt ./
2.-get:等同于-copytoLocal将文件从HDFS下载到本地
hadoop fs -get /input/aa.txt ./
3.-getmerge:合并下载多个文件,比如HDFS的目录/user/atguigu/test下有多个文件:log1,log2,log3
hadoop fs -getmerge /user/atguigu/test/* ./ee.txt
- HDFS直接操作
1.-ls:显示目录信息
hadoop fs -ls /
2.-mkdir:在HDFS上创建目录
hadoop fs -mkdir -p /input/aa
3.-cat:显示文件内容
hadoop fs -cat /input/aa.txt
hadoop fs -cat /input/* | zcat //显示压缩文件内容
4.-chmod:修改文件所属权限
hadoop fs -chmod 666 /input/aa.txt
5.-cp:从HDFS的一个路径拷贝到HDFS的另一个路径
hadoop fs -cp /input/aa.txt /output
6.-mv:在HDFS目录中移动文件
hadoop fs -mv /input/aa.txt /
7.-tail:显示一个文件的末尾
hadoop fs -tail /input/aa.txt
8.-rm:删除文件或文件夹
hadoop fs -rm /input/aa.txt
9.-rmdir:删除空目录
hadoop fs -rmdir /test
10.-du:统计文件夹的大小信息
hadoop fs -du -s -h /input
11.-setrep设置HDFS中文件的副本数量
hadoop fs -setrep 10 /input/aa.txt   #这里设置的副本数只是记录在NameNode的元数据中,是否真的会有这么多副本,还得看DataNode的数量,因为目前只有三台设备,最多也就3台副本,只有节点数增加到十台时,副本数才能达到10
第三章.HDFS客户端操作
1.在window上配置Hadoop环境变量
- 配置HADOOP_HOME
- 配置path
- 如果上述操作后还有问题可以将bin目录下hadoop.dll和winutils.exe放到C:/windows/system32目录下
2.创建一个空的Maven工程(hadoop-hdfs)
- 导入相关依赖坐标+日志添加
<dependencies>
    <dependency>
        <groupId>junit</groupId>
        <artifactId>junit</artifactId>
        <version>4.12</version>
    </dependency>
    <dependency>
        <groupId>org.apache.logging.log4j</groupId>
        <artifactId>log4j-slf4j-impl</artifactId>
        <version>2.12.0</version>
    </dependency>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-client</artifactId>
        <version>3.1.3</version>
    </dependency>
</dependencies>
- 在项目的src/main/resource目录下,新建一个文件,命名为log4j2.xml,在文件中填入
<?xml version="1.0" encoding="UTF-8"?>
<Configuration status="error" strict="true" name="XMLConfig">
    <Appenders>
        <!-- 类型名为Console,名称为必须属性 -->
        <Appender type="Console" name="STDOUT">
            <!-- 布局为PatternLayout的方式,
            输出样式为[INFO] [2018-01-22 17:34:01][org.test.Console]I'm here -->
            <Layout type="PatternLayout"
                    pattern="[%p] [%d{yyyy-MM-dd HH:mm:ss}][%c{10}]%m%n" />
        </Appender>

    </Appenders>

    <Loggers>
        <!-- 可加性为false -->
        <Logger name="test" level="info" additivity="false">
            <AppenderRef ref="STDOUT" />
        </Logger>

        <!-- root loggerConfig设置 -->
        <Root level="info">
            <AppenderRef ref="STDOUT" />
        </Root>
    </Loggers>
</Configuration>
3. 创建文件系统对象
public class HDFSDemo {
    private FileSystem fileSystem;
    /*
    创建文件系统对象
     */
    @Before
    public void before() throws Exception {
        /*
         get(final URI uri, final Configuration conf, String user)
         uri:HDFS的地址
         conf:配置信息
         user:操作HDFS的用户
         */
        URI uri = new URI("hdfs://hadoop001:9820");//HDFS的地址
        Configuration configuration = new Configuration();//配置信息
        fileSystem = FileSystem.get(uri, configuration, "atguigu");
    }
    @Test
    public void test(){
        System.out.println("具体的操作");
    }
    /*
    关闭资源
     */
    @After
    public void after(){
        try {
            if(fileSystem != null){
                fileSystem.close();
            }

        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
4.上传
 /*
    上传
     */
    @Test
    public void test1() throws IOException {
        boolean delSrc = false;//是否删除原文件(客户端)
        boolean overwrite = true;//如果目标文件存在是否覆盖
        Path src = new Path("C:\\Users\\admin\\Desktop\\aa.txt");//源文件路径
        Path dst = new Path("/");//目标文件路径
        fileSystem.copyFromLocalFile(delSrc,overwrite,src,dst);

    }
5.下载
/*
    下载
     */
    @Test
    public void test2() throws Exception  {
        boolean delSrc = false;//是否删除原文件(HDFS)
        Path src = new Path("/xiyouji.txt");//源文件路径
        Path dst = new Path("C:\\Users\\admin\\Desktop");//目标文件路径
        boolean useRawLocalFileSystem = true;//是否使用RawLocalFileSystem
        fileSystem.copyToLocalFile(delSrc,src,dst,useRawLocalFileSystem);
    }
6.删除
/*
   删除
    */
    @Test
    public void test3() throws Exception  {

        Path src = new Path("/xiyouji.txt");//要删除的文件或目录的路径
        boolean recursive = true;//如果是目录必须为true,文件true或false都可以
        fileSystem.delete(src,recursive);
    }
7.移动和更改
 /*
   移动和更改
    */
    @Test
    public void test4() throws Exception  {

        Path src = new Path("/aa.txt");//源文件路径
        Path dst = new Path("/input1");//目标文件路径

        fileSystem.rename(src,dst);
    }
8.文件详情查看
/*
   查看文件详情
    */
    @Test
    public void test5() throws Exception  {
        Path path = new Path("/");//目标路径
        boolean recursive = true;//是否递归
        RemoteIterator<LocatedFileStatus> iterator = fileSystem.listFiles(path, recursive);
        //遍历
        while(iterator.hasNext()){//是否有下一个文件
            LocatedFileStatus fileStatus = iterator.next();//指针下移获取对应的文件
            System.out.println("============="+fileStatus.getPath().getName()+"=============");//获取文件的名字
            System.out.println("副本数量:" + fileStatus.getReplication());
            System.out.println("文件大小:" + fileStatus.getLen());
            //获取文件的块信息
            BlockLocation[] blockLocations = fileStatus.getBlockLocations();
            System.out.println(Arrays.toString(blockLocations));
        }

    }
9.判断是文件还是目录
/*
   判断是文件还是目录
    */
    @Test
    public void test6() throws Exception  {

        FileStatus[] fileStatuses = fileSystem.listStatus(new Path("/input"));
        //遍历
        for(FileStatus f : fileStatuses){
            if(f.isFile()){
                System.out.println(f.getPath().getName() +"是一个文件");
            }
            if(f.isDirectory()){
                System.out.println(f.getPath().getName() + "是一个目录");
            }
        }
    }
10.通过流的方式实现文件的上传和下载
/*
    通过流的方式实现上传
     */
    @Test
    public void test7() throws Exception{
        //从客户端读取指定的文件到内存中
        FileInputStream fis = new FileInputStream("C:\\Users\\admin\\Desktop\\添加新节点.txt");
        //通过文件系统对象把读取到的文件写到指定的目录
        FSDataOutputStream fos = fileSystem.create(new Path("/test.txt"));
        //一边读一边写
        IOUtils.copyBytes(fis,fos,1024,false);
        IOUtils.closeStream(fis);
        IOUtils.closeStream(fos);


    }
/*
    通过流的方式实现下载
     */
    @Test
    public void test8() throws Exception{
        //读:通过文件系统对象创建
        FSDataInputStream fis  = fileSystem.open(new Path("/input/aa.txt"));
        //写:通过FileOutputStream
        FileOutputStream fos = new FileOutputStream("C:\\Users\\admin\\Desktop\\aa1.txt");
        //一边读一边写
        IOUtils.copyBytes(fis,fos,1024,true);


    }

若有收获,就点个赞吧
0 人点赞


