第一章.Flink的window机制
1.窗口概述及分类
# 窗口概述在流处理应用中,数据是连续不断的,因此我们不可能等到所有数据都到了才开始处理,当然我们可以每来一个消息就处理一次,但是有时我们需要做一些聚合类的运算,例如:在过去的1分钟内有多少用户点击了我们的网页,在这种情况下,我们必须定义一个窗口,用来收集最近一分钟内的数据,并对这个窗口中的数据进行计算流式计算是一种被设计用于处理无限数据集的数据处理引擎,而无限数据集是指一种不断增长的本质上的无限的数据集,而window窗口是一种切割无限数据为有限块进行处理的手段在Flink中,窗口(window)是处理无界流的核心,窗口把流切割成有限大小的多个存储桶(bucket),我们在这些桶上进行计算
窗口分为两类
- 基于时间的窗口(时间驱动)
- 基于元素个数的窗口(数据驱动)
2.基于时间的窗口
- 时间窗口包含一个开始时间戳(包含)和结束时间戳(不包含)—->[start,end),这两个时间戳一起限制了窗口的尺寸,在Flink中,TimeWindow这个类表示基于时间的窗口
- 时间窗口又分三种:滚动窗口,滑动窗口,会话窗口
一.滚动窗口(Tumbling Windows)
- 滚动窗口有固定的大小,窗口与窗口之间不会重叠也没有缝隙,比如,如果指定一个长度为5分钟的窗口,当前窗口开始计算,每5分钟启动一个新的窗口
- 滚动窗口能将数据流切分为不重叠的窗口,每一个事件只能属于一个窗口

示例代码
package com.atguigu.flink.day04;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.TimeCharacteristic;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.datastream.WindowedStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;import org.apache.flink.streaming.api.windowing.assigners.TumblingProcessingTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;import org.apache.flink.streaming.api.windowing.windows.TimeWindow;import org.apache.flink.util.Collector;import org.junit.After;import org.junit.Before;import org.junit.Test;public class $01_TimeWindow {SingleOutputStreamOperator<WaterSensor> sensorDS = null;WindowedStream<WaterSensor, String, TimeWindow> sensorWS = null;StreamExecutionEnvironment env = null;SingleOutputStreamOperator<String> resultDS = null;@Beforepublic void before(){env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//老版本需要该设置//env.setStreamTimeCharacteristic(TimeCharacteristic.ProcessingTime);sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});}/*** 基于时间的滚动窗口*/@Testpublic void test01(){sensorWS = sensorDS.keyBy(sensor -> sensor.getId())/*** flink version <= 1.11的写法*///.timeWindow(Time.seconds(3));/*** 新写法*/.window(TumblingProcessingTimeWindows.of(Time.seconds(3)));}@Afterpublic void after() throws Exception {resultDS = sensorWS.process(new ProcessWindowFunction<WaterSensor, String, String, TimeWindow>() {@Overridepublic void process(String s, Context context, Iterable<WaterSensor> elements, Collector<String> out) throws Exception {out.collect("key" + s + "\n"+ "窗口有" + elements.spliterator().estimateSize() + "条数据" + "\n"+ "窗口划分:[" + context.window().getStart() + "," + context.window().getEnd() + ")" + "\n\n");}});resultDS.print();env.execute();}}
二.滑动窗口(Sliding Windows)
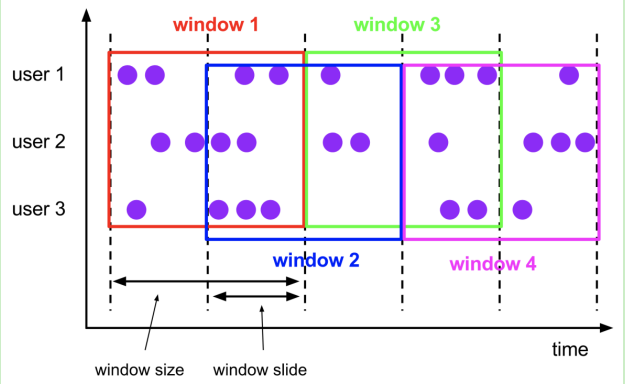
- 与滚动窗口一样,滑动窗口也有固定的长度,另外一个参数我们叫滑动步长,用来控制窗口启动的频率
- 所以如果滑动步长小于窗口长度,滑动窗口会重叠,这种情况下,一个元素可能会被分配到多个窗口中
示例代码
/*** 基于时间的滑动窗口*/@Testpublic void test02(){sensorWS = sensorDS.keyBy(sensor -> sensor.getId())/*** <=1.11的写法*///.timeWindow(Time.seconds(5),Time.seconds(3));/*** 新写法*/.window(TumblingProcessingTimeWindows.of(Time.seconds(3)));}
三.会话窗口(Session Windows)
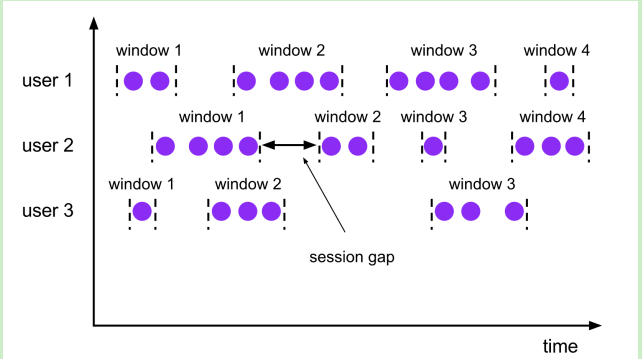
- 会话窗口分配器会根据活动的元素进行分组,会话窗口不会有重叠,与滚动窗口和滑动窗口相比,会话窗口也没有固定的开启和关闭时间
- 如果会话窗口有一段时间没有收到数据,会话窗口会自动关闭,这段没有收到数据的时间就是会话窗口的gap(间隔)
- 我们可以配置静态的gap,也可以通过一个gap extractor 函数来定义gap的长度,当时间超过了这个gap,当前的会话窗口就会关闭,后续的元素会被分配到一个新的会话窗口
示例代码
/*** 基于时间的会话窗口-静态Gap*/@Testpublic void test03(){sensorWS = sensorDS.keyBy(sensor -> sensor.getId()).window(ProcessingTimeSessionWindows.withGap(Time.seconds(5)));}/*** 基于时间的会话窗口-动态Gap*/@Testpublic void test04(){sensorWS = sensorDS.keyBy(sensor -> sensor.getId()).window(ProcessingTimeSessionWindows.withDynamicGap(new SessionWindowTimeGapExtractor<WaterSensor>() {@Overridepublic long extract(WaterSensor element) {return element.getTs() * 1000L;}}));}
3.全局窗口(Global Windows)
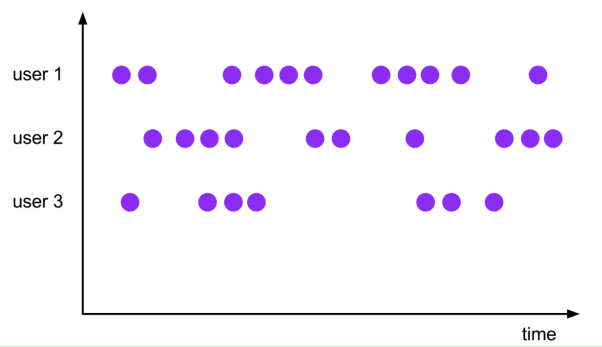
全局窗口分配器会分配相同key的所有元素,进入同一个Global window,这种窗口机制只有指定自定义的触发器时才有用,否则,不会做任何运算,因为这种窗口没有能够处理聚集在一起元素的结束点
示例代码
package com.atguigu.flink.day04;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.datastream.WindowedStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;import org.apache.flink.streaming.api.windowing.assigners.GlobalWindows;import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;import org.apache.flink.streaming.api.windowing.evictors.TimeEvictor;import org.apache.flink.streaming.api.windowing.time.Time;import org.apache.flink.streaming.api.windowing.triggers.CountTrigger;import org.apache.flink.streaming.api.windowing.windows.GlobalWindow;import org.apache.flink.streaming.api.windowing.windows.TimeWindow;import org.apache.flink.util.Collector;import java.util.Arrays;public class $02_GlobalWindow {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);/*** 老版本需要这么指定,默认是处理时间* 新版本不需要指定,默认是事件时间,而且开窗的时候,自己就要明确指定时间语义*///env.setStreamTimeCharacteristic(TimeCharacteristic.EventTime);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}}).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forMonotonousTimestamps().withTimestampAssigner(new SerializableTimestampAssigner<WaterSensor>() {@Overridepublic long extractTimestamp(WaterSensor element, long recordTimestamp) {return element.getTs() * 1000L;}}));//TODO 全局窗口,需要自定义触发器WindowedStream<WaterSensor, String, GlobalWindow> sensorWS = sensorDS.keyBy(sensor -> sensor.getId()).window(GlobalWindows.create()).trigger(CountTrigger.of(3)).evictor(TimeEvictor.of(Time.seconds(5)));SingleOutputStreamOperator<String> resultDS = sensorWS.process(new ProcessWindowFunction<WaterSensor, String, String, GlobalWindow>() {@Overridepublic void process(String s, Context context, Iterable<WaterSensor> elements, Collector<String> out) throws Exception {out.collect("key=" + s + "\n"+ "窗口有" + elements.spliterator().estimateSize() + "条数据" + "\n"+ "窗口划分:[" + context.window().toString()+ ")" + "\n\n");}});resultDS.print();env.execute();}}
4.基于元素个数的窗口
一.滚动窗口
- 默认的CountWindow是一个滚动窗口,只需要指定窗口大小即可,当元素数量达到窗口大小时,就会触发窗口的执行
- 哪个窗口先达到3个元素,哪个窗口就关闭,不影响其他的窗口
示例代码
package com.atguigu.flink.day04;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.datastream.WindowedStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;import org.apache.flink.streaming.api.windowing.windows.GlobalWindow;import org.apache.flink.util.Collector;public class $03_CountWindow {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);/*** 老版本需要这么指定,默认是处理时间* 新版本不需要指定,默认是事件时间,而且开窗的时候,自己就要明确指定时间语义*///env.setStreamTimeCharacteristic(TimeCharacteristic.EventTime);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});//TODO 基于条数的滚动窗口WindowedStream<WaterSensor, String, GlobalWindow> sensorWS = sensorDS.keyBy(sensor -> sensor.getId()).countWindow(3);SingleOutputStreamOperator<String> resultDS = sensorWS.process(new ProcessWindowFunction<WaterSensor, String, String, GlobalWindow>() {@Overridepublic void process(String s, Context context, Iterable<WaterSensor> elements, Collector<String> out) throws Exception {out.collect("key=" + s + "\n"+ "窗口有" + elements.spliterator().estimateSize() + "条数据" + "\n"+ "窗口划分:[" + context.window().toString()+ ")" + "\n\n");}});resultDS.print();env.execute();}}
二.滑动窗口
滑动窗口和滚动窗口的函数名是完全一致的,只是在传参数时需要传入两个参数,一个是window_size,一个是sliding_size
示例代码
package com.atguigu.flink.day04;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.datastream.WindowedStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;import org.apache.flink.streaming.api.windowing.windows.GlobalWindow;import org.apache.flink.util.Collector;/*** 窗口的划分并不是以第一条数据为基准的* 第一个输出的窗口 = 步长* 每经过一个步长,都有一个窗口输出,关闭*/public class $04_CountWindow2 {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);/*** 老版本需要这么指定,默认是处理时间* 新版本不需要指定,默认是事件时间,而且开窗的时候,自己就要明确指定时间语义*///env.setStreamTimeCharacteristic(TimeCharacteristic.EventTime);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});//TODO 基于条数的滑动窗口WindowedStream<WaterSensor, String, GlobalWindow> sensorWS = sensorDS.keyBy(sensor -> sensor.getId()).countWindow(5,2);SingleOutputStreamOperator<String> resultDS = sensorWS.process(new ProcessWindowFunction<WaterSensor, String, String, GlobalWindow>() {@Overridepublic void process(String s, Context context, Iterable<WaterSensor> elements, Collector<String> out) throws Exception {out.collect("key=" + s + "\n"+ "窗口有" + elements.spliterator().estimateSize() + "条数据" + "\n"+ "窗口划分:[" + context.window().toString()+ ")" + "\n\n");}});resultDS.print();env.execute();}}
5.窗口函数
- 指定了窗口的分配器后,需要指定如何计算,这事由窗口函数来负责,一旦窗口关闭,窗口函数去计算处理窗口中的每个元素
- 窗口函数可以是ReduceFunction,AggregateFunction,ProcessWindowFunction中的任意一种
- ReduceFunction,AggregateFunction更加高效,原因是Flink可以对到来的元素进行增量聚合,ProcessWindowFunction可以得到一个包含这个窗口的所有元素的迭代器,以及这些元素所属窗口的元数据信息
- ProcessWindowFunction不能被高效执行的原因是Flink在执行这个函数之前,需要在内存缓存这个窗口上的所有元素
一.增量函数
增量函数:
- 来一条处理一条
- 窗口的输出次数:窗口触发关闭的时候,也就是说,每个窗口只会向下游传递一次结果
- aggregate相比reduce:都是增量聚合
- reduce第一条不调用方法
- aggregate比reduce更灵活,reduce要求输入类型,中间状态,输出类型要一致,aggregate输入类型,中间状态(累加器),输出类型可以不一致
示例代码
package com.atguigu.flink.day04;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.AggregateFunction;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.functions.ReduceFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.datastream.WindowedStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.windowing.assigners.TumblingProcessingTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;import org.apache.flink.streaming.api.windowing.windows.TimeWindow;import org.junit.After;import org.junit.Before;import org.junit.Test;public class $05_IncreFunction {SingleOutputStreamOperator<WaterSensor> sensorDS = null;WindowedStream<WaterSensor, String, TimeWindow> sensorWS = null;StreamExecutionEnvironment env = null;SingleOutputStreamOperator<WaterSensor> resultDS = null;SingleOutputStreamOperator<String> resultDS1 = null;@Beforepublic void before(){env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});sensorWS = sensorDS.keyBy(sensor -> sensor.getId()).window(TumblingProcessingTimeWindows.of(Time.seconds(10)));//窗口分配器}/*** 窗口函数-增量函数 - reduce*/@Testpublic void test01(){resultDS = sensorWS.reduce(new ReduceFunction<WaterSensor>() {@Overridepublic WaterSensor reduce(WaterSensor value1, WaterSensor value2) throws Exception {System.out.println(value1 + "<=======>" + value2);return new WaterSensor(value1.getId(), System.currentTimeMillis(), value1.getVc()+value2.getVc());}});}/*** 窗口函数-增量函数 -aggregate*/@Testpublic void test02(){resultDS1 = sensorWS.aggregate(new AggregateFunction<WaterSensor, Integer, String>() {/*** 初始化累加器* @return*/@Overridepublic Integer createAccumulator() {System.out.println("create.....");return 0;}/*** 累加的逻辑* @param value* @param accumulator* @return*/@Overridepublic Integer add(WaterSensor value, Integer accumulator) {System.out.println("add....");return value.getVc() + accumulator;}/*** 获取结果* @param accumulator* @return*/@Overridepublic String getResult(Integer accumulator) {System.out.println("getResult....");return accumulator.toString();}/*** 只有会话窗口才会调用* @param a* @param b* @return*/@Overridepublic Integer merge(Integer a, Integer b) {System.out.println("merge.....");return a + b;}});}@Afterpublic void after() throws Exception {if(resultDS != null){resultDS.print();}if(resultDS1 != null){resultDS1.print();}env.execute();}}
二.全量函数
全量函数:数据全部存起来,触发的时候一次性计算和输出
示例代码
package com.atguigu.flink.day04;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.datastream.WindowedStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;import org.apache.flink.streaming.api.windowing.assigners.TumblingProcessingTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;import org.apache.flink.streaming.api.windowing.windows.TimeWindow;import org.apache.flink.util.Collector;import java.util.Arrays;/*** 窗口函数-->全量函数*/public class $06_AllFunctionWindow {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});//TODO 全局窗口,需要自定义触发器WindowedStream<WaterSensor, String, TimeWindow> sensorWS = sensorDS.keyBy(sensor -> sensor.getId()).window(TumblingProcessingTimeWindows.of(Time.seconds(10)));SingleOutputStreamOperator<String> resultDS = sensorWS.process(new ProcessWindowFunction<WaterSensor, String, String, TimeWindow>() {@Overridepublic void process(String s, Context context, Iterable<WaterSensor> elements, Collector<String> out) throws Exception {out.collect("key=" + s + "\n"+ "窗口有" + elements.spliterator().estimateSize() + "条数据" + "\n"+ "数据为:" + Arrays.asList(elements).toString() + "\n"+ "窗口划分:[" + context.window().getStart() + "," + context.window().getEnd() + ")" + "\n\n");}});resultDS.print();env.execute();}}
6.Non-Keyed Windows
- 在用窗口前首先需要确认应该是在keyBy之后的流上用,还是在没有keyBy的流上用
- 在keyed streams上使用窗口,窗口计算被并行的运用在多个task上,可以认为每个task都有自己单独窗口
- 在非non-keyed stream上使用窗口,流的并行度只能是1,所有的窗口逻辑只能在一个单独的task上执行
- 需要注意的是:非key分区的流上使用window,如果把并行度强行设置为>1,则会抛出异常
示例代码
package com.atguigu.flink.day04;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.windowing.ProcessAllWindowFunction;import org.apache.flink.streaming.api.windowing.assigners.TumblingProcessingTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;import org.apache.flink.streaming.api.windowing.windows.TimeWindow;import org.apache.flink.util.Collector;import java.util.Arrays;/*** NoKeyedWindow*/public class $07_NoKeyedWindow {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(3);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});sensorDS.windowAll(TumblingProcessingTimeWindows.of(Time.seconds(10))).process(new ProcessAllWindowFunction<WaterSensor, String, TimeWindow>() {@Overridepublic void process(Context context, Iterable<WaterSensor> elements, Collector<String> out) throws Exception {out.collect(Arrays.asList(elements).toString());}}).print();env.execute();}}
7.窗口源码分析
以滚动窗口为例
package com.atguigu.flink.day04;/*** 窗口相关源码分析(以滚动窗口为例)*/public class $09_SourceCodeAnalysis {public static void main(String[] args) throws Exception {/**** 窗口是怎么划分的* long start =TimeWindow.getWindowStartWithOffset(* now, (globalOffset + staggerOffset) % size, size);* return Collections.singletonList(new TimeWindow(start, start + size));* public static long getWindowStartWithOffset(long timestamp, long offset, long windowSize) {* return timestamp - (timestamp - offset + windowSize) % windowSize;* }**//**** 窗口为什么左闭右开* Gets the largest timestamp that still belongs to this window.** <p>This timestamp is identical to {@code getEnd() - 1}.** @return The largest timestamp that still belongs to this window.* @see #getEnd()*** @Override* public long maxTimestamp() {* return end - 1;* }*//*** 窗口什么时候触发* @Override* public TriggerResult onProcessingTime(long time, TimeWindow window, TriggerContext ctx) {* return TriggerResult.FIRE;* }* 时间 >= maxTimestamp*//*** 窗口什么时候创建?窗口什么时候销毁?(窗口的生命周期?)* 创建: 属于本窗口的第一条数据来的时候,new的,放到一个 单例集合* 销毁: cleanupTime = window.maxTimestamp() + allowedLateness;* 清空状态的时间 = 时间进展到 窗口最大时间戳 + 允许迟到的时间*/}}
第二章.Flink的时间语义与WaterMark
1.时间语义
一.事件时间
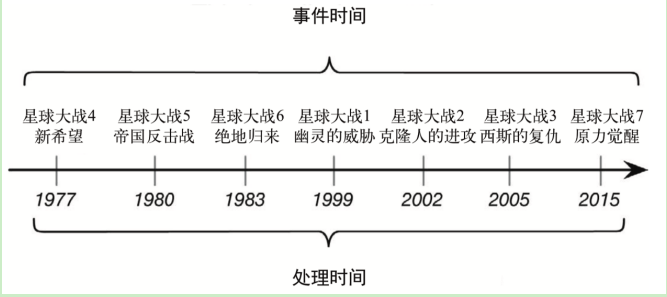
事件时间是指这个事件发生的时间在event进入flink之前,通常被嵌入到了event中,一般作为这个event的时间戳存在在事件时间体系中,时间的进度依赖于事件本身,和任何设备的时间无关,事件时间必须制定如何产生Event Time Watermarks(水印),在事件时间体系中,水印是代表时间进度的标志(作用相当于现实时间的时钟)在理想条件下,不管事件时间何时到达或者他们到达的顺序如何,事件时间处理将产生完全一致且确定的结果,事件时间会在等待无序时间(迟到时间)时产生一定的延迟,由于只能等待有限的时间,因此这限制了确定性事件时间应用程序的可使用性假设所有数据都已到达,事件时间操作将按照预期方式进行,即使在处理无序或迟到的事件或重新处理历史数据时,也会产生正确且一致的效果,例如,每小时事件时间窗口将包含带有事件时间戳的所有记录,将记录计入该小时,无论他们到达的顺序或处理时间在使用窗口的时候,如果使用事件时间,就指定时间分配器为事件时间分配器
注意: 在1.12之前默认的时间语义是处理时间,从1.12开始,Flink内部已经把默认的语义改成了事件时间
二.处理时间
处理时间指的是执行操作的各个设备的时间对于运行在处理时间上的流程序,所有的基于时间的操作(比如时间窗口)都是使用的设备时钟,比如一个长度为1个小时的窗口将会包含设备时钟表示的1个小时内所有的数据,假设应用程序在9:15am启动,第一个小时窗口将会包含9:15am到10:00am所有的数据,然后下个窗口是10:00am-11.00am等处理时间是最简单时间语义,数据流与设备之间不需要做任何的协调,它提供了最好的性能和最低的延迟,但是在分布式和异步的环境之下,处理时间没有方法保证确定性,容易受到数据传递速度的影响:事件的延迟和乱序在使用窗口的时候,如果使用处理时间,就指定时间分配器为处理时间分配器
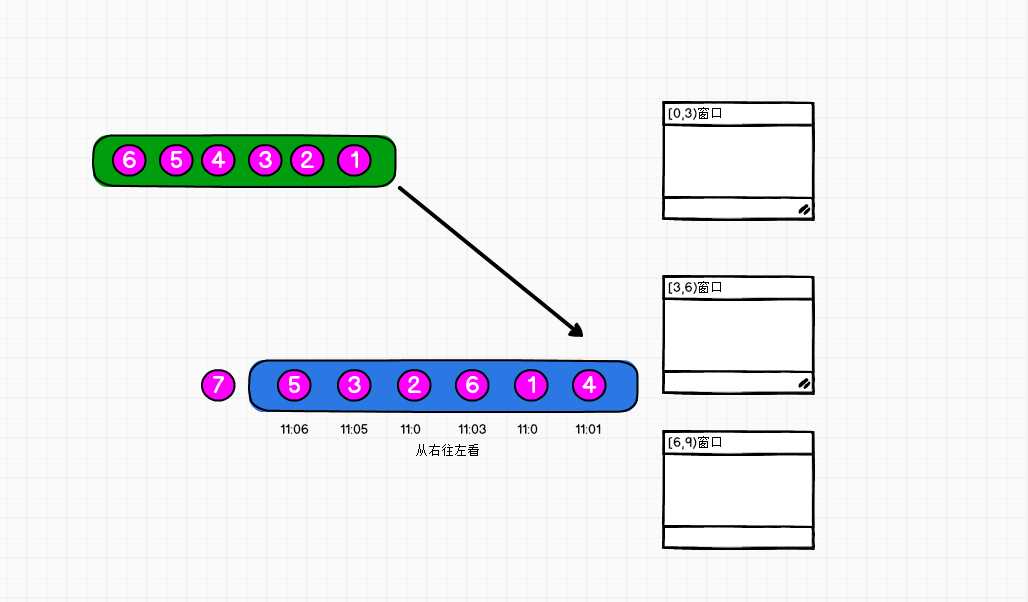
三.案例
四.代码
package com.atguigu.flink.day04;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.TimeCharacteristic;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.datastream.WindowedStream;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;import org.apache.flink.streaming.api.windowing.assigners.TumblingProcessingTimeWindows;import org.apache.flink.streaming.api.windowing.assigners.TumblingTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;import org.apache.flink.streaming.api.windowing.windows.TimeWindow;import org.apache.flink.util.Collector;import java.util.Arrays;public class $08_TimeCharacteristic_EventTime {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);/*** 老版本需要这么指定,默认是处理时间* 新版本不需要指定,默认是事件时间,而且开窗的时候,自己就要明确指定时间语义*///env.setStreamTimeCharacteristic(TimeCharacteristic.EventTime);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}}).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forMonotonousTimestamps().withTimestampAssigner(new SerializableTimestampAssigner<WaterSensor>() {@Overridepublic long extractTimestamp(WaterSensor element, long recordTimestamp) {return element.getTs() * 1000L;}}));WindowedStream<WaterSensor, String, TimeWindow> sensorWS = sensorDS.keyBy(sensor -> sensor.getId()).window(TumblingEventTimeWindows.of(Time.seconds(10)));SingleOutputStreamOperator<String> resultDS = sensorWS.process(new ProcessWindowFunction<WaterSensor, String, String, TimeWindow>() {@Overridepublic void process(String s, Context context, Iterable<WaterSensor> elements, Collector<String> out) throws Exception {out.collect("key" + s + "\n"+ "窗口有" + elements.spliterator().estimateSize() + "条数据" + "\n"+ "数据为:" + Arrays.asList(elements).toString() + "\n"+ "窗口划分:[" + context.window().getStart() + "," + context.window().getEnd() + ")" + "\n\n");}});resultDS.print();env.execute();}}
2.WaterMark初理解
- WaterMark是用来衡量事件时间的进展
- 用来解决乱序的问题
- 是一个特殊的时间戳,从指定生成的位置插入到流里
- 单调不减的
- 用来触发窗口的
- Flink认为,事件时间小于WaterMark的数据应该都已经处理过了,如果后续还有事件时间小于watermark的数据来,称为迟到数据
支持event time的流式处理框架需要一种能够测量 event time 进度的方式,比如一个窗口算子创建了一个长度为1小时的窗口,那么这个算子需要知道事件时间已经到达了这个窗口的关闭时间,从而在程序中去关闭这个窗口事件时间可以不依赖处理时间来表示时间的进度,例如在程序中,即使处理时间和事件时间有相同的速度,事件时间可能会轻微的落后处理时间,另外一方面,使用事件时间可以在几秒内处理已经缓存在kafka中的数据,这些数据可以照样被正确处理,就像实时发生的一样能够进入正确的窗口这种在flink中去测量事件时间的进度的机制就是waterMark(水印),waterMark作为数据流的一部分在流动,并且携带一个时间戳t一个WaterMark(t)表示在这个流里面事件时间已经到了时间t,意味着此时,流中不应该存在这样的数据:它的时间戳t2<=t(时间比较旧或者等于时间戳)
WaterMark原理图


若有收获,就点个赞吧
0 人点赞


