第一章.Flink流处理核心编程
1.transform
一.简单滚动聚合算子
常见的滚动聚合算子 sum, min, max,minBy,maxBy
作用:KeyedStream的每一个支流做聚合,执行完成后,会将聚合的结果合成一个流返回,所以结果都是DataStream
参数:如果流中存储的是POJO或者scala的样例类, 参数使用字段名. 如果流中存储的是元组, 参数就是位置(基于0…)
返回:KeyedStream -> SingleOutputStreamOperator
package com.atguigu.flink.day03;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.java.functions.KeySelector;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import java.util.ArrayList;/*** 简单滚动聚合算子*/public class $01_RollingAggregationFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);ArrayList<WaterSensor> waterSensors = new ArrayList<>();waterSensors.add(new WaterSensor("sensor_1", 1607527992000L, 20));waterSensors.add(new WaterSensor("sensor_1", 1607527994000L, 50));waterSensors.add(new WaterSensor("sensor_1", 1607527996000L, 50));waterSensors.add(new WaterSensor("sensor_2", 1607527993000L, 10));waterSensors.add(new WaterSensor("sensor_2", 1607527995000L, 30));DataStreamSource<WaterSensor> waterSensorDS = env.fromCollection(waterSensors);waterSensorDS.keyBy(new KeySelector<WaterSensor, String>() {@Overridepublic String getKey(WaterSensor value) throws Exception {return value.getId();}})/*** maxBy和minBy可以指定当出现相同值的时候,其他字段是否取第一个.* true表示取第一个, false表示取与最大值(最小值)同一行的.* 5.3.10reduce*///.maxBy("vc",Boolean.FALSE).print();//.sum("vc").print();.min("vc").print();env.execute();}}
二.reduce
一个分组数据流的聚合操作,合并当前的元素和上次聚合的结果,产生一个新的值,返回的流中包含每一次聚合的结果,而不是只返回最后一次聚合的最终结果
为什么还要把中间值也保存下来,考虑流式数据的特点:没有终点,也就没有最终的概念了,任何一个中间的聚合结果都是值
注意:聚合后结果的类型,必须和原来流中元素的类型保持一致
package com.atguigu.flink.day03;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.functions.ReduceFunction;import org.apache.flink.api.java.functions.KeySelector;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import java.util.ArrayList;/*** reduce* 1.keyby之后调用* 2.每个分组的第一条数据来的时候,不会调用reduce方法,直接传递给下游* 3.value1是上一次的计算结果,value2是当前来的数据*/public class $02_ReduceFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});sensorDS.keyBy(sensor -> sensor.getId()).reduce(new ReduceFunction<WaterSensor>() {@Overridepublic WaterSensor reduce(WaterSensor value1, WaterSensor value2) throws Exception {return new WaterSensor(value1.getId(),System.currentTimeMillis(),value1.getVc() + value2.getVc());}}).print();env.execute();}}
三.process
process算子在flink算是一个比较底层的算子,很多类型的流上都可以调用,可以从流中获取更多的信息(不仅仅是数据本身)
package com.atguigu.flink.day03;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.KeyedProcessFunction;import org.apache.flink.util.Collector;/*** process*/public class $03_ProcessFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop102", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});sensorDS.keyBy(sensor -> sensor.getId()).process(new KeyedProcessFunction<String, WaterSensor, String>() {@Overridepublic void processElement(WaterSensor value, Context ctx, Collector<String> out) throws Exception {out.collect(ctx.getCurrentKey());}}).print();env.execute();}}
四.对流重新分区的几个算子
- keyBy: 先按照key分组,按照key的双重hash来选择后面的分区
- shuffle: 对流中的元素随机分区
- rebalance : 对流中的元素平均分布到每个区,当处理倾斜数据的时候,进行性能优化
- rescale: 同rebalance一样,也是平均循环的分布数据,但是要比rebalance更高效,因为rescale不需要通过网络,完全走的管道
2.sink
一.KafkaSink
- pom.xml
<dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-kafka_2.12</artifactId><version>1.13.1</version></dependency>
- 代码
package com.atguigu.flink.day03;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.connectors.kafka.FlinkKafkaProducer;import org.apache.flink.streaming.connectors.kafka.KafkaSerializationSchema;import org.apache.kafka.clients.producer.ProducerRecord;import javax.annotation.Nullable;import java.nio.charset.StandardCharsets;import java.util.Properties;/*** 将数据写出到kafka* 生产者:* ack:* buffersize: 默认 32M* batchsize: 默认 16K* linger.ms: 默认 0ms** 注意事项:* 1.可以指定一些生产者参数:ack.缓冲区,批次* 2.默认分区器 FlinkFixedPartitioner* 3.可以指定一致性级别: 至少一次,精准一次*/public class $04_KafkaSink {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});Properties prop = new Properties();prop.put("bootstrap.servers","hadoop162:9092,hadoop163:9092,hadoop164:9092");sensorDS.addSink(new FlinkKafkaProducer<WaterSensor>("default",new KafkaSerializationSchema<WaterSensor>() {@Overridepublic ProducerRecord<byte[], byte[]> serialize(WaterSensor waterSensor, @Nullable Long aLong) {return new ProducerRecord<byte[], byte[]>("waterSensor",waterSensor.toString().getBytes(StandardCharsets.UTF_8));}},prop,FlinkKafkaProducer.Semantic.EXACTLY_ONCE));env.execute();}}
二.Redis Sink
- pom.xml
<!-- https://mvnrepository.com/artifact/org.apache.flink/flink-connector-redis --><dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-redis_2.11</artifactId><version>1.1.5</version></dependency>
- 代码
package com.atguigu.flink.day03;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.connectors.kafka.FlinkKafkaProducer;import org.apache.flink.streaming.connectors.kafka.KafkaSerializationSchema;import org.apache.flink.streaming.connectors.redis.RedisSink;import org.apache.flink.streaming.connectors.redis.common.config.FlinkJedisPoolConfig;import org.apache.flink.streaming.connectors.redis.common.mapper.RedisCommand;import org.apache.flink.streaming.connectors.redis.common.mapper.RedisCommandDescription;import org.apache.flink.streaming.connectors.redis.common.mapper.RedisMapper;import org.apache.kafka.clients.producer.ProducerRecord;import javax.annotation.Nullable;import java.nio.charset.StandardCharsets;import java.util.Properties;/*** 将数据写入到redis*/public class $05_RedisSink {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});FlinkJedisPoolConfig jedisPoolConfig = new FlinkJedisPoolConfig.Builder().setHost("hadoop162").setPort(6379).build();RedisSink<WaterSensor> redisSinkFunction = new RedisSink<>(jedisPoolConfig,new RedisMapper<WaterSensor>() {@Overridepublic RedisCommandDescription getCommandDescription() {//指定命令:往Hash结构插入数据(也可以是其他命令)return new RedisCommandDescription(RedisCommand.HSET, "waterSensor");}/*** 从数据读取hash结构的key* @param waterSensor* @return*/@Overridepublic String getKeyFromData(WaterSensor waterSensor) {return waterSensor.getId();}/*** 从数据提取,hash结构的value* @param waterSensor* @return*/@Overridepublic String getValueFromData(WaterSensor waterSensor) {return waterSensor.getVc().toString();}});sensorDS.addSink(redisSinkFunction);env.execute();}}
三.ElasticsearchSink
- pom.xml
<!-- https://mvnrepository.com/artifact/org.apache.flink/flink-connector-elasticsearch6 --><dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-elasticsearch6_2.12</artifactId><version>1.13.1</version></dependency>
- 代码
package com.atguigu.flink.day03;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.functions.RuntimeContext;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.connectors.elasticsearch.ElasticsearchSinkFunction;import org.apache.flink.streaming.connectors.elasticsearch.RequestIndexer;import org.apache.flink.streaming.connectors.elasticsearch6.ElasticsearchSink;import org.apache.http.HttpHost;import org.elasticsearch.action.index.IndexRequest;import org.elasticsearch.client.Requests;import java.util.ArrayList;import java.util.HashMap;/*** 将数据写入到es* es: http://hadoop162:9200/watersensor/_search* kibana: GET /watersensor/_search*/public class $06_ElasticsearchSink {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});ArrayList<HttpHost> httpHosts = new ArrayList<>();httpHosts.add(new HttpHost("hadoop162",9200));httpHosts.add(new HttpHost("hadoop163",9200));httpHosts.add(new HttpHost("hadoop164",9200));ElasticsearchSink.Builder<WaterSensor> esBuilder = new ElasticsearchSink.Builder<>(httpHosts,new ElasticsearchSinkFunction<WaterSensor>() {@Overridepublic void process(WaterSensor waterSensor, RuntimeContext runtimeContext, RequestIndexer requestIndexer) {HashMap<String, String> dataMap = new HashMap<>();dataMap.put("data", waterSensor.toString());IndexRequest indexRequest = Requests.indexRequest().index("watersensor").type("_doc").source(dataMap);requestIndexer.add(indexRequest);}});//TODO 注意:这个仅仅是为了演示效果才设为1,生产环境不要改成1esBuilder.setBulkFlushMaxActions(1);ElasticsearchSink<WaterSensor> esSinkFunction = esBuilder.build();sensorDS.addSink(esSinkFunction);env.execute();}}
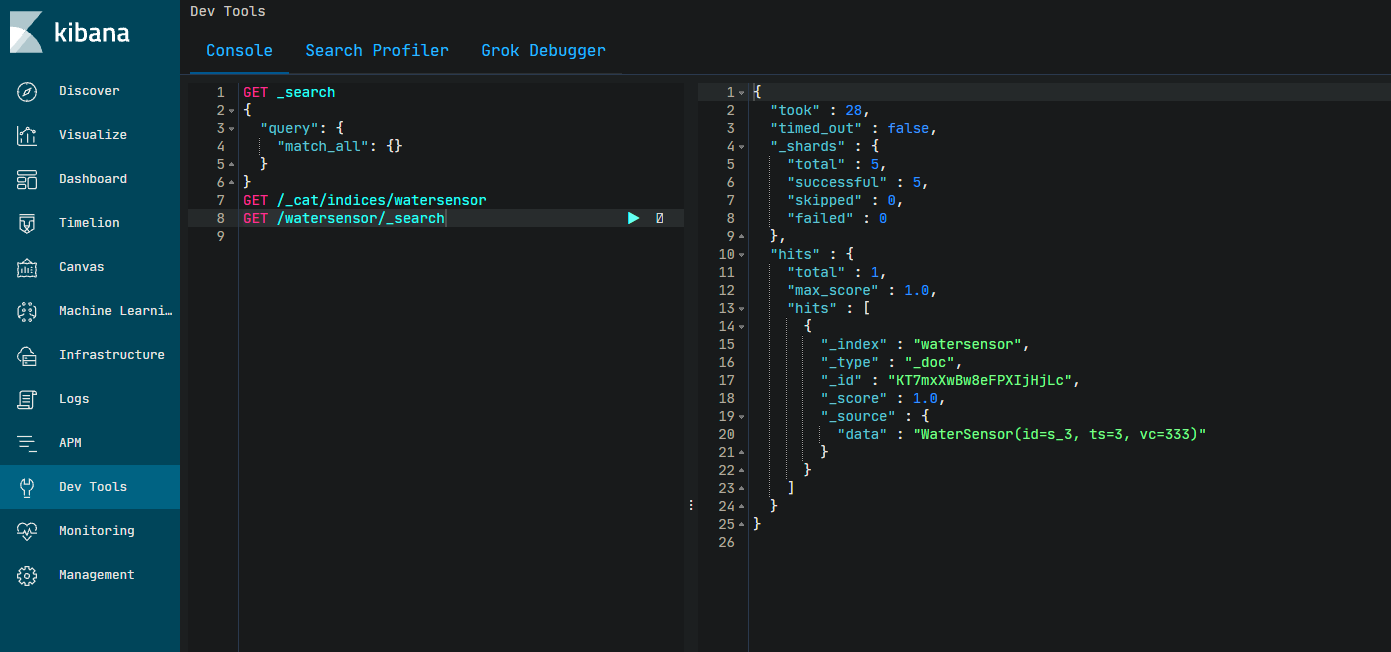
四.自定义sink
需求: 使用flink读取socket数据到mysql
- 导入mysql依赖
<dependency><groupId>mysql</groupId><artifactId>mysql-connector-java</artifactId><version>5.1.49</version></dependency>
- 建库建表
create database test;use test;CREATE TABLE `sensor` (`id` varchar(20) NOT NULL,`ts` bigint(20) NOT NULL,`vc` int(11) NOT NULL,PRIMARY KEY (`id`,`ts`)) ENGINE=InnoDB DEFAULT CHARSET=utf8;
- 代码
package com.atguigu.flink.day03;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.functions.RuntimeContext;import org.apache.flink.configuration.Configuration;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.sink.RichSinkFunction;import org.apache.flink.streaming.connectors.elasticsearch.ElasticsearchSinkFunction;import org.apache.flink.streaming.connectors.elasticsearch.RequestIndexer;import org.apache.flink.streaming.connectors.elasticsearch6.ElasticsearchSink;import org.apache.http.HttpHost;import org.elasticsearch.action.index.IndexRequest;import org.elasticsearch.client.Requests;import java.sql.Connection;import java.sql.DriverManager;import java.sql.PreparedStatement;import java.util.ArrayList;import java.util.HashMap;/*** 自定义sink :将数据写出到kafka* 生产环境用官方的JDBC写法* https://nightlies.apache.org/flink/flink-docs-release-1.13/docs/connectors/datastream/jdbc/*/public class $07_MySqlSink {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}});sensorDS.addSink(new MySink());env.execute();}public static class MySink extends RichSinkFunction<WaterSensor>{private Connection connection;private PreparedStatement preparedStatement;@Overridepublic void open(Configuration parameters) throws Exception {connection = DriverManager.getConnection("jdbc:mysql://hadoop162:3306/test", "root", "aaaaaa");preparedStatement = connection.prepareStatement("insert into sensor values (?,?,?)");}@Overridepublic void close() throws Exception {if(preparedStatement != null){preparedStatement.close();}if(connection != null){connection.close();}}@Overridepublic void invoke(WaterSensor value, Context context) throws Exception {preparedStatement.setString(1, value.getId());preparedStatement.setLong(2,value.getTs());preparedStatement.setInt(3,value.getVc());preparedStatement.execute();}}}
3.配置BATH执行模式
执行模式有3个选择可配
- STREAMING(默认)
- BATCH
- AUTOMATIC
有界数据用哪个STREAMING 和BATCH的区别STREAMING模式下, 数据是来一条输出一次结果.BATCH模式下, 数据处理完之后, 一次性输出结果.
命令行配置
bin/flink run -Dexecution.runtime-mode=BATCH …
第二章.Flink流处理核心编程实战
1.基于埋点日志数据的网络流量统计
一.网站总浏览量(PV)的统计
衡量网站流量一个最简单的指标,就是网站的页面浏览量(Page View,PV)。用户每次打开一个页面便记录1次PV,多次打开同一页面则浏览量累计。一般来说,PV与来访者的数量成正比,但是PV并不直接决定页面的真实来访者数量,如同一个来访者通过不断的刷新页面,也可以制造出非常高的PV。接下来我们就用咱们之前学习的Flink算子来实现PV的统计
- 用于封装数据的javabean
package com.atguigu.flink.day03.pojo;import lombok.AllArgsConstructor;import lombok.Data;import lombok.NoArgsConstructor;@Data@NoArgsConstructor@AllArgsConstructorpublic class UserBehavior {/*** 用户ID*/private Long userId;/*** 商品ID*/private Long itemId;/*** 品类ID*/private Integer categoryId;/*** 用户的行为:pv、buy、cart、fav*/private String behavior;/*** 时间戳*/private Long timestamp;}
- 代码
package com.atguigu.flink.day03;import com.atguigu.flink.day03.pojo.UserBehavior;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.ProcessFunction;import org.apache.flink.util.Collector;/*** pv*/public class $08_PV {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);//1.读取数据SingleOutputStreamOperator<UserBehavior> userBehavioirDS = env.readTextFile("input/UserBehavior.csv").map(new MapFunction<String, UserBehavior>() {@Overridepublic UserBehavior map(String value) throws Exception {String[] datas = value.split(",");return new UserBehavior(Long.parseLong(datas[0]),Long.parseLong(datas[1]),Integer.parseInt(datas[2]),datas[3],Long.parseLong(datas[4]));}});//2.处理数据userBehavioirDS.filter(user -> "pv".equals(user.getBehavior())).process(new ProcessFunction<UserBehavior, Integer>() {int pvCount = 0;@Overridepublic void processElement(UserBehavior value, Context ctx, Collector<Integer> out) throws Exception {pvCount++;out.collect(pvCount);}}).setParallelism(1).print();env.execute();}}
二.网站独立访客数(UV)的统计
上一个案例中,我们统计的是所有用户对页面的所有浏览行为,也就是说,同一用户的浏览行为会被重复统计。而在实际应用中,我们往往还会关注,到底有多少不同的用户访问了网站,所以另外一个统计流量的重要指标是网站的独立访客数(Unique Visitor,UV)
对于UserBehavior数据源来说,我们直接可以根据userId来区分不同的用户.
代码
package com.atguigu.flink.day03;import com.atguigu.flink.day03.pojo.UserBehavior;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.ProcessFunction;import org.apache.flink.util.Collector;import java.util.HashSet;import java.util.Set;/*** uv*/public class $09_UV {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);//1.读取数据SingleOutputStreamOperator<UserBehavior> userBehavioirDS = env.readTextFile("input/UserBehavior.csv").map(new MapFunction<String, UserBehavior>() {@Overridepublic UserBehavior map(String value) throws Exception {String[] datas = value.split(",");return new UserBehavior(Long.parseLong(datas[0]),Long.parseLong(datas[1]),Integer.parseInt(datas[2]),datas[3],Long.parseLong(datas[4]));}});//2.处理数据,提取出 用户ID,存在SET结构里,求SET的长度就是UV值userBehavioirDS.filter(user -> "pv".equals(user.getBehavior())).process(new ProcessFunction<UserBehavior, Integer>() {Set<Long> uvSet = new HashSet<>();@Overridepublic void processElement(UserBehavior value, Context ctx, Collector<Integer> out) throws Exception {//每来一条数据,提取出用户ID,存到Set里uvSet.add(value.getItemId());//将Set的元素个数(uv值),传递给下游out.collect(uvSet.size());}}).setParallelism(1).print();env.execute();}}
2.市场营销商业指标统计分析
随着智能手机的普及,在如今的电商网站中已经有越来越多的用户来自移动端,相比起传统浏览器的登录方式,手机APP成为了更多用户访问电商网站的首选。对于电商企业来说,一般会通过各种不同的渠道对自己的APP进行市场推广,而这些渠道的统计数据(比如,不同网站上广告链接的点击量、APP下载量)就成了市场营销的重要商业指标。
一.APP市场推广统计 -分渠道
- 封装数据的javabean
package com.atguigu.flink.day03.pojo;import lombok.AllArgsConstructor;import lombok.Data;import lombok.NoArgsConstructor;@Data@AllArgsConstructor@NoArgsConstructorpublic class MarketingUserBehavior {private Long userId;private String behavior;private String channel;private Long timestamp;}
- 具体实现代码
package com.atguigu.flink.day03;import com.atguigu.flink.day03.pojo.MarketingUserBehavior;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.java.tuple.Tuple2;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.source.SourceFunction;import java.util.Arrays;import java.util.List;import java.util.Random;/*** APP市场推广统计-分渠道*/public class $10_AppAnalysisByChannel {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);//1.读取数据DataStreamSource<MarketingUserBehavior> inputDS = env.addSource(new AppSource());//2.处理数据:按照不同渠道对不同行为进行统计-->对两个维度进行keybyinputDS.map(new MapFunction<MarketingUserBehavior, Tuple2<String,Integer>>() {@Overridepublic Tuple2<String, Integer> map(MarketingUserBehavior value) throws Exception {return Tuple2.of(value.getChannel() +"_"+value.getBehavior(),1);}}).keyBy(t->t.f0).sum(1).print();env.execute();}public static class AppSource implements SourceFunction<MarketingUserBehavior>{static boolean flag = true;List<String> behaviorList = Arrays.asList("DOWNLOAD", "INSTALL", "UPDATE", "UNINSTALL");List<String> channelList = Arrays.asList("XIAOMI", "HUAWEI", "OPPO", "VIVO");@Overridepublic void run(SourceContext<MarketingUserBehavior> ctx) throws Exception {Random random = new Random();while (flag) {ctx.collect(new MarketingUserBehavior(random.nextLong(),behaviorList.get(random.nextInt(behaviorList.size())),channelList.get(random.nextInt(channelList.size())),System.currentTimeMillis()));Thread.sleep(1000);}}@Overridepublic void cancel() {flag = false;}}}
二.APP市场推广统计 -不分渠道
- 实现代码
package com.atguigu.flink.day03;import com.atguigu.flink.day03.pojo.MarketingUserBehavior;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.java.tuple.Tuple2;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.source.SourceFunction;import java.util.Arrays;import java.util.List;import java.util.Random;/*** APP市场推广统计-不分渠道*/public class $11_AppAnalysisWithOutChannel {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);//1.读取数据DataStreamSource<MarketingUserBehavior> inputDS = env.addSource(new AppSource());//2.处理数据:按照不同渠道对不同行为进行统计-->对两个维度进行keybyinputDS.map(new MapFunction<MarketingUserBehavior, Tuple2<String,Integer>>() {@Overridepublic Tuple2<String, Integer> map(MarketingUserBehavior value) throws Exception {return Tuple2.of(value.getBehavior(),1);}}).keyBy(t->t.f0).sum(1).print();env.execute();}public static class AppSource implements SourceFunction<MarketingUserBehavior>{static boolean flag = true;List<String> behaviorList = Arrays.asList("DOWNLOAD", "INSTALL", "UPDATE", "UNINSTALL");List<String> channelList = Arrays.asList("XIAOMI", "HUAWEI", "OPPO", "VIVO");@Overridepublic void run(SourceContext<MarketingUserBehavior> ctx) throws Exception {Random random = new Random();while (flag) {ctx.collect(new MarketingUserBehavior(random.nextLong(),behaviorList.get(random.nextInt(behaviorList.size())),channelList.get(random.nextInt(channelList.size())),System.currentTimeMillis()));Thread.sleep(1000);}}@Overridepublic void cancel() {flag = false;}}}
3.各省市页面广告点击量实时统计
电商网站的市场营销商业指标中,除了自身的APP推广,还会考虑到页面上的广告投放(包括自己经营的产品和其它网站的广告)。所以广告相关的统计分析,也是市场营销的重要指标。<br /> 对于广告的统计,最简单也最重要的就是页面广告的点击量,网站往往需要根据广告点击量来制定定价策略和调整推广方式,而且也可以借此收集用户的偏好信息。更加具体的应用是,我们可以根据用户的地理位置进行划分,从而总结出不同省份用户对不同广告的偏好,这样更有助于广告的精准投放。
- 用于封装数据的javabean
package com.atguigu.flink.day03.pojo;import lombok.AllArgsConstructor;import lombok.Data;import lombok.NoArgsConstructor;@Data@AllArgsConstructor@NoArgsConstructorpublic class AdsClickLog {private Long userId;private Long adId;private String province;private String city;private Long timestamp;}
- 实现代码
package com.atguigu.flink.day03;import com.atguigu.flink.day03.pojo.AdsClickLog;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.java.functions.KeySelector;import org.apache.flink.api.java.tuple.Tuple2;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.KeyedProcessFunction;import org.apache.flink.util.Collector;import java.util.*;/*** 各省市页面广告点击量实时统计** 扩展知识:* 函数类中,定义的变量个数和作用范围* 1.函数类创建了几次?* 每个并行实例new一次* 2.类中定义的变量一共有几个?* 每个并行实例一份* 3.函数类的方法调用几次?* 大部分是,来一条数据调用一次方法* 也有一些是,来一批数据调用一次(比如窗口的全量函数)*/public class $12_AdClick {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);//1.读取数据,转换格式SingleOutputStreamOperator<AdsClickLog> adClickDS = env.readTextFile("input/AdClickLog.csv").map(new MapFunction<String, AdsClickLog>() {@Overridepublic AdsClickLog map(String value) throws Exception {String[] datas = value.split(",");return new AdsClickLog(Long.parseLong(datas[0]),Long.parseLong(datas[1]),datas[2],datas[3],Long.parseLong(datas[4]));}});//2.处理数据adClickDS.keyBy(new KeySelector<AdsClickLog, Tuple2<String,Long>>() {@Overridepublic Tuple2<String, Long> getKey(AdsClickLog value) throws Exception {return Tuple2.of(value.getProvince(),value.getAdId());}}).process(new KeyedProcessFunction<Tuple2<String, Long>, AdsClickLog, String>() {Map<Tuple2<String, Long>, Integer> map = new HashMap<>();@Overridepublic void processElement(AdsClickLog value, Context ctx, Collector<String> out) throws Exception {Integer count = map.get(ctx.getCurrentKey());if(count == null){//说明当前的key不存在,说明这是第一条数据count = 1;}else{//说明当前的key存在,说明这不是第一条数据,正常+1就行count++;}map.put(ctx.getCurrentKey(),count);out.collect(map.toString());}}).print();env.execute();}}
4.订单支付实时监控
在电商网站中,订单的支付作为直接与营销收入挂钩的一环,在业务流程中非常重要。对于订单而言,为了正确控制业务流程,也为了增加用户的支付意愿,网站一般会设置一个支付失效时间,超过一段时间不支付的订单就会被取消。另外,对于订单的支付,我们还应保证用户支付的正确性,这可以通过第三方支付平台的交易数据来做一个实时对账。需求:来自两条流的订单交易匹配
对于订单支付事件,用户支付完成其实并不算完,我们还得确认平台账户上是否到账了。而往往这会来自不同的日志信息,所以我们要同时读入两条流的数据来做合并处理。
- 用于封装数据的javabean
package com.atguigu.flink.day03.pojo;import lombok.AllArgsConstructor;import lombok.Data;import lombok.NoArgsConstructor;@Data@AllArgsConstructor@NoArgsConstructorpublic class OrderEvent {private Long orderId;private String eventType;private String txId;private Long eventTime;}
package com.atguigu.flink.day03.pojo;import lombok.AllArgsConstructor;import lombok.Data;import lombok.NoArgsConstructor;@Data@AllArgsConstructor@NoArgsConstructorpublic class TxEvent {private String txId;private String payChannel;private Long eventTime;}
- 实现代码
package com.atguigu.flink.day03;import com.atguigu.flink.day03.pojo.OrderEvent;import com.atguigu.flink.day03.pojo.TxEvent;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.streaming.api.datastream.ConnectedStreams;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.co.CoProcessFunction;import org.apache.flink.util.Collector;import java.util.HashMap;import java.util.Map;/***connect连接两条流的时候,如果需要做一些比对操作,要考虑数据的分布,* 需要比对的数据要在同一个分区里 ---->keyby(关联条件)*/public class $13_OrderTxDetect {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//1.读取数据,转换格式SingleOutputStreamOperator<OrderEvent> orderDS = env.readTextFile("input/OrderLog.csv").map(new MapFunction<String, OrderEvent>() {@Overridepublic OrderEvent map(String value) throws Exception {String[] datas = value.split(",");return new OrderEvent(Long.parseLong(datas[0]),datas[1],datas[2],Long.parseLong(datas[3]));}});SingleOutputStreamOperator<TxEvent> txDS = env.readTextFile("input/ReceiptLog.csv").map(new MapFunction<String, TxEvent>() {@Overridepublic TxEvent map(String value) throws Exception {String[] datas = value.split(",");return new TxEvent(datas[0],datas[1],Long.parseLong(datas[2]));}});//2.数据处理,需要做一个合流操作ConnectedStreams<OrderEvent, TxEvent> orderTxCS = orderDS.connect(txDS);ConnectedStreams<OrderEvent, TxEvent> orderTxKCS = orderTxCS.keyBy(order -> order.getTxId(), tx -> tx.getTxId());SingleOutputStreamOperator<String> resultDS = orderTxKCS.process(new CoProcessFunction<OrderEvent, TxEvent, String>() {Map<String, OrderEvent> orderMap = new HashMap<>();Map<String, TxEvent> txMap = new HashMap<>();/*** 处理的是业务系统的数据* @param value* @param ctx* @param out* @throws Exception*/@Overridepublic void processElement1(OrderEvent value, Context ctx, Collector<String> out) throws Exception {//进入这个方法,说明当前来的是业务系统的数据,先查一下,对方交易(数据)来了没有TxEvent txEvent = txMap.get(value.getTxId());if (txEvent == null) {//说明交易数据没来过,等他先把自己存起来orderMap.put(value.getTxId(), value);} else {//说明,对方来过==>匹配上,删除map中的数据out.collect("订单" + value.getOrderId() + "对账成功");txMap.remove(value.getTxId());}}/*** 处理的是交易系统的数据* @param value* @param ctx* @param out* @throws Exception*/@Overridepublic void processElement2(TxEvent value, Context ctx, Collector<String> out) throws Exception {//进入这个方法,说明当前来的是交易系统的数据,先查一下,对方业务(数据)来了没有OrderEvent orderEvent = orderMap.get(value.getTxId());if (orderEvent == null) {//说明业务数据没来过,等他先把自己存起来txMap.put(value.getTxId(), value);} else {//说明,对方来过==>匹配上,删除map中的数据out.collect("订单" + orderEvent.getOrderId() + "对账成功");orderMap.remove(value.getTxId());}}});resultDS.print();env.execute();}}

若有收获,就点个赞吧
0 人点赞


