第一章.Flink的状态编程
1.状态介绍
一.什么是状态
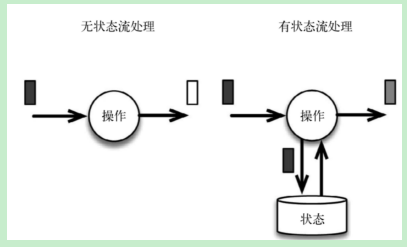
在流式计算中有些操作一次处理一个独立的事件,比如解析一个事件,有些操作却需要记住多个事件的信息(比如窗口操作),那么需要记住多个事件信息的操作是有状态的流式计算分为无状态计算和有状态计算两种情况无状态计算观察每个独立事件,并根据最后一个事件输出结果,例如.流处理应用程序从传感器接收水位数据,并在水位超出指定高度时发出警告有状态的计算则会基于多个事件输出结果,例如,计算过去一小时的平均水位,就是有状态的计算,所有用于复杂事件处理的状态机,例如,若在一分钟内收到两个相差20cm以上的水位差读数,则发出警告,这就是有状态的计算,所有流与流之间的关联操作,以及流与静态表或动态表的关联操作,都是有状态的计算
二.为什么需要管理状态
1. 去重数据流中的数据有重复,我们想对重复数据去重,需要记录哪些数据已经流入过应用,当新数据流入时,根据已流入过的数据来判断去重2. 检测检查输入流是否符合某个特定的模式,需要将之前流入的元素以状态的形式缓存下来,比如,判断一个温度传感器数据流中的温度是否在持续上升3. 聚合对一个时间窗口内的数据进行聚合分析,分析一个小时内水位的情况4. 更新机器学习模型在线机器学习场景下,需要根据新流入数据不断更新机器学习的模型参数
三.Flink中的状态分类
Flink 包括两种基本类型的状态 Managed State 和Row State
| Managed State | Row State | |
|---|---|---|
| 状态管理方式 | Flink Runtime托管,自动存储,自动恢复,自动伸缩 | 用户自己管理 |
| 状态数据结构 | Flink提供多种常用的数据结构,例如ListState,MapState等 | 字节数组[] |
| 使用场景 | 绝大数Flink算子 | 所有算子 |
注意,从具体的使用场景来说,绝大多数的算子都可以通过继承Rich函数类或其他提供好的接口类,在里面使用Managed State,Row State一般是在已有算子和Managed State 不够用时,用户自定义算子时使用在平常的使用中Managed State已经足够使用,所以重点学习Managed State
对Managed State继续细分,它又有两种类型,Operator State(算子状态),Keyed State(键控状态)
| Operator State | Keyed State | |
|---|---|---|
| 适用算子类型 | 可用于所有算子,常用于source,sink,例如FlinkKafkaConsumer | 只能用于KeyedStream上的算子 |
| 状态分配 | 一个算子的子任务对应一个状态 | 一个Key对应一个State:一个算子会处理多个Key,则访问相应的多个State |
| 创建和访问方式 | 实现CheckpointedFunction或ListCheckpointed(已经过时)接口 | 重写RichFunction,通过里面的RuntimeContext访问 |
| 横向扩展 | 并发改变时有多重重写分配方式可选:均匀分配和合并后每个得到全量 | 并发改变,State随着key在实例间迁移 |
| 支持的数据结构 | ListState和BroadCastState | ValueState,ListState,MapState,ReduceState,AggregatingState |
2.算子状态的使用
Operator State可以用在所有算子上,每个算子子任务或者说每个算子实例共享一个状态,流入这个算子子任务的数据可以访问和更新这个状态算子子任务之间的状态不能互相访问Operator State的实际应用场景不如Keyed State多,它经常被用在Source或Sink等算子上,用来保存流入数据的偏移量或对输出数据做缓存,以保证Flink应用的Exactly-Once语义
Flink为算子状态提供三种基本数据结构1.列表状态,将状态表示为一组数据的列表2.联合列表状态,也是将状态表示为数据的列表,它与常规列表状态的区别在于,在发生故障时,或者从保存点(savepoint)启动应用程序时如何恢复,一种是均匀分配,另外一种是将所有的State合并为全量State再分发给每个实例3.广播状态(Broadcast state),是一种特殊的算子状态,如果一个算子有多项任务,而他的每项任务状态又都相同,那么这种特殊情况最适合应用广播状态
一.列表状态
package com.atguigu.flink.day06;import org.apache.flink.api.common.functions.RichMapFunction;import org.apache.flink.api.common.state.ListState;import org.apache.flink.api.common.state.ListStateDescriptor;import org.apache.flink.api.common.typeinfo.Types;import org.apache.flink.runtime.state.FunctionInitializationContext;import org.apache.flink.runtime.state.FunctionSnapshotContext;import org.apache.flink.streaming.api.checkpoint.CheckpointedFunction;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import java.util.ArrayList;import java.util.List;/*** 列表状态*/public class $01_OperatorStateList {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);DataStreamSource<String> inputDS = env.socketTextStream("hadoop102", 9999);//读进来一行数据->切分成一个一个的单词,放到一个list里面inputDS.map(new MyMap()).print();env.execute();}public static class MyMap extends RichMapFunction<String,List<String>> implements CheckpointedFunction{ListState<String> listState;List<String> wordList = new ArrayList<>();@Overridepublic List<String> map(String value) throws Exception {String[] words = value.split(",");for (String word : words) {wordList.add(word);}return wordList;}/*** 对状态做快照(往状态里面存数据)* @param context* @throws Exception*/@Overridepublic void snapshotState(FunctionSnapshotContext context) throws Exception {listState.update(wordList);}/*** 从备份恢复状态到本地* @param context* @throws Exception*/@Overridepublic void initializeState(FunctionInitializationContext context) throws Exception {listState = context.getOperatorStateStore().getListState(new ListStateDescriptor<String>("list-state", Types.STRING));Iterable<String> listStateIt = listState.get();for (String element : listStateIt) {wordList.add(element);}}}}
二.广播状态
从版本1.5.0开始, Apache Flink具有一种新的状态,称为广播状态广播状态被引入以支持这样的用例:来自一个流的一些数据需要广播到所有下游任务,在那里它被本地存储,并用于处理另一个流上的所有传入元素,作为广播状态自然适合出现的一个例子.我们可以想象一个低吞吐量流,其中包含一个规则,我们希望根据来自另一个流的所有元素对这些规则进行评估,考虑到上述类型的用例,广播状态与其他算子状态的区别在于1.它是一个map格式2.它只对输入有广播流和无广播流的特定算子可用3.这样的算子可以具有不同名称的多个广播状态
package com.atguigu.flink.day06;import org.apache.flink.api.common.functions.RichMapFunction;import org.apache.flink.api.common.state.*;import org.apache.flink.api.common.typeinfo.Types;import org.apache.flink.runtime.state.FunctionInitializationContext;import org.apache.flink.runtime.state.FunctionSnapshotContext;import org.apache.flink.streaming.api.checkpoint.CheckpointedFunction;import org.apache.flink.streaming.api.datastream.BroadcastConnectedStream;import org.apache.flink.streaming.api.datastream.BroadcastStream;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.co.BroadcastProcessFunction;import org.apache.flink.util.Collector;import java.util.ArrayList;import java.util.List;/*** 列表状态*/public class $02_OperatorStateBroadCast {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);DataStreamSource<String> inputDS = env.socketTextStream("hadoop162", 9999);DataStreamSource<String> controlDS = env.socketTextStream("hadoop162", 8888);//TODO 1.将流广播出去MapStateDescriptor<String, String> broadcastStateDesc = new MapStateDescriptor<>("broadcast-state", Types.STRING, Types.STRING);BroadcastStream<String> controlBS = controlDS.broadcast(broadcastStateDesc);//TODO 2.连接主流和广播流BroadcastConnectedStream<String, String> inputControlBCS = inputDS.connect(controlBS);//选择做一个keyby,因为connect最好结合keyby使用//TODO 3.调用算子处理inputControlBCS.process(new BroadcastProcessFunction<String, String, Object>() {/*** 处理主流的数据* @param value* @param ctx* @param out* @throws Exception*/@Overridepublic void processElement(String value, ReadOnlyContext ctx, Collector<Object> out) throws Exception {//TODO 5.获取广播状态,进行相应处理ReadOnlyBroadcastState<String, String> broadcastState = ctx.getBroadcastState(broadcastStateDesc);String b = broadcastState.get("a");if("1".equals(b)){out.collect("走1的逻辑");}else if("0".equals(b)){out.collect("走0的逻辑");}else{out.collect("非法格式");}}/*** 处理广播流的数据* @param value* @param ctx* @param out* @throws Exception*/@Overridepublic void processBroadcastElement(String value, Context ctx, Collector<Object> out) throws Exception {//TODO 4.处理广播流,给广播状态赋值BroadcastState<String, String> broadcastState = ctx.getBroadcastState(broadcastStateDesc);//给广播状态赋值broadcastState.put("a",value);}}).print();env.execute();}}
3.键控状态的使用
一.介绍
键控状态是根据输入数据流中定义的键(key)来维护和访问的
Flink为每一个键值维护一个状态实例,并将具有相同键的所有数据,都分区到同一个算子任务中,这个任务会维护和处理这个key对应的状态,当任务处理一条数据时,它会自动将当前状态的访问权限限定为当前数据的key,因此具有相同key的所有数据都会访问相同的状态
KeyedState很类似于一个分布式的key-value map数据结构,只能用于KeyedStream(KeyBy算子之后)
package com.atguigu.flink.day06;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.state.*;import org.apache.flink.api.common.typeinfo.Types;import org.apache.flink.configuration.Configuration;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.KeyedProcessFunction;import org.apache.flink.util.Collector;import java.time.Duration;import java.util.ArrayList;import java.util.HashMap;public class $03_KeyedStateDemo1 {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}}).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(4)).withTimestampAssigner(new SerializableTimestampAssigner<WaterSensor>() {@Overridepublic long extractTimestamp(WaterSensor element, long recordTimestamp) {return element.getTs() * 1000;}}));sensorDS.keyBy(sensor-> sensor.getId()).process(new KeyedProcessFunction<String, WaterSensor, String>() {//TODO 1.声明状态ValueState<String> valueState;ListState<Integer> listState;MapState<String,Long> mapState;@Overridepublic void open(Configuration parameters) throws Exception {//TODO 2.在open方法里,通过运行上下文,初始化状态valueState = getRuntimeContext().getState(new ValueStateDescriptor<String>("value-state", Types.STRING));listState = getRuntimeContext().getListState(new ListStateDescriptor<Integer>("list-state", Types.INT));mapState = getRuntimeContext().getMapState(new MapStateDescriptor<String,Long>("map-state", Types.STRING,Types.LONG));}@Overridepublic void processElement(WaterSensor value, Context ctx, Collector<String> out) throws Exception {//TODO 3.使用状态String value1 = valueState.value();//取出状态值valueState.update("haha");//更新状态值valueState.clear();//清空状态值//ListState的APIIterable<Integer> integers = listState.get();//取出状态值listState.update(new ArrayList<Integer>());//更新状态值listState.add(1);//添加单个值到List中listState.addAll(new ArrayList<Integer>());//添加整个list,不会覆盖listState.clear();//清空状态//MapState的API(参考HashMap操作)mapState.put("1",1L);mapState.get("1");mapState.remove("1");mapState.contains("1");mapState.putAll(new HashMap<>());mapState.keys();mapState.values();mapState.clear();}}).print();env.execute();}}
package com.atguigu.flink.day06;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.state.*;import org.apache.flink.api.common.typeinfo.Types;import org.apache.flink.configuration.Configuration;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.KeyedProcessFunction;import org.apache.flink.util.Collector;import java.time.Duration;import java.util.ArrayList;import java.util.HashMap;/*** 键控状态注意:* 总体原则:各组管各自的---->包括更新,清空* 存数据的时候,不同组互不影响* clear的时候,哪个组调用的,只会清空自己组的*/public class $04_KeyedStateDemo2 {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}}).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(4)).withTimestampAssigner(new SerializableTimestampAssigner<WaterSensor>() {@Overridepublic long extractTimestamp(WaterSensor element, long recordTimestamp) {return element.getTs() * 1000L;}}));sensorDS.keyBy(sensor-> sensor.getId()).process(new KeyedProcessFunction<String, WaterSensor, String>() {ValueState<Integer> lastVC;@Overridepublic void open(Configuration parameters) throws Exception {lastVC = getRuntimeContext().getState(new ValueStateDescriptor<Integer>("last-vc",Types.INT));}@Overridepublic void processElement(WaterSensor value, Context ctx, Collector<String> out) throws Exception {ctx.timerService().registerEventTimeTimer(5000L);System.out.println("上一条的水位值="+lastVC.value());lastVC.update(value.getVc());System.out.println("当前水位值="+value.getVc());}@Overridepublic void onTimer(long timestamp, OnTimerContext ctx, Collector<String> out) throws Exception {System.out.println("我被"+ ctx.getCurrentKey() + "触发了");lastVC.clear();}}).print();env.execute();}}
二.ReduceState
需求:计算每个传感器的水位和
package com.atguigu.flink.day06;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.functions.ReduceFunction;import org.apache.flink.api.common.state.ReducingState;import org.apache.flink.api.common.state.ReducingStateDescriptor;import org.apache.flink.api.common.typeinfo.Types;import org.apache.flink.configuration.Configuration;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.KeyedProcessFunction;import org.apache.flink.util.Collector;import java.time.Duration;/*** 需求:计算各水位器的水位和*/public class $06_ReduceState {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}}).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(4)).withTimestampAssigner(new SerializableTimestampAssigner<WaterSensor>() {@Overridepublic long extractTimestamp(WaterSensor element, long recordTimestamp) {return element.getTs() * 1000L;}}));sensorDS.keyBy(sensor-> sensor.getId()).process(new KeyedProcessFunction<String, WaterSensor, String>() {ReducingState<Integer> vcSumState;@Overridepublic void open(Configuration parameters) throws Exception {vcSumState = getRuntimeContext().getReducingState(new ReducingStateDescriptor<Integer>("vcSumState",new ReduceFunction<Integer>(){@Overridepublic Integer reduce(Integer value1, Integer value2) throws Exception {return value1 + value2;}},Types.INT));}@Overridepublic void processElement(WaterSensor value, Context ctx, Collector<String> out) throws Exception {vcSumState.add(value.getVc());out.collect(vcSumState.get().toString());}}).print();env.execute();}}
三.AggregatingState
需求:求每个传感器的水位均值
package com.atguigu.flink.day06;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.AggregateFunction;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.state.AggregatingState;import org.apache.flink.api.common.state.AggregatingStateDescriptor;import org.apache.flink.api.common.typeinfo.Types;import org.apache.flink.configuration.Configuration;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.KeyedProcessFunction;import org.apache.flink.util.Collector;import org.apache.flink.api.java.tuple.Tuple2;import java.time.Duration;/*** 需求:计算各水位器的水位均值*/public class $07_AggregatingState {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}}).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(4)).withTimestampAssigner(new SerializableTimestampAssigner<WaterSensor>() {@Overridepublic long extractTimestamp(WaterSensor element, long recordTimestamp) {return element.getTs() * 1000L;}}));sensorDS.keyBy(sensor-> sensor.getId()).process(new KeyedProcessFunction<String, WaterSensor, String>() {AggregatingState<Integer,Double> vcSumAndCountState;@Overridepublic void open(Configuration parameters) throws Exception {vcSumAndCountState = getRuntimeContext().getAggregatingState(new AggregatingStateDescriptor<Integer, Tuple2<Integer,Integer>, Double>("vcSumAndCountState",new AggregateFunction<Integer, Tuple2<Integer,Integer>, Double>() {@Overridepublic Tuple2<Integer, Integer> createAccumulator() {return Tuple2.of(0,0);}@Overridepublic Tuple2<Integer, Integer> add(Integer value, Tuple2<Integer, Integer> accumulator) {//将水位加上去,将数量加1Integer lastSum = accumulator.f0;Integer lastCount = accumulator.f1;//将新的结果返回,封装成Tuple2返回return Tuple2.of(lastSum + value,lastCount+1);}@Overridepublic Double getResult(Tuple2<Integer, Integer> accumulator) {return accumulator.f0 * 1D / accumulator.f1;}@Overridepublic Tuple2<Integer, Integer> merge(Tuple2<Integer, Integer> a, Tuple2<Integer, Integer> b) {System.out.println("我merge了......");return null;}},Types.TUPLE(Types.INT, Types.INT)));}@Overridepublic void processElement(WaterSensor value, Context ctx, Collector<String> out) throws Exception {//将水位值放进状态里vcSumAndCountState.add(value.getVc());out.collect(vcSumAndCountState.get().toString());}}).print();env.execute();}}
4.状态练习
需求:监控水位传感器的水位值,如果水位值在5秒之内(event time)连续上升,则报警
提示:使用状态和定时器完成
package com.atguigu.flink.day06;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.MapFunction;import org.apache.flink.api.common.state.ValueState;import org.apache.flink.api.common.state.ValueStateDescriptor;import org.apache.flink.api.common.typeinfo.Types;import org.apache.flink.configuration.Configuration;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.KeyedProcessFunction;import org.apache.flink.util.Collector;import java.time.Duration;/****需求:监控水位传感器的水位值,如果水位值在5秒之内(event time)连续上升,则报警**/public class $04_KeyedStateDemo3 {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<WaterSensor> sensorDS = env.socketTextStream("hadoop162", 9999).map(new MapFunction<String, WaterSensor>() {@Overridepublic WaterSensor map(String value) throws Exception {String[] line = value.split(",");return new WaterSensor(line[0],Long.parseLong(line[1]),Integer.parseInt(line[2]));}}).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forMonotonousTimestamps().withTimestampAssigner(new SerializableTimestampAssigner<WaterSensor>() {@Overridepublic long extractTimestamp(WaterSensor element, long recordTimestamp) {return element.getTs() * 1000L;}}));sensorDS.keyBy(sensor-> sensor.getId()).process(new KeyedProcessFunction<String, WaterSensor, String>() {ValueState<Long> timeTsState;ValueState<Integer> lastVCState;@Overridepublic void open(Configuration parameters) throws Exception {timeTsState = getRuntimeContext().getState(new ValueStateDescriptor<Long>("timerTsState",Types.LONG));lastVCState = getRuntimeContext().getState(new ValueStateDescriptor<Integer>("lastVcState",Types.INT));}@Overridepublic void processElement(WaterSensor value, Context ctx, Collector<String> out) throws Exception {if(timeTsState.value()==null){//说明没有注册过,可以注册timeTsState.update(ctx.timestamp() + 5000L);ctx.timerService().registerEventTimeTimer(timeTsState.value());}//判断是上升还是下降//如果是上升,啥也不干if(value.getVc() < (lastVCState.value() == null ? 0 : lastVCState.value())){//如果是下降=>删除定时器,重新注册5s后的定时器ctx.timerService().deleteEventTimeTimer(timeTsState.value());timeTsState.update(ctx.timestamp() + 5000L);ctx.timerService().registerEventTimeTimer(timeTsState.value());}//无论是上升还是下降,都必须将自己的水位值存下来lastVCState.update(value.getVc());}@Overridepublic void onTimer(long timestamp, OnTimerContext ctx, Collector<String> out) throws Exception {out.collect(ctx.getCurrentKey()+"告警:检测到连续5s水位上涨,赶紧跑!");timeTsState.clear();}}).print();env.execute();}}
5.状态后端
状态后端主要负责两件事
- 本地(taskmanager)的状态管理
- 将检查点(checkpoint)状态写入远程存储
一.1.13之后版本的状态后端
- 本地状态位置
- 内存(TaskManager)
- 一个数据库 RocksDB
- 内嵌的,不需要我们单独安装
- 是一个k,v类型的数据库
- 存储的是序列化之后的数据, 读—>反序列化 写—>序列化
- 使用的是磁盘(数据先写入内存,刷写到磁盘,和HBase类似)
- checkpoint位置(对状态的备份)
- 内存(JobManager)
- 持久化的文件系统: HDFS
注意:使用RocksDB需要先导入依赖
<dependency><groupId>org.apache.flink</groupId><artifactId>flink-statebackend-rocksdb_${scala.binary.version}</artifactId><version>${flink.version}</version></dependency>
二.1.13之前的状态后端
1.13之前的状态后端分为三种,MemoryStateBackend(默认),FsStateBackend,RockedDBStateBackend
| 本地状态存哪里 | checkpoint存哪里(备份) | 使用场景 | |
|---|---|---|---|
| Memory | TaskManager的内存 | JobManager的内存 | 1.本地测试2.几乎无状态的作业3.不推荐在生产环境下使用 |
| Fs | TaskManager的内存 | HDFS | 1.常规使用状态的作业,例如分钟级别窗口聚合,join等2.需要开启HA作业3.可以应用在生产环境中 |
| RocksDB | RocksDB | HDFS | 1.超大状态的作业,例如天级的窗口聚合2.需要开启HA的作业3,对读写状态性能要求不高的作业4,可以使用在生产环境 |
三.代码示例
package com.atguigu.flink.day06;import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend;import org.apache.flink.contrib.streaming.state.RocksDBStateBackend;import org.apache.flink.runtime.state.filesystem.FsStateBackend;import org.apache.flink.runtime.state.hashmap.HashMapStateBackend;import org.apache.flink.runtime.state.memory.MemoryStateBackend;import org.apache.flink.runtime.state.storage.JobManagerCheckpointStorage;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;/*** 状态后端*/public class $08_StateBackend {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//开启checkpointenv.enableCheckpointing(5000L);/*** TODO 1.13版本开始的写法*///1.指定本地状态的类型env.setStateBackend(new HashMapStateBackend());//本地状态存在内存env.setStateBackend(new EmbeddedRocksDBStateBackend());//本地状态存在RocksDB//2.指定CheckPoint的存储位置env.getCheckpointConfig().setCheckpointStorage(new JobManagerCheckpointStorage());//checkPoint存在JM内存env.getCheckpointConfig().setCheckpointStorage("hdfs://hadoop162:8020/flink/ck");//checkPoint存在HDFS/*** TODO 1.13版本之前的写法*///1.Memoryenv.setStateBackend(new MemoryStateBackend());//2.FSenv.setStateBackend(new FsStateBackend("hdfs://hadoop162:8020/flink/ck"));//3.RocksDBenv.setStateBackend(new RocksDBStateBackend("hdfs://hadoop162:8020/flink/ck"));}}
第二章.Flink的容错机制
1.状态一致性
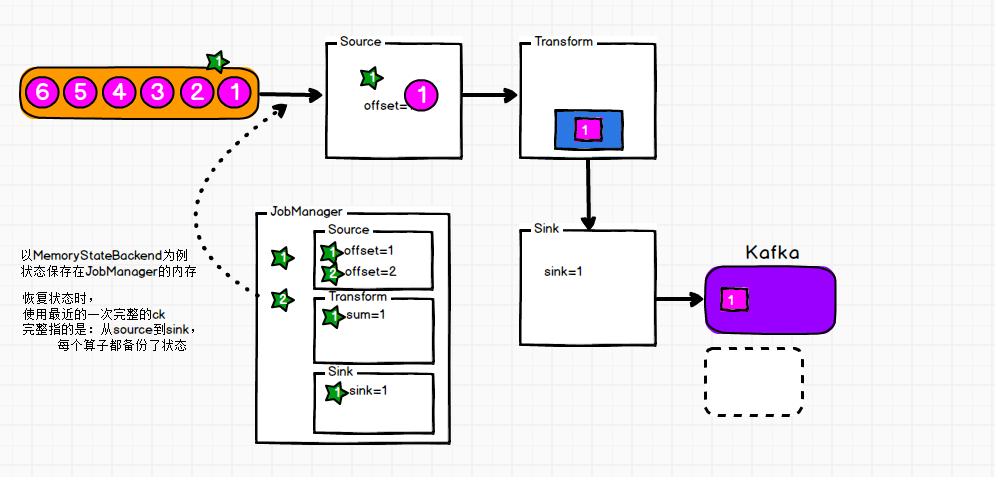
1.一致性级别在流处理中,一致性可以分为3个级别:at most once(最多一次):这其实是没有正确性保障搞得委婉说法--故障发生之后,计数结果可能丢失at least once(至少一次):这表示计数结果可能大于正确值,但绝不会小于正确值,也就是说,计数程序在发生故障时可能多算,但是绝不会少算exactly once(严格一次):这指的是系统保证在发生故障后的计数结果与正确值一致,既不多算也不少算Flink的一个重大价值在于,它即保证了exactly-once,又具有低延迟和高吞吐的处理能力
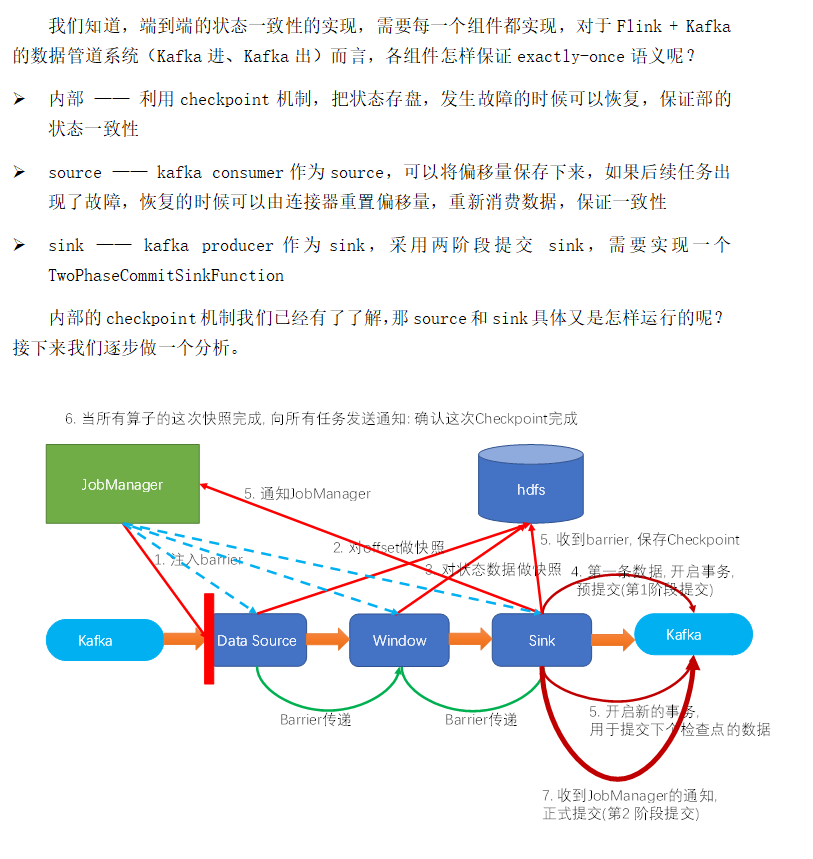
2.端到端的状态一致性目前我们看到的一致性保证都是由流处理器保证的,也就是说都是在Flink流处理器内部保证的,而在真实应用中,流处理器应用除了流处理器以外还包含了数据源(例如Kafka)和输出到持久化系统,整个端到端的一致性级别取决于所有组件中一致性最弱的组件Source端:需要外部源可重设数据的读取位置,Kafka Source具有这种特性,读取数据的时候可以指定offsetFlink内部:依赖checkpoint机制Sink端:需要保证故障恢复时,数据不会重复写入外部系统,有两种实现方式幂等写入:所谓幂等操作,是说一个操作,可以重复执行很多次,但只导致一次结果更改,也就是说,后面再重复执行就不起作用事务性写入需要构建事务来写入外部系统,构建的事务对应着checkpoint,等到checkpoint真正完成的时候,才把所有的结果写入sink系统中,对于事务性写入,具体又有两种实现方式,预写日志和两阶段提交
| Sink\Source | 不可重置 | 可重置 |
|---|---|---|
| 任意(Any) | at most once | at least once |
| 幂等 | at most once | Exactly-once(短暂恢复时会出现暂时不一致) |
| 预写日志(WAL) | at most once | at least once |
| 两阶段提交(2PC) | at most once | Exactly-once |
2.checkPoint与Barrier
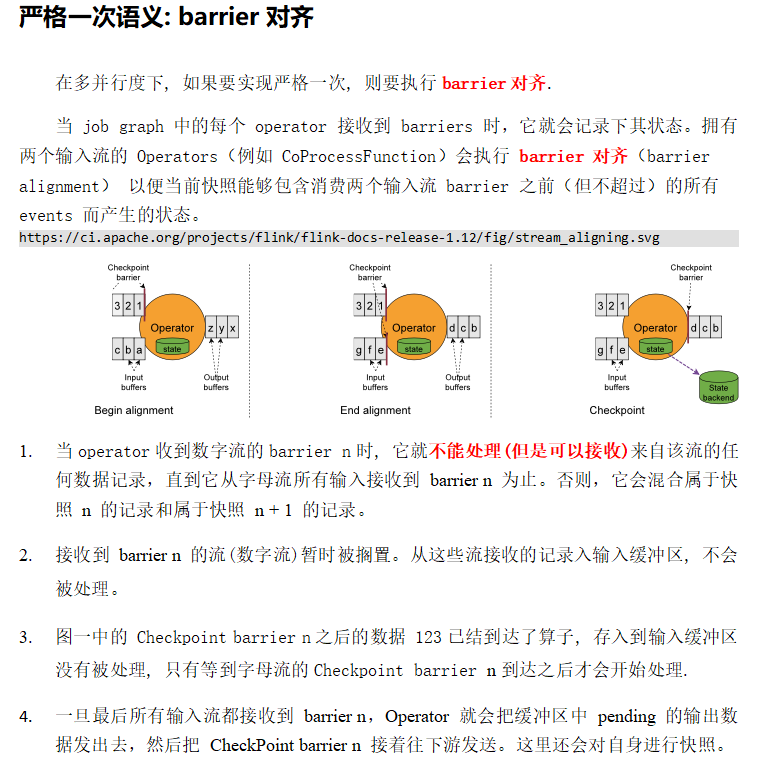
Checkpoint 使 Flink 的状态具有良好的容错性,通过 checkpoint 机制,Flink 可以对作业的状态和计算位置进行恢复。Flink 的 checkpoint 机制会和持久化存储进行交互,读写流与状态。一般需要:1.一个能够回放一段时间内数据的持久化数据源,例如持久化消息队列(例如 Apache Kafka、RabbitMQ、 Amazon Kinesis、 Google PubSub 等)或文件系统(例如 HDFS、 S3、 GFS、 NFS、 Ceph 等)。2.存放状态的持久化存储,通常为分布式文件系统(比如 HDFS、 S3、 GFS、 NFS、 Ceph 等)。流的barrier是Flink的Checkpoint中的一个核心概念. 多个barrier被插入到数据流中, 然后作为数据流的一部分随着数据流动(有点类似于Watermark).这些barrier不会跨越流中的数据.每个barrier会把数据流分成两部分: 一部分数据进入当前的快照 , 另一部分数据进入下一个快照 . 每个barrier携带着快照的id. barrier 不会暂停数据的流动, 所以非常轻量级. 在流中, 同一时间可以有来源于多个不同快照的多个barrier, 这个意味着可以并发的出现不同的快照.
3.Flink的检查点制作过程
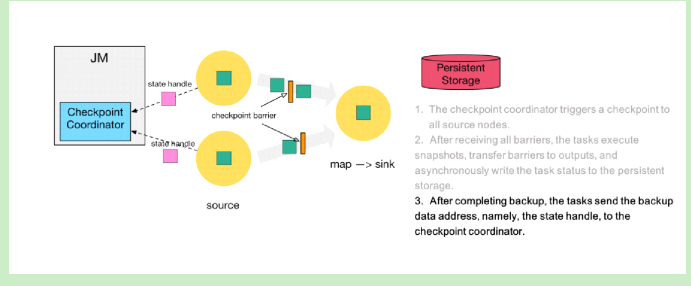
1.Checkpoint Coordinator 向所有 source 节点 trigger Checkpoint. 然后Source Task会在数据流中安插CheckPoint barrier
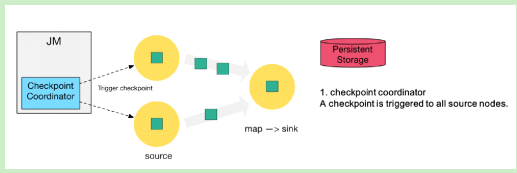
2.source 节点向下游广播 barrier,这个 barrier 就是实现 Chandy-Lamport 分布式快照算法的核心,下游的 task 只有收到所有进来的 barrier 才会执行相应的 Checkpoint(barrier对齐, 但是新版本有一种新的: barrier)
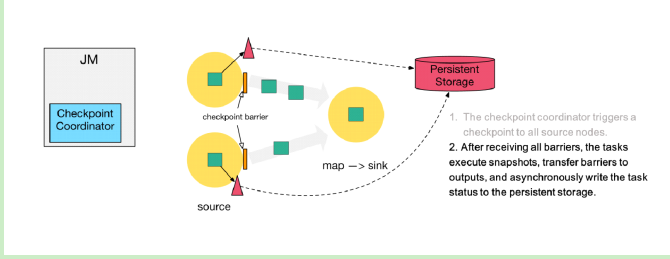
3.当 task 完成 state 备份后,会将备份数据的地址(state handle)通知给 Checkpoint coordinator。
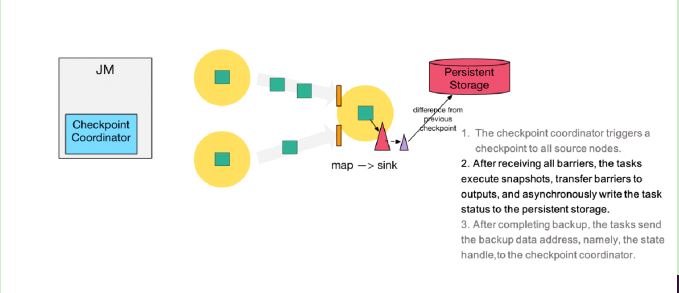
4.下游的 sink 节点收集齐上游两个 input 的 barrier 之后,会执行本地快照,这里特地展示了 RocksDB incremental Checkpoint 的流程,首先 RocksDB 会全量刷数据到磁盘上(红色大三角表示),然后 Flink 框架会从中选择没有上传的文件进行持久化备份(紫色小三角)
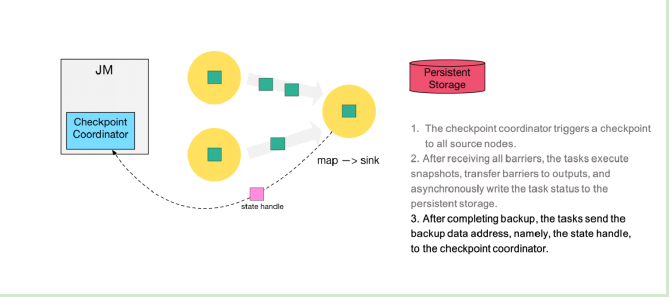
5.同样的,sink 节点在完成自己的 Checkpoint 之后,会将 state handle 返回通知 Coordinator
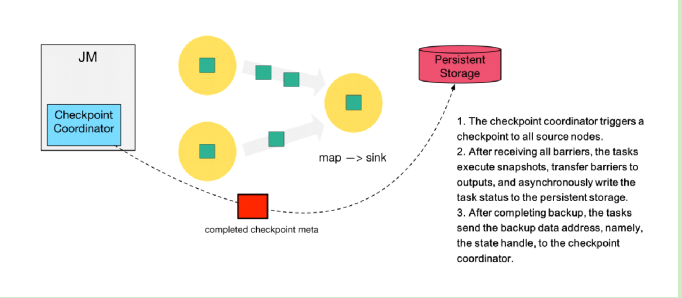
6.最后,当 Checkpoint coordinator 收集齐所有 task 的 state handle,就认为这一次的 Checkpoint 全局完成了,向持久化存储中再备份一个 Checkpoint meta 文件。
4.严格一次语义(barrier对齐)
5.至少一次语义:barrier不对齐
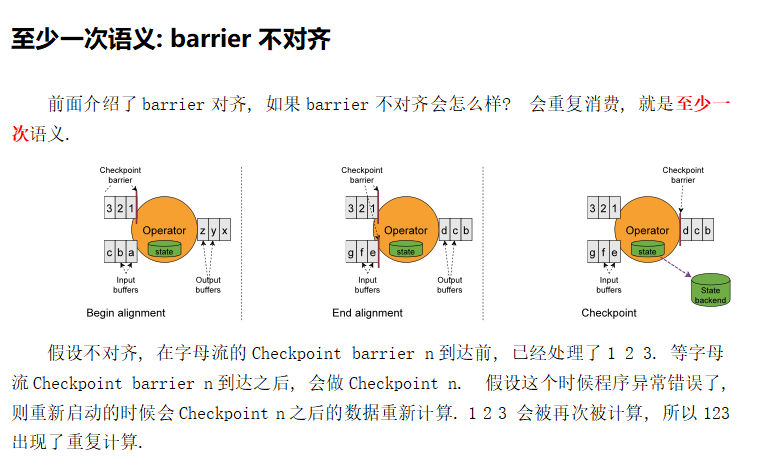
6.SavePoint
- Flink 还提供了可以自定义的镜像保存功能,就是保存点(savepoints)
- 原则上,创建保存点使用的算法与检查点完全相同,因此保存点可以认为就是具有一些额外元数据的检查点
- Flink不会自动创建保存点,因此用户(或外部调度程序)必须明确地触发创建操作
- 保存点是一个强大的功能。除了故障恢复外,保存点可以用于:有计划的手动备份,更新应用程序,版本迁移,暂停和重启应用,等等
| Savepoint | Checkpoint |
|---|---|
| Savepoint是由命令触发, 由用户创建和删除 | Checkpoint被保存在用户指定的外部路径中, flink自动触发 |
| 保存点存储在标准格式存储中,并且可以升级作业版本并可以更改其配置。 | 当作业失败或被取消时,将保留外部存储的检查点 |
| 用户必须提供用于还原作业状态的保存点的路径。 | 用户必须提供用于还原作业状态的检查点的路径。 如果是flink的自动重启, 则flink会自动找到最后一个完整的状态 |
7.Kafka+Flink+Kafka 实现端到端严格一次
8.checkPoint config
package com.atguigu.flink.day06;import org.apache.flink.api.common.restartstrategy.RestartStrategies;import org.apache.flink.api.common.time.Time;import org.apache.flink.streaming.api.CheckpointingMode;import org.apache.flink.streaming.api.environment.CheckpointConfig;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;/*** CheckPoint 配置*/public class $09_CheckPointConfig {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//TODO checkpoint配置//1.开启checkpoint:生产上建议分钟级,3~10分env.enableCheckpointing(5000L);CheckpointConfig ckConfig = env.getCheckpointConfig();//2.指定一致性级别:默认就是精准一次ckConfig.setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE);//3.设置两个checkpoint之间的最小间隔(上一次的结束到下一次的开始)ckConfig.setMinPauseBetweenCheckpoints(3000L);//4.设置超时时间,如果超时了,那么就失败了ckConfig.setCheckpointTimeout(5000L);//5.设置最大失败的次数ckConfig.setTolerableCheckpointFailureNumber(3);//6.设置job被cancel时,也会保留checkpointckConfig.enableExternalizedCheckpoints(CheckpointConfig.ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION);//TODO Task FailOver:Task重试策略/*** 固定延迟重启策略:第一个参数:重试次数 第二个参数:重试的间隔*/env.setRestartStrategy(RestartStrategies.fixedDelayRestart(5,3000L));/*** 失败率重试策略:* 第一个参数:在指定时间范围内最大失败次数* 第二个参数:指定的时间范围* 第三个参数:重试的间隔*/env.setRestartStrategy(RestartStrategies.failureRateRestart(5, Time.seconds(5),Time.seconds(3)));}}

若有收获,就点个赞吧
0 人点赞


