第一章.Flink核心架构
1.运行架构
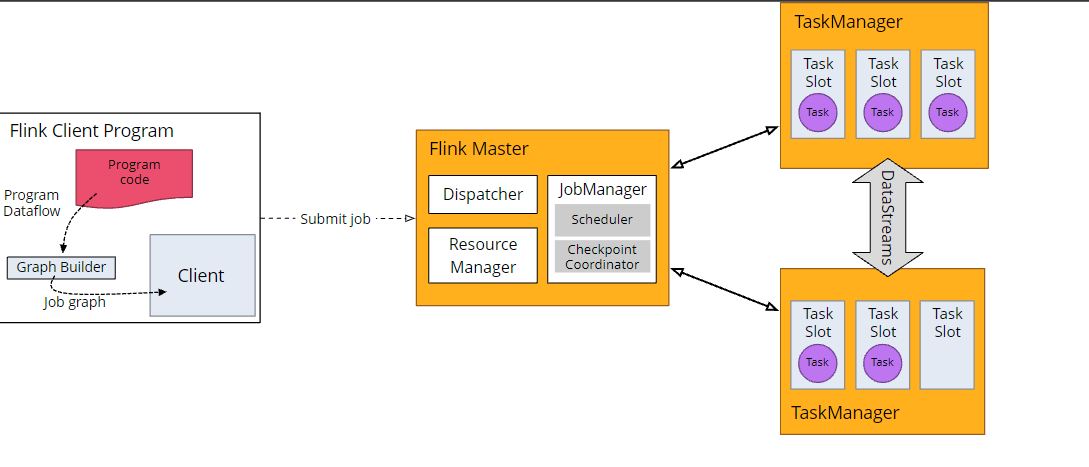
Flink运行时包含2种进程:1个JobManager和至少一个TaskManager
# 客户端严格上说, 客户端不是运行和程序执行的一部分, 而是用于准备和发送dataflow到JobManager. 然后客户端可以断开与JobManager的连接(detached mode), 也可以继续保持与JobManager的连接(attached mode)客户端作为触发执行的java或者scala代码的一部分运行, 也可以在命令行运行:bin/flink run ...
# JobManager控制一个应用程序执行的主进程,也就是说,每个应用程序都会被一个的JobManager所控制执行。JobManager会先接收到要执行的应用程序,这个应用程序会包括:作业图(JobGraph)、逻辑数据流图(logical dataflow graph)和打包了所有的类、库和其它资源的JAR包。JobManager会把JobGraph转换成一个物理层面的数据流图,这个图被叫做“执行图”(ExecutionGraph),包含了所有可以并发执行的任务。JobManager会向资源管理器(ResourceManager)请求执行任务必要的资源,也就是任务管理器(TaskManager)上的插槽(slot)。一旦它获取到了足够的资源,就会将执行图分发到真正运行它们的TaskManager上。而在运行过程中,JobManager会负责所有需要中央协调的操作,比如说检查点(checkpoints)的协调。JobManager包含ResourceManager,Dispatcher和JobMaster
# ResourceManager负责资源的管理,在整个 Flink 集群中只有一个 ResourceManager. 注意这个ResourceManager不是Yarn中的ResourceManager, 是Flink中内置的, 只是赶巧重名了而已.主要负责管理任务管理器(TaskManager)的插槽(slot),TaskManger插槽是Flink中定义的处理资源单元。当JobManager申请插槽资源时,ResourceManager会将有空闲插槽的TaskManager分配给JobManager。如果ResourceManager没有足够的插槽来满足JobManager的请求,它还可以向资源提供平台发起会话,以提供启动TaskManager进程的容器。另外,ResourceManager还负责终止空闲的TaskManager,释放计算资源。
# Dispatcher负责接收用户提供的作业,并且负责为这个新提交的作业启动一个新的JobMaster 组件. Dispatcher也会启动一个Web UI,用来方便地展示和监控作业执行的信息。Dispatcher在架构中可能并不是必需的,这取决于应用提交运行的方式。
# JobMasterJobMaster负责管理单个JobGraph的执行.多个Job可以同时运行在一个Flink集群中, 每个Job都有一个自己的JobMaster
# TaskManagerFlink中的工作进程。通常在Flink中会有多个TaskManager运行,每一个TaskManager都包含了一定数量的插槽(slots)。插槽的数量限制了TaskManager能够执行的任务数量。启动之后,TaskManager会向资源管理器注册它的插槽;收到资源管理器的指令后,TaskManager就会将一个或者多个插槽提供给JobManager调用。JobManager就可以向插槽分配任务(tasks)来执行了。在执行过程中,一个TaskManager可以跟其它运行同一应用程序的TaskManager交换数据。
2.核心概念
一.TaskManager与Slots

Flink中每一个worker(TaskManager)都是一个JVM进程,它可能会在独立的线程上执行一个Task。为了控制一个worker能接收多少个task,worker通过Task Slot来进行控制(一个worker至少有一个Task Slot)。这里的Slot如何来理解呢?很多的文章中经常会和Spark框架进行类比,将Slot类比为Core,其实简单这么类比是可以的,可实际上,可以考虑下,当Spark申请资源后,这个Core执行任务时有可能是空闲的,但是这个时候Spark并不能将这个空闲下来的Core共享给其他Job使用,所以这里的Core是Job内部共享使用的。接下来我们再回想一下,之前在Yarn Session-Cluster模式时,其实是可以并行执行多个Job的,那如果申请两个Slot,而执行Job时,只用到了一个,剩下的一个怎么办?那我们自认而然就会想到可以将这个Slot给并行的其他Job,对吗?所以Flink中的Slot和Spark中的Core还是有很大区别的。每个task slot表示TaskManager拥有资源的一个固定大小的子集。假如一个TaskManager有三个slot,那么它会将其管理的内存分成三份给各个slot。资源slot化意味着一个task将不需要跟来自其他job的task竞争被管理的内存,取而代之的是它将拥有一定数量的内存储备。需要注意的是,这里不会涉及到CPU的隔离,slot目前仅仅用来隔离task的受管理的内存。
二.Parallelism(并行度)
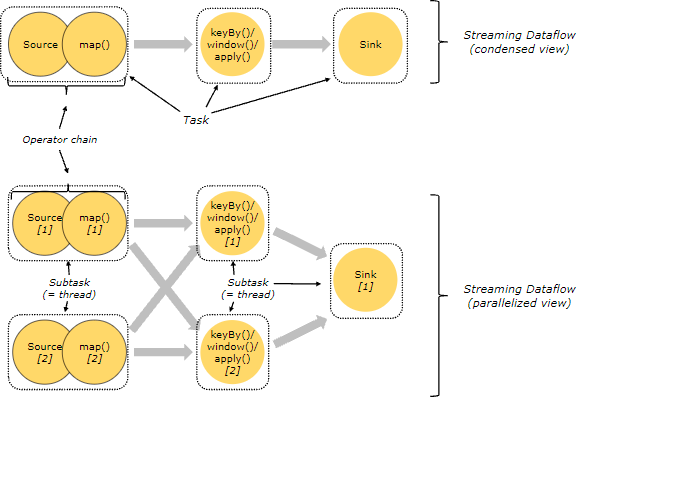
一个特定算子的子任务(subtask)的个数被称之为这个算子的并行度(parallelism),一般情况下,一个流程序的并行度,可以认为就是其所有算子中最大的并行度。一个程序中,不同的算子可能具有不同的并行度。Stream在算子之间传输数据的形式可以是one-to-one(forwarding)的模式也可以是redistributing的模式,具体是哪一种形式,取决于算子的种类。
1. One to Onestream(比如在source和map operator之间)维护着分区以及元素的顺序。那意味着flatmap 算子的子任务看到的元素的个数以及顺序跟source 算子的子任务生产的元素的个数、顺序相同,map、fliter、flatMap等算子都是one-to-one的对应关系。类似于spark中的窄依赖2. Redistributingstream(map()跟keyBy/window之间或者keyBy/window跟sink之间)的分区会发生改变。每一个算子的子任务依据所选择的transformation发送数据到不同的目标任务。例如,keyBy()基于hashCode重分区、broadcast和rebalance会随机重新分区,这些算子都会引起redistribute过程,而redistribute过程就类似于Spark中的shuffle过程。类似于spark中的宽依赖
三.Task与SubTask
一个算子就是一个Task,一个算子的并行度是几,这个Task就有几个SubTask
四.Operator Chains(任务链)
相同并行度的one to one操作,Flink将这样相连的算子链接在一起形成一个task,原来的算子成为里面的一部分。 每个subtask被一个线程执行.将算子链接成task是非常有效的优化:它能减少线程之间的切换和基于缓存区的数据交换,在减少时延的同时提升吞吐量。链接的行为可以在编程API中进行指定。
五.ExecutionGraph(执行图)
由Flink程序直接映射成的数据流图是StreamGraph,也被称为逻辑流图,因为它们表示的是计算逻辑的高级视图。为了执行一个流处理程序,Flink需要将逻辑流图转换为物理数据流图(也叫执行图),详细说明程序的执行方式。Flink 中的执行图可以分成四层:StreamGraph -> JobGraph -> ExecutionGraph -> Physical Graph。
1. StreamGraph是根据用户通过 Stream API 编写的代码生成的最初的图。用来表示程序的拓扑结构。2. JobGraphStreamGraph经过优化后生成了 JobGraph,是提交给 JobManager 的数据结构。主要的优化为: 将多个符合条件的节点 chain 在一起作为一个节点,这样可以减少数据在节点之间流动所需要的序列化/反序列化/传输消耗。3. ExecutionGraphJobManager 根据 JobGraph 生成ExecutionGraph。ExecutionGraph是JobGraph的并行化版本,是调度层最核心的数据结构。4. Physical GraphJobManager 根据 ExecutionGraph 对 Job 进行调度后,在各个TaskManager 上部署 Task 后形成的“图”,并不是一个具体的数据结构。2个并发度(Source为1个并发度)的 SocketTextStreamWordCount 四层执行图的演变过程env.socketTextStream().flatMap(…).keyBy(0).sum(1).print()
3.提交流程
一.通用提交流程

二.yarn-cluster提交流程per-job
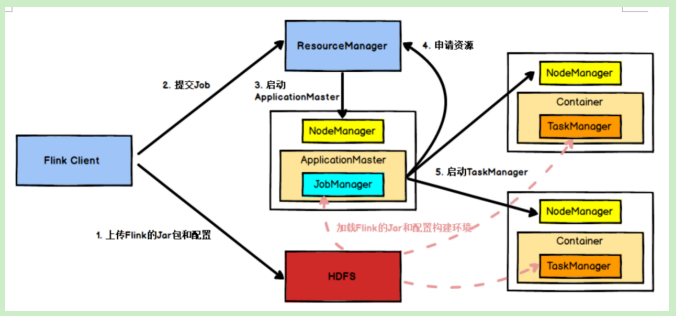
- Flink任务提交后,Client向HDFS上传Flink的Jar包和配置
- 向Yarn ResourceManager提交任务,ResourceManager分配Container资源
- 通知对应的NodeManager启动ApplicationMaster,ApplicationMaster启动后加载Flink的 Jar包和配置构建环境,然后启动JobManager
- ApplicationMaster向ResourceManager申请资源启动TaskManager
ResourceManager分配Container资源后,由ApplicationMaster通知资源所在节点的
NodeManager启动TaskManager
- NodeManager加载Flink的Jar包和配置构建环境并启动TaskManager
- TaskManager启动后向JobManager发送心跳包,并等待JobManager向其分配任务。
第二章.Flink流处理核心编程
1.准备工作
一.pom.xml
<!-- https://mvnrepository.com/artifact/org.projectlombok/lombok --><dependency><groupId>org.projectlombok</groupId><artifactId>lombok</artifactId><version>1.18.16</version><scope>provided</scope></dependency><dependency><groupId>org.apache.hadoop</groupId><artifactId>hadoop-client</artifactId><version>3.1.3</version><scope>provided</scope></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-kafka_2.12</artifactId><version>1.13.1</version></dependency>
二.提供一个JavaBean(WaterSensor)类方便展示
package com.atguigu.flink.day02.pojo;import lombok.AllArgsConstructor;import lombok.Data;import lombok.NoArgsConstructor;/*** 水位传感器:用于接收水位数据** id:传感器编号* ts:时间戳* vc:水位*/@Data@NoArgsConstructor@AllArgsConstructorpublic class WaterSensor {private String id;private Long ts;private Integer vc;}
2.Source
Flink框架可以从不同的来源获取数据,将数据提交给框架进行处理,我们将获取数据的来源称之为数据源(Source)
一.从Java的集合中读取数据
package com.atguigu.flink.day02.source;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import java.util.Arrays;import java.util.List;/*** 从java的集合中读取数据*/public class Flink_Source_Collection {public static void main(String[] args) throws Exception {List<WaterSensor> waterSensors = Arrays.asList(new WaterSensor("ws001", 1111111L, 45),new WaterSensor("ws002", 2222222L, 45),new WaterSensor("ws003", 3333333L, 45));//创建执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);env.fromCollection(waterSensors).print();env.fromElements(new WaterSensor("ws001", 1111111L, 45),new WaterSensor("ws002", 2222222L, 45),new WaterSensor("ws003", 3333333L, 45)).print();env.execute();}}
二.从文件读取数据
package com.atguigu.flink.day02.source;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;/*** 从文件中读取数据*/public class Flink_Source_File {public static void main(String[] args) throws Exception {//创建执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);env.readTextFile("hdfs://hadoop102:9820/flink/data/word.txt").print();env.execute();}}
三.从kafka中读取数据
package com.atguigu.flink.day02.source;import org.apache.flink.api.common.serialization.SimpleStringSchema;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;import org.apache.flink.streaming.util.serialization.JSONKeyValueDeserializationSchema;import java.util.Properties;//{"id":1001,"name":"zhangsan"}public class Flink_Source_Kafka {public static void main(String[] args) throws Exception {//获取执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);Properties properties = new Properties();properties.setProperty("bootstrap.servers","hadoop102:9092,hadoop103:9092,hadoop104:9092");properties.setProperty("group.id","Flink_Source_Kafka");properties.setProperty("auto.offset.reset","latest");//env.addSource(new FlinkKafkaConsumer<>("first",new SimpleStringSchema(),properties)).print();env.addSource(new FlinkKafkaConsumer<>("first",new JSONKeyValueDeserializationSchema(false),properties)).print();env.execute();}}
四.自定义Source
package com.atguigu.flink.day02.source;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.source.SourceFunction;import java.io.BufferedReader;import java.io.InputStream;import java.io.InputStreamReader;import java.net.Socket;import java.nio.charset.StandardCharsets;/*** 自定义source* //sensor1 1607527992000 20*/public class Flink_Source_Custom {public static void main(String[] args) throws Exception {//获取执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.addSource(new MySocketSource("hadoop102",9999)).print();env.execute();}static class MySocketSource implements SourceFunction<WaterSensor>{String host;Integer port;boolean flag = true;public MySocketSource(String host, Integer port) {this.host = host;this.port = port;}/*** 数据生产的代码,ctx就是用来放我们的数据的* @param ctx* @throws Exception*/@Overridepublic void run(SourceContext<WaterSensor> ctx) throws Exception {Socket socket = new Socket(host,port);InputStream inputStream = socket.getInputStream();InputStreamReader inputStreamReader = new InputStreamReader(inputStream, StandardCharsets.UTF_8);BufferedReader bufferedReader = new BufferedReader(inputStreamReader);String line = bufferedReader.readLine();while(line != null && flag){String[] data = line.split(" ");ctx.collect(new WaterSensor(data[0],Long.valueOf(data[1]),Integer.valueOf(data[2])));line = bufferedReader.readLine();}}/*** 程序结束的时候进行调用,或者是进行外部调用来停止整个流*/@Overridepublic void cancel() {flag = false;}}}
3.Transform
转换算子可以把一个或多个DataStream转成一个新的DataStream,程序可以把多个复杂的转换组合成复杂的数据流拓扑
一.map
作用:将数据流中的数据进行转换,形成新的数据流,消费一个元素并产生一个元素
package com.atguigu.flink.day02.transform;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;/*** 使用map算子将数字转换为数字的平方*/public class $01_MapFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);DataStreamSource<Integer> ds = env.fromElements(1, 2, 3, 4);ds.map(ele -> ele * ele).print();env.execute();}}
二.RichMap
package com.atguigu.flink.day02.transform;import org.apache.flink.api.common.functions.RichMapFunction;import org.apache.flink.configuration.Configuration;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;/*** 所有Flink函数类都有其Rich版本,它与常规函数的不同在于,可以获取运行环境的上下文,并拥有一些生命周期方法,所以可以实现更复杂的功能,也* 就意味着提供了更多的,丰富的功能,例如:RichMapFunction*/public class $02_RichMapFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);DataStreamSource<Integer> ds = env.fromElements(1, 2, 3, 4);ds.map(new RichMapFunction<Integer, Integer>() {@Overridepublic void open(Configuration parameters) throws Exception {/*** 一般可以在open方法中,创建一个数据库的连接* 算子的并行度为几,那么open方法就会执行几次,close与open类似*/System.out.println("$02_RichMapFunction.open");}@Overridepublic void close() throws Exception {//一般可以在close方法中,可以归还一个数据库连接System.out.println("$02_RichMapFunction.close");}@Overridepublic Integer map(Integer value) throws Exception {System.out.println("$02_RichMapFunction.map");return value * value;}}).print();env.execute();}}
三.FlatMap
消费一个元素并产生零个或多个元素
package com.atguigu.flink.day02.transform;import org.apache.flink.api.common.typeinfo.Types;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.util.Collector;/*** 需求:使用flatmap算子将数字转换为数字,数字的平方,数字的立方并重新放回流中*/public class $03_FlatMapFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);DataStreamSource<Integer> ds = env.fromElements(1, 2, 3, 4);SingleOutputStreamOperator<Integer> results = ds.flatMap((Integer ele, Collector<Integer> out) -> {out.collect(ele);out.collect(ele * ele);out.collect(ele * ele * ele);}).returns(Types.INT);results.print();env.execute();}}
四.Filter
根据指定的规则将满足条件(true)的数据保留,不满足条件(false)的数据丢弃
package com.atguigu.flink.day02.transform;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;/*** 需求:使用Filter算子将流中的全部偶数取出*/public class $04_FilterFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);DataStreamSource<Integer> ds = env.fromElements(1, 2, 3, 4);ds.filter(ele -> ele % 2 ==0).print();env.execute();}}
五.KeyBy
将流中的数据分到不同的分区(并行度)中,具有相同key的元素会分到同一个分区中,一个分区中可以有多个不同的key,在内部是使用key的hash分区来实现的
package com.atguigu.flink.day02.transform;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;public class $05_KeyByFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);DataStreamSource<Integer> ds = env.fromElements(1, 2, 3, 4, 5, 6, 7, 8, 9);ds.keyBy(ele -> {if(ele % 2 ==0){return "偶数";}else{return "奇数";}}).print();env.execute();}}
六.shuffle
将流中的元素随机打乱,对同一组数据,每次执行得到的结果都不同
package com.atguigu.flink.day02.transform;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;/*** shuffle算子随机打散流中元素*/public class $06_ShuffleFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);DataStreamSource<Integer> ds = env.fromElements(1, 2, 3, 4, 5, 6, 7, 8, 9);ds.shuffle().print();env.execute();}}
七.connect
在某些情况下,我们需要将两个不同来源的数据流进行连接,实现数据匹配,比如订单支付和第三方交易信息,这两个信息的数据就来自于不同数据源,连接后,将订单支付和第三方交易信息进行对账,此时,才能算真正的支付完成
Flink中的connect算子可以连接两个保持他们类型的数据流,两个数据流被connect之后,只是被放在了同一个流中,内部依然保持各自的数据和形式不发生任何变化,两个流相互独立
package com.atguigu.flink.day02.transform;import org.apache.flink.streaming.api.datastream.ConnectedStreams;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.co.CoMapFunction;/*** 需求:连接两个不同的流* 两个流存储的数据类型可以不同* 只是机械的合并在一起,内部仍然是分离的2个流* 只能2个流进行connect,不能有第三个参与*/public class $07_ConnectFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);DataStreamSource<Integer> ds1 = env.fromElements(1, 2, 3, 4);DataStreamSource<String> ds2 = env.fromElements("a", "b", "c");ConnectedStreams<Integer, String> connect = ds1.connect(ds2);connect.map(new CoMapFunction<Integer, String, String>() {@Overridepublic String map1(Integer value) throws Exception {return value + ":是数字";}@Overridepublic String map2(String value) throws Exception {return value + ":是字母";}}).print();env.execute();}}
八.union
package com.atguigu.flink.day02.transform;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;/*** connect与union的区别* Union之前两个或多个流的类型必须是一样的,connect可以不一样* connect只能操作两个流,union可以操作多个*/public class $08_UnionFunction {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(2);DataStreamSource<Integer> ds1 = env.fromElements(1, 2, 3, 4);DataStreamSource<Integer> ds2 = env.fromElements(5, 6, 7, 8);DataStreamSource<Integer> ds3 = env.fromElements(9, 10, 11, 12);DataStreamSource<String> ds4 = env.fromElements("a", "b", "c");ds1.union(ds2).union(ds3).print();env.execute();}}

若有收获,就点个赞吧
0 人点赞


