第一章.Flink简介
1.初识Flink
# Flink起源于Stratosphere项目,Stratosphere是2010-2014年由三所地处柏林的大学和欧洲的其他大学共同进行的研究项目,2014年4月Stratosphere的代码被复制并捐赠给了Apache软件基金会,参加这个孵化项目的初始成员是Stratosphere系统的核心开发人员,2014年12月,Flink一跃成为Apache软件基金会的顶级项目# 在德语中Flink一词表示快速和灵巧,项目采用一只松鼠的彩色图案作为logo,这不仅是因为松鼠具有快速和灵巧的特点,还因为柏林的松鼠有一种迷人的红棕色,而Flink的松鼠的logo拥有可爱的尾巴,尾巴的颜色与Apache软件基金会的logo颜色相呼应,也就是说,这是一只Apache风格的松鼠# Flink项目的理念是"Apache Flink是分布式,高性能,随时可用以及准确的流式处理应用程序打造的开源流处理框架"# Apache Flink是一个框架和分布式处理引擎,用于对无界和有界的数据进行有状态计算,Flink被设计在所有常见的集群环境中运行,以内存执行速度和任意规模来执行运算

2.Flink的重要特点
一.事件驱动型(Event-driven)
# 事件驱动型应用是一类具有状态的应用,它从一个事件或多个事件流提取数据,并根据到来的事件触发计算,状态更新或其他外部操作,比较典型的就是以kafka为代表的消息队列几乎都是事件驱动型应用,Flink的计算也是事件驱动型
二.流(Flink)与批(Spark)的世界观
# 批处理的特点是有界,大量,非常适合需要访问全套记录才能完成的计算工作,一般用于离线统计# 流处理的特点是无界,实时,无需针对整个数据集执行操作,而是对通过系统传输的每个数据项执行操作,一般用于实时统计# 在spark的世界观中,一切都是由批次组成的,离线数据是一个大批次,而实时数据是由一个一个无限的小批次组成的# 在Flink的世界观中,一切都是由流组成的,离线数据是有界限的流,实时数据是一个没有界限的流,这就是所谓的有界流和无界流# 无界数据流:有一个开始但是没有结束,他们不会在生成时终止并提供数据,必须连续处理无界流,也就是说必须在获取后立即处理event,对于无界数据流我们无法等待所有数据都到达,因为输入是无界的并且在任何时间点都不会完成,处理无界数据流通常要求以特定顺序(例如事件发生的顺序)获取event,以便能够推断结果完整性# 有界数据流: 有界数据流有明确定义的开始和结束,可以在执行任何计算之前通过获取所有数据来处理有界流,处理有界流不需要有序获取,因为可以始终对有界数据集进行排序,有界流的处理也称为批处理
三.分层API
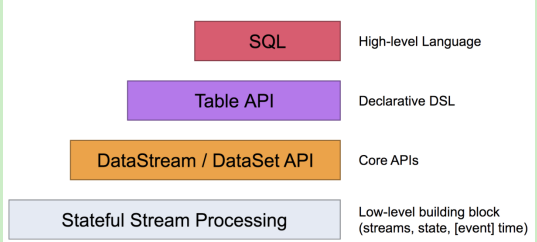
1. 最底层的抽象仅仅提供了有状态流,它将通过过程函数(Process Function)被嵌入到DataStream API中,底层过程函数与DataStream API相集成,使其可以对某些特定的操作进行底层的抽象,它允许用户可以自由的处理来自一个或多个数据流的事件,并使用一致的容错的状态,除此之外,用户可以注册事件时间并处理时间回调,从而使程序可以处理复杂的运算2. 实际上大多数应用并不需要上述的底层抽象,而是针对核心API(Core APIS)进行编程,比如DataStream API(有界或无界流数据) 以及DataSet API(有界数据集)这些API为数据处理提供了通用的构建模块,比如由用户定义的多种形式的转换,连接,聚合,窗口操作等,DataSet Api为有界数据集提供了额外的支持,例如循环和迭代,这些API处理的数据以类(class)的形式由各自的编程语言所表示3. Table API是以表为中心的声明式编程,其中表可能会动态变化(在表达流数据时),Table API遵循(扩展)的关系模型,表有二维数据结构(schema)(类似于关系数据库中的表),同时API提供可比较的操作,例如select,project,join,group-by,aggregate等,Table API程序声明式的定义了什么逻辑操作应该执行,而不是准确的确定这些操作代码看上去如何尽管Table API 可以通过多种类型的用户自定义函数(UDF)进行扩展,其仍不如核心API更具表达能力,而是使用起来更加简洁(代码量更少),除此之外,Table API程序在执行之前会经过内置优化器进行优化你可以在表与DataStream/DataSet之间无缝切换,以允许程序将Table API 与DataStream以及DataSet混合使用4. Flink提供的最高层级的抽象是SQL,这一层抽象在语法和表达能力上与 Table API类似,但是是以SQL查询表达式的形式表现程序,SQL抽象与Table API交互密切,同时SQL查询可以直接在Table API定义的表上执行5. 目前Flink作为批处理还不是主流,不如Spark成熟,所以DataSet使用的并不是很多,Flink Table API与Flink SQL也并不完善,大多都由各大厂商自己定制,所以我们主要学习DataStream API的使用,实际上Flink作为最接近Google DataFlow模型的实现,是流批统一的观点,所以基本上使用DataStream就可以了6. 2020年12月8日发布的1.12.0版本,已经完成实现了真正的流批一体,写好的一套代码,既可以处理流式数据,也可以处理离线数据,Flink专门对批处理数据做了优化处理
3.Spark or Flink
# Spark和Flink一开始都有同一个梦想,他们都希望能够用同一个技术把流处理和批处理统一起来,但他们走了完全不一样的两条路# Spark是以批处理的技术为根本,并尝试在批处理上支持流计算# Flink则认为流计算技术是最基本的,在流计算的基础之上支持批处理# 正是因为这两种架构的不同,二者在能做的事情上有一些细微的区别,比如在低延迟场景,spark基于微批次处理的方式需要同步会有额外开销,因此无法在延迟上做到极致# 在大数据处理的低延迟场景,Flink已经有非常大的优势
# 如果企业中非要技术选型从Spark和Flink这两个主流框架来进行流数据处理,推荐使用Flink,主要的原因为1.Flink灵活的窗口2.Exactly Once语义保证3.事件时间(event-time)语义(处理乱序数据或者延迟数据)
4.Flink的应用
- 事件驱动型应用
- 数据分析应用
- 数据管道应用
第二章.WordCount
1.创建maven项目,并在pom.xml中导入依赖
<properties><flink.version>1.13.1</flink.version><scala.binary.version>2.12</scala.binary.version><slf4j.version>1.7.30</slf4j.version></properties><dependencies><dependency><groupId>org.apache.flink</groupId><artifactId>flink-java</artifactId><version>${flink.version}</version><scope>provided</scope></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-streaming-java_${scala.binary.version}</artifactId><version>${flink.version}</version><scope>provided</scope></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-clients_${scala.binary.version}</artifactId><version>${flink.version}</version><scope>provided</scope></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-runtime-web_${scala.binary.version}</artifactId><version>${flink.version}</version><scope>provided</scope></dependency><dependency><groupId>org.slf4j</groupId><artifactId>slf4j-api</artifactId><version>${slf4j.version}</version><scope>provided</scope></dependency><dependency><groupId>org.slf4j</groupId><artifactId>slf4j-log4j12</artifactId><version>${slf4j.version}</version><scope>provided</scope></dependency><dependency><groupId>org.apache.logging.log4j</groupId><artifactId>log4j-to-slf4j</artifactId><version>2.14.0</version><scope>provided</scope></dependency></dependencies><build><plugins><plugin><groupId>org.apache.maven.plugins</groupId><artifactId>maven-shade-plugin</artifactId><version>3.2.4</version><executions><execution><phase>package</phase><goals><goal>shade</goal></goals><configuration><artifactSet><excludes><exclude>com.google.code.findbugs:jsr305</exclude><exclude>org.slf4j:*</exclude><exclude>log4j:*</exclude></excludes></artifactSet><filters><filter><!-- Do not copy the signatures in the META-INF folder.Otherwise, this might cause SecurityExceptions when using the JAR. --><artifact>*:*</artifact><excludes><exclude>META-INF/*.SF</exclude><exclude>META-INF/*.DSA</exclude><exclude>META-INF/*.RSA</exclude></excludes></filter></filters><transformers combine.children="append"><transformer implementation="org.apache.maven.plugins.shade.resource.ServicesResourceTransformer"></transformer></transformers></configuration></execution></executions></plugin></plugins></build>
2.src/main/resources下新建log4j.properties文件
log4j.rootLogger=error, stdoutlog4j.appender.stdout=org.apache.log4j.ConsoleAppenderlog4j.appender.stdout.layout=org.apache.log4j.PatternLayoutlog4j.appender.stdout.layout.ConversionPattern=%-4r [%t] %-5p %c %x - %m%n
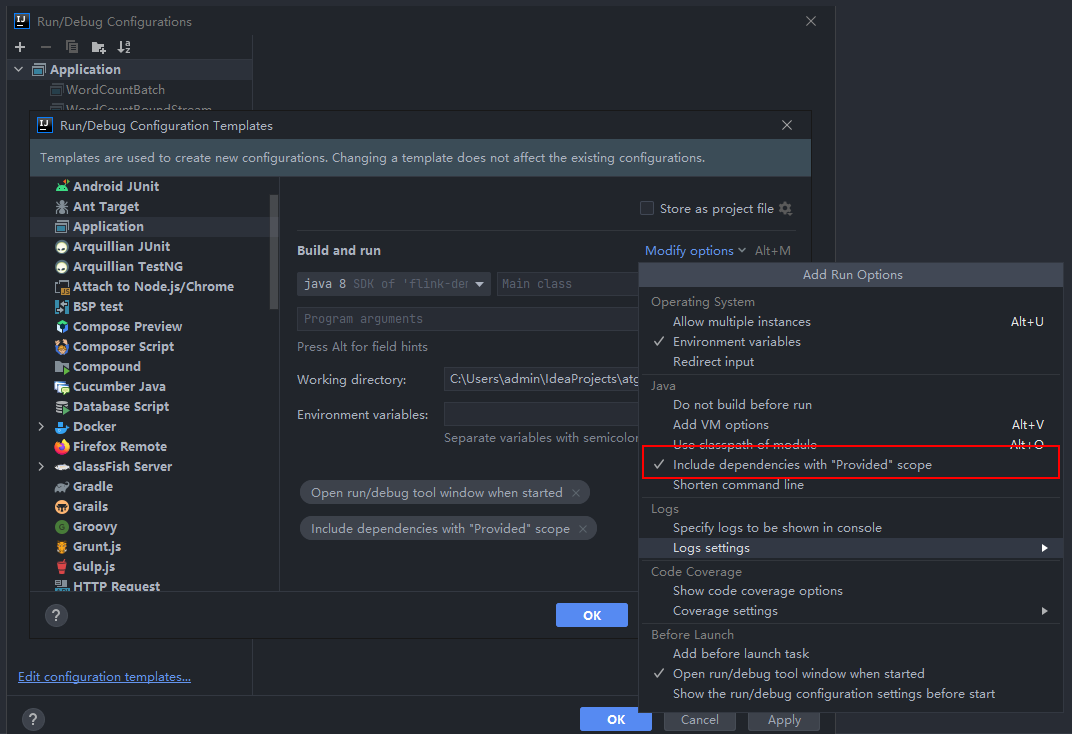
3.配置idea,运行的时候包括provided scope
4.批处理WordCount
package com.atguigu.flink.day01;import org.apache.flink.api.common.functions.FlatMapFunction;import org.apache.flink.api.java.ExecutionEnvironment;import org.apache.flink.api.java.operators.AggregateOperator;import org.apache.flink.api.java.operators.DataSource;import org.apache.flink.api.java.operators.FlatMapOperator;import org.apache.flink.api.java.operators.UnsortedGrouping;import org.apache.flink.api.java.tuple.Tuple2;import org.apache.flink.util.Collector;/*** wouldcoult -批处理*/public class WordCountBatch {public static void main(String[] args) throws Exception {//1.获取执行环境ExecutionEnvironment benv = ExecutionEnvironment.getExecutionEnvironment();//2.读取数据DataSource<String> inputDS = benv.readTextFile("C:\\Users\\admin\\IdeaProjects\\atguigu\\flink-demo\\input\\word.txt");//3.处理数据//3.1压平,切分,转换格式FlatMapOperator<String, Tuple2<String, Integer>> wordAndOne = inputDS.flatMap(new FlatMapFunction<String, Tuple2<String, Integer>>() {@Overridepublic void flatMap(String value, Collector<Tuple2<String, Integer>> collector) throws Exception {//切分String[] words = value.split(" ");//遍历,每一个元素都发送出去for (String word : words) {//转换成元组Tuple2<String, Integer> tuple2 = Tuple2.of(word, 1);//通过采集器,一个一个往下游发送collector.collect(tuple2);}}});//3.2按照word分组UnsortedGrouping<Tuple2<String, Integer>> wordAndOneGroup = wordAndOne.groupBy(0);//3.3 按组聚合AggregateOperator<Tuple2<String, Integer>> result = wordAndOneGroup.sum(1);//4.输出result.print();//批处理不需要,阻塞,启动}}
5.流处理WordCount(有界流)
package com.atguigu.flink.day01;import org.apache.flink.api.common.functions.FlatMapFunction;import org.apache.flink.api.java.tuple.Tuple;import org.apache.flink.api.java.tuple.Tuple2;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.datastream.KeyedStream;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.util.Collector;/*** wouldcoult -有界流处理 (读文件)*/public class WordCountBoundStream {public static void main(String[] args) throws Exception {//1.获取执行环境StreamExecutionEnvironment senv = StreamExecutionEnvironment.getExecutionEnvironment();//2.读取数据DataStreamSource<String> inputDS = senv.readTextFile("C:\\Users\\admin\\IdeaProjects\\atguigu\\flink-demo\\input\\word.txt");//3.处理数据//3.1压平,切分,转换格式SingleOutputStreamOperator<Tuple2<String, Integer>> wordAndOne = inputDS.flatMap(new FlatMapFunction<String, Tuple2<String, Integer>>() {@Overridepublic void flatMap(String value, Collector<Tuple2<String, Integer>> collector) throws Exception {//切分String[] words = value.split(" ");//遍历,每一个元素都发送出去for (String word : words) {collector.collect(Tuple2.of(word, 1));}}});//3.2按照word分组KeyedStream<Tuple2<String, Integer>, Tuple> wordAndOneKB = wordAndOne.keyBy(0);//3.3 按组聚合SingleOutputStreamOperator<Tuple2<String, Integer>> result = wordAndOneKB.sum(1);//4.输出result.print();//启动senv.execute();}}
6.流处理WordCount(无界流)
package com.atguigu.flink.day01;import org.apache.flink.api.common.functions.FlatMapFunction;import org.apache.flink.api.java.tuple.Tuple;import org.apache.flink.api.java.tuple.Tuple2;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.datastream.KeyedStream;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.util.Collector;/*** wouldcoult -无界流处理 (kafka,socket)*/public class WordCountUnBoundStream {public static void main(String[] args) throws Exception {//1.获取执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();//2.读取数据DataStreamSource<String> socketDS = env.socketTextStream("hadoop102", 9999);//3.处理数据//3.1压平,切分,转换格式socketDS.flatMap(new FlatMapFunction<String, Tuple2<String,Integer>>() {@Overridepublic void flatMap(String value, Collector<Tuple2<String, Integer>> collector) throws Exception {String[] words = value.split(" ");for (String word : words) {collector.collect(Tuple2.of(word,1));}}}).keyBy(0).sum(1).print();//启动env.execute();}}
第三章.Flink部署
1.local-cluster模式
local-cluster(本地集群模式),基本属于零配置
- 上传Flink的安装包flink-1.13.1-bin-scala_2.12.tgz到hadoop102并解压
tar -zxvf flink-1.13.1-bin-scala_2.12.tgz -C /opt/modulecp -r flink-1.13.1 flink-1.13.1-local
- 在local-cluster模式下运行无界的wordcount
- 打包idea中的应用
- 把不带依赖的jar包上传到目录/opt/module/flink-1.13.1-local下
- 启动本地集群
[atguigu@hadoop102 flink-1.13.1-local]$ bin/start-cluster.sh
- 在hadoop102上启动netcat
nc -lk 9999
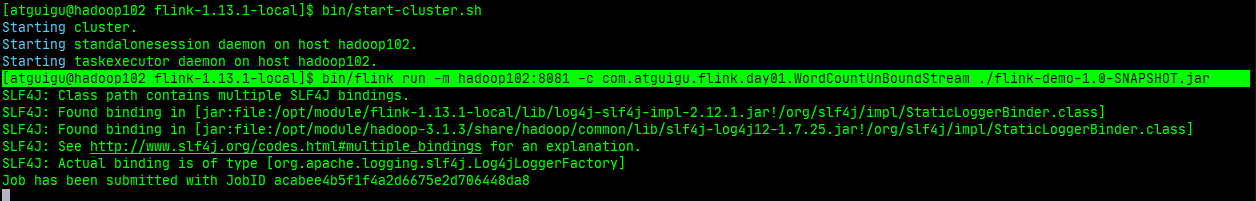
- 命令行提交Flink应用
[atguigu@hadoop102 flink-1.13.1-local]$ bin/flink run -m hadoop102:8081 -c com.atguigu.flink.day01.WordCountUnBoundStream ./flink-demo-1.0-SNAPSHOT.jar
- 浏览器查看应用执行情况
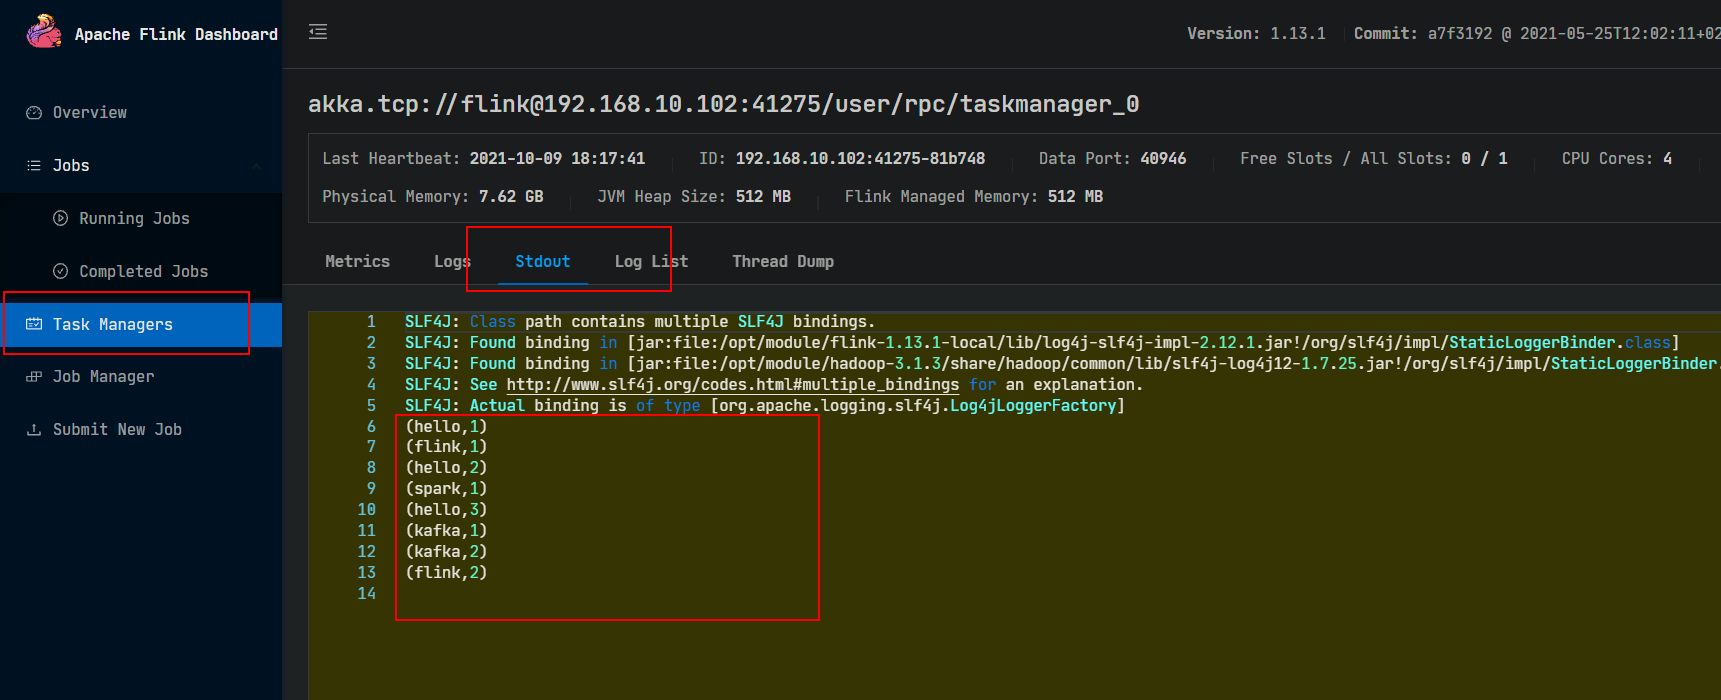
- 也可以在log日志中查看执行结果
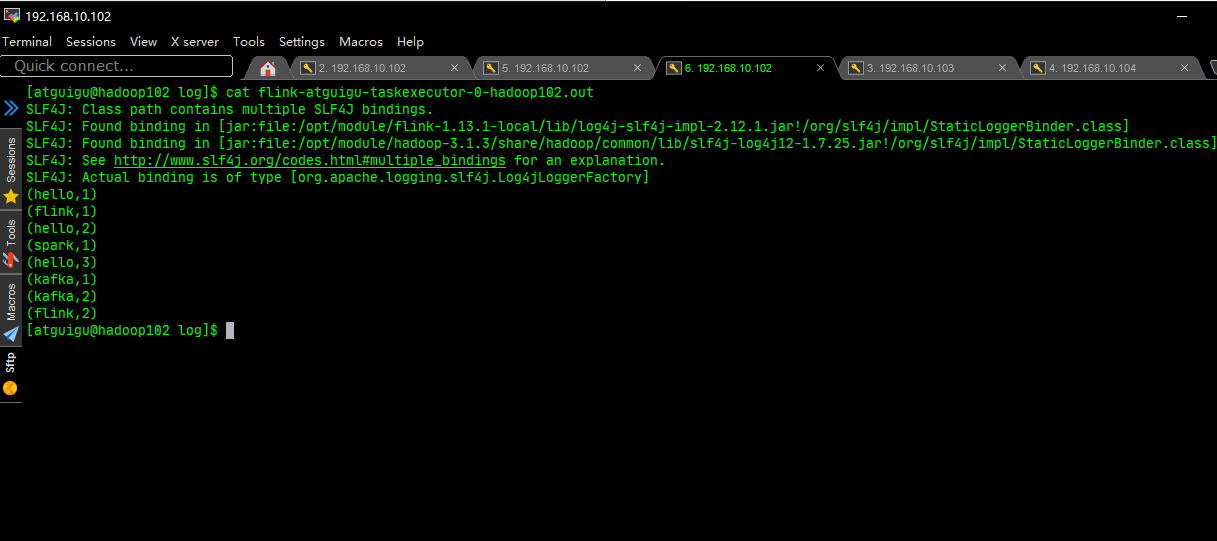
- 也可以在WEB UI提交应用
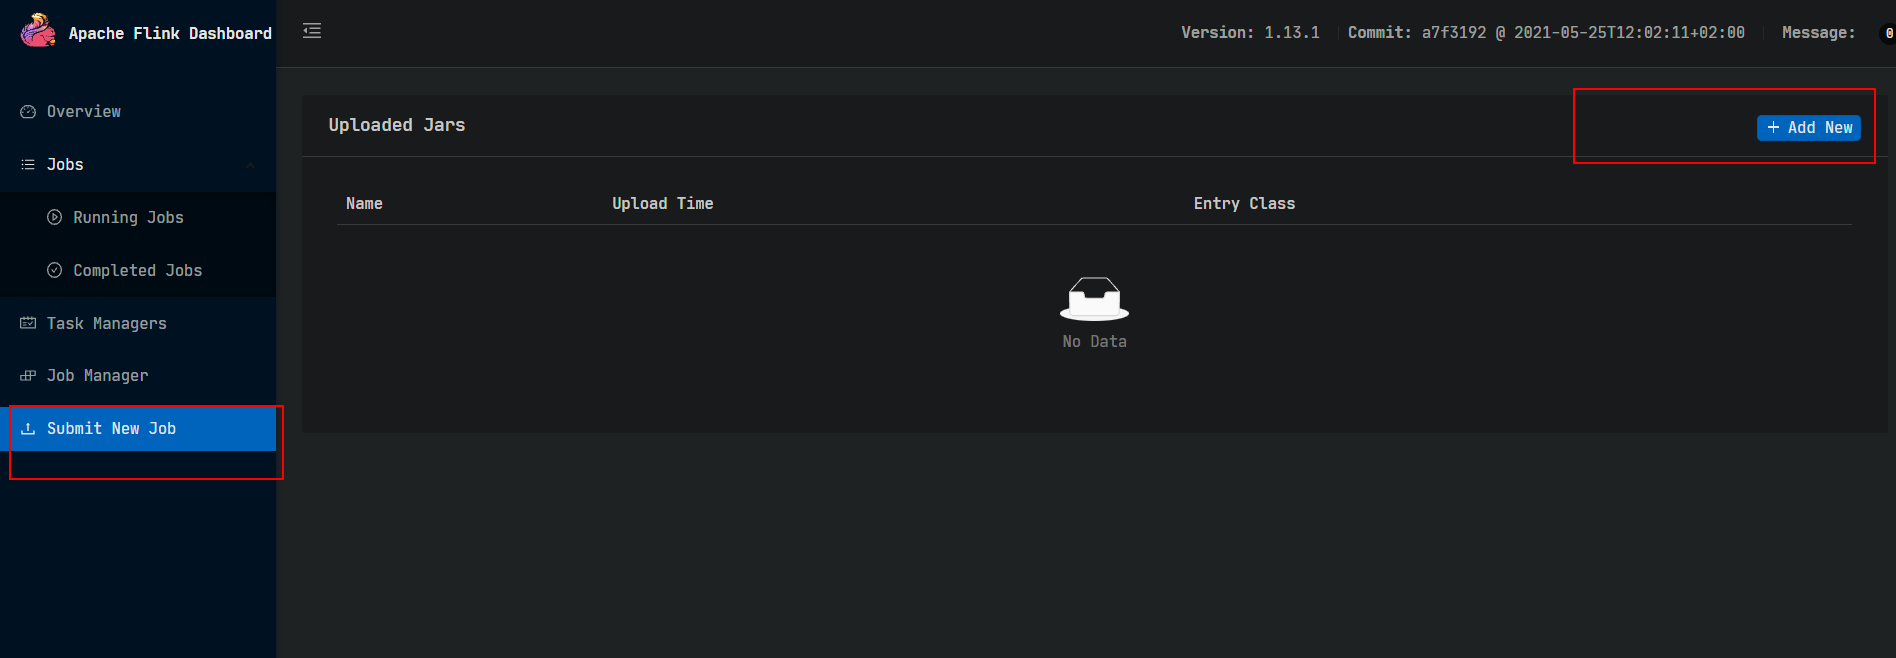
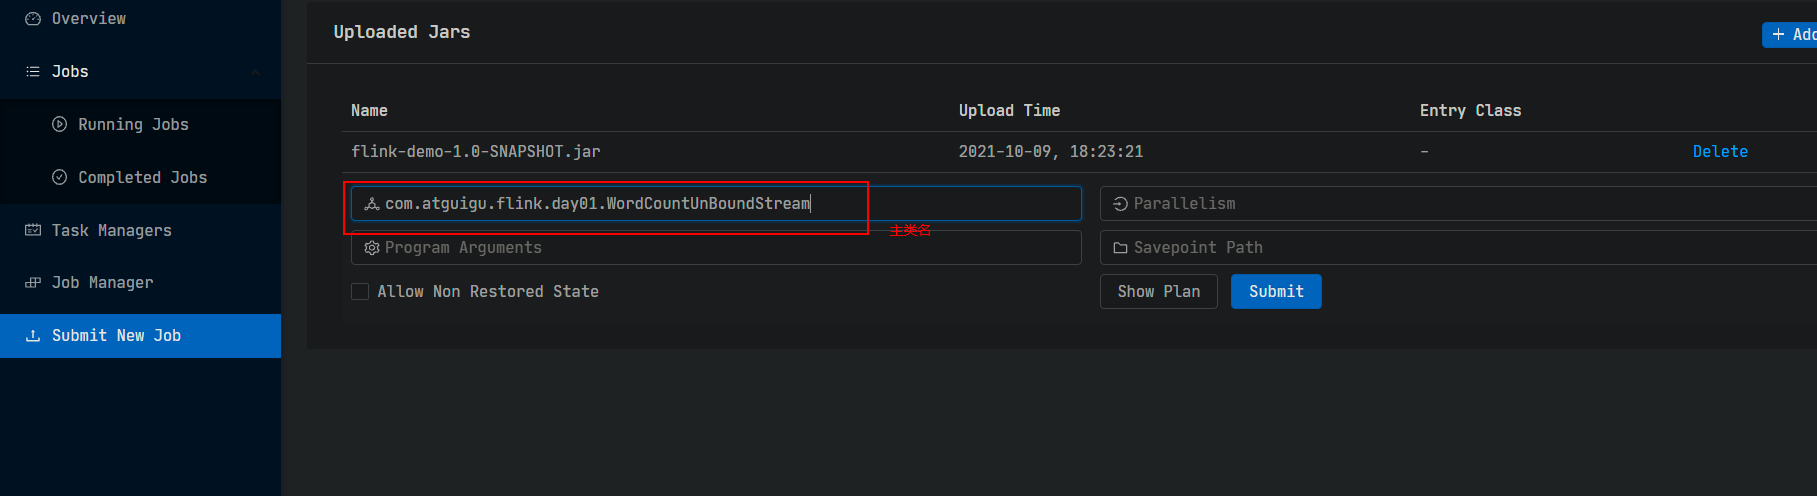
2.Standalone模式
Standalone模式又叫做独立集群模式
一.模式配置
- 复制解压缩后的flink文件更名为flink-1.13.1-standalone
cp -r flink-1.13.1 flink-1.13.1-standalone
- 修改配置文件flink-conf.yaml
jobmanager.rpc.address: hadoop102
- 修改配置文件:workers
hadoop102hadoop103hadoop104
- 分发flink-1.13.1-standalone到其他节点
xsync flink-1.13.1-standalone
- 执行wordcount与本地集群一致
二.高可用配置
- 修改环境变量配置文件,并分发
vim /etc/profile.d/my_env.sh#添加#HADOOP_CLASSPATHexport HADOOP_CLASSPATH=`hadoop classpath`
- 修改配置文件:flink-conf.yaml
high-availability: zookeeperhigh-availability.storageDir: hdfs://hadoop102:9820/flink/standalone/hahigh-availability.zookeeper.quorum: hadoop102:2181,hadoop103:2181,hadoop104:2181#添加以下两行内容high-availability.zookeeper.path.root: /flink-standalonehigh-availability.cluster-id: /cluster_atguigu
- 修改配置文件:masters
hadoop102:8081hadoop103:8081
- 分发修改后的配置文件到其他节点
xsync flink-conf.yaml masters
- 分别启动hadoop和zookeeper集群
hadoop.sh startzookeeper.sh start
- 启动standalone HA 集群
[atguigu@hadoop102 bin]$ ./start-cluster.sh
- 可以分别访问 http://hadoop102:8081 http://hadoop103:8081
- 可以借助zookeeper可视化工具查看谁是leader
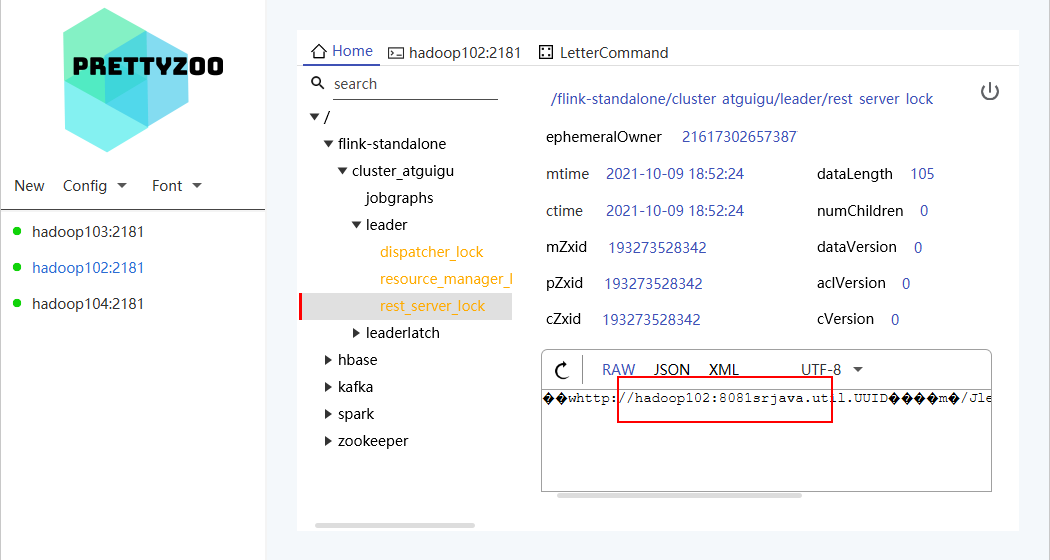
- 杀死hadoop102上的jobmanager,再看leader
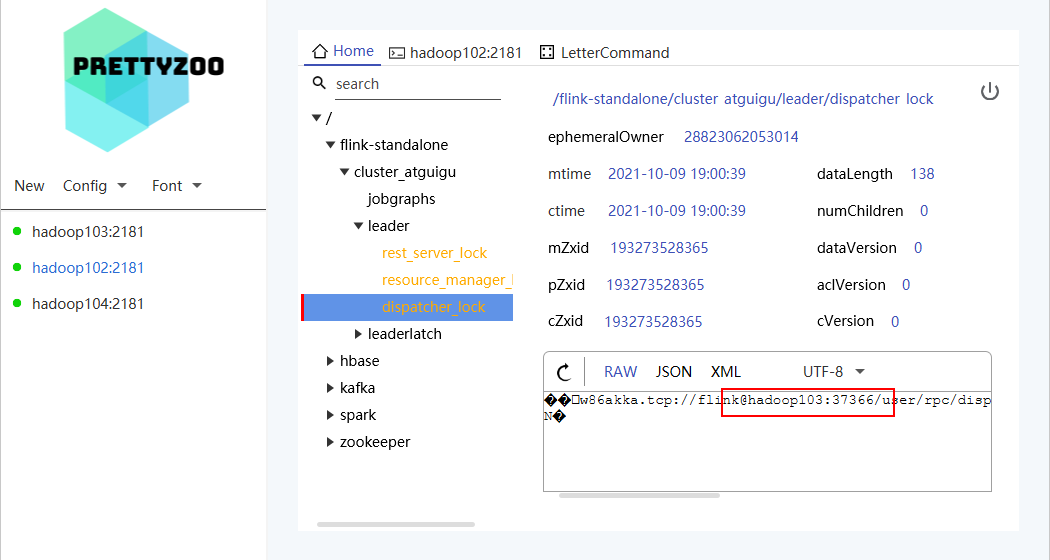
注意:不管是不是leader从WEB UI上看不到区别,并且都可以与之提交应用
3.Yarn模式
一.简单体检
- 复制解压缩后的flink文件更名为flink-1.13.1-yarn
cp -r flink-1.13.1 flink-1.13.1-yarn
- 修改环境变量配置文件,并分发(如果前面已经设置可以忽略)
vim /etc/profile.d/my_env.sh#添加#HADOOP_CLASSPATHexport HADOOP_CLASSPATH=`hadoop classpath`
- 启动hadoop集群
hadoop.sh start
- 运行无界流wordcount
bin/flink run -t yarn-per-job -c com.atguigu.flink.day01.WordCountUnBoundStream ./flink-demo-1.0-SNAPSHOT.jar
- 在yarn的Resourcemanager界面查看执行情况
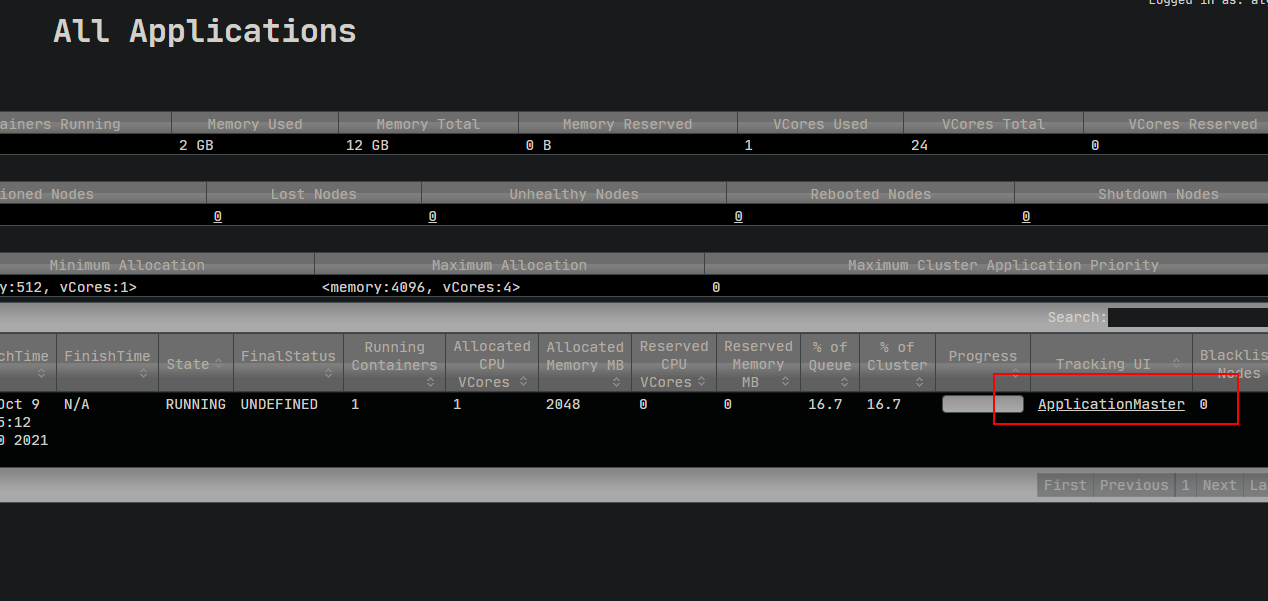

二.Flink on Yarn三种部署模式
Flink提供了yarn上运行的三种模式,分别为Application Mode,Session-Cluster和Per-Job-Cluster模式
- Session-Cluster
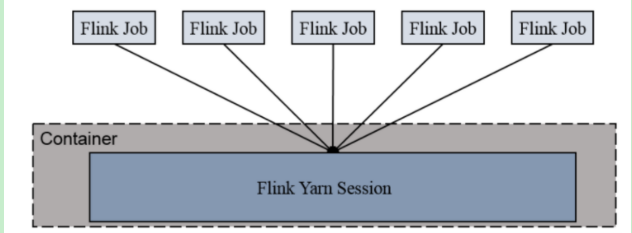
#Session-Cluster模式需要先启动Flink集群,向Yarn申请资源,以后提交任务都向这里提交,这个Flink集群会常驻在yarn集群上,除非手工停止#在向Flink集群提交job的时候,如果资源被用完了,则新的job不能正常提交#缺点;如果提交的作业中有长时间执行的大作业,占用了该Flink集群中的所有资源,则后续无法提交新的job#所以,Session-Cluster适合那些需要频繁提交的多个小job,并且执行时间都不长的job
1.#启动一个Flink-Sessionbin/yarn-session.sh -d2.#在Session上运行jobbin/flink run -c com.atguigu.flink.day01.WordCountUnBoundStream ./flink-demo-1.0-SNAPSHOT.jar
- Per-Job-Cluster
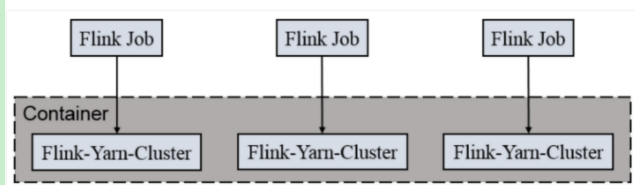
#一个job会对应一个新的flink集群,每提交一个作业会根据自身的情况,都会单独向yarn申请资源,直到作业执行完成,一个作业的失败与否并不会影响下一个作业的正常提交和运行,独享Dispatcher和ResourceManager,按需接收资源申请,适合大规模长时间运行的作业#每次提交都会创建一个新的flink集群,任务之间互相独立,互不影响,方便管理,任务完成之后创建的集群也会消失
bin/flink run -t yarn-per-job -c com.atguigu.flink.day01.WordCountUnBoundStream ./flink-demo-1.0-SNAPSHOT.jar
- Application Mode
Application Mode会在Yarn上启动集群,应用jar包的main函数(用户类的main函数)将会在JobManager上执行,只要应用程序执行结束,Flink集群会马上被关闭,也可以手动停止集群与Per-Job-Cluster的区别,就是在Application Mode下,用户的main函数是在集群(job manager)执行的
bin/flink run-application -t yarn-application -c com.atguigu.flink.day01.WordCountUnBoundStream ./flink-demo-1.0-SNAPSHOT.jar
三.高可用配置
- Yarn模式的高可用和Standalone模式的高可用原理不一样
- Standalone模式中,同时启动多个Jobmanager,一个为leader其他为standby,当leader挂了,其他的才有一个成为leader
- yarn的高可用是同时只启动一个Jobmanager,当这个Jobmanager挂了之后,yarn会再启动一个,其实是利用了yarn的重试次数来实现的高可用
- 在yarn-site.xml中配置
<property><name>yarn.resourcemanager.am.max-attempts</name><value>4</value><description>The maximum number of application master execution attempts.</description></property>
- 分发修改后的配置,并重启yarn
- 配置flink-conf.yaml
yarn.application-attempts: 3high-availability: zookeeperhigh-availability.storageDir: hdfs://hadoop102:9820/flink/yarn/hahigh-availability.zookeeper.quorum: hadoop102:2181,hadoop103:2181,hadoop104:2181high-availability.zookeeper.path.root: /flink-yarn
- 启动yarn-session
[atguigu@hadoop102 flink-1.13.1-yarn]$ bin/yarn-session.sh -d
- 杀死Jobmanager,查看复活情况

若有收获,就点个赞吧
0 人点赞


