第一章.Flink SQL简介
Apache Flink 有两种关系型API 来做流批统一处理: Table API 和 SQL
Table API 是用于Scala与Java语言的查询API,它可以用一种非常直观的方式来组合使用选取,过滤,join等关系型算子
Flink SQL是基于Apache Calcite来实现的标准SQL,这两种API的查询对于批(DataSet) 和流(DataStream)的输入有相同的语义,也会产生同样的计算结果

1.动态表
动态表(Dynamic Tables)是FLink的支持流数据的Table API 和SQL的核心概念与表示批处理数据的静态表不同,动态表是随时间变化的,可以像查询静态批处理表一样查询他们,查询动态表将生成一个连续查询(Continuous Query),一个连续查询永远不会终止,结果会生成一个动态表,查询不断更新其动态结果集以反映其(动态)输入表上的更改需要注意的是,连续查询的结果在语义上总是等价于批处理模式在输入表快照上执行的相同查询的结果
2.连续查询
在动态表上计算一个连续查询,并生成一个新的动态表,与批处理查询不同,连续查询从不终止,并根据其输入表上的更新更新其结果表在任何时候,连续查询的结果在语义上与以批处理模式在输入表上执行的相同查询的结果相同
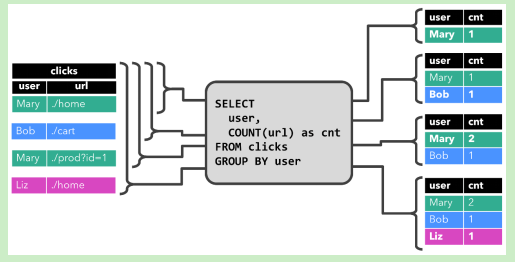
- 当查询开始,clicks 表(左侧)是空的。
- 当第一行数据被插入到 clicks 表时,查询开始计算结果表。第一行数据 [Mary,./home] 插入后,结果表(右侧,上部)由一行 [Mary, 1] 组成。
- 当第二行 [Bob, ./cart] 插入到 clicks 表时,查询会更新结果表并插入了一行新数据 [Bob, 1]。
- 第三行 [Mary, ./prod?id=1] 将产生已计算的结果行的更新,[Mary, 1] 更新成 [Mary, 2]。
- 最后,当第四行数据加入 clicks 表时,查询将第三行 [Liz, 1] 插入到结果表中。
第二章.Flink Table API
1.导入依赖
<dependency><groupId>org.apache.flink</groupId><artifactId>flink-table-planner-blink_${scala.binary.version}</artifactId><version>${flink.version}</version><scope>provided</scope></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-streaming-scala_${scala.binary.version}</artifactId><version>${flink.version}</version><scope>provided</scope></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-csv</artifactId><version>${flink.version}</version></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-json</artifactId><version>${flink.version}</version></dependency><!-- https://mvnrepository.com/artifact/org.apache.commons/commons-compress --><dependency><groupId>org.apache.commons</groupId><artifactId>commons-compress</artifactId><version>1.21</version></dependency>
2.基本使用:表与DataStream的混合使用
写法一
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.datastream.DataStream;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.types.Row;public class $01_TableBaseUse {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 5000L, 50),new WaterSensor("sensor_2", 6000L, 60));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//把流转成动态表Table table = tenv.fromDataStream(stream);table.printSchema();//打印表的元数据//在动态表上进行连续查询Table result = table.where("id=='sensor_1'").select("id,vc");//把查询结果(动态表)转成流DataStream<Row> resultStream = tenv.toAppendStream(result, Row.class);//把流进行sinkresultStream.print();env.execute();}}
写法二(常用)
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.datastream.DataStream;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.types.Row;import static org.apache.flink.table.api.Expressions.$;public class $02_TableBaseUseNormal {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 5000L, 50),new WaterSensor("sensor_2", 6000L, 60));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//把流转成动态表Table table = tenv.fromDataStream(stream);//在动态表上进行连续查询Table result = table.where($("id").isEqual("sensor_1")).select($("id").as("id1"), $("vc"));result.execute().print();}}
3.基本使用:聚合操作
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.AggregatedTable;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import static org.apache.flink.table.api.Expressions.$;public class $03_TableBaseUseAgg {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 5000L, 50),new WaterSensor("sensor_2", 6000L, 60));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//把流转成动态表Table table = tenv.fromDataStream(stream);//在动态表上进行连续查询/*Table result = table.groupBy($("id")).aggregate($("vc").sum().as("vc_sum")).select($("id"), $("vc_sum"));*/Table result = table.groupBy($("id")).select($("id"), $("vc").sum().as("vc_sum"));result.execute().print();/*** 把动态表转换成流. 如果涉及到数据的更新, 要用到撤回流. 多个了一个boolean标记* DataStream<Tuple2<Boolean, Row>> resultStream = tenv.toRetractStream(result, Row.class);* resultStream.print()*/}}
4.表到流的转换
动态表可以像普通数据库表一样通过insert,update,和delete来不断修改,它可能是一个只有一行,不断更新的表,也可能是一个insert-only的表,没有update和delete修改,或者介于两者之间的其他表在将动态表转换为流,或将其写入外部系统时,需要对这些更改进行编码,Flink的Table API和SQL支持三种方式来编码一个动态表的变化Append-only流:仅通过insert操作修改的动态表可以通过输出输入的行转换为流Retract流:retract流包含两种类型的message:addmessages 和 retract messages,通过将insert操作编码为addmessage,将delete操作编码为retract message,将update操作编码为更新行的retract message和更新行的add message,将动态表转换为retract流Upsert流:upsert流包含两种类型的message:upsertmessages和delete messages.转换为upsert流的动态表需要(可能是组合的)唯一键,通过将insert和upsert操作操作编码为upsert message,将delete操作编码为delete message,将具有唯一键的动态表转换为流,消费流的算子需要知道唯一键的属性,以便正确的应用message.与retract流的主要区别在于update操作是用单个message编码的,因此效率更高
5.使用Table API读写文件
package com.atguigu.flink.day09;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.DataTypes;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.table.descriptors.Csv;import org.apache.flink.table.descriptors.FileSystem;import org.apache.flink.table.descriptors.Schema;import static org.apache.flink.table.api.Expressions.$;public class $04_TableToFile {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//表的元数据信息Schema schema = new Schema().field("id", DataTypes.STRING()).field("ts", DataTypes.BIGINT()).field("vc", DataTypes.INT());//通过读取文件创建临时表tenv.connect(new FileSystem().path("input/sensor.txt"))//文件的切分方式.withFormat(new Csv().lineDelimiter("\n").fieldDelimiter(',')).withSchema(schema).createTemporaryTable("sensor");Table resultTable = tenv.from("sensor").where($("id").isEqual("sensor_1")).select($("id"), $("vc"));//建立动态表与文件(sink)进行关联tenv.connect(new FileSystem().path("input/a.txt"))//文件的切分方式.withFormat(new Csv().fieldDelimiter(',')).withSchema(new Schema().field("id", DataTypes.STRING()).field("vc", DataTypes.INT())).createTemporaryTable("a");//把数据写入到与sink关联的临时表中(动态表)resultTable.executeInsert("a");}}
6.使用Table API读写Kafka
package com.atguigu.flink.day09;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.DataTypes;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.table.descriptors.*;import static org.apache.flink.table.api.Expressions.$;public class $05_TableToKafka {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//表的元数据信息Schema schema = new Schema().field("id", DataTypes.STRING()).field("ts", DataTypes.BIGINT()).field("vc", DataTypes.INT());//通过读取kafka创建临时表tenv.connect(new Kafka().version("universal").property("bootstrap.servers","hadoop162:9092").property("group.id","$05_TableToKafka").topic("s1").startFromLatest())//文件的切分方式.withFormat(new Json()).withSchema(schema).createTemporaryTable("s1");Table s1 = tenv.from("s1").select($("id"), $("vc"));//与sink关联tenv.connect(new Kafka().version("universal").property("bootstrap.servers","hadoop162:9092").topic("s2").sinkPartitionerRoundRobin()).withFormat(new Csv().lineDelimiter("")).withSchema(new Schema().field("id", DataTypes.STRING()).field("vc", DataTypes.INT())).createTemporaryTable("s2");s1.executeInsert("s2");}}
第三章.Flink SQL
1.基本使用
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.datastream.DataStream;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.types.Row;public class $06_SQLBaseUse {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 5000L, 50),new WaterSensor("sensor_2", 6000L, 60));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//把流转成动态表Table table = tenv.fromDataStream(stream);//查询未注册的表/*** tenv.executeSql("");执行DDL和DML(insert,update和delete)*///注意from和where之后要有空格Table t1 = tenv.sqlQuery("select * from " + table + " where id= 'sensor_1'");//只执行查询t1.execute().print();//查询已注册的表//1.先为table对象注册一个临时表tenv.createTemporaryView("sensor",table);//2.执行SQL查询tenv.sqlQuery("select * from sensor where id= 'sensor_1'").execute().print();}}
2.使用SQL API读写文件
package com.atguigu.flink.day09;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;public class $07_SQLToFile {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//通过ddl建立一个动态 表,与file source 进行关联tenv.executeSql("create table sensor(id string, ts bigint, vc int" +")with(" +" 'connector' = 'filesystem', "+" 'path' = 'input/sensor.txt', "+" 'format'= 'csv' " +")");//建立动态表与sink进行关联tenv.executeSql("create table b(id string, vc int" +")with(" +" 'connector' = 'filesystem', "+" 'path' = 'input/b.txt', "+" 'format'= 'csv' " +")");tenv.executeSql("insert into b select id, vc from sensor where id='sensor_1' ");}}
3.使用SQL API读写Kafka
package com.atguigu.flink.day09;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;public class $08_SQLToKafka {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);tenv.executeSql("create table sensor(id string, ts bigint, vc int" +")with(" +" 'connector' = 'kafka',\n "+" 'properties.bootstrap.servers' = 'hadoop162:9092',\n "+" 'properties.group.id'= '$08_SQLToKafka',\n " +" 'topic' = 's1',\n"+" 'scan.startup.mode' = 'latest-offset',\n"+" 'format' = 'csv'" +")");tenv.executeSql("create table ss(id string, vc int" +")with(" +" 'connector' = 'kafka',\n "+" 'properties.bootstrap.servers' = 'hadoop162:9092',\n "+" 'topic' = 's2',\n"+" 'format' = 'json',\n" +" 'sink.partitioner' = 'round-robin' "+")");Table result = tenv.sqlQuery("select id, vc from sensor");result.executeInsert("ss");}}
第四章.时间属性
1.处理时间
DataStream到Table转换时定义
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import static org.apache.flink.table.api.Expressions.$;public class $09_TimeProcessing {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 5000L, 50),new WaterSensor("sensor_2", 6000L, 60));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//必须添加一个新的字段作为处理时间Table table = tenv.fromDataStream(stream, $("id"), $("ts"), $("vc"), $("pt").proctime());table.execute().print();}}
在创建表的DDL中定义
package com.atguigu.flink.day09;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;public class $10_TimeDDLProcessing {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);tenv.executeSql("create table sensor(" +" id string, " +" ts bigint, " +" vc int, " +" pt as proctime() " +")with(" +" 'connector' = 'filesystem', " +" 'path' = 'input/sensor.txt', " +" 'format' = 'csv' " +")");tenv.sqlQuery("select * from sensor").execute().print();}}
2.事件时间
DataStream到Table转换时定义
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import java.time.Duration;import static org.apache.flink.table.api.Expressions.$;public class $11_TimeEventTime {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据SingleOutputStreamOperator<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 5000L, 50),new WaterSensor("sensor_2", 6000L, 60)).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(3)).withTimestampAssigner((ws, ts) -> ws.getTs()));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//直接在原来属性指定为事件时间Table table = tenv.fromDataStream(stream, $("id"), $("ts").rowtime(), $("vc"));table.execute().print();}}
在创建表的DDL中定义
package com.atguigu.flink.day09;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import java.time.ZoneOffset;public class $12_TimeDDLEventTime {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//设置时区tenv.getConfig().setLocalTimeZone(ZoneOffset.ofHours(0));tenv.executeSql("create table sensor(" +" id string, " +" ts bigint, " +" vc int, " +" et as to_timestamp(from_unixtime(ts/1000)), " +" WATERMARK FOR et AS et - INTERVAL '3' SECOND " +")with(" +" 'connector' = 'filesystem', " +" 'path' = 'input/sensor.txt', " +" 'format' = 'csv' " +")");tenv.sqlQuery("select * from sensor").execute().print();}}
第五章.窗口
1.Table API中使用窗口
一.Group Windows
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.*;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import java.time.Duration;import static org.apache.flink.table.api.Expressions.$;import static org.apache.flink.table.api.Expressions.lit;public class $13_TableWindowGroup {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据SingleOutputStreamOperator<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 5000L, 50),new WaterSensor("sensor_2", 6000L, 60)).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(3)).withTimestampAssigner((ws, ts) -> ws.getTs()));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//直接在原来属性指定为事件时间Table table = tenv.fromDataStream(stream, $("id"), $("ts").rowtime(), $("vc"));//滚动窗口//GroupWindow window = Tumble.over(lit(3).second()).on($("ts")).as("w");//滑动窗口GroupWindow window = Slide.over(lit(5).second()).every(lit(2).second()).on($("ts")).as("w");//会话窗口//GroupWindow window = Session.withGap(lit(2).second()).on($("ts")).as("w");table.window(window).groupBy($("id"),$("w")).select($("id"),$("w").start(),$("w").end(),$("vc").sum().as("sum_vc")).execute().print();}}
二.Over Windows
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.*;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.table.expressions.Expression;import org.apache.flink.table.runtime.operators.over.frame.OverWindowFrame;import java.time.Duration;import static org.apache.flink.table.api.Expressions.*;public class $14_TableWindowOver {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据SingleOutputStreamOperator<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 4000L, 50),new WaterSensor("sensor_2", 6000L, 60)).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(3)).withTimestampAssigner((ws, ts) -> ws.getTs()));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//直接在原来属性指定为事件时间Table table = tenv.fromDataStream(stream, $("id"), $("ts").rowtime(), $("vc"));//基于行数开窗OverWindow over = Over.partitionBy($("id")).orderBy($("ts")).preceding(Expressions.UNBOUNDED_ROW).as("w");//基于时间开窗OverWindow over1 = Over.partitionBy($("id")).orderBy($("ts")).preceding(Expressions.UNBOUNDED_RANGE).as("w1");//当事件时间向前算1s得到一个窗口OverWindow over2 = Over.partitionBy($("id")).orderBy($("ts")).preceding(lit(1).second()).as("w3");//当前行向前推算一行算一个窗口OverWindow over3 = Over.partitionBy($("id")).orderBy($("ts")).preceding(rowInterval(1L)).as("w4");table.window(over1).select($("id"),$("ts"),$("vc").sum().over($("w1")).as("vc_sum")).execute().print();}}
2.SQL API中使用窗口
一.Group Windows
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import java.time.Duration;import static org.apache.flink.table.api.Expressions.$;public class $15_SQLWindowGroup {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据SingleOutputStreamOperator<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 5000L, 50),new WaterSensor("sensor_2", 6000L, 60)).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(3)).withTimestampAssigner((ws, ts) -> ws.getTs()));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//直接在原来属性指定为事件时间Table table = tenv.fromDataStream(stream, $("id"), $("ts").rowtime(), $("vc"));tenv.createTemporaryView("sensor", table);// 滚动窗口/*tenv.sqlQuery("select " +" id," +" tumble_start(ts, interval '3' second) stt, " +" tumble_end(ts, interval '3' second) edt, " +" sum(vc) " +"from sensor " +"group by id, TUMBLE(ts, interval '3' second)").execute().print();*///跳跃的时间窗口(滑动窗口)/*tenv.sqlQuery("select " +" id," +" hop_start(ts, interval '3' second, interval '5' second) stt, " +" hop_end(ts, interval '3' second, interval '5' second) edt, " +" sum(vc) " +"from sensor " +"group by id, HOP(ts, interval '3' second, interval '5' second)").execute().print();*///会话的时间窗口tenv.sqlQuery("select " +" id," +" session_start(ts, interval '2' second) stt, " +" session_end(ts, interval '2' second) edt, " +" sum(vc) " +"from sensor " +"group by id, SESSION(ts, interval '2' second)").execute().print();}}
二.Over Windows
package com.atguigu.flink.day09;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import java.time.Duration;import static org.apache.flink.table.api.Expressions.*;public class $16_SQLWindowOver {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据SingleOutputStreamOperator<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 4000L, 50),new WaterSensor("sensor_2", 6000L, 60)).assignTimestampsAndWatermarks(WatermarkStrategy.<WaterSensor>forBoundedOutOfOrderness(Duration.ofSeconds(3)).withTimestampAssigner((ws, ts) -> ws.getTs()));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//直接在原来属性指定为事件时间Table table = tenv.fromDataStream(stream, $("id"), $("ts").rowtime(), $("vc"));tenv.createTemporaryView("sensor", table);/*tenv.sqlQuery("select" +" id, " +" ts," +" vc," +// " sum(vc) over(partition by id order by ts rows between unbounded preceding and current row) vc_sum " +// " sum(vc) over(partition by id order by ts rows between 1 preceding and current row) vc_sum " +// " sum(vc) over(partition by id order by ts range between unbounded preceding and current row) vc_sum " +// " sum(vc) over(partition by id order by ts range between interval '1' second preceding and current row) vc_sum " +" sum(vc) over(partition by id order by ts) vc_sum " +"from sensor").execute().print();*/tenv.sqlQuery("select" +" id, " +" ts," +" vc," +" sum(vc) over w vc_sum, " +" max(vc) over w vc_max, " +" min(vc) over w vc_min " +"from sensor " +"window w as(partition by id order by ts rows between unbounded preceding and current row)").execute().print();}}

若有收获,就点个赞吧
0 人点赞


