第一章.Catalog
catalog提供了元数据信息,例如数据库,表,分区,视图以及数据库或其他外部系统中存储的函数和信息数据处理最关键的方面之一是管理元数据,元数据可以是临时的,例如临时表,或者通过TableEnvironment注册的UDF,元数据也可以是持久化的,例如HiveMetaStore中的元数据,Catalog提供了一个统一的API,用于管理元数据,并使其可以从TableAPI和SQL查询语句中来访问
1.Catalog类型
GenericInMemoryCatalogGenericInMemoryCatalog 是基于内存实现的 Catalog,所有元数据只在 session 的生命周期内可用。JdbcCatalogJdbcCatalog 使得用户可以将 Flink 通过 JDBC 协议连接到关系数据库。PostgresCatalog 是当前实现的唯一一种 JDBC Catalog。HiveCatalogHiveCatalog 有两个用途:作为原生 Flink 元数据的持久化存储,以及作为读写现有 Hive 元数据的接口。 Flink 的 Hive 文档 提供了有关设置 HiveCatalog 以及访问现有 Hive 元数据的详细信息。
2.HiveCatalog
一.导入依赖
<dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-hive_${scala.binary.version}</artifactId><version>${flink.version}</version></dependency><!-- Hive Dependency --><dependency><groupId>org.apache.hive</groupId><artifactId>hive-exec</artifactId><version>3.1.2</version></dependency>
二.在hadoop162上启动元数据服务
nohup hive --service metastore >/dev/null 2>&1 &
三.代码编写
package com.atguigu.flink.day10;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.table.catalog.hive.HiveCatalog;public class $01_Hive {public static void main(String[] args) {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//1.创建一个hive catalogHiveCatalog hive = new HiveCatalog("hive", "default", "input/");//2.注册hive catalogtenv.registerCatalog("hive",hive);//3.设置默认的catalogtenv.useCatalog("hive");tenv.useDatabase("default");tenv.sqlQuery("select * from student").execute().print();}}
第二章.函数
Flink 允许用户在Table API 和 SQL中使用函数来进行数据的转换
1.内置函数
Flink Table API 和SQL给用户提供了大量的函数用于数据转换
2.自定义函数
自定义函数(UDF)是一种扩展开发机制,可以用来查询语句中调用难以用其他方式表达的频繁使用和自定义的逻辑自定义函数分类:1.标量函数:标量值转换成一个新标量值2.表值函数:将标量值转换成新的行数据3.聚合函数:将多行数据里的标量值转换成一个新的标量值4.表值聚合函数:将多行数据里的标量值转换成新的行数据5.异步表值函数:是异步查询外部数据系统的特殊函数函数用于SQL查询前要先经过注册,而在用于Table API时,函数可以先注册后调用,也可以内联后直接使用
一.标量函数
介绍:用户定义的标量函数,可以将0、1或多个标量值,映射到新的标量值。为了定义标量函数,必须在org.apache.flink.table.functions中扩展基类Scalar Function,并实现(一个或多个)求值(evaluation,eval)方法。标量函数的行为由求值方法决定,求值方法必须公开声明并命名为eval(直接def声明,没有override)。求值方法的参数类型和返回类型,确定了标量函数的参数和返回类型。
package com.atguigu.flink.day10;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.table.functions.ScalarFunction;import static org.apache.flink.table.api.Expressions.$;import static org.apache.flink.table.api.Expressions.call;/*** 变成大写字母的标量函数*/public class $02_FunctionScalar {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 4000L, 50),new WaterSensor("sensor_2", 6000L, 60));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);Table table = tenv.fromDataStream(stream);//1.在table api中使用//1.1内联的方式/*table.select($("id"),call(MyUpperCase.class,$("id")).as("id_upper")).execute().print();*///1.2注册后使用/*tenv.createTemporaryFunction("toUpper",MyUpperCase.class);table.select($("id"),call("toUpper",$("id")).as("id_upper")).execute().print();*///2.在SQL语句中使用//2.1先注册tenv.createTemporaryFunction("toUpper",MyUpperCase.class);//2.2再使用tenv.sqlQuery(" select id, toUpper(id) from " + table).execute().print();}public static class MyUpperCase extends ScalarFunction{public String eval(String s){return s==null?null:s.toUpperCase();}}}
二.表值函数
跟自定义标量函数一样,自定义表值函数的输入参数也可以是 0 到多个标量。但是跟标量函数只能返回一个值不同的是,它可以返回任意多行。返回的每一行可以包含 1 到多列,如果输出行只包含 1 列,会省略结构化信息并生成标量值,这个标量值在运行阶段会隐式地包装进行里。要定义一个表值函数,你需要扩展 org.apache.flink.table.functions 下的 TableFunction,可以通过实现多个名为 eval 的方法对求值方法进行重载。像其他函数一样,输入和输出类型也可以通过反射自动提取出来。表值函数返回的表的类型取决于 TableFunction 类的泛型参数 T,不同于标量函数,表值函数的求值方法本身不包含返回类型,而是通过 collect(T) 方法来发送要输出的行。在 Table API 中,表值函数是通过 .joinLateral(...) 或者 .leftOuterJoinLateral(...) 来使用的。joinLateral 算子会把外表(算子左侧的表)的每一行跟跟表值函数返回的所有行(位于算子右侧)进行 (cross)join。leftOuterJoinLateral 算子也是把外表(算子左侧的表)的每一行跟表值函数返回的所有行(位于算子右侧)进行(cross)join,并且如果表值函数返回 0 行也会保留外表的这一行。在 SQL 里面用 JOIN 或者 以 ON TRUE 为条件的 LEFT JOIN 来配合 LATERAL TABLE(<TableFunction>) 的使用。其实就是以前的UDTF函数
package com.atguigu.flink.day10;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.annotation.DataTypeHint;import org.apache.flink.table.annotation.FunctionHint;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.table.functions.ScalarFunction;import org.apache.flink.table.functions.TableFunction;import org.apache.flink.types.Row;import static org.apache.flink.table.api.Expressions.$;import static org.apache.flink.table.api.Expressions.call;/*hello hello hello 5hello 5hello world hello 5world 5atguigu hello hello atguigu 7....*/public class $03_FunctionTable {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<String> stream = env.fromElements("hello hello","hello world","atguigu hello hello");//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);Table table = tenv.fromDataStream(stream);//1.在table api中使用//1.1内联的方式/*table.joinLateral(call(MySplit.class,$("f0"))).select($("f0"),$("word"),$("len")).execute().print();*///1.2注册后使用/*tenv.createTemporaryFunction("my_split",MySplit.class);table.joinLateral(call("my_split",$("f0"))).select($("f0"),$("word"),$("len")).execute().print();*///2.在SQL语句中使用//2.1先注册tenv.createTemporaryFunction("my_split",MySplit.class);//2.2再使用tenv.sqlQuery("select" + " f0, " +" word, " +" len " +"from " + table +" left join lateral table(my_split(f0)) on true").execute().print();/*tenv.sqlQuery("select" +" f0, " +" w, " +" l " +"from " + table +" left join lateral table(my_split(f0)) as T(w, l) on true").execute().print();*/}@FunctionHint(output = @DataTypeHint("row<word string, len int>"))public static class MySplit extends TableFunction<Row> {public void eval(String s){String[] words = s.split(" ");for (String word : words) {collect(Row.of(word,word.length()));}}}}
三.聚合函数
用户自定义聚合函数(User-Defined Aggregate Functions,UDAGGs)可以把一个表中的数据,聚合成一个标量值。用户定义的聚合函数,是通过继承AggregateFunction抽象类实现的。
package com.atguigu.flink.day10;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.table.functions.AggregateFunction;import org.apache.flink.table.functions.ScalarFunction;import static org.apache.flink.table.api.Expressions.$;import static org.apache.flink.table.api.Expressions.call;/*** 变成大写字母的标量函数*/public class $04_FunctionAgg {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 4000L, 50),new WaterSensor("sensor_2", 6000L, 60));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);Table table = tenv.fromDataStream(stream);//1.在table api中使用//1.1内联的方式/*table.groupBy($("id")).select($("id"),call(MyAvg.class,$("vc")).as("vc_avg")).execute().print();*///1.2注册后使用/*tenv.createTemporaryFunction("my_avg",MyAvg.class);table.groupBy($("id")).select($("id"),call("my_avg",$("vc")).as("vc_avg")).execute().print();*///2.在SQL语句中使用//2.1先注册tenv.createTemporaryFunction("my_avg",MyAvg.class);//2.2再使用tenv.sqlQuery("select " +" id, " +" my_avg(vc) " +"from " + table +" group by id").execute().print();}public static class Avg{public Double sum = 0D;public Long count = 0L;public Double avg(){return sum / count;}}public static class MyAvg extends AggregateFunction<Double,Avg>{//返回最终的计算结果@Overridepublic Double getValue(Avg acc) {return acc.avg();}//初始化累加器@Overridepublic Avg createAccumulator() {return new Avg();}/*** 参数1:累加器 参数2:用户自定义的输入值* @param avg* @param vc*/public void accumulate(Avg avg,Double vc){avg.sum += vc;avg.count++;}}}
四.表值聚合函数
自定义表值聚合函数(UDTAGG)可以把一个表(一行或者多行,每行有一列或者多列)聚合成另一张表,结果中可以有多行多列。
package com.atguigu.flink.day10;import com.atguigu.flink.day02.pojo.WaterSensor;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;import org.apache.flink.table.functions.AggregateFunction;import org.apache.flink.table.functions.TableAggregateFunction;import org.apache.flink.util.Collector;import static org.apache.flink.table.api.Expressions.$;import static org.apache.flink.table.api.Expressions.call;/*10 ..第一 1020第一 20第二 1030第一 30第二 20*/public class $05_FunctionTableAgg {public static void main(String[] args) throws Exception {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//读取集合中的数据DataStreamSource<WaterSensor> stream = env.fromElements(new WaterSensor("sensor_1", 1000L, 10),new WaterSensor("sensor_1", 2000L, 20),new WaterSensor("sensor_2", 3000L, 30),new WaterSensor("sensor_1", 4000L, 40),new WaterSensor("sensor_1", 4000L, 50),new WaterSensor("sensor_2", 6000L, 60));//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);Table table = tenv.fromDataStream(stream);//1.在table api中使用//1.1内联的方式table.groupBy($("id")).flatAggregate(call(Top2Function.class,$("vc"))).select($("id"),$("level"),$("value")).execute().print();//1.2注册后使用/*tenv.createTemporaryFunction("top2",Top2Function.class);table.groupBy($("id")).flatAggregate(call("top2",$("vc"))).select($("id"),$("level"),$("value")).execute().print();*///2.在SQL语句中使用//不支持}public static class FirstSecond{public Integer first = 0;public Integer second = 0;}public static class Result{public String level;public Integer value;public Result(String level, Integer value) {this.level = level;this.value = value;}}public static class Top2Function extends TableAggregateFunction<Result,FirstSecond>{//初始化累加器@Overridepublic FirstSecond createAccumulator() {return new FirstSecond();}//聚合public void accumulate(FirstSecond fs,Integer vc){if(vc > fs.first){fs.second = fs.first;fs.first = vc;}else if(vc > fs.second){fs.second = vc;}}//制表:通过out.collect()发射每行数据public void emitValue(FirstSecond fs, Collector<Result> out){out.collect(new Result("第一名",fs.first));if(fs.second>0){out.collect(new Result("第二名", fs.second));}}}}
第三章.SQL实现topN
1.介绍
目前仅 Blink 计划器支持 Top-N 。Flink 使用 OVER 窗口条件和过滤条件相结合以进行 Top-N 查询。利用 OVER 窗口的 PARTITION BY 子句的功能,Flink 还支持逐组 Top-N 。 例如,每个类别中实时销量最高的前五种产品。批处理表和流处理表都支持基于SQL的 Top-N 查询。流处理模式需注意: TopN 查询的结果会带有更新。 Flink SQL 会根据排序键对输入的流进行排序;若 top N 的记录发生了变化,变化的部分会以撤销、更新记录的形式发送到下游。 推荐使用一个支持更新的存储作为 Top-N 查询的 sink 。另外,若 top N 记录需要存储到外部存储,则结果表需要拥有与 Top-N 查询相同的唯一键。
2.实现
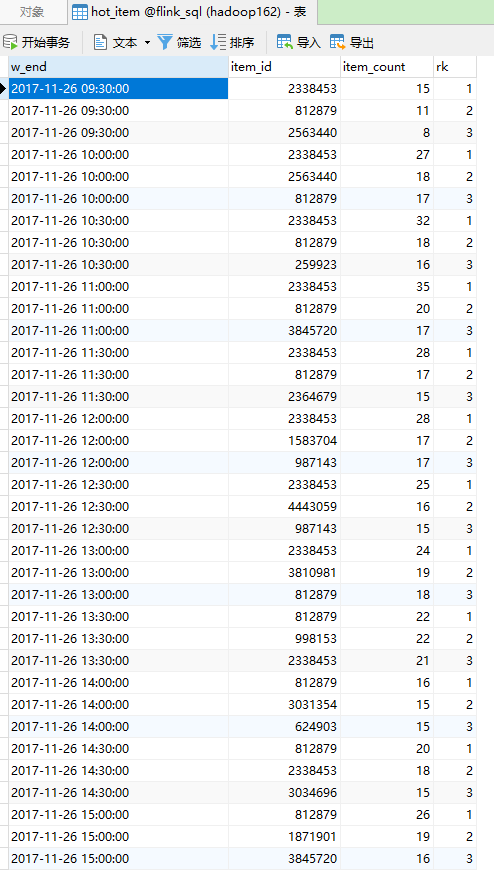
需求:每隔30分钟统计最近1小时的热门商品top3,并把统计的结果写入到mysql中
思路:
- 按照商品id,窗口(hop)分组,计算点击量
- 使用over窗口:按照点击量进行排序,每个数据添加一个排名(row_number)
- 使用where 过滤出来topN where rn <= 3
- 把结果写入到mysql中 官方建议:把topN的结果写入到支持更新的数据库中
- 数据源
input/UserBehavior.csv
- 在Mysql中创建表
CREATE DATABASE flink_sql;USE flink_sql;DROP TABLE IF EXISTS `hot_item`;CREATE TABLE `hot_item` (`w_end` timestamp NOT NULL,`item_id` bigint(20) NOT NULL,`item_count` bigint(20) NOT NULL,`rk` bigint(20) NOT NULL,PRIMARY KEY (`w_end`,`rk`)) ENGINE=InnoDB DEFAULT CHARSET=utf8;
- 导入JDBC Connector依赖
<dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-jdbc_${scala.binary.version}</artifactId><version>${flink.version}</version></dependency>
- 具体实现
package com.atguigu.flink.day10;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.table.api.Table;import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;/*** 需求:每隔30分钟统计最近1小时的热门商品top3,并把统计的结果写入到mysql中*/public class $08_TopN {public static void main(String[] args) {//获取流的执行环境StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);//获取表的执行环境StreamTableEnvironment tenv = StreamTableEnvironment.create(env);//1.先建立一个动态表与数据源关联 事件时间tenv.executeSql("create table ub(" +" user_id bigint, " +" item_id bigint, " +" category_id int, " +" behavior string, " +" ts bigint, " +" et as to_timestamp(from_unixtime(ts)), " +" watermark for et as et - interval '3' second " +")with(" +" 'connector' = 'filesystem', " +" 'path' = 'input/UserBehavior.csv', " +" 'format' = 'csv' " +")");//tenv.sqlQuery("select * from ub").execute().print();//2.过滤pv数据,按照商品id 开窗,聚合Table t1 = tenv.sqlQuery("select " +" item_id, " +" hop_start(et, interval '30' minute, interval '1' hour) stt, " +" hop_end(et, interval '30' minute, interval '1' hour) edt, " +" count(*) ct " +" from ub " +" where behavior='pv' " +" group by item_id, hop(et, interval '30' minute, interval '1' hour)");tenv.createTemporaryView("t1",t1);//3.使用over窗口给每个聚合结果排序 row_numberTable t2 = tenv.sqlQuery("select" +" * , " +" row_number() over(partition by edt order by ct desc) rn " +"from t1 ");tenv.createTemporaryView("t2",t2);//4.过滤出topNTable t3 = tenv.sqlQuery("select" +" edt w_end, " +" item_id, " +" ct item_count, " +" rn rk " +" from t2 " +"where rn <= 3");//t3.execute().print();// 5. 结果输出(sink:mysql)// 5.1 建立一张表与mysql关联tenv.executeSql("CREATE TABLE `hot_item` (\n" +" `w_end` timestamp ,\n" +" `item_id` bigint,\n" +" `item_count` bigint ,\n" +" `rk` bigint,\n" +" PRIMARY KEY (`w_end`,`rk`) not enforced\n" +")with(" +" 'connector'='jdbc', " +" 'url'='jdbc:mysql://hadoop162:3306/flink_sql?useSSL=false', " +" 'table-name'='hot_item', " +" 'username'='root', " +" 'password'='aaaaaa' " +") ");// 5.2 写入t3.executeInsert("hot_item");}}
第四章.双流join
在Flink中,支持两种方式的流的join:Window Join 和Interval Join
1.Window Join
窗口join会join具有相同的key并且处于同一个窗口的两个流的元素
- 所有的窗口join都是inner join,意味着a 流中的元素如果在b 流中没有对应的,则a 流中这个元素就不会处理了(就是忽略掉了)
- join成功后的元素会以所在窗口的最大时间作为时间戳,例如窗口[5,10),则元素会以9作为自己的时间戳
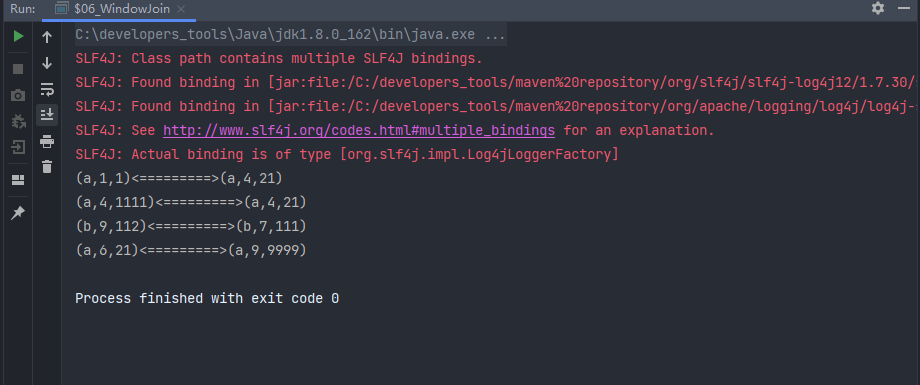
package com.atguigu.flink.day10;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.JoinFunction;import org.apache.flink.api.java.tuple.Tuple3;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;/*** window join*/public class $06_WindowJoin {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<Tuple3<String, Long, Integer>> ds1 = env.fromElements(Tuple3.of("a", 1L, 1),Tuple3.of("a", 6L, 21),Tuple3.of("b", 3L, 12),Tuple3.of("a", 4L, 1111),Tuple3.of("b", 9L, 112)).assignTimestampsAndWatermarks(WatermarkStrategy.<Tuple3<String, Long, Integer>>forMonotonousTimestamps().withTimestampAssigner((data, ts) -> data.f1 * 1000L));SingleOutputStreamOperator<Tuple3<String, Long, Integer>> ds2 = env.fromElements(Tuple3.of("a", 4L, 21),Tuple3.of("b", 7L, 111),Tuple3.of("d", 3L, 312),Tuple3.of("a", 9L, 9999),Tuple3.of("c", 3L, 110)).assignTimestampsAndWatermarks(WatermarkStrategy.<Tuple3<String, Long, Integer>>forMonotonousTimestamps().withTimestampAssigner((data, ts) -> data.f1 * 1000L));ds1.join(ds2).where(d1 -> d1.f0).equalTo(d2 -> d2.f0).window(TumblingEventTimeWindows.of(Time.seconds(5))).apply(new JoinFunction<Tuple3<String, Long, Integer>, Tuple3<String, Long, Integer>, String>() {@Overridepublic String join(Tuple3<String, Long, Integer> first, Tuple3<String, Long, Integer> second) throws Exception {//关联上的数据会进入这个方法//关联上:key一样,同一个窗口范围内return first + "<=========>" + second;}}).print();env.execute();}}
2.Interval Join
间隔流join(Interval Join)是指使用一个流的数据按照key去join另外一个流指定范围的数据
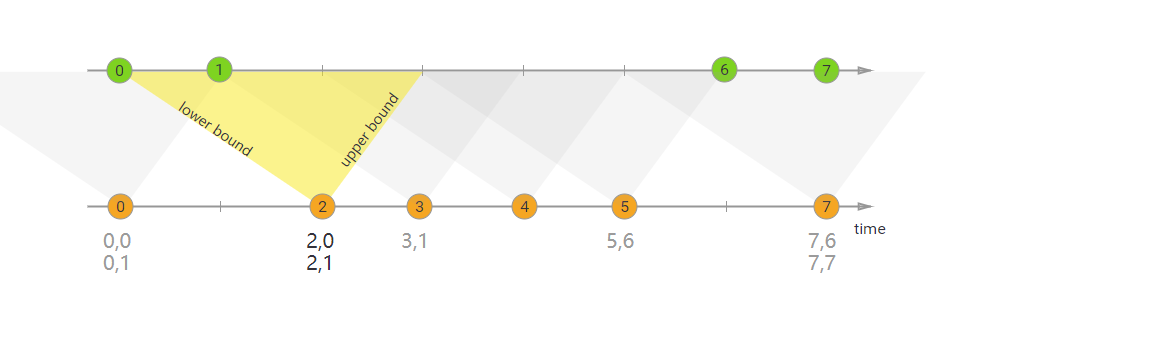
如下图:橙色的流去join绿色的流,范围是由橙色流的event-time + lower bound 和 event-time + upper bound来决定的
orangeElem.ts + lowerBound <= greenElem.ts <= orangeElem.ts + upperBound
package com.atguigu.flink.day10;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.api.common.functions.JoinFunction;import org.apache.flink.api.java.tuple.Tuple3;import org.apache.flink.streaming.api.datastream.KeyedStream;import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.co.ProcessJoinFunction;import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;import org.apache.flink.util.Collector;/*** Interval join* Intervaljoin实现的join效果,类似SQL里的innerjoin,取不到join不上的数据*/public class $07_IntervalJoin {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.setParallelism(1);SingleOutputStreamOperator<Tuple3<String, Long, Integer>> ds1 = env.fromElements(Tuple3.of("a", 1L, 1),Tuple3.of("a", 6L, 21),Tuple3.of("b", 3L, 12),Tuple3.of("a", 4L, 1111),Tuple3.of("b", 9L, 112)).assignTimestampsAndWatermarks(WatermarkStrategy.<Tuple3<String, Long, Integer>>forMonotonousTimestamps().withTimestampAssigner((data, ts) -> data.f1 * 1000L));SingleOutputStreamOperator<Tuple3<String, Long, Integer>> ds2 = env.fromElements(Tuple3.of("a", 4L, 21),Tuple3.of("b", 7L, 111),Tuple3.of("d", 3L, 312),Tuple3.of("a", 9L, 9999),Tuple3.of("c", 3L, 110)).assignTimestampsAndWatermarks(WatermarkStrategy.<Tuple3<String, Long, Integer>>forMonotonousTimestamps().withTimestampAssigner((data, ts) -> data.f1 * 1000L));//1.先按照关联条件 keyByKeyedStream<Tuple3<String, Long, Integer>, String> k1 = ds1.keyBy(d1 -> d1.f0);KeyedStream<Tuple3<String, Long, Integer>, String> k2= ds2.keyBy(d2 -> d2.f0);k1.intervalJoin(k2).between(Time.seconds(-3),Time.seconds(2)).process(new ProcessJoinFunction<Tuple3<String, Long, Integer>, Tuple3<String, Long, Integer>, String>() {@Overridepublic void processElement(Tuple3<String, Long, Integer> left, Tuple3<String, Long, Integer> right, Context ctx, Collector<String> out) throws Exception {out.collect(left + "<----------->" + right);}}).print();env.execute();}}

Interval Join原理:
- 底层使用的 connect + keyby
- 执行过程
- 两条流各初始化了一个状态,用来存储数据
- 先判断数据是否迟到,如果迟到,直接return,不处理
- 不管哪条流的数据来,都会存在自己的状态里
- 不管哪条流的数据来,都会遍历对方的状态,
- 如果在时间范围外,跳过
- 如果在时间范围内,join上—>发送给processElement方法 ——>我们实现的方法里拿到的就是join上的数据
- 清理数据的实现方式:注册一个定时器,到时间了就remove
第五章.海量数据实时去重
1.方案一:借用redis的Set
缺点:
- 需要频繁连接redis
- 如果数据量过大,对redis的内存也是一种压力
2.方案二:借用Flink的MapState
缺点:
- 如果数据量过大,状态后端最好选择RocksDBStateBackend
- 如果数据量过大, 对存储也有一定压力
3.方案三:使用布隆过滤器
布隆过滤器可以大大减少存储的数据的数据量
一.介绍
1.为什么需要布隆过滤器如果想判断一个元素是不是在一个集合里,一般想到的是将集合中所有元素保存起来,然后通过比较确定。链表、树、散列表(又叫哈希表,Hash table)等等数据结构都是这种思路。但是随着集合中元素的增加,我们需要的存储空间越来越大。同时检索速度也越来越慢,上述三种结构的检索时间复杂度分别为O(n),O(logn),O(1)。布隆过滤器即可以解决存储空间的问题, 又可以解决时间复杂度的问题.布隆过滤器的原理是,当一个元素被加入集合时,通过K个散列函数将这个元素映射成一个位数组中的K个点,把它们置为1。检索时,我们只要看看这些点是不是都是1就(大约)知道集合中有没有它了:如果这些点有任何一个0,则被检元素一定不在;如果都是1,则被检元素很可能在。这就是布隆过滤器的基本思想。
2.基本概念布隆过滤器(Bloom Filter,下文简称BF)由Burton Howard Bloom在1970年提出,是一种空间效率高的概率型数据结构。它专门用来检测集合中是否存在特定的元素。它实际上是一个很长的二进制向量和一系列随机映射函数。
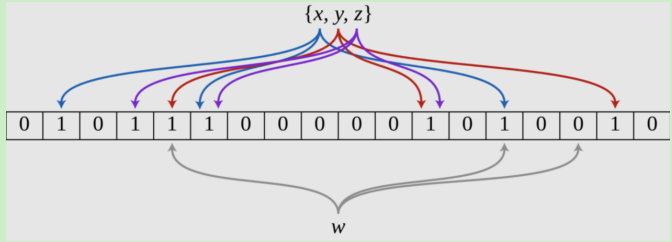
3.实现原理布隆过滤器的原理是,当一个元素被加入集合时,通过K个散列函数将这个元素映射成一个位数组中的K个点,把它们置为1。检索时,我们只要看看这些点是不是都是1就(大约)知道集合中有没有它了:如果这些点有任何一个0,则被检元素一定不在;如果都是1,则被检元素很可能在。这就是布隆过滤器的基本思想。BF是由一个长度为m比特的位数组(bit array)与k个哈希函数(hash function)组成的数据结构。位数组均初始化为0,所有哈希函数都可以分别把输入数据尽量均匀地散列。当要插入一个元素时,将其数据分别输入k个哈希函数,产生k个哈希值。以哈希值作为位数组中的下标,将所有k个对应的比特置为1。当要查询(即判断是否存在)一个元素时,同样将其数据输入哈希函数,然后检查对应的k个比特。如果有任意一个比特为0,表明该元素一定不在集合中。如果所有比特均为1,表明该集合有(较大的)可能性在集合中。为什么不是一定在集合中呢?因为一个比特被置为1有可能会受到其他元素的影响(hash碰撞),这就是所谓“假阳性”(false positive)。相对地,“假阴性”(false negative)在BF中是绝不会出现的。下图示出一个m=18, k=3的BF示例。集合中的x、y、z三个元素通过3个不同的哈希函数散列到位数组中。当查询元素w时,因为有一个比特为0,因此w不在该集合中。
4.优点一.不需要存储数据本身,只用比特表示,因此空间占用相对于传统方式有巨大的优势,并且能够保密数据;二.时间效率也较高,插入和查询的时间复杂度均为O(K), 所以他的时间复杂度实际是O(1)三.哈希函数之间相互独立,可以在硬件指令层面并行计算。
5.缺点一.存在假阳性的概率,不适用于任何要求100%准确率的情境二.只能插入和查询元素,不能删除元素,这与产生假阳性的原因是相同的。我们可以简单地想到通过计数(即将一个比特扩展为计数值)来记录元素数,但仍然无法保证删除的元素一定在集合中
6.使用场景所以,BF在对查准度要求没有那么苛刻,而对时间、空间效率要求较高的场合非常合适.另外,由于它不存在假阴性问题,所以用作“不存在”逻辑的处理时有奇效,比如可以用来作为缓存系统(如Redis)的缓冲,防止缓存穿
二.假阳性概率的计算
三.使用布隆过滤器实现去重
Flink已经内置了布隆过滤器的实现(使用的是google的Guava)
package com.atguigu.flink.day10;import com.atguigu.flink.day07.pojo.UserBehavior;import org.apache.flink.shaded.guava18.com.google.common.hash.Funnels;import org.apache.flink.api.common.eventtime.WatermarkStrategy;import org.apache.flink.shaded.guava18.com.google.common.hash.BloomFilter;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;import org.apache.flink.streaming.api.windowing.time.Time;import org.apache.flink.streaming.api.windowing.windows.TimeWindow;import org.apache.flink.util.Collector;import java.time.Duration;/*** 需求:指定时间范围内网站独立访客数(UV)的统计(使用布隆过滤器)*/public class $09_BloomFilter {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();env.readTextFile("input/UserBehavior.csv").map(line -> {String[] data = line.split(",");return new UserBehavior(Long.parseLong(data[0]),Long.parseLong(data[1]),Integer.parseInt(data[2]),data[3], Long.parseLong(data[4] ) * 1000);}).assignTimestampsAndWatermarks(WatermarkStrategy.<UserBehavior>forBoundedOutOfOrderness(Duration.ofSeconds(3)).withTimestampAssigner((ub,ts)-> ub.getTimestamp())).filter(ub -> "pv".equals(ub.getBehavior())).keyBy(ub -> ub.getBehavior()).window(TumblingEventTimeWindows.of(Time.minutes(30))).process(new ProcessWindowFunction<UserBehavior, String, String, TimeWindow>() {@Overridepublic void process(String s, Context context, Iterable<UserBehavior> elements, Collector<String> out) throws Exception {//1.创建一个布隆过滤器BloomFilter<Long> bf = BloomFilter.create(Funnels.longFunnel(), 1000000, 0.01);int uv = 0;for (UserBehavior element : elements) {if(bf.put(element.getUserId())){uv++;}}out.collect(context.window() +" " + uv);}}).print();env.execute();}}

若有收获,就点个赞吧
0 人点赞


