MR支持的压缩编码
| 压缩格式 | hadoop自带? | 算法 | 文件扩展名 | 是否可切分 | 切换压缩格式后,原代码是否需要修改 |
|---|---|---|---|---|---|
| DEFLATE | 是 | DEFLATE | .deflate | 否 | 和文本处理一样,不需要修改 |
| Gzip | 是 | DEFLATE | .gz | 否 | 和文本处理一样,不需要修改 |
| Bzip2 | 是 | bzip2 | .bz2 | 是 | 和文本处理一样,不需要修改 |
| LZO | 否,需要安装 | LZO | .lzo | 是 | 需要建立索引,还需要指定输入格式 |
| Snappy | 否,需要安装 | Snappy | .snappy | 否 | 和文本处理一样,不需要修改 |
编解码器
| 压缩格式 | 对应的编码/解码器 |
|---|---|
| DEFLATE | org.apache.hadoop.io.compress.DefaultCodec |
| Gzip | org.apache.hadoop.io.compress.GzipCodec |
| Bzip2 | org.apache.hadoop.io.compress.BZip2Codec |
| LZO | com.hadoop.compression.lzo.LzopCodec |
| Snappy | org.apache.hadoop.io.compress.SnappyCodec |
压缩性能比较
| 压缩算法 | 原始文件大小 | 压缩文件大小 | 压缩速度 | 解压速度 |
|---|---|---|---|---|
| Gzip | 8.3G | 1.8G | 17.5M/s | 58M/s |
| Bzip2 | 8.3G | 1.1GB | 2.4M/s | 9.5M/s |
| LZO | 8.3G | 2.9G | 49.3M/s | 74.6M/s |
在64位模式的核心i7处理器的单个核心上,Snappy以大约250MB/sec或更高的速度压缩,以大约500MB/sec或更高的速度解压缩。
压缩方式选择
在考虑压缩方式时候,压缩格式是否支持分割(Split)是很重要的。如果你是每日作业的小文件日志(在130M内左右),则可以无需考虑,否则并行度对MR作业至关重要。
Gzip
优点:压缩率较高,压缩/解压速度也较快;hadoop本身支持,在应用过程中处理gzip文件和直接处理文本一样;使用方便
缺点:不支持split
应用场景:每个文件压缩后在130M内(1个块大小内),可以考虑用Gzip压缩格式。
Bzip2
优点:支持Split;具有很高的压缩率;hadoop本身支持,但不支持native;
缺点:压缩/解压速度慢;不支持native
应用场景:适合对速度要求不高,但需要较高压缩率的适合,可以作为MR作业的输出格式;或者输入数据比较大,需要处理之后的数据存档小,减少磁盘空间的情况;
LZO
优点:支持Split,是hadoop中最流行的压缩格式;压缩/解压速度较块;
缺点:压缩率比Gzip要低一些,hadoop本身不支持,需要安装;在应用中对lzo格式的文件需要做一些特殊处理(为了支持split,需要建立索引,还需要指定inputFormat为lzo格式)
应用场景:一个很大的文本文件,压缩之后还大于200M以上,可以考虑,单个文件越大,lzo优点越明显;
Snappy
优点:告诉压缩/解压速度;合理压缩率
缺点:不支持Split,压缩率比Gzip低;hadoop本身不支持,需要安装
应用场景:当MR作业的map输出的数据较大时候,作为Map到Reduce的中间数据的压缩格式;或者作为一个MR作业的输出和另个MR作业的输入;
压缩位置选择
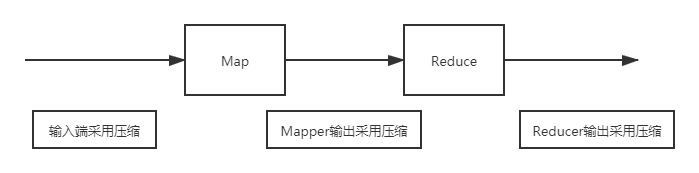
输入端采用压缩:在有大量数据并计划重复处理的情况下,应该考虑对输入进行压缩。然而,无须指定使用的编解码格式,Hadoop自动检查文件扩展名,如果扩展名能够匹配,就会用恰当的编解码方式对文件进行压缩和解压。否则,hadoop不会使用任何编解码器
Mapper端输出采用压缩:在Map任务输出的中间数据量很大时候,应考虑在此阶段采用压缩技术,这能显著改善内部数据shffle过程,shuffle过程在Hadoop处理过程中是资源消耗最多的环节。如果发现数据大造成网络传输缓慢,应该考虑使用压缩技术;可用于压缩Mapper输出的快速编解码器包括LZO和Snappy。
Reducer输出采用压缩:在此阶段启用压缩技术能够减少要存储的数据量,因此降低所需要的磁盘空间
压缩基本原则
运算密集型的job,少用压缩;数据量大的job,多用压缩

若有收获,就点个赞吧
0 人点赞


