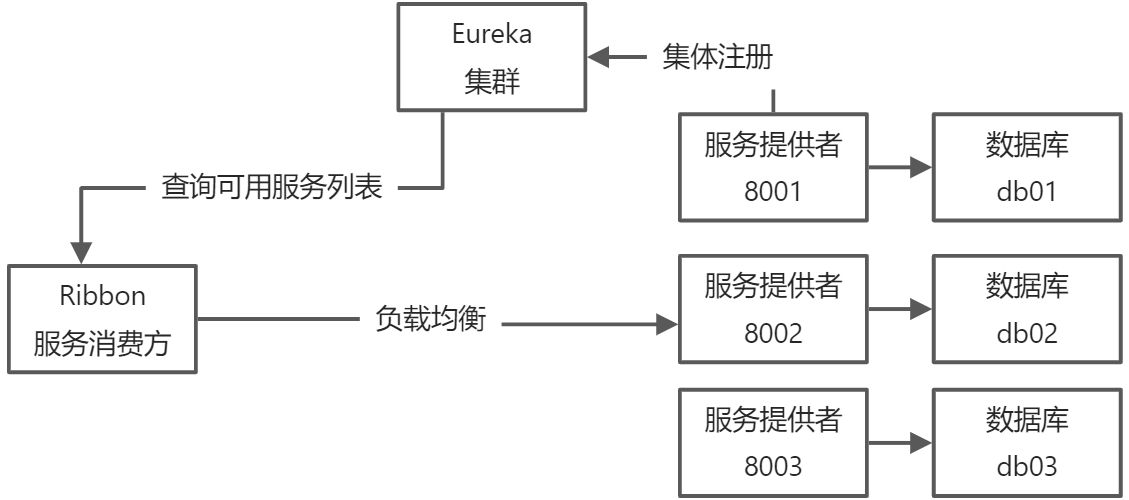
示意图
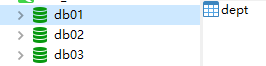
增加db数据库
增加服务提供者
springcloud-provider-dept-8082
springcloud-provider-dept-8083
通过springcloud父工程创建服务提供者子工程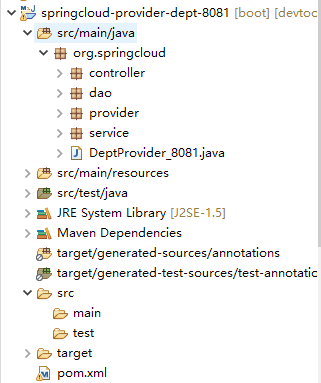
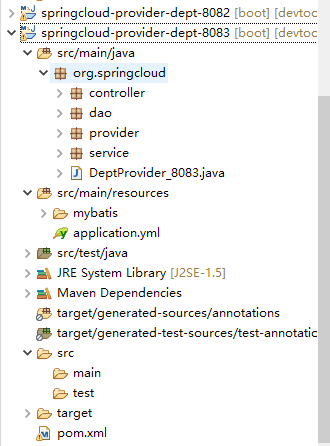
保持和springcloud-provider-dept-8081 一致,只修改yml文件中的数据库链接
#spring配置spring:application:name: springcloud-provider-dept #三个服务一致datasource:# 数据库名称type: com.alibaba.druid.pool.DruidDataSourcedriver-class-name: com.mysql.jdbc.Driverurl: jdbc:mysql://localhost:3306/db03?useUncode=true&characterEncoding=utf8&verifyServerCertificate=false&useSSL=false&allowMultiQueries=trueusername: rootpassword: root
启动eureka集群
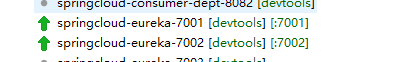
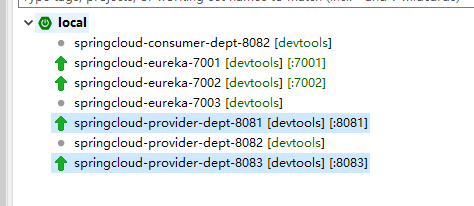
启动服务提供者

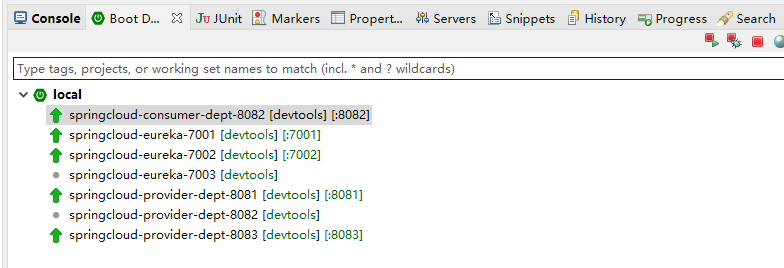
启动服务消费者
测试Ribbon负载均衡
第一次访问,调用db01数据库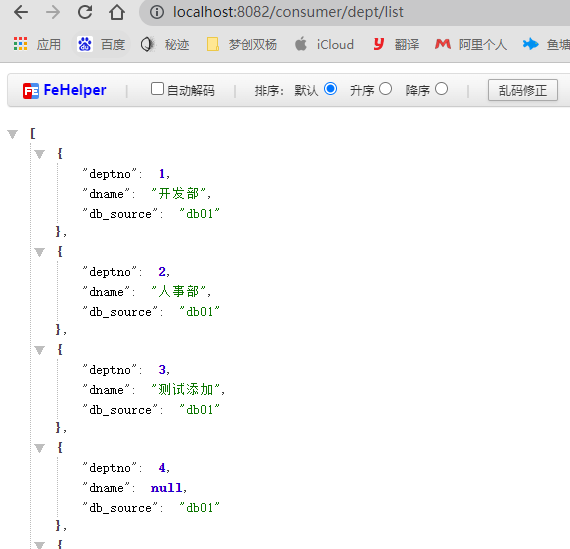
第二次访问,调用db01数据库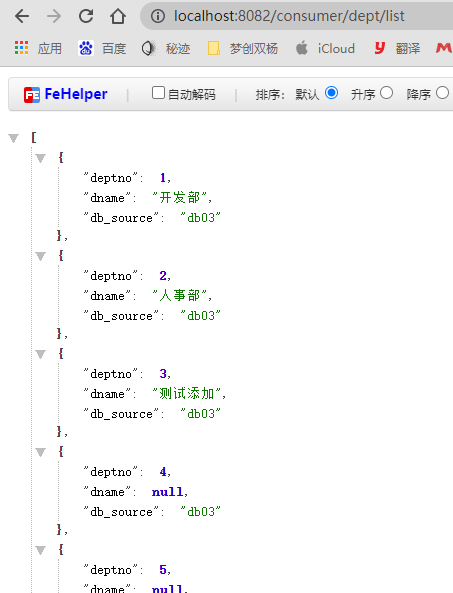
Ribbon默认轮询调用所以每次调用得到数据库不一样
ribbon有7种负载均衡策略可供选择:
| 策略类 | 命名 | 描述 |
|---|---|---|
| RandomRule | 随机策略 | 随机选择server |
| RoundRobinRule | 轮询策略 | 按照顺序选择server(ribbon默认策略) |
| RetryRule | 重试策略 | 在一个配置时间段内,当选择server不成功,则一直尝试选择一个可用的server |
| BestAvailableRule | 最低并发策略 | 逐个考察server,如果server断路器打开,则忽略,再选择其中并发链接最低的server |
| AvailabilityFilteringRule | 可用过滤策略 | 过滤掉一直失败并被标记为circuit tripped的server,过滤掉那些高并发链接的server(active connections超过配置的阈值) |
| ResponseTimeWeightedRule | 响应时间加权重策略 | 根据server的响应时间分配权重,响应时间越长,权重越低,被选择到的概率也就越低。响应时间越短,权重越高,被选中的概率越高,这个策略很贴切,综合了各种因素,比如:网络,磁盘,io等,都直接影响响应时间 |
| ZoneAvoidanceRule | 区域权重策略 | 综合判断server所在区域的性能,和server的可用性,轮询选择server并且判断一个AWS Zone的运行性能是否可用,剔除不可用的Zone中的所有server |
自定义负载均衡算法
IRul实现
负载均衡的核心实现,IRul路由网关,项目网关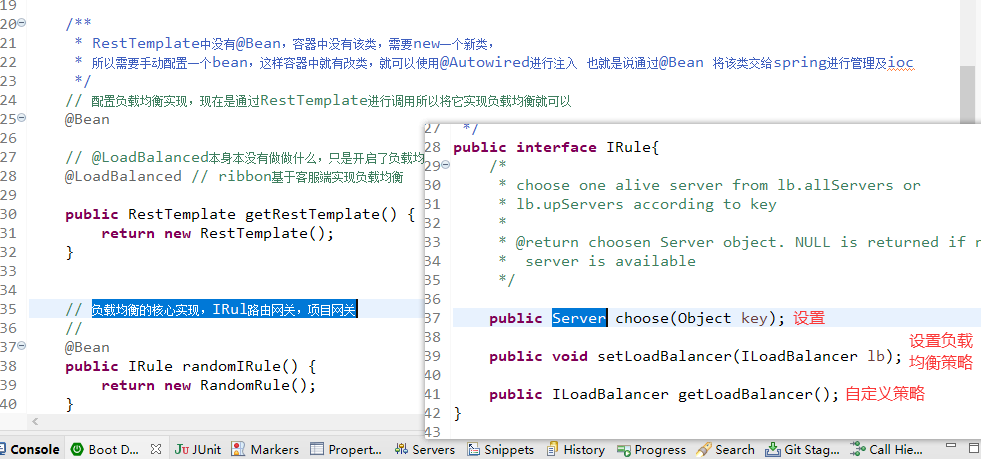
IRule接口有许多实现类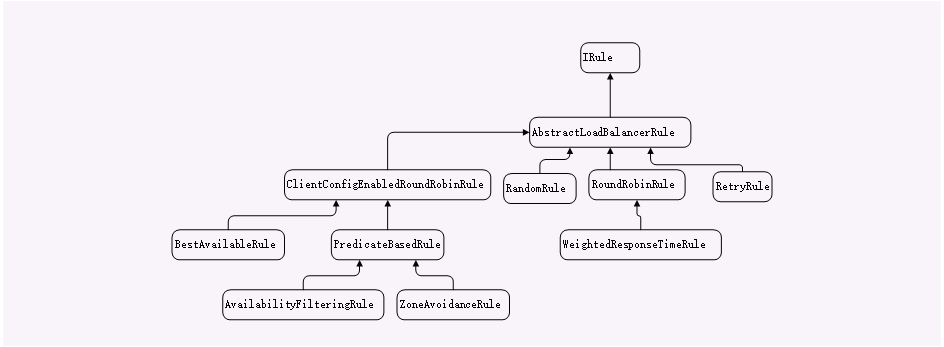
1、AbstractLoadBalancerRule
AbstractLoadBalancerRule类是负载均衡策略IRule的抽象实现类,在该抽象类中定义了负载均衡器ILoadBalancer对象,该对象能够在具体实现选择服务策略时,获取到一些负载均衡器中维护的信息来作为分配依据,并依次设计一些算法来针对特定场景的高级策略。
public abstract class AbstractLoadBalancerRule implements IRule, IClientConfigAware {private ILoadBalancer lb;@Overridepublic void setLoadBalancer(ILoadBalancer lb){this.lb = lb;}@Overridepublic ILoadBalancer getLoadBalancer(){return lb;}}
2、RandomRule
随机
该策略实现了从服务实例清单中随机选择一个服务实例的功能。从下面的源码可以看到,该实现类的choose方法传入了一个负载均衡器,并且使用负载均衡器获取对应的可用服务列表和全部服务列表,并通过chooseRandomInt方法获取一个随机数,该随机数作为可用服务列表的索引来获取具体的实例。这里有个问题,选择服务实例时使用的是while获取,正常情况下,每次选择都应该能选择一个实例进行返回,但是如果出现异常导致每一次都获取步到可用的实例,那么如果出现死循环而获取不到服务实例时,则很有可能存在并发的BUG。
public Server choose(ILoadBalancer lb, Object key) {if (lb == null) {return null;}Server server = null;while (server == null) {if (Thread.interrupted()) {return null;}List<Server> upList = lb.getReachableServers();List<Server> allList = lb.getAllServers();int serverCount = allList.size();if (serverCount == 0) {/** No servers. End regardless of pass, because subsequent passes* only get more restrictive.*/return null;}int index = chooseRandomInt(serverCount);server = upList.get(index);if (server == null) {/** The only time this should happen is if the server list were* somehow trimmed. This is a transient condition. Retry after* yielding.*/Thread.yield();continue;}if (server.isAlive()) {return (server);}// Shouldn't actually happen.. but must be transient or a bug.server = null;Thread.yield();}return server;}
3、RoundRobinRule
轮询
该策略实现了按照轮询的方式依次选择每个服务实例的功能。该实现和上述的RandomRule类似,只是获取逻辑不同,该负载均衡策略实现逻辑是直接获取下一个可用实例,如果超过10次没有获取到可用的实例,则返回空且打印异常信息。
public Server choose(ILoadBalancer lb, Object key) {if (lb == null) {log.warn("no load balancer");return null;}Server server = null;int count = 0;while (server == null && count++ < 10) {List<Server> reachableServers = lb.getReachableServers();List<Server> allServers = lb.getAllServers();int upCount = reachableServers.size();int serverCount = allServers.size();if ((upCount == 0) || (serverCount == 0)) {log.warn("No up servers available from load balancer: " + lb);return null;}int nextServerIndex = incrementAndGetModulo(serverCount);server = allServers.get(nextServerIndex);if (server == null) {/* Transient. */Thread.yield();continue;}if (server.isAlive() && (server.isReadyToServe())) {return (server);}// Next.server = null;}if (count >= 10) {log.warn("No available alive servers after 10 tries from load balancer: "+ lb);}return server;}
4、RetryRule
会先按照轮询获取服务,如果服务失败,则会选择指定时间内选择重试
该策略实现了一个具备重试机制的实力选择功能。重下述源码可以看出,其选择服务实例使用的是轮询选择策略RoundRobinRule,然后在获取不到服务实例的情况下,则反复尝试获取,直到调用时间超过设置的阈值,则返回空。
IRule subRule = new RoundRobinRule();long maxRetryMillis = 500;public Server choose(ILoadBalancer lb, Object key) {long requestTime = System.currentTimeMillis();long deadline = requestTime + maxRetryMillis;Server answer = null;answer = subRule.choose(key);if (((answer == null) || (!answer.isAlive()))&& (System.currentTimeMillis() < deadline)) {InterruptTask task = new InterruptTask(deadline- System.currentTimeMillis());while (!Thread.interrupted()) {answer = subRule.choose(key);if (((answer == null) || (!answer.isAlive()))&& (System.currentTimeMillis() < deadline)) {/* pause and retry hoping it's transient */Thread.yield();} else {break;}}task.cancel();}if ((answer == null) || (!answer.isAlive())) {return null;} else {return answer;}}
5、WeightedResponseTimeRule
该策略继承自RoundRobinRule,增加了根据实例的运行情况来计算权重,并根据权重来挑选实例,以达到更优的分配效果,其核心内容分为三块:定时任务、权重计算、实例选择
(1)定时任务
@Overridepublic void setLoadBalancer(ILoadBalancer lb) {super.setLoadBalancer(lb);if (lb instanceof BaseLoadBalancer) {name = ((BaseLoadBalancer) lb).getName();}initialize(lb);}public static final int DEFAULT_TIMER_INTERVAL = 30 * 1000;private int serverWeightTaskTimerInterval = DEFAULT_TIMER_INTERVAL;void initialize(ILoadBalancer lb) {if (serverWeightTimer != null) {serverWeightTimer.cancel();}serverWeightTimer = new Timer("NFLoadBalancer-serverWeightTimer-"+ name, true);serverWeightTimer.schedule(new DynamicServerWeightTask(), 0,serverWeightTaskTimerInterval);// do a initial runServerWeight sw = new ServerWeight();sw.maintainWeights();Runtime.getRuntime().addShutdownHook(new Thread(new Runnable() {public void run() {logger.info("Stopping NFLoadBalancer-serverWeightTimer-"+ name);serverWeightTimer.cancel();}}));}class DynamicServerWeightTask extends TimerTask {public void run() {ServerWeight serverWeight = new ServerWeight();try {serverWeight.maintainWeights();} catch (Exception e) {logger.error("Error running DynamicServerWeightTask for {}", name, e);}}}
从上述源码可见,在设置负载均衡策略对应的负载均衡器时,调用了initialize方法,而该方法创建了一个定时任务来计算权重(最终调用的serverWeight.maintainWeights()方法),每30秒执行一次。
(2)权重计算
private volatile List<Double> accumulatedWeights = new ArrayList<Double>();class ServerWeight {public void maintainWeights() {ILoadBalancer lb = getLoadBalancer();if (lb == null) {return;}if (!serverWeightAssignmentInProgress.compareAndSet(false, true)) {return;}try {logger.info("Weight adjusting job started");AbstractLoadBalancer nlb = (AbstractLoadBalancer) lb;LoadBalancerStats stats = nlb.getLoadBalancerStats();if (stats == null) {// no statistics, nothing to doreturn;}double totalResponseTime = 0;// find maximal 95% response timefor (Server server : nlb.getAllServers()) {// this will automatically load the stats if not in cacheServerStats ss = stats.getSingleServerStat(server);totalResponseTime += ss.getResponseTimeAvg();}// weight for each server is (sum of responseTime of all servers - responseTime)// so that the longer the response time, the less the weight and the less likely to be chosenDouble weightSoFar = 0.0;// create new list and hot swap the referenceList<Double> finalWeights = new ArrayList<Double>();for (Server server : nlb.getAllServers()) {ServerStats ss = stats.getSingleServerStat(server);double weight = totalResponseTime - ss.getResponseTimeAvg();weightSoFar += weight;finalWeights.add(weightSoFar);}setWeights(finalWeights);} catch (Exception e) {logger.error("Error calculating server weights", e);} finally {serverWeightAssignmentInProgress.set(false);}}}void setWeights(List<Double> weights) {this.accumulatedWeights = weights;}
通过源码可见,代码中维护一个用于存储权重的List集合accumulatedWeights,同时,通过maintainWeights方法做了权重计算,该计算主要分为两步,第一步,根据LoadBalancerStatus中记录的每个实例的统计信息,累加所有实例的平均响应时间,得到总的响应时间totalResponseTime;第二步,为负载均衡器中维护的实例清单逐个计算权重(从第一个开始),计算规则为weightSoFar+totalResponseTime-实例的平均响应时间,其中weightSoFar的初始值为0。
举个例子,如果有ABCD4个实例,他们的平均响应时间是10、40、80、100,那么总的相应时间就是230,那么计算出4个实例的权重分别为:
A:230-10 = 220
B:220+(230-40) = 410
C:410+(230-80) = 560
D:560+(230-100) = 690
权重区间是左开右闭,但是第一个和最后一个比较特殊,由于在后续选择实例时会用随机数从区间中获取,但是随机数最小值可以是0,但是不会到达随机数的最大值,因此第一个左边的0是闭区间,而最后一个的右侧是开区间,因此这4个实例对应的权重区间即为:
A:[0,220]
B:(220,410]
C:(410,560]
D:(560,690)
不难发现,区间的宽度就是总的平均响应时间-实例的平均响应时间,因此实例的平均响应时间越短,那么权重的区间就越大,那么被选中的几率就越大。
(3)实例选择
public Server choose(ILoadBalancer lb, Object key) {if (lb == null) {return null;}Server server = null;while (server == null) {// get hold of the current reference in case it is changed from the other threadList<Double> currentWeights = accumulatedWeights;if (Thread.interrupted()) {return null;}List<Server> allList = lb.getAllServers();int serverCount = allList.size();if (serverCount == 0) {return null;}int serverIndex = 0;// last one in the list is the sum of all weightsdouble maxTotalWeight = currentWeights.size() == 0 ? 0 : currentWeights.get(currentWeights.size() - 1);// No server has been hit yet and total weight is not initialized// fallback to use round robinif (maxTotalWeight < 0.001d || serverCount != currentWeights.size()) {server = super.choose(getLoadBalancer(), key);if(server == null) {return server;}} else {// generate a random weight between 0 (inclusive) to maxTotalWeight (exclusive)double randomWeight = random.nextDouble() * maxTotalWeight;// pick the server index based on the randomIndexint n = 0;for (Double d : currentWeights) {if (d >= randomWeight) {serverIndex = n;break;} else {n++;}}server = allList.get(serverIndex);}if (server == null) {/* Transient. */Thread.yield();continue;}if (server.isAlive()) {return (server);}// Next.server = null;}return server;}
通过上述源码可见,其首先生成了一个 [0,最大权重值) 区间内的随机数,然后循环权重区间,如果该随机数在权限区间内,则就拿当前权重列表的索引去服务实例获取对应的服务。还是以上面的ABCD四个实例来说明,那么随机数就是从 [0,690) 的区间中获取,如果获取的随机数数230,那么该随机数在实例B的权重区间内,因此就会选择B实例。
6、ClientConfigEnabledRoundRobinRule
该策略比较特殊,一般不会使用它。因为它本身没有什么特殊的处理逻辑,正如下面源码所示,该策略在内部定义了一个RoundRobinRule策略,而choose函数调用的就是RoundRobinRule的choose函数。该类主要的作用就是通过继承该类,在子类中做一些其他的策略时,如果条件不满足,则会使用父类的策略。
public class ClientConfigEnabledRoundRobinRule extends AbstractLoadBalancerRule {RoundRobinRule roundRobinRule = new RoundRobinRule();@Overridepublic void initWithNiwsConfig(IClientConfig clientConfig) {roundRobinRule = new RoundRobinRule();}@Overridepublic void setLoadBalancer(ILoadBalancer lb) {super.setLoadBalancer(lb);roundRobinRule.setLoadBalancer(lb);}@Overridepublic Server choose(Object key) {if (roundRobinRule != null) {return roundRobinRule.choose(key);} else {throw new IllegalArgumentException("This class has not been initialized with the RoundRobinRule class");}}}
7、BestAvailableRule
该策略会选出负载最低的实例。
BestAvailableRule继承自ClientConfigEnabledRoundRobinRule,从choose方法看,会循环所有Server实例,过滤掉故障实例并选出负载最低的Server。同时我们可以发现,如果没有选择到Server的话,就会调用父类的choose方法,那么就会使用到上面说的 “通过继承该类,在子类中做一些其他的策略时,如果条件不满足,则会使用父类的策略” 。
public class BestAvailableRule extends ClientConfigEnabledRoundRobinRule {private LoadBalancerStats loadBalancerStats;@Overridepublic Server choose(Object key) {if (loadBalancerStats == null) {return super.choose(key);}List<Server> serverList = getLoadBalancer().getAllServers();int minimalConcurrentConnections = Integer.MAX_VALUE;long currentTime = System.currentTimeMillis();Server chosen = null;for (Server server: serverList) {ServerStats serverStats = loadBalancerStats.getSingleServerStat(server);if (!serverStats.isCircuitBreakerTripped(currentTime)) {int concurrentConnections = serverStats.getActiveRequestsCount(currentTime);if (concurrentConnections < minimalConcurrentConnections) {minimalConcurrentConnections = concurrentConnections;chosen = server;}}}if (chosen == null) {return super.choose(key);} else {return chosen;}}@Overridepublic void setLoadBalancer(ILoadBalancer lb) {super.setLoadBalancer(lb);if (lb instanceof AbstractLoadBalancer) {loadBalancerStats = ((AbstractLoadBalancer) lb).getLoadBalancerStats();}}}
8、PredicateBasedRule
该策略实现了先通过子类获取一部分实例,然后通过线性轮询的方式从该部分实例中获取一个实例。
PredicateBasedRule继承自ClientConfigEnabledRoundRobinRule,是一个抽象类,它首先使用getPredicate方法获取一个AbstractServerPredicate的实现。而choose方法则是调用AbstractServerPredicate类的chooseRoundRobinAfterFiltering方法获取对应的Server实例并返回。
public abstract class PredicateBasedRule extends ClientConfigEnabledRoundRobinRule {public abstract AbstractServerPredicate getPredicate();@Overridepublic Server choose(Object key) {ILoadBalancer lb = getLoadBalancer();Optional<Server> server = getPredicate().chooseRoundRobinAfterFiltering(lb.getAllServers(), key);if (server.isPresent()) {return server.get();} else {return null;}}}
通过chooseRoundRobinAfterFiltering方法可以看到,其先是调用getEligibleServers方法获取了一部分实例,然后又调用了eligible.get(incrementAndGetModulo(eligible.size()))方法从该部分实例中动态获取了一个Server。其中getEligibleServers方法是根据this.apply(new PredicateKey(loadBalancerKey, server))进行过滤的,如果满足,就添加到返回的集合中,而apply方法,在AbstractServerPredicate中并不存在,因此需要子类实现;而incrementAndGetModulo方法则是直接返回了下一个整数(索引值),通过该索引值从返回的实例列表中取得Server实例。
public Optional<Server> chooseRoundRobinAfterFiltering(List<Server> servers, Object loadBalancerKey) {List<Server> eligible = getEligibleServers(servers, loadBalancerKey);if (eligible.size() == 0) {return Optional.absent();}return Optional.of(eligible.get(incrementAndGetModulo(eligible.size())));}public List<Server> getEligibleServers(List<Server> servers, Object loadBalancerKey) {if (loadBalancerKey == null) {return ImmutableList.copyOf(Iterables.filter(servers, this.getServerOnlyPredicate()));} else {List<Server> results = Lists.newArrayList();for (Server server: servers) {if (this.apply(new PredicateKey(loadBalancerKey, server))) {results.add(server);}}return results;}}private int incrementAndGetModulo(int modulo) {for (;;) {int current = nextIndex.get();int next = (current + 1) % modulo;if (nextIndex.compareAndSet(current, next) && current < modulo)return current;}}
9、AvailabilityFilteringRule
会先过滤掉跳闸的,访问故障的访问,对剩下的访问进行轮询,对轮询进行优化
public class AvailabilityFilteringRule extends PredicateBasedRule {private AbstractServerPredicate predicate;public AvailabilityFilteringRule() {super();predicate = CompositePredicate.withPredicate(new AvailabilityPredicate(this, null)).addFallbackPredicate(AbstractServerPredicate.alwaysTrue()).build();}@Overridepublic void initWithNiwsConfig(IClientConfig clientConfig) {predicate = CompositePredicate.withPredicate(new AvailabilityPredicate(this, clientConfig)).addFallbackPredicate(AbstractServerPredicate.alwaysTrue()).build();}@Overridepublic Server choose(Object key) {int count = 0;Server server = roundRobinRule.choose(key);while (count++ <= 10) {if (predicate.apply(new PredicateKey(server))) {return server;}server = roundRobinRule.choose(key);}return super.choose(key);}@Overridepublic AbstractServerPredicate getPredicate() {return predicate;}}
该策略实现了轮询获取Server并校验Server状态的功能。
AvailabilityFilteringRule继承自PredicateBasedRule,从其choose方法可见,其并没有完全使用父类的实现方式,而是先轮询获取一个Server,然后判断该Server是否满足需要,如果满足,直接返回;如果不满足,就继续获取下一个Server,如果一直轮询10次还没有符合要求的Server,那么再使用父类的实现方式(先获取所有满足需求的Server列表,然后从该Server列表中轮询获取一个Server对象)
同时从AvailabilityFilteringRule构造函数中可以看到,AvailabilityFilteringRule使用的是AvailabilityPredicate,根据上面讲述的PredicateBasedRule,其必须要实现apply方法,从下述源码可见,apply方法主要是通过shouldSkipServer方法进行判断的,在该方法中,有两个判断维度:是否故障(断路器是否断开)、实例的并发请求数是否大于阈值(int的最大值)
private static final DynamicBooleanProperty CIRCUIT_BREAKER_FILTERING =DynamicPropertyFactory.getInstance().getBooleanProperty("niws.loadbalancer.availabilityFilteringRule.filterCircuitTripped", true);private static final DynamicIntProperty ACTIVE_CONNECTIONS_LIMIT =DynamicPropertyFactory.getInstance().getIntProperty("niws.loadbalancer.availabilityFilteringRule.activeConnectionsLimit", Integer.MAX_VALUE);private ChainedDynamicProperty.IntProperty activeConnectionsLimit = new ChainedDynamicProperty.IntProperty(ACTIVE_CONNECTIONS_LIMIT);@Overridepublic boolean apply(@Nullable PredicateKey input) {LoadBalancerStats stats = getLBStats();if (stats == null) {return true;}return !shouldSkipServer(stats.getSingleServerStat(input.getServer()));}private boolean shouldSkipServer(ServerStats stats) {if ((CIRCUIT_BREAKER_FILTERING.get() && stats.isCircuitBreakerTripped())|| stats.getActiveRequestsCount() >= activeConnectionsLimit.get()) {return true;}return false;}
10、ZoneAvoidanceRule
ZoneAvoidanceRule同样继承自PredicateBasedRule,同时ZoneAvoidanceRule中没有choose方法,说明完全复用了父类中的策略(先过滤所有可用的实例,然后使用轮询从满足需要的实例清单中获取一个Server)。同时通过ZoneAvoidanceRule的构造函数可见,使用的是CompositePredicate进行的过滤,CompositePredicate的构造函数传入了两个AbstractServerPredicate的子类,分别是主过滤条件ZoneAvoidancePredicate和次过滤条件AvailabilityPredicate(其实次过滤条件可以传入多个)
public ZoneAvoidanceRule() {super();ZoneAvoidancePredicate zonePredicate = new ZoneAvoidancePredicate(this);AvailabilityPredicate availabilityPredicate = new AvailabilityPredicate(this);compositePredicate = createCompositePredicate(zonePredicate, availabilityPredicate);}private CompositePredicate createCompositePredicate(ZoneAvoidancePredicate p1, AvailabilityPredicate p2) {return CompositePredicate.withPredicates(p1, p2).addFallbackPredicate(p2).addFallbackPredicate(AbstractServerPredicate.alwaysTrue()).build();}
首先可以看下CompositePredicate的构造函数相关,可以看到,上一步在创建CompositePredicate对象时:
首先调用了withPredicates方法,该方法调用了Builder(primaryPredicates),最后调用了Builder(AbstractServerPredicate …primaryPredicates)方法,在该方法中,将第一个过滤对象(ZoneAvoidancePredicate)赋值给delegate属性;
其次又调用了addFallbackPredicate方法,在该方法中,将第二个过滤对象(AvailabilityPredicate)赋值给了fallbacks属性
private AbstractServerPredicate delegate;private List<AbstractServerPredicate> fallbacks = Lists.newArrayList();private int minimalFilteredServers = 1;private float minimalFilteredPercentage = 0;public static class Builder {private CompositePredicate toBuild;Builder(AbstractServerPredicate primaryPredicate) {toBuild = new CompositePredicate();toBuild.delegate = primaryPredicate;}Builder(AbstractServerPredicate ...primaryPredicates) {toBuild = new CompositePredicate();Predicate<PredicateKey> chain = Predicates.<PredicateKey>and(primaryPredicates);toBuild.delegate = AbstractServerPredicate.ofKeyPredicate(chain);}public Builder addFallbackPredicate(AbstractServerPredicate fallback) {toBuild.fallbacks.add(fallback);return this;}public Builder setFallbackThresholdAsMinimalFilteredNumberOfServers(int number) {toBuild.minimalFilteredServers = number;return this;}public Builder setFallbackThresholdAsMinimalFilteredPercentage(float percent) {toBuild.minimalFilteredPercentage = percent;return this;}public CompositePredicate build() {return toBuild;}}public static Builder withPredicates(AbstractServerPredicate ...primaryPredicates) {return new Builder(primaryPredicates);}public static Builder withPredicate(AbstractServerPredicate primaryPredicate) {return new Builder(primaryPredicate);}
然后可以看到CompositePredicate重写了父类中的getEligibleServers方法,因此,在获取满足条件Server集合时,就会调用CompositePredicate中的getEligibleServers方法,在该方法中,首先调用super.getEligibleServers(servers, loadBalancerKey),那么就会调用到CompositePredicate实现的apply方法,通过源码可以看到,这里直接调用了delegate.apply(input),也就是直接使用了主过滤类ZoneAvoidancePredicate的apply方法,获取到可用的服务列表后,在依次调用次过滤类(次过滤类可以是多个,CompositePredicate里只有一个AvailabilityPredicate)的getEligibleServers方法进行过滤。
CompositePredicate的总体处理逻辑如下:
(1)使用主过滤类对所有实例过滤并返回过滤后的清单
(2)依次使用次过滤类对已筛选出的清单进行再次过滤
(3)每次过滤之后,判断如果满足下面两个条件的话,就不再过滤:
过滤后的实例总数 >= 最小过滤实例数(默认值为1)
过滤后的实例比例 > 最小过滤百分比(默认值为0)
主过滤类ZoneAvoidancePredicate的apply方法在讲述SpringCloud—Ribbon—源码解析—IloadBalancer&ServerListUpdater&ServerListFilter实现的ZoneAwareLoadBalancer过滤器的时候,已经解析过源码,这里就不再赘述。
@Overridepublic boolean apply(@Nullable PredicateKey input) {return delegate.apply(input);}@Overridepublic List<Server> getEligibleServers(List<Server> servers, Object loadBalancerKey) {List<Server> result = super.getEligibleServers(servers, loadBalancerKey);Iterator<AbstractServerPredicate> i = fallbacks.iterator();while (!(result.size() >= minimalFilteredServers && result.size() > (int) (servers.size() * minimalFilteredPercentage))&& i.hasNext()) {AbstractServerPredicate predicate = i.next();result = predicate.getEligibleServers(servers, loadBalancerKey);}return result;}
自定义轮询
源码分析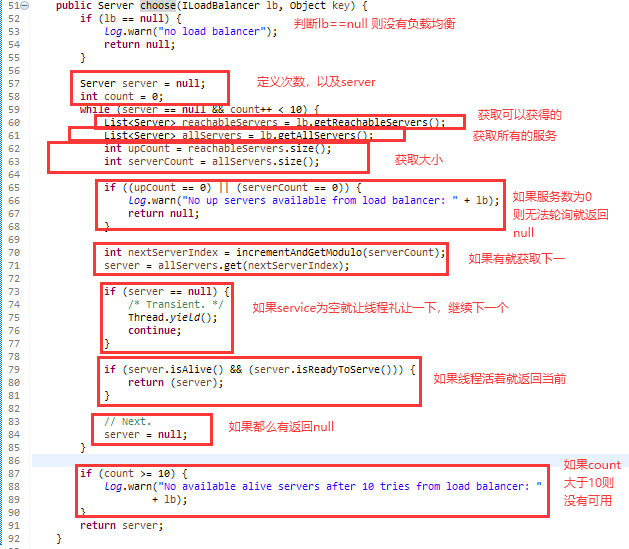
更改ribbonconfig 类 实现随机访问
package org.springcloud.config;import org.springframework.cloud.client.loadbalancer.LoadBalanced;import org.springframework.context.annotation.Bean;import org.springframework.context.annotation.Configuration;import org.springframework.web.client.RestTemplate;import com.netflix.loadbalancer.IRule;import com.netflix.loadbalancer.RandomRule;// 相当于spring 中的 applicationContext.xml//指示一个类声明一个或多个@Bean方法,并且可以由Spring容器处理,以便在运行时为这些bean生成BeanDefinition和服务请求@Configurationpublic class ConfigBean {// 原来是<bean></bean>// 现在使用spring注解/*** RestTemplate中没有@Bean,容器中没有该类,需要new一个新类,* 所以需要手动配置一个bean,这样容器中就有改类,就可以使用@Autowired进行注入 也就是说通过@Bean 将该类交给spring进行管理及ioc*/// 配置负载均衡实现,现在是通过RestTemplate进行调用所以将它实现负载均衡就可以@Bean// @LoadBalanced本身本没有做做什么,只是开启了负载均衡@LoadBalanced // ribbon基于客服端实现负载均衡public RestTemplate getRestTemplate() {return new RestTemplate();}// 负载均衡的核心实现,IRul路由网关,项目网关//@Beanpublic IRule myIRule() {// 使用随机return new RandomRule();}}
测试结果则为随机访问服务提供者,结果也是随机的数据库。
编辑ribbon config 类
主要启动类中添加 @RibbonClient(name=”SPRINGCLOUD-PROVIDER-DEPT”) 告诉程序我们要对SPRINGCLOUD-PROVIDER-DEPT进行改造
package org.springcloud;import org.springcloud.config.RibbonConfig;import org.springframework.boot.SpringApplication;import org.springframework.boot.autoconfigure.EnableAutoConfiguration;import org.springframework.boot.autoconfigure.SpringBootApplication;import org.springframework.boot.autoconfigure.jdbc.DataSourceAutoConfiguration;import org.springframework.cloud.client.discovery.EnableDiscoveryClient;import org.springframework.cloud.netflix.ribbon.RibbonClient;@SpringBootApplication@EnableAutoConfiguration(exclude = { DataSourceAutoConfiguration.class })@EnableDiscoveryClient// 在微服务启动时候就对SPRINGCLOUD-PROVIDER-DEPT进行Ribbon负载均衡改造,改造配置类RibbonConfig.class@RibbonClient(name = "SPRINGCLOUD-PROVIDER-DEPT", configuration = RibbonConfig.class)public class DeptConsumer_8082 {public static void main(String[] args) {SpringApplication.run(DeptConsumer_8082.class, args);}}
自定义Ribbon客户端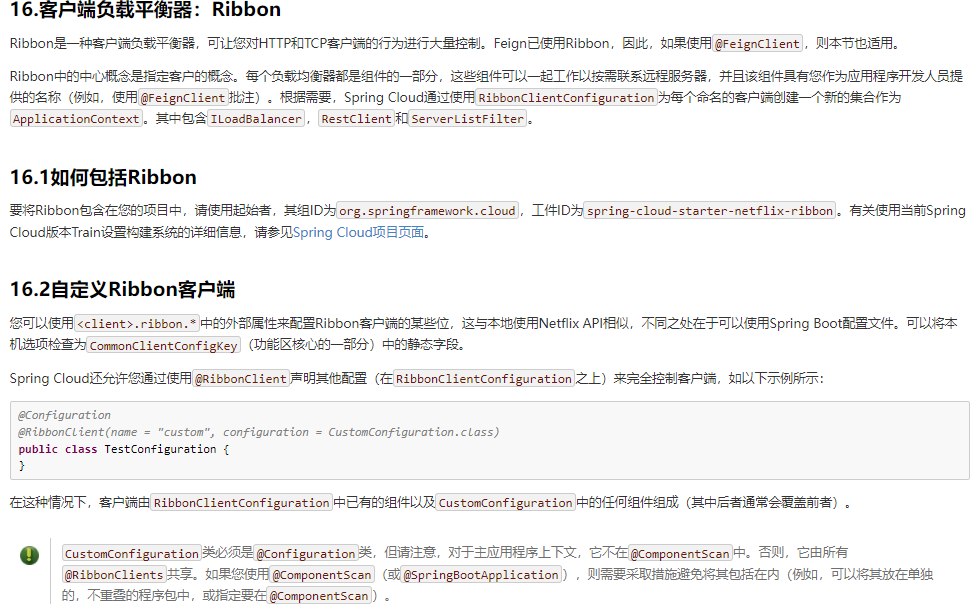
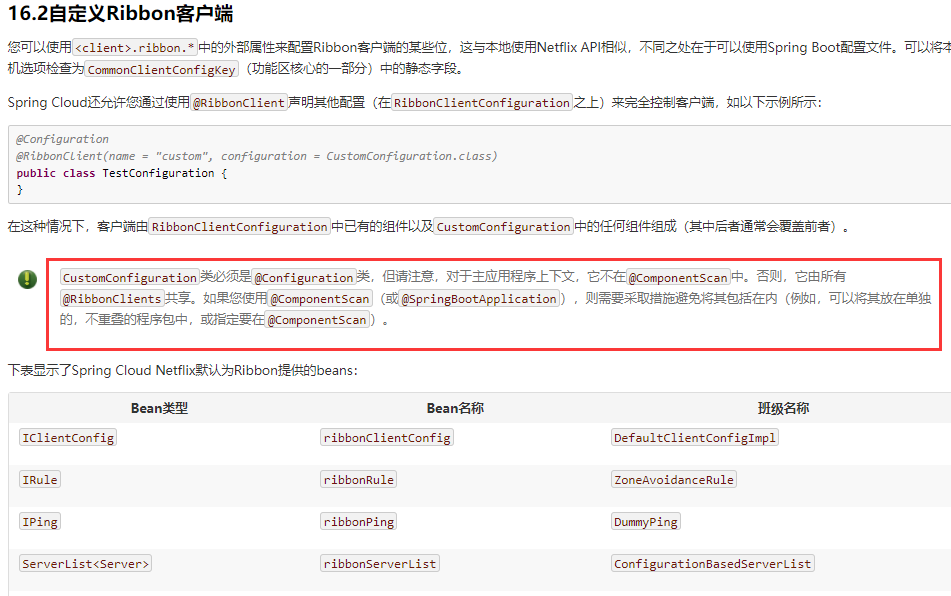
仿写ribbon本身实现类,在改造成自己的负载均衡实现
package org.springcloud.config;import java.util.List;import java.util.concurrent.ThreadLocalRandom;import com.netflix.client.config.IClientConfig;import com.netflix.loadbalancer.AbstractLoadBalancerRule;import com.netflix.loadbalancer.ILoadBalancer;import com.netflix.loadbalancer.Server;public class MyRandomRule extends AbstractLoadBalancerRule {// 自定义负载均衡策略需求// 每个服务,访问3次,换下一个访问(服务器为2)// 需要一个值来记录访问次数,total,默认为0,如果当total=3,就下一个服务// index = 0 ,默认为0,如果total=3,则index+1/*** 被调用的次数*/private int total = 0;/*** 当前服务*/private int divIndex = 0;/*** Randomly choose from all living servers*/// @edu.umd.cs.findbugs.annotations.SuppressWarnings(value =// "RCN_REDUNDANT_NULLCHECK_OF_NULL_VALUE")public Server choose(ILoadBalancer lb, Object key) {if (lb == null) {return null;}Server server = null;while (server == null) {if (Thread.interrupted()) {return null;}// 获得可获得的服务器 翻译直译// get获取,Reachable 可获得的,Servers 服务List<Server> upList = lb.getReachableServers();// 获取所有的服务List<Server> allList = lb.getAllServers();int serverCount = allList.size();if (serverCount == 0) {return null;}// 注释掉随机算法,编辑自定义算法// 从所有的服务中数量中, 生成区间随机数// int index = chooseRandomInt(serverCount);// 从可获得活着的服务中,以随机数获取改服务,进行服务判断// server = upList.get(index);// ---------------------------------------------// div 算法,每个服务访问3次,换下一个if (total < 3) {// 如果次数小于3,则返回当前,并次数+1server = upList.get(divIndex);total++;}else {// 如果次数大于3则,重置次数为0;选择下一个服务divIndex+1total=0;divIndex++;// 如果当前服务大于可选择服务数量,则从0从新开始if(divIndex>upList.size()) {divIndex=0;}// 从活着的服务中获取调用服务server = upList.get(divIndex);}// ------------------------------------------if (server == null) {Thread.yield();continue;}if (server.isAlive()) {return (server);}server = null;Thread.yield();}return server;}protected int chooseRandomInt(int serverCount) {return ThreadLocalRandom.current().nextInt(serverCount);}public Server choose(Object key) {return choose(getLoadBalancer(), key);}public void initWithNiwsConfig(IClientConfig clientConfig) {// TODO Auto-generated method stub}}
RibbonConfig调用自定义算法
package org.springcloud.config;import java.util.List;import java.util.concurrent.ThreadLocalRandom;import com.netflix.client.config.IClientConfig;import com.netflix.loadbalancer.AbstractLoadBalancerRule;import com.netflix.loadbalancer.ILoadBalancer;import com.netflix.loadbalancer.Server;public class MyRandomRule extends AbstractLoadBalancerRule {// 自定义负载均衡策略需求// 每个服务,访问3次,换下一个访问(服务器为2)// 需要一个值来记录访问次数,total,默认为0,如果当total=3,就下一个服务// index = 0 ,默认为0,如果total=3,则index+1/*** 被调用的次数*/private int total = 0;/*** 当前服务*/private int divIndex = 0;/*** Randomly choose from all living servers*/// @edu.umd.cs.findbugs.annotations.SuppressWarnings(value =// "RCN_REDUNDANT_NULLCHECK_OF_NULL_VALUE")public Server choose(ILoadBalancer lb, Object key) {if (lb == null) {return null;}Server server = null;while (server == null) {if (Thread.interrupted()) {return null;}// 获得可获得的服务器 翻译直译// get获取,Reachable 可获得的,Servers 服务List<Server> upList = lb.getReachableServers();// 获取所有的服务List<Server> allList = lb.getAllServers();int serverCount = allList.size();if (serverCount == 0) {return null;}// 注释掉随机算法,编辑自定义算法// 从所有的服务中数量中, 生成区间随机数// int index = chooseRandomInt(serverCount);// 从可获得活着的服务中,以随机数获取改服务,进行服务判断// server = upList.get(index);// ---------------------------------------------// div 算法,每个服务访问3次,换下一个if (total < 3) {// 如果次数小于3,则返回当前,并次数+1server = upList.get(divIndex);total++;}else {// 如果次数大于3则,重置次数为0;选择下一个服务divIndex+1total=0;divIndex++;// 如果当前服务大于可选择服务数量,则从0从新开始if(divIndex>upList.size()-1) {divIndex=0;}// 从活着的服务中获取调用服务server = upList.get(divIndex);}// ------------------------------------------if (server == null) {Thread.yield();continue;}if (server.isAlive()) {return (server);}server = null;Thread.yield();}return server;}protected int chooseRandomInt(int serverCount) {return ThreadLocalRandom.current().nextInt(serverCount);}public Server choose(Object key) {return choose(getLoadBalancer(), key);}public void initWithNiwsConfig(IClientConfig clientConfig) {// TODO Auto-generated method stub}}
测试服务访问,如愿得到结果

若有收获,就点个赞吧
0 人点赞


