1.目的 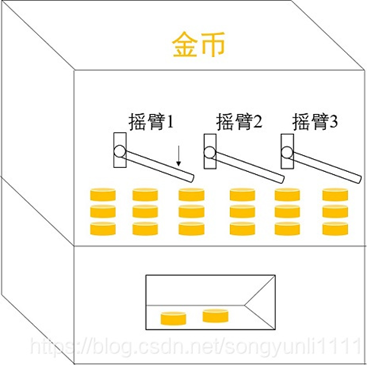
问题假设:按下摇臂后的回报取值为 1 或 0,每个摇臂获得回报的概率服从不同的分布,但事先并不知道。
问题目标:按某种策略按压摇臂,获取最大的累计回报。
UCB(Upper Confidence Bounds)算法的提出是为了解决探索和利用的平衡。以多臂赌博机问题为例:
- 利用(exploitation):按压之前获得回报概率最高的那个臂,以获得更高的累计回报。
- 探索(exploration):随机地去按压不同的臂。
2.原始UCB算法: 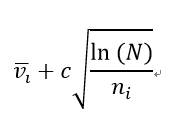
以多臂赌博机问题为例,左边为第i个臂获得的平均收益,右边中N为目前为止所有臂的按压次数和,ni为第i个臂的按压次数。c为常数。
3.应用:
UCB(Upper Confidence Bounds)应用于MCTS的选择动作阶段,为UCT(Upper Confidence Bounds Applied to Trees),即UCT=UCB+MCTS。UCT相较于传统的随机策略 ϵ - greedy 策略,更多的利用了之前已获取的信息,能够处理更加复杂的任务。
4.扩展的UCB算法对比:
1)Muzero: 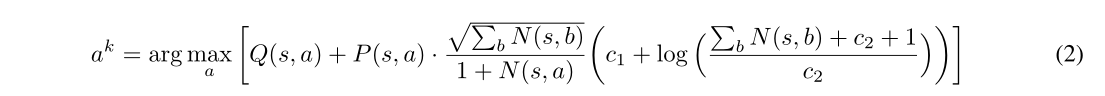
2) KR-DL-UCB: 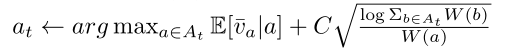
3)KB-Tree: 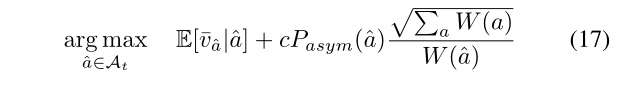
上述公式内部公式: 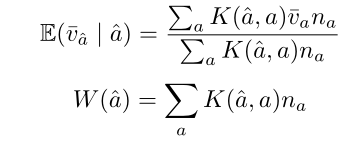

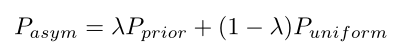
通过对上述三个方法的分析,我们发现,KR-DL-UCB在Muzero的基础上加入了核回归,核回归是一种估计随机变量概率密度函数的非参数方法。而KB-Tree在KR-DL-UCB的基础上,为了避免收敛到局部最优,使用Pasym函数控制探索的渐进衰减。
5.结果对比: 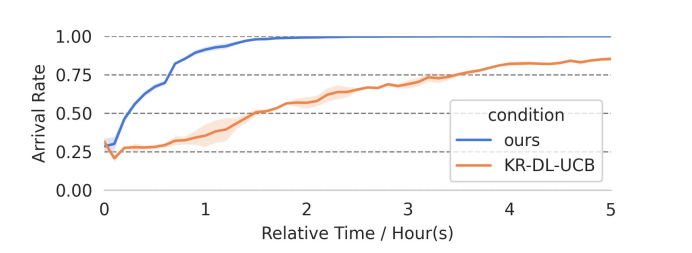
KB-Tree和KR-DL-UCB算法对比 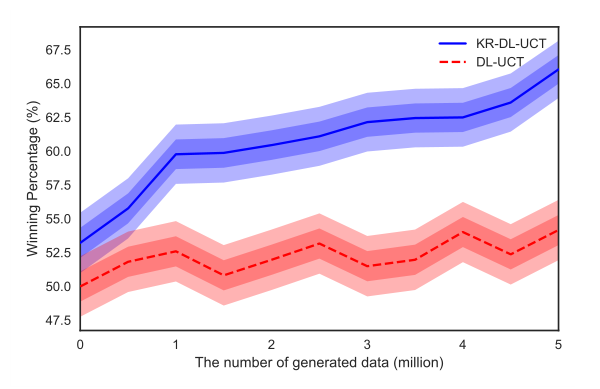

若有收获,就点个赞吧
0 人点赞


