select语句
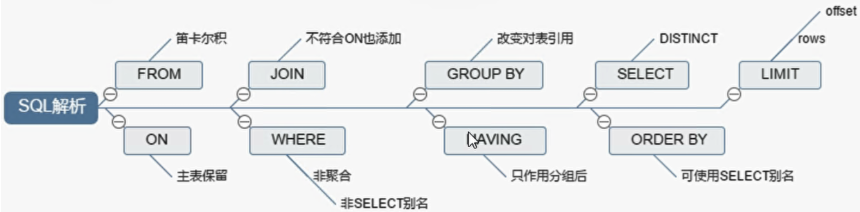
FROM > WHERE > GROUP BY > HAVING > SELECT的字段 > DISTINCT > ORDER BY > LIMIT
SELECT DISTINCT player_id, player_name, count(*) as num #顺序5FROM player JOIN team ON player.team_id = team.team_id #顺序1WHERE height > 1.80 #顺序2GROUP BY player.team_id #顺序3HAVING num > 2 #顺序4ORDER BY num DESC #顺序6LIMIT 2 #顺序7
SELECT 是先执行 FROM 这一步的。在这个阶段,如果是多张表联查,还会经历下面的几个步骤:
- 首先先通过 CROSS JOIN 求笛卡尔积,相当于得到虚拟表 vt(virtual table)1-1;
- 通过 ON 进行筛选,在虚拟表 vt1-1 的基础上进行筛选,得到虚拟表 vt1-2;
- 添加外部行。如果我们使用的是左连接、右链接或者全连接,就会涉及到外部行,也就是在虚拟表 vt1-2 的基础上增加外部行,得到虚拟表 vt1-3。
当然如果我们操作的是两张以上的表,还会重复上面的步骤,直到所有表都被处理完为止。
这个过程得到是我们的原始数据。当我们拿到了查询数据表的原始数据,也就是最终的虚拟表 vt1,就可以在此基础上再进行 WHERE 阶段。
在这个阶段中,会根据 vt1 表的结果进行筛选过滤,得到虚拟表 vt2。然
后进入第三步和第四步,也就是 GROUP 和 HAVING 阶段。
在这个阶段中,实际上是在虚拟表 vt2 的基础上进行分组和分组过滤,得到中间的虚拟表 vt3 和 vt4。
当我们完成了条件筛选部分之后,就可以筛选表中提取的字段,也就是进入到 SELECT 和 DISTINCT 阶段。
首先在 SELECT 阶段会提取想要的字段,然后在 DISTINCT 阶段过滤掉重复的行,分别得到中间的虚拟表 vt5-1 和 vt5-2。
当我们提取了想要的字段数据之后,就可以按照指定的字段进行排序,也就是 ORDER BY 阶段,得到虚拟表 vt6。
最后在 vt6 的基础上,取出指定行的记录,也就是 LIMIT 阶段,得到最终的结果,对应的是虚拟表 vt7。
from(笛卡尔积)on(主表保留)
到
join(不符合on也添加)where(非聚合,非select别名)
到
Group By(改变对表引用)having(只作用分组后)
到
select(disinct)order by(可使用select别名)
到
limit(rows,offset)
一条sql的执行过程
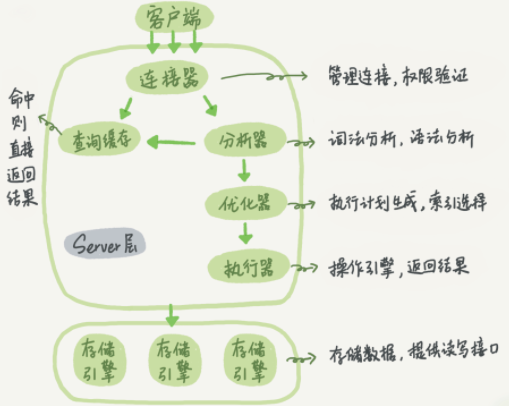
连接器
如果用户名密码认证通过,连接器会到权限表里面查出你拥有的权限。之后,这个连接里面的权限判断逻辑,都将依赖于此时读到的权限
这就意味着,一个用户成功建立连接后,即使你用管理员账号对这个用户的权限做了修改,也不会影响已经存在连接的权限。修改完成后,只有再新建的连接才会使用新的权限设置。连接完成后,如果你没有后续的动作,这个连接就处于空闲状态,你可以在 show processlist 命令中看到它。其中的 Command 列显示为“Sleep”的这一行,就表示现在系统里面有一个空闲连接。
mysql> show processlist;+----+-----------------+-----------+------+---------+-------+------------------------+------------------+| Id | User | Host | db | Command | Time | State | Info |+----+-----------------+-----------+------+---------+-------+------------------------+------------------+| 4 | event_scheduler | localhost | NULL | Daemon | 78474 | Waiting on empty queue | NULL || 13 | root | localhost | NULL | Query | 0 | starting | show processlist || 14 | root | localhost | NULL | Sleep | 4 | | NULL |+----+-----------------+-----------+------+---------+-------+------------------------+------------------+3 rows in set (0.00 sec)
客户端如果太长时间没动静,连接器就会自动将它断开。这个时间是由参数 wait_timeout 控制的,默认值是 8 小时。如果在连接被断开之后,客户端再次发送请求的话,就会收到一个错误提醒: Lost connection to MySQL server during query。这时候如果你要继续,就需要重连,然后再执行请求了。
:::info
长连接
有些时候 MySQL 占用内存涨得特别快,这是因为 MySQL 在执行过程中临时使用的内存是管理在连接对象里面的。这些资源会在连接断开的时候才释放。所以如果长连接累积下来,可能导致内存占用太大,被系统强行杀掉(OOM),从现象看就是 MySQL 异常重启了。
:::
怎么解决这个问题呢?
- 定期断开长连接。使用一段时间,或者程序里面判断执行过一个占用内存的大查询后,断开连接,之后要查询再重连。
- 如果你用的是 MySQL 5.7 或更新版本,可以在每次执行一个比较大的操作后,通过执行
mysql_reset_connection来重新初始化连接资源。这个过程不需要重连和重新做权限验证,但是会将连接恢复到刚刚创建完时的状态查询缓存
大多数情况下不建议用
在一个表上有更新的时候,跟这个表有关的查询缓存会失效,所以这条语句就会把表 T 上所有缓存结果都清空。这也就是我们一般不建议使用查询缓存的原因。
如果要用的话
MySQL 也提供了这种“按需使用”的方式。你可以将参数 query_cache_type 设置成 DEMAND,这样对于默认的 SQL 语句都不使用查询缓存。而对于你确定要使用查询缓存的语句,可以用 SQL_CACHE 显式指定,像下面这个语句一样:
mysql> select SQL_CACHE * from T where ID=10;
分析器
词法分析
输入的是由多个字符串和空格组成的一条 SQL 语句,MySQL 需要识别出里面的字符串分别是什么,代表什么。
MySQL 从你输入的”select”这个关键字识别出来,这是一个查询语句。它也要把字符串“T”识别成“表名 T”,把字符串“ID”识别成“列 ID”。
语法分析
根据词法分析的结果,语法分析器会根据语法规则,判断你输入的这个 SQL 语句是否满足 MySQL 语法
优化器
在表里面有多个索引的时候,决定使用哪个索引;或者在一个语句有多表关联(join)的时候,决定各个表的连接顺序。比如你执行下面这样的语句,这个语句是执行两个表的 join:
mysql> select * from t1 join t2 using(ID) where t1.c=10 and t2.d=20;
- 既可以先从表 t1 里面取出 c=10 的记录的 ID 值,再根据 ID 值关联到表 t2,再判断 t2 里面 d 的值是否等于 20。
- 也可以先从表 t2 里面取出 d=20 的记录的 ID 值,再根据 ID 值关联到 t1,再判断 t1 里面 c 的值是否等于 10。
这两种执行方法的逻辑结果是一样的,但是执行的效率会有不同,而优化器的作用就是决定选择使用哪一个方案。
执行器
mysql> select * from T where ID=10;ERROR 1142 (42000): SELECT command denied to user 'b'@'localhost' for table 'T'
如果有权限,就打开表继续执行。
比如我们这个例子中的表 T 中,ID 字段没有索引,那么执行器的执行流程是这样的:
- 调用 InnoDB 引擎接口取这个表的第一行,判断 ID 值是不是 10,如果不是则跳过,如果是则将这行存在结果集中;
- 调用引擎接口取“下一行”,重复相同的判断逻辑,直到取到这个表的最后一行。
- 执行器将上述遍历过程中所有满足条件的行组成的记录集作为结果集返回给客户端。
至此,这个语句就执行完成了。对于有索引的表,执行的逻辑也差不多。第一次调用的是“取满足条件的第一行”这个接口,之后循环取“满足条件的下一行”这个接口,这些接口都是引擎中已经定义好的。
你会在数据库的慢查询日志中看到一个rows_examined 的字段,表示这个语句执行过程中扫描了多少行。这个值就是在执行器每次调用引擎获取数据行的时候累加的。在
有些场景下,执行器调用一次,在引擎内部则扫描了多行,因此引擎扫描行数跟 rows_examined 并不是完全相同的。
debug模式启动
比如查一个表中没有的字段, debug模式
源码安装完MySQL之后,使用Debug模式启动mysqld --debug --console &后,mysql> create database wxb;Query OK, 1 row affected (0.01 sec)mysql> use wxb;Database changedmysql> create table t(a int);Query OK, 0 rows affected (0.01 sec)mysql> select * from t where k=1;ERROR 1054 (42S22): Unknown column 'k' in 'where clause'T@4: | | | | | | | | | error: error: 1054 message: 'Unknown column 'k' in 'where clause''Complete optimizer trace:

若有收获,就点个赞吧
0 人点赞


