HDFS
hdfs读写流程
- hadoop读数据流程
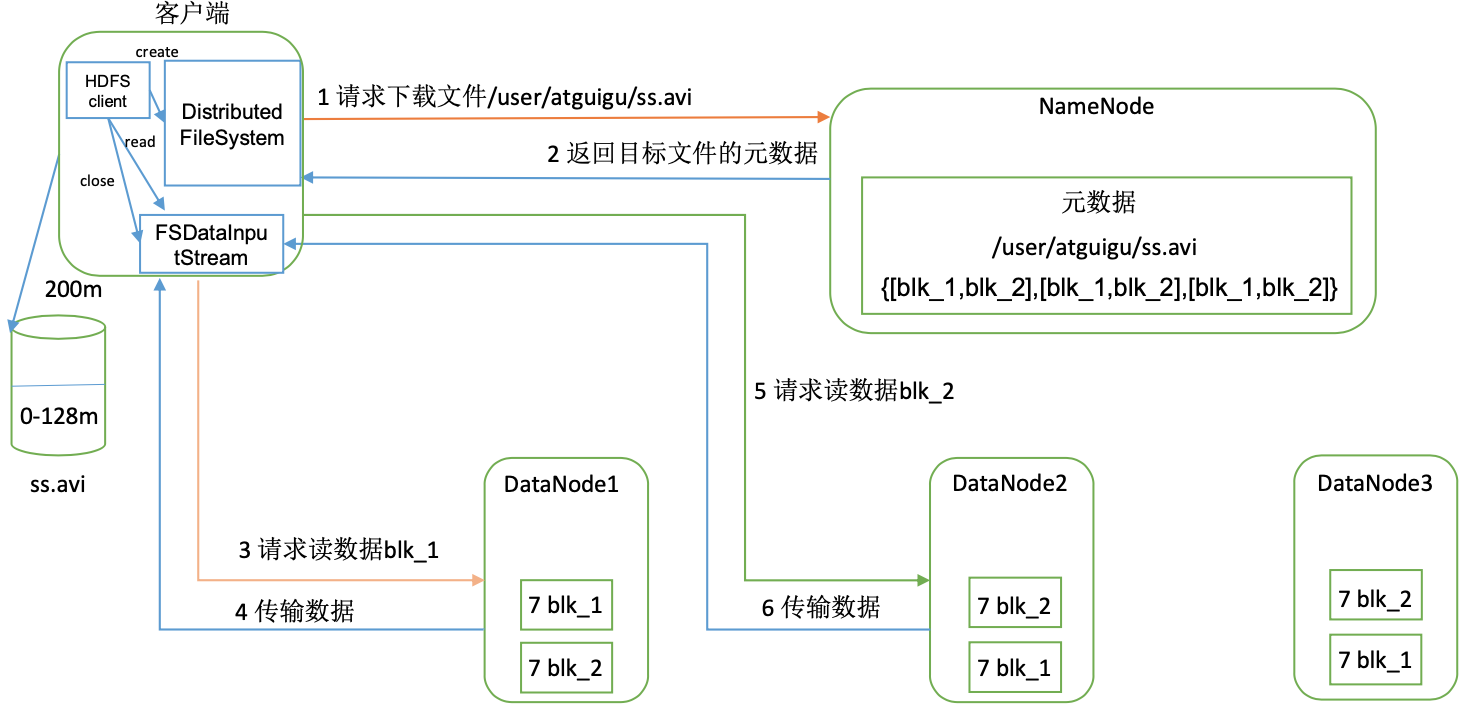
- hadoop写数据流程
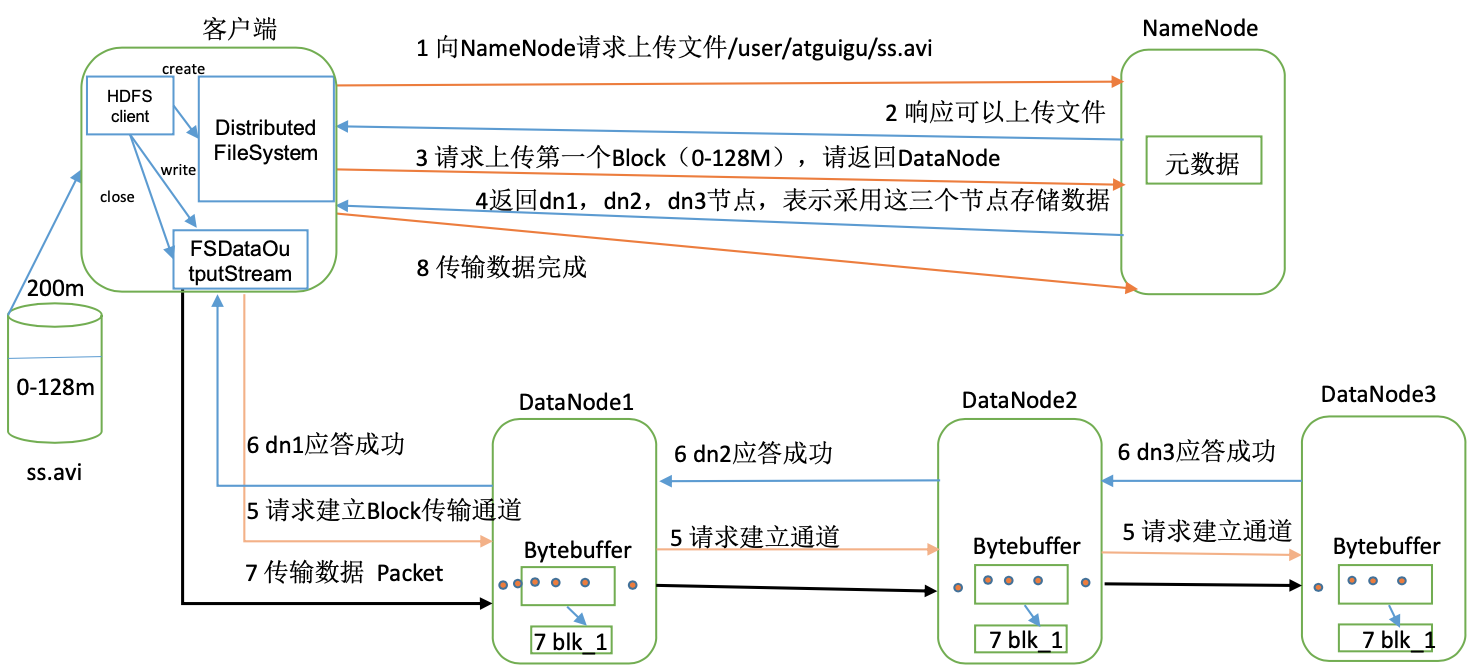
hdfs小文件处理
- 会有什么影响
1个文件块,占用namenode150字节内存,
一亿个小文件150字节~=13GB
128G能存多少文件块?128102410241024/150~=9亿文件块
- 怎么解决
- 采用har归档,将小文件归档
- 采用CombineTextInputFormat,将文件合并。todo在什么过程合并
- 有小文件场景开启JVM重用;如果没有不要开启,会一直占用使用到的Task卡槽,直到任务完成才释放。
JVM重用可以使得JVM实例在同一个job中重新使用N次,N的值可以在Hadoop的mapred-site.xml文件中进行配置,通常在10-20之间。
<property><name>mapreduce.job.jvm.numtasks</name><value>10</value><description>How many tasks to run per jvm,if set to -1 ,there is no limit</description></property>
MapReduce
mapreduce详细工作流程
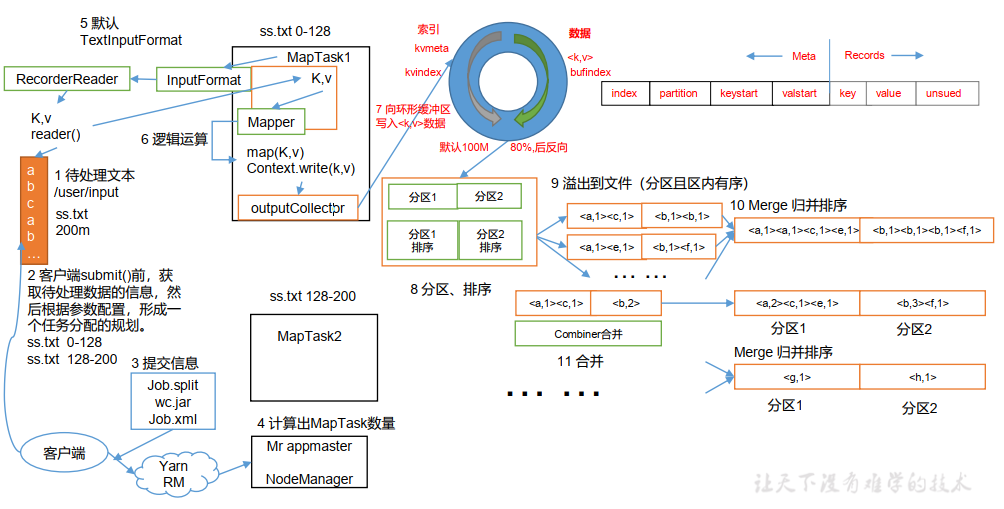
Shuffle工作流程
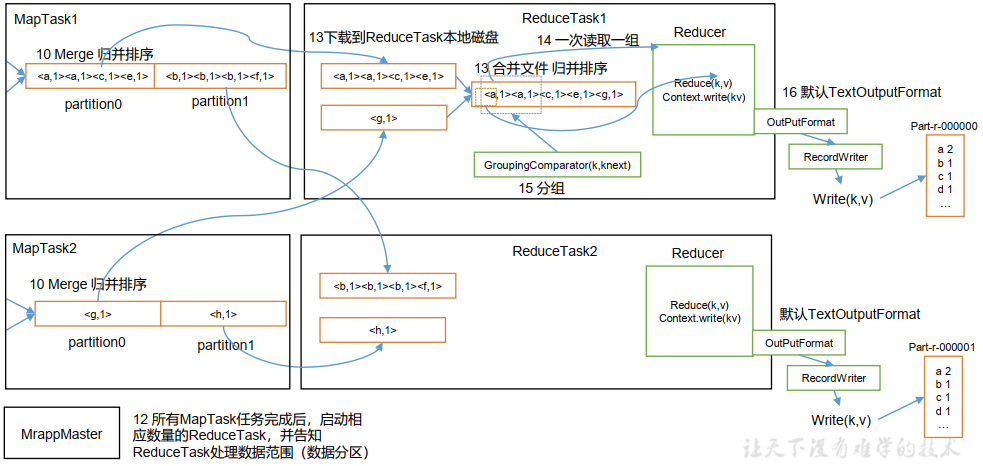
优化
- map阶段
- 增大环形缓冲区大小。由默认100MB扩大到200MB。
- 增大环形缓冲区溢写比例。由80%扩大到90%。
- 减少对溢写文件的merge次数。(10个文件,一次20个merge)
- 不影响实际业务前提下,采用Combiner提前合并,减少I/O
- reduce阶段
- 合理设置map和reduce数:两个都不能设置太少,也不能太多。太少会导致task等待,延长处理时间;太多会导致map、reduce任务间竞争资源,造成处理超时等错误。
- 设置map、reduce共存:调整slowstart.completedmaps参数,使map运行到一定程度后,reduce也开始运行,减少reduce的等待时间。
- 规避使用reduce,因为reduce在用于连接数据集的时候将会产生大量网络消耗。
- 增加每个reduce去map中拿数据的并行数
- 集群性能可以的前提下,增加reduce端存储数据内存的大小
- IO传输
采用数据压缩的方式,减少网络IO的时间。安装Snappy和LZOP压缩编码器。
压缩:
a. map输入端主要考虑数据量大小和切片,支持切片的有Bzip2、LZO。LZO支持切片必须创建索引。
b. map输出端主要考虑速度,速度快的snappy、lZO;
c. reduce输出端主要看具体需求,例如作为下一个mr输入需要考虑切片,永久保存考虑压缩率比较大的gzip。
整体
- nodemanager默认内存8G,需要根据该服务器实际配置灵活调整,例如128G内存,配置100G内存,yarn.nodemanager.resource.memory-mb。
- 单任务默认内存8G,需要根据该任务的数据量灵活调整,例如128m数据,配置1G内存,yarn.sheduler.maximum-allocation-mb。
- mapreduce.map.memory.mb:控制分配给mapTask内存上线,如果超过会kill掉进程(报:Container is running beyond physical memory limits. Current usage:565MB of 512MB physical memory used;killing container)。默认内存大小为1G,如果数据量是128M,正常不需要调整内存;如果数据量大于128M,可以增加MapTask内存,最大可以增加到4-5G。
- mapreduce.reduce.memory.mb:控制分配给ReduceTask内存上线。默认内存大小为1G,如果数据量是128M,一般不需要调整;如果数据量大于128M,可以增加ReduceTask内存大小为4-5G。
- mapreduce.map.java.opts:控制MapTask堆内存大小。(不够报OOME)
- mapreduce.reduce.java.opts:控制ReduceTask堆内存大小。(不够报OOME)
- 可以增加MapTask的CPU核数,增加ReduceTask的CPU核数
- 可以增加每个Container的CPU核数和内存大小
- 在hdfs-site.xml文件中配置多目录(多磁盘)
- NameNode有一个工作线程池,用来处理不同DataNode的并发心跳以及客户端并发的元数据操作。dfs.namenode.handler.count=20*
 ,比如集群规模为8台时,此参数设置为41.
mapreduce解决数据倾斜
提前在map进行combine,减少传输的数据量
在mapper加上combiner相当于提前进行reduce,即把一个mapper中的相同的key进行了聚合,减少shuffle过程中传输的数据量,以及reducer端的计算量。
如果导致数据倾斜的key大量分布在不同的mapper的时候,这种方法就不是很有效了。
- 导致数据倾斜的key大量分布在不同的mapper
- 局部聚合加全局聚合
第一次在map阶段对那些导致了数据倾斜的key加上1到n的随机前缀,这样本来相同的key也会被分到多个reducer中进行局部聚合,数量就会大大降低。
第二次mapreduce,去掉key的随机前缀,进行全局聚合。
思想:两次mr,第一次将key随机散列到不同reducer进行处理达到负载均衡目的。第二次根据去掉key的随机前缀,按原key进行reduce处理。
进行两次mapreduce,性能稍差。
b. 增加reducer,提升并行度
JobConf.setNumReduceTasks(int)
c.实现自定义分区
根据数据分布情况,自定义散列函数,将key均匀分配到不同reducer。
如国家、地区、用户
https://cloud.tencent.com/developer/article/1519028
Yarn
yarn工作机制
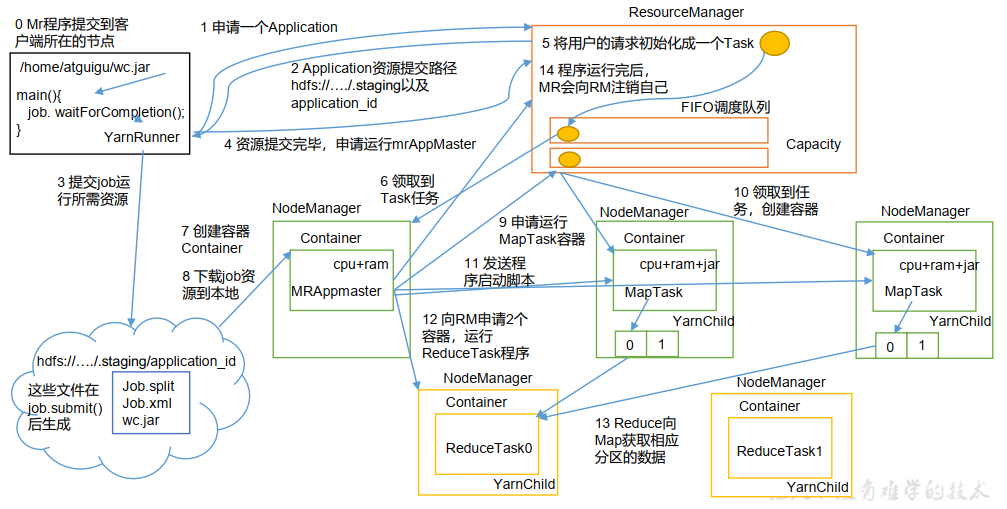
yarn调度器
- hadoop调度器主要分为三类
- FIFO:支持单队列、先进先出;一般生产不用
- Capacity Scheduler(容量调度器):支持多队列,保证先进入的任务优先执行。Apache默认的资源调度器。中小公司,集群服务器不太充裕选容量。
- Fair Sceduler(公平调度器):支持多队列,保证每个任务公平享有队列资源。CDH默认的资源调度器。大厂对并发要求比较高,选择公平,要求服务器性能必须OK。
- 生产环境怎么创建队列
- 调度器默认就1个default队列,不能满足生产要求。
- 按照框架:hive、spark、flink每个框架的任务放入指定队列(企业用的不多)
- 按照业务模块:登录注册、购物车、下单、业务部门1、业务部门2
- 创建多队列的好处
- 担心员工不小心,写递归死循环代码,把所有资源全部耗尽。
- 实现任务的降级使用,特殊时期保证重要的任务队列资源充足
业务部门1(重要)>业务部门2(比较重要)>下单(一般)>购物车(一般)>登录注册(次要)
集群资源分配问题
集群有 30 台机器,跑 MR 任务的时候发现 5 个 map 任务全都分配到了同一台机器上,这个可能是由于什么原因导致的吗?
解决方案: yarn.scheduler.fair.assignmultiple 这个参数, 默认是关闭的。
参考: Yarn参数优化(Fair Scheduler版本)
未分类
常用端口号
| hadoop2.x | hadoop3.x | |
|---|---|---|
| 访问HDFS端口 | 50070 | 9870 |
| 访问MR执行情况端口 | 8088 | 8088 |
| 历史服务器 | 19888 | 19888 |
| 客户端访问集群端口 | 9000 | 8020 |
基准测试
搭建完 Hadoop 集群后需要对 HDFS 读写性能和 MR 计算能力测试。测试 jar 包在 hadoop 的 share 文件夹下。
hadoop宕机
1、如果mr造成宕机,此时要控制yarn同时运行的任务数和每个任务申请的最大内存。调整参数:yarn.scheduler.maximum-allocation-mb (单个任务可申请的最多物理内存默认为8G)
2、如果写入文件过快造成namenode宕机。调高kafka的存储大小,控制从kafka到hdfs的写入速度,也可以调整flume每批次拉取数据量的大小参数batchsize。
hadoop文件压缩
mr支持的压缩编码
| 压缩格式 | hadoop自带? | 算法 | 文件扩展名 | 是否可切分 | 换成压缩格式后,原来的程序是否需要修改 |
|---|---|---|---|---|---|
| DEFLATE | 是,直接使用 | DEFLATE | .deflate | 否 | 和文本处理一样,不需要修改 |
| Gzip | 是,直接使用 | DEFLATE | .gz | 否 | 和文本处理一样,不需要修改 |
| bzip2 | 是,直接使用 | bzip2 | .bz2 | 是 | 和文本处理一样,不需要修改 |
| LZO | 否,需要安装 | LZO | .lzo | 是 | 需要建索引,还需要指定输入格式 |
| Snappy | 否,需要安装 | Snappy | .snappy | 否 | 和文本处理一样,不需要修改 |
| 压缩格式 | 工具 | 算法 | 文件扩展名 | 是否可切分 |
|---|---|---|---|---|
| DEFLATE | 无 | DEFLATE | .deflate | 否 |
| Gzip | gzip | DEFLATE | .gz | 否 |
| bzip2 | bzip2 | bzip2 | .bz2 | 是 |
| LZO | lzop | LZO | .lzo | 是 |
| snappy | 无 | snappy | .snappy | 否 |
为了支持多种压缩/解压缩算法,Hadoop引入了编码/解码器,如下表所示:
| 压缩格式 | 对应的编码/解码器 |
|---|---|
| DEFLATE | org.apache.hadoop.io.compress.DefaultCodec |
| gzip | org.apache.hadoop.io.compress.GzipCodec |
| bzip2 | org.apache.hadoop.io.compress.BZip2Codec |
| LZO | com.hadoop.compression.lzo.LzopCodec |
| Snappy | org.apache.hadoop.io.compress.SnappyCodec |
压缩性能的比较:
| 压缩算法 | 原始文件 | 压缩文件 | 压缩速度 | 解压速度 |
|---|---|---|---|---|
| gzip | 8.3GB | 1.8GB | 17.5MB/s | 58MB/s |
| bzip2 | 8.3GB | 1.1GB | 2.4MB/s | 9.5MB/s |
| LZO | 8.3GB | 2.9GB | 49.3MB/s | 74.6MB/s |
mr压缩参数配置
要在Hadoop中启用压缩,可以配置如下参数(mapred-site.xml文件中):
| 参数 | 默认值 | 阶段 | 建议 |
|---|---|---|---|
| io.compression.codecs (在core-site.xml中配置) |
org.apache.hadoop.io.compress.DefaultCodec, org.apache.hadoop.io.compress.GzipCodec, org.apache.hadoop.io.compress.BZip2Codec, org.apache.hadoop.io.compress.Lz4Codec |
输入压缩 | Hadoop使用文件扩展名判断是否支持某种编解码器 |
| mapreduce.map.output.compress | false | mapper输出 | 这个参数设为true启用压缩 |
| mapreduce.map.output.compress.codec | org.apache.hadoop.io.compress.DefaultCodec | mapper输出 | 使用LZO、LZ4或snappy编解码器在此阶段压缩数据 |
| mapreduce.output.fileoutputformat.compress | false | reducer输出 | 这个参数设为true启用压缩 |
| mapreduce.output.fileoutputformat.compress.codec | org.apache.hadoop.io.compress. DefaultCodec | reducer输出 | 使用标准工具或者编解码器,如gzip和bzip2 |
| mapreduce.output.fileoutputformat.compress.type | RECORD | reducer输出 | SequenceFile输出使用的压缩类型:NONE和BLOCK |
压缩方式选择
| 压缩方式 | 优点 | 缺点 | 应用场景 |
|---|---|---|---|
| gzip | 压缩率高;压缩、解压速度较快;hadoop本身支持,应用中处理和文本一样;linux自带gzip命令,使用方便; | 不支持split | 每个文件压缩之后在130MB以内,都可以考虑Gzip。例如一天或一个小时的日志压缩成gzip文件。 |
| bzip2 | 支持split;比gzip的压缩率高;hadoop本身自带; | 压缩、解压速度慢 | 适合对速度要求不高,但要较高压缩率的时候;或者输出之后数据比较大,以后数据用得少的情况;或者单个很大的文本文件想减少存储空间又要支持split,而且兼容之前的应用程序的情况。 |
| lzo | 压缩、解压速度比较快;合理的压缩率;支持split,是hadoop中最流行的压缩格式;可以在linux安装lzop命令。 | 压缩率比gzip低一些,hadoop本身不支持,要安装;在应用中对lzo格式文件做特殊处理(为了支持split需要建索引,还需要指定inputformat为lzo格式) | 一个很大的文本文件,压缩之后还大于200M以上的可以考虑,单个文件越大,lzo优点越明显。 |
| snappy | 高速压缩速度,合理的压缩率 | 不支持split;压缩率比gzip要低;hadoop本身不支持,需要安装。 | 当mapreduce作业的map输出的数据比较大的时候,作为map到reduce的中间数据的压缩格式;或者作为一个mapreduce作业的输出和另外一个mapreduce作业的输入。 |
开启压缩
map输出端开启压缩
开启map输出阶段压缩可以减少job中map和Reduce task间数据传输量。具体配置如下:
(1)开启hive中间传输数据压缩功能
hive (default)>set hive.exec.compress.intermediate=true;
(2)开启mapreduce中map输出压缩功能
hive (default)>set mapreduce.map.output.compress=true;
(3)设置mapreduce中map输出数据的压缩方式
hive (default)>set mapreduce.map.output.compress.codec=org.apache.hadoop.io.compress.SnappyCodec;
(4)执行查询语句
hive (default)> select count(ename) name from emp;
reduce输出阶段压缩
当Hive将输出写入到表中时,输出内容同样可以进行压缩。属性hive.exec.compress.output控制着这个功能。用户可能需要保持默认设置文件中的默认值false,这样默认的输出就是非压缩的纯文本文件了。用户可以通过在查询语句或执行脚本中设置这个值为true,来开启输出结果压缩功能。
(1)开启hive最终输出数据压缩功能
hive (default)>set hive.exec.compress.output=true;
(2)开启mapreduce最终输出数据压缩
hive (default)>set mapreduce.output.fileoutputformat.compress=true;
(3)设置mapreduce最终数据输出压缩方式
hive (default)> set mapreduce.output.fileoutputformat.compress.codec = org.apache.hadoop.io.compress.SnappyCodec;
(4)设置mapreduce最终数据输出压缩为块压缩
hive (default)> set mapreduce.output.fileoutputformat.compress.type=BLOCK;
(5)测试一下输出结果是否是压缩文件
hive (default)> insert overwrite local directory ‘/opt/module/datas/distribute-result’ select * from emp distribute by deptno sort by empno desc;
文件存储格式
主要有:TextFile、SequenceFile、Avro、Parquet、RC & ORC
TEXTFILE和SEQUENCEFILE的存储格式都是基于行存储的;
ORC和PARQUET是基于列式存储的。
列式存储和行式存储
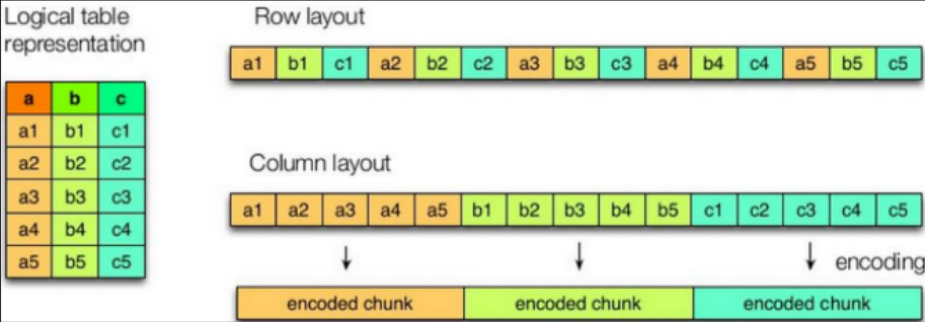
如图所示左边为逻辑表,右边第一个为行式存储,第二个为列式存储。
行式存储的特点
查询满足条件的一整行数据的时候,行存储只需要找到其中一个值,其余值都在相邻地方,列存储需要去每个聚集的字段找到相对应的每个列的值,所以此时行存储查询速度更快。
列式存储的特点
因为每个字段的数据聚集存储,在查询只需要少数几个字段的时候,能大大减少读取的数据量;每个字段的数据类型一定是相同的,列式存储可以针对性的设计更好的设计压缩算法。
textfile格式
默认格式,数据不做压缩,磁盘开销大,数据解析开销大。可结合Gzip、bzip2使用,但使用gzip这种方式,hive不会对数据进行切分,从而无法对数据进行并行操作。
orc格式
orc(Optimized Row Columnar)是hive0.11版里引入的新的存储格式。
如下图所示可以看到每个orc文件由1个或多个stripe组成,每个stripe一般为HDFS的块大小,每一个stripe包含多条记录,这些记录按照列进行独立存储,对应到Parquet中的row group的概念。每个stripe有三部分组成,分别是Index Data,Row Data,Stripe Footer: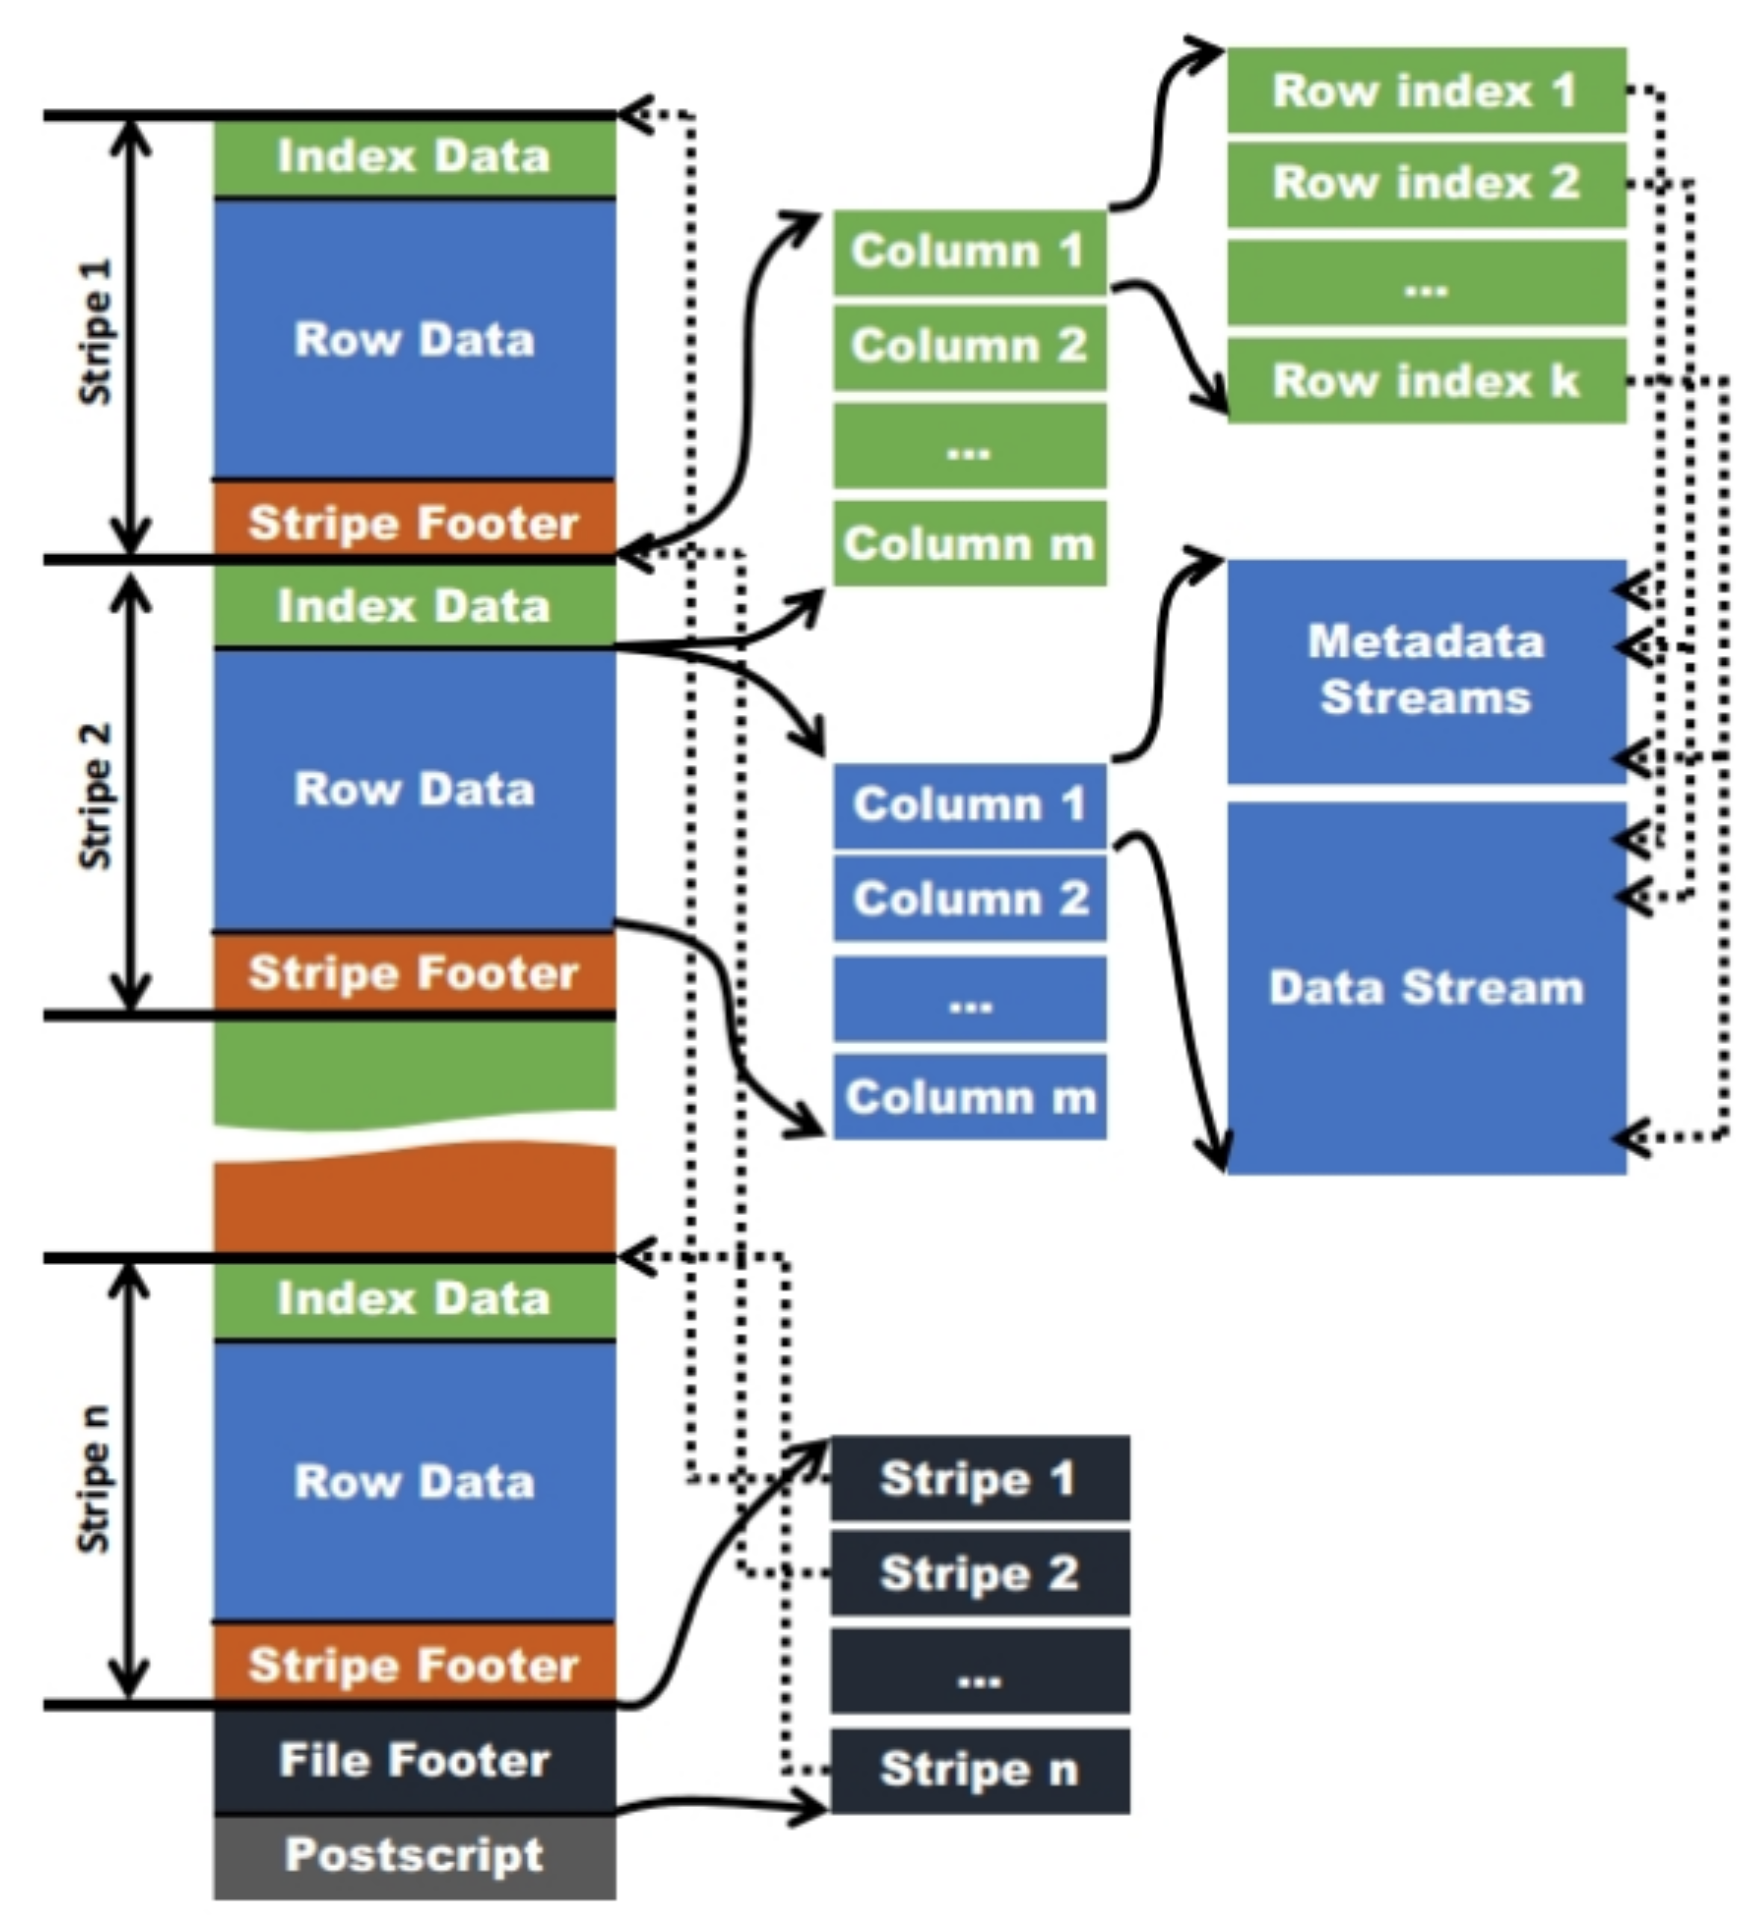
- index data:一个轻量级的index,默认是每隔1w行做一个索引。这里做的索引应该只是记录某行的各字段在row data中的offset。
- row data:存的是具体的数据,先取部分行,然后对这些行按列进行存储。对每个列进行了编码,分成多个stream来存储。
- stripe footer:存的是各个stream的类型,长度等信息。
- file footer:每个文件都有,这里面存的是每个stripe的行数,每个column的数据类型信息等;
postScript:这里面记录了整个文件的压缩类型以及fileFooter的长度信息等。在读取文件时,会seek到文件尾部读postScript,从里面解析到fileFooter长度,再度fileFooter,从里面解析到各个stripe信息,再读各个stripe,即从后往前读。
parquet格式
parquet文件是以二进制方式存储的,所以是不可以直接读取的,文件中包括该文件的数据和元数据,因此parquet格式文件是自解析的。
行组(RowGroup):每一个行组包含一定的行数,在一个HDFS文件中至少存储一个行组,类似于orc的stripe的概念。
- 列块(column chunk):在一个行组中每一列保存在一个列块中,行组中的所有列连续的存储在这个行组文件中。一个列块中的值都是相同类型的,不同的列块可能使用不同的算法进行压缩。
- 页(page):每一个列块划分为多个页,一个页是最小的编码的单位,在同一个列块的不同页可能使用不同的编码方式。
通常情况下,在存储parquet数据的时候会按照bloc大小设置行组的大小,由于一般情况下每一个mapper任务处理数据的最小单位是一个block,这样可以把每一个行组由一个mapper任务处理,增大任务执行并行度。parquet文件的格式。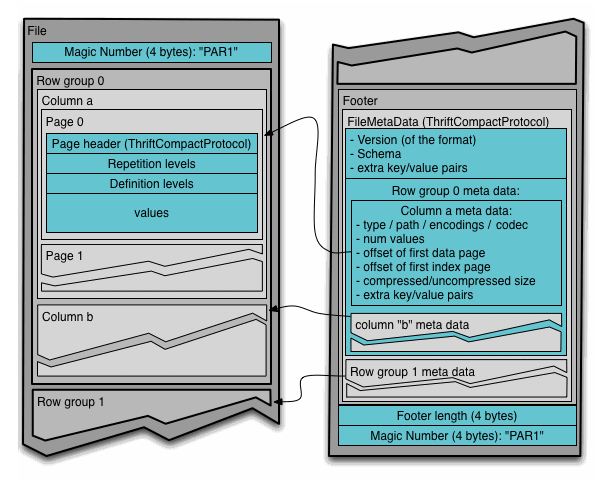
上图展示了一个parquet文件的内容,一个文件中可以存储多个行组,文件的首位都是该文件的Magic Code,用于校验它是否是一个parquet文件,footer length记录了文件元数据的大小,通过该值和文件长度可以计算出元数据的偏移量,文件的元数据中包括每一个行组的元数据信息和该文件存储数据的schema信息。除了文件中每一个行组的元数据,每一页的开始都会存储该页的元数据,在parquet中,有三种类型的页:数据页、字典页、索引页。数据页用于存储当前行组中该列的值,字典页存储该列值的编码字典,每一个列块中最多包含一个字典页,索引页用来存储当前行组下该列的索引,目前parquet中还不支持索引页。
文件压缩比和查询速度比较
压缩比:ORC>Parquet>textFile
查询速度:查询速度相近
在实际项目开发中,hive表的数据存储格式一般选择orc或parquet。压缩方式一般选择snappy,lzo。
在Hive中常用的使用方式:一般读入源文件为Avro格式,在Hive中的中间过程可以使用ORC存储,而最后保存也选择Avro格式保存。因为Avro格式比较通用,而ORC格式在很多地方并不能使用。
hbase

若有收获,就点个赞吧
0 人点赞


