哈希简介
哈希表(Hash Table)是又称散列表,一种以 “key-value” 形式存储数据的数据结构。所谓以 “key-value” 形式存储数据,是指任意的键值 key 都唯一对应到内存中的某个位置。只需要输入查找的键值,就可以快速地找到其对应的 value。可以把哈希表理解为一种高级的数组,这种数组的下标可以是很大的整数,浮点数,字符串甚至结构体。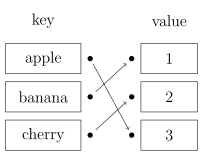
哈希函数
要让键值对应到内存中的位置,就要为键值计算索引,也就是计算这个数据应该放到哪里。这个根据键值计算索引的函数就叫做哈希函数,也称散列函数。举个例子,如果键值是一个人的身份证号码,哈希函数就可以是号码的后四位,当然也可以是号码的前四位。生活中常用的“手机尾号”也是一种哈希函数。在实际的应用中,键值可能是更复杂的东西,比如浮点数、字符串、结构体等,这时候就要根据具体情况设计合适的哈希函数。哈希函数应当易于计算,并且尽量使计算出来的索引均匀分布。
在 OI 中,最常见的情况应该是键值为整数的情况。当键值的范围比较小的时候,可以直接把键值作为数组的下标,但当键值的范围比较大,比如以 10^9 范围内的整数作为键值的时候,就需要用到哈希表。一般把键值模一个较大的质数作为索引,也就是取 f(x) = x % M 作为哈希函数。另一种比较常见的情况是 key 为字符串的情况,在算法竞赛中,一般不直接把字符串作为键值,而是先算出字符串的哈希值,再把其哈希值作为键值插入到哈希表里。
能为 key 计算索引之后,我们就可以知道每个键值对应的值 value 应该放在哪里了。假设我们用数组 a 存放数据,哈希函数是 f,那键值对 (key, value) 就应该放在 a[f(key)] 上。不论键值是什么类型,范围有多大,f(key) 都是在可接受范围内的整数,可以作为数组的下标。
哈希冲突
如果对于任意的键值,哈希函数计算出来的索引都不相同,那只用根据索引把 (key, value) 放到对应的位置就行了。但实际上,常常会出现两个不同的键值,他们用哈希函数计算出来的索引是相同的。这时候就需要一些方法来处理冲突。在竞赛中,最常用的方法是拉链法。
*STL中的哈希
C++STL实现了哈希表,即unordered_map,但因常数过大,很多情况下效率并不如map,故而不建议使用。

若有收获,就点个赞吧
0 人点赞


