一、并查集
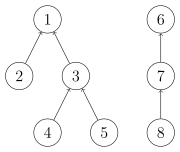
并查集是一种树形的数据结构,顾名思义,它用于处理一些不交集的 合并 及 查询 问题。 它支持两种操作:
- 查找(Find):确定某个元素处于哪个子集;
- 合并(Union):将两个子集合并成一个集合。
初始化
并查集的初始化很简单,只需要让每个元素自身作为自身集合的父节点就行for (int i = 0; i < size; i++)fa[i] = i; // i 就在它本身的集合里
查找
通俗地讲一个故事:几个家族进行宴会,但是家族普遍长寿,所以人数众多。由于长时间的分离以及年龄的增长,这些人逐渐忘掉了自己的亲人,只记得自己的爸爸是谁了,而最长者(称为「祖先」)的父亲已经去世,他只知道自己是祖先。为了确定自己是哪个家族,他们想出了一个办法,只要问自己的爸爸是不是祖先,一层一层的向上问,直到问到祖先。如果要判断两人是否在同一家族,只要看两人的祖先是不是同一人就可以了。
在这样的思想下,并查集的查找算法诞生了。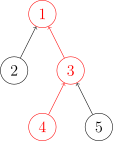 ```cpp
int fa[MAXN]; // 记录某个人的爸爸是谁,特别规定,祖先的爸爸是他自己
// 递归 int find(int x) { if (fa[x] == x) // 如果 x 是祖先则返回 return x; else return find(fa[x]); // 如果不是则 x 的爸爸问 x 的爷爷 }
// 非递归 int find(int x) { while (x != fa[x]) // 如果 x 不是祖先,就一直往上一辈找 { x = fa[x]; } return x; // 如果 x 是祖先则返回 }
<a name="KM1js"></a>
#### 路径压缩
上述查找的实现确可以达成目的,但是显然效率实在太低。为什么呢?因为我们使用了太多没用的信息,我的祖先是谁与我父亲是谁没什么关系,这样一层一层找太浪费时间,不如我直接当祖先的儿子,问一次就可以出结果了。甚至祖先是谁都无所谓,只要这个人可以代表我们家族就能得到想要的效果。**把在路径上的每个节点都直接连接到根上**,这就是路径压缩。<br />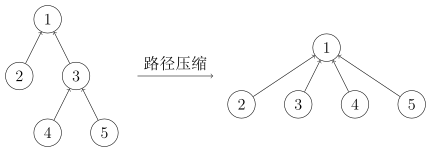
```cpp
// C++ Version
int find(int x) {
if (x != fa[x]) // x 不是自身的父亲,即 x 不是该集合的代表
fa[x] = find(fa[x]); // 查找 x 的祖先直到找到代表,于是顺手路径压缩
return fa[x];
}
合并
宴会上,一个家族的祖先突然对另一个家族说:我们两个家族交情这么好,不如合成一家好了。另一个家族也欣然接受了。
我们之前说过,并不在意祖先究竟是谁,所以只要其中一个祖先变成另一个祖先的儿子就可以了。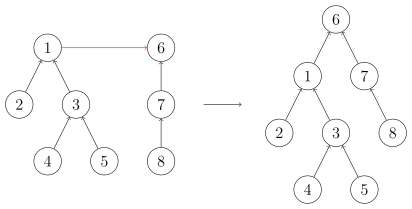
// C++ Version
void unionSet(int x, int y) {
  // x 与 y 所在家族合并
  x = find(x);
  y = find(y);
  fa[x] = y;  // 把 x 的祖先变成 y 的祖先的儿子
}
启发式合并(按秩合并)
一个祖先突然抖了个机灵:「你们家族人比较少,搬家到我们家族里比较方便,我们要是搬过去的话太费事了。」
由于需要我们支持的只有集合的合并、查询操作,当我们需要将两个集合合二为一时,无论将哪一个集合连接到另一个集合的下面,都能得到正确的结果。但不同的连接方法存在时间复杂度的差异。具体来说,如果我们将一棵点数与深度都较小的集合树连接到一棵更大的集合树下,显然相比于另一种连接方案,接下来执行查找操作的用时更小(也会带来更优的最坏时间复杂度)。
当然,我们不总能遇到恰好如上所述的集合————点数与深度都更小。鉴于点数与深度这两个特征都很容易维护,我们常常从中择一,作为估价函数。而无论选择哪一个,时间复杂度都为 O(mα(m,n)),具体的证明可参见 References 中引用的论文。
在算法竞赛的实际代码中,即便不使用启发式合并,代码也往往能够在规定时间内完成任务。在 Tarjan 的论文[1]中,证明了不使用启发式合并、只使用路径压缩的最坏时间复杂度是O(mlogn) 。在姚期智的论文[2]中,证明了不使用启发式合并、只使用路径压缩,在平均情况下,时间复杂度依然是 O(mα(m,n)) 。
如果只使用启发式合并,而不使用路径压缩,时间复杂度为 O(mlogn) 。由于路径压缩单次合并可能造成大量修改,有时路径压缩并不适合使用。例如,在可持久化并查集、线段树分治 + 并查集中,一般使用只启发式合并的并查集。
C++ 的参考实现,其选择点数作为估价函数:
std::vector<int> size(N, 1);  // 记录并初始化子树的大小为 1

void unionSet(int x, int y) {
  int xx = find(x), yy = find(y);
  if (xx == yy) return;
  if (size[xx] > size[yy])  // 保证小的合到大的里
    swap(xx, yy);
  fa[xx] = yy;
  size[yy] += size[xx];
}
二、带权并查集
我们还可以在并查集的边上定义某种权值、以及这种权值在路径压缩时产生的运算,从而解决更多的问题。比如对于经典的「NOI2001」食物链,我们可以在边权上维护模 3 意义下的加法群。
三、代码模板
(1)朴素并查集:

    int p[N]; //存储每个点的祖宗节点

    // 返回x的祖宗节点
    int find(int x)
    {
        if (p[x] != x) p[x] = find(p[x]);
        return p[x];
    }

    // 初始化,假定节点编号是1~n
    for (int i = 1; i <= n; i ++ ) p[i] = i;

    // 合并a和b所在的两个集合:
    p[find(a)] = find(b);

(2)维护size的并查集:

    int p[N], size[N];
    //p[]存储每个点的祖宗节点, size[]只有祖宗节点的有意义,表示祖宗节点所在集合中的点的数量

    // 返回x的祖宗节点
    int find(int x)
    {
        if (p[x] != x) p[x] = find(p[x]);
        return p[x];
    }

    // 初始化,假定节点编号是1~n
    for (int i = 1; i <= n; i ++ )
    {
        p[i] = i;
        size[i] = 1;
    }

    // 合并a和b所在的两个集合:
    size[find(b)] += size[find(a)];
    p[find(a)] = find(b);

(3)维护到祖宗节点距离的并查集:

    int p[N], d[N];
    //p[]存储每个点的祖宗节点, d[x]存储x到p[x]的距离

    // 返回x的祖宗节点
    int find(int x)
    {
        if (p[x] != x)
        {
            int u = find(p[x]);
            d[x] += d[p[x]];
            p[x] = u;
        }
        return p[x];
    }

    // 初始化,假定节点编号是1~n
    for (int i = 1; i <= n; i ++ )
    {
        p[i] = i;
        d[i] = 0;
    }

    // 合并a和b所在的两个集合:
    p[find(a)] = find(b);
    d[find(a)] = distance; // 根据具体问题,初始化find(a)的偏移量
典型例题
kuangbin并查集题目单:
https://www.acwing.com/activity/content/punch_the_clock/90/
包含大部分并查集的使用,难易适中
银河英雄传说
https://www.luogu.com.cn/problem/P1196
出自NOI2002,经典并查集题目
其他
最小生成树算法 中的 Kruskal 和 最近公共祖先 中的 Tarjan 算法是基于并查集的算法。
相关专题见OI wiki -> 并查集应用。

若有收获,就点个赞吧
0 人点赞


