记录维维的每一篇Hello World
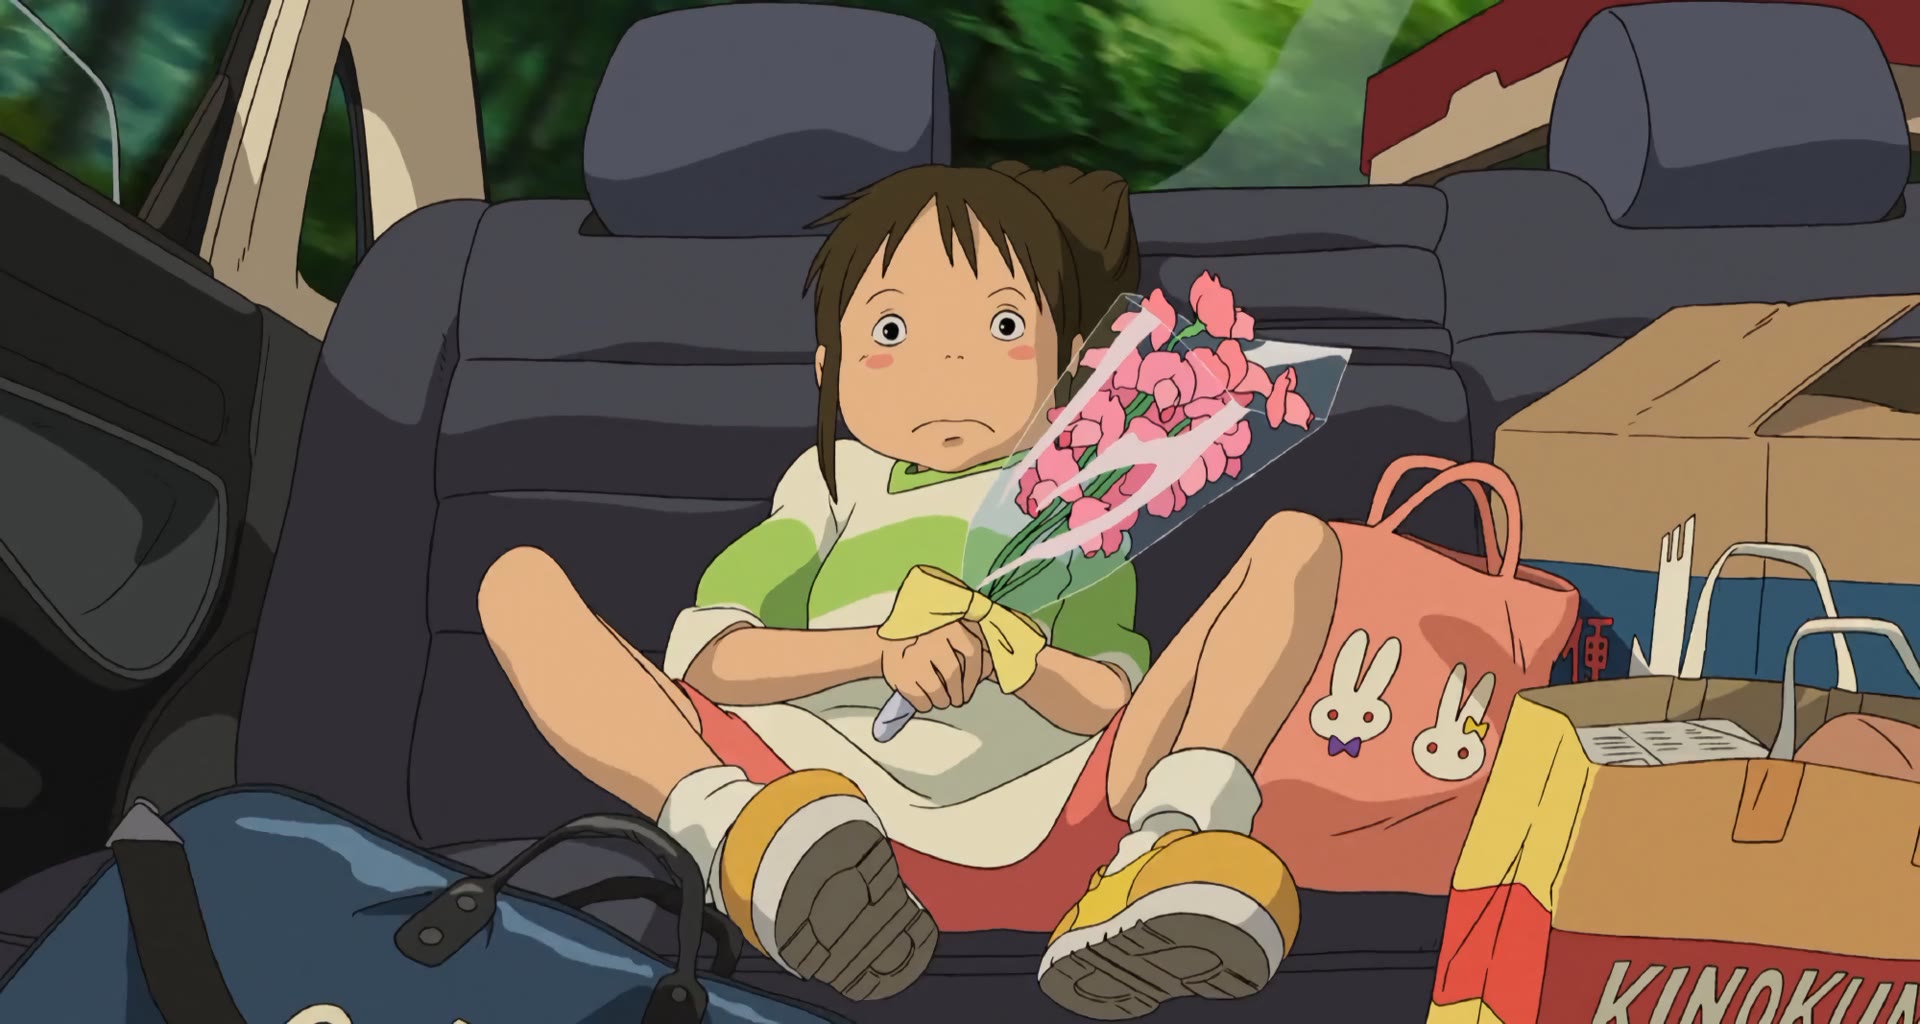
朴素贝叶斯公式
西瓜数据
复制保存为csv文件格式
色泽,根蒂,敲声,纹理,脐部,触感,好瓜青绿,蜷缩,浊响,清晰,凹陷,硬滑,是乌黑,蜷缩,沉闷,清晰,凹陷,硬滑,是乌黑,蜷缩,浊响,清晰,凹陷,硬滑,是青绿,蜷缩,沉闷,清晰,凹陷,硬滑,是浅白,蜷缩,浊响,清晰,凹陷,硬滑,是青绿,稍蜷,浊响,清晰,稍凹,软粘,是乌黑,稍蜷,浊响,稍糊,稍凹,软粘,是乌黑,稍蜷,浊响,清晰,稍凹,硬滑,是乌黑,稍蜷,沉闷,稍糊,稍凹,硬滑,否青绿,硬挺,清脆,清晰,平坦,软粘,否浅白,硬挺,清脆,模糊,平坦,硬滑,否浅白,蜷缩,浊响,模糊,平坦,软粘,否青绿,稍蜷,浊响,稍糊,凹陷,硬滑,否浅白,稍蜷,沉闷,稍糊,凹陷,硬滑,否乌黑,稍蜷,浊响,清晰,稍凹,软粘,否浅白,蜷缩,浊响,模糊,平坦,硬滑,否青绿,蜷缩,沉闷,稍糊,稍凹,硬滑,否
实现理论
假设事件西瓜是好瓜为Y,是坏瓜为N,
属性色泽,根蒂,敲声,纹理,脐部,触感,分别为a,b,c,d,e,f,
在已知西瓜属性的情况下西瓜是好瓜的概率为:
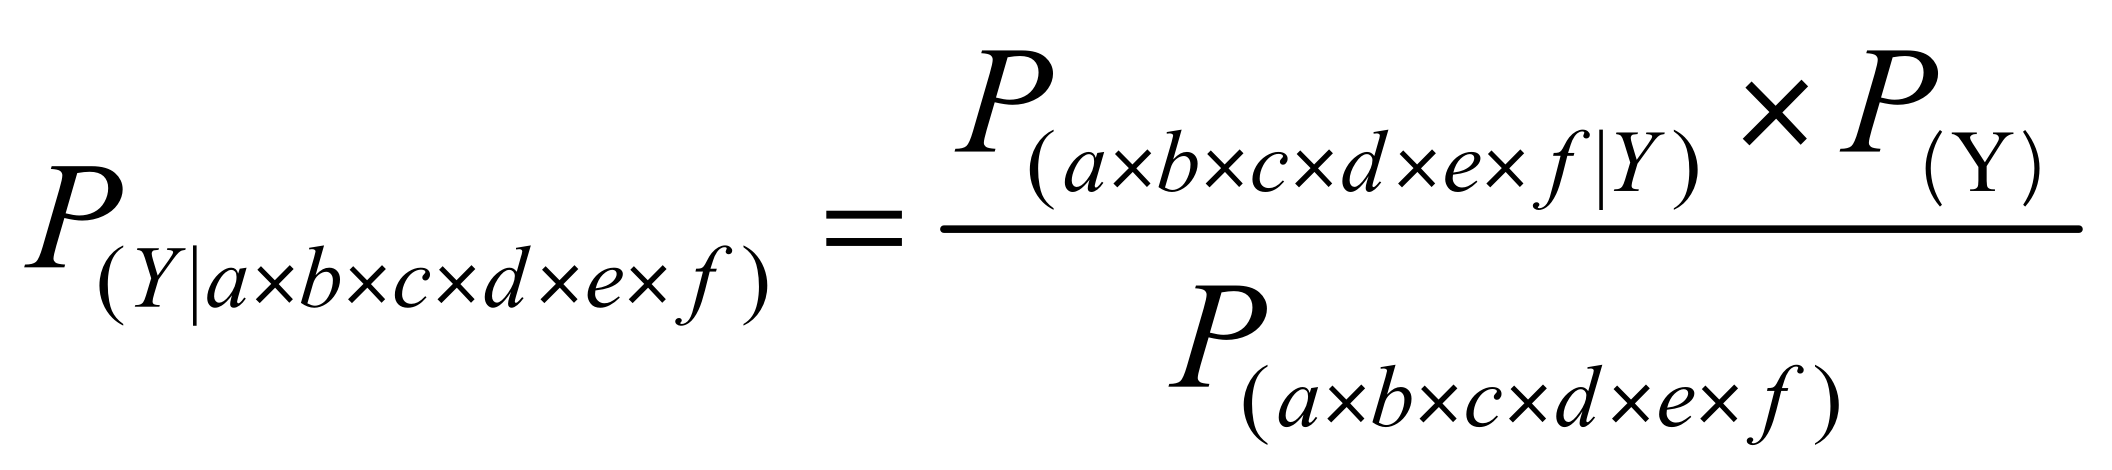
又有: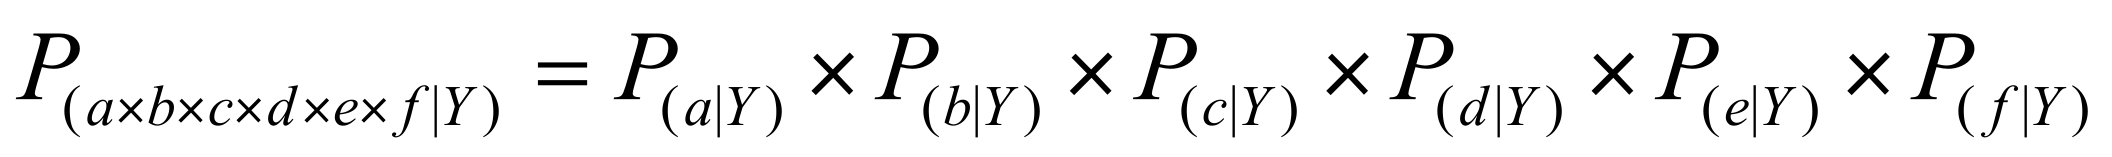
在已知西瓜属性的情况下西瓜不是好瓜的概率为:
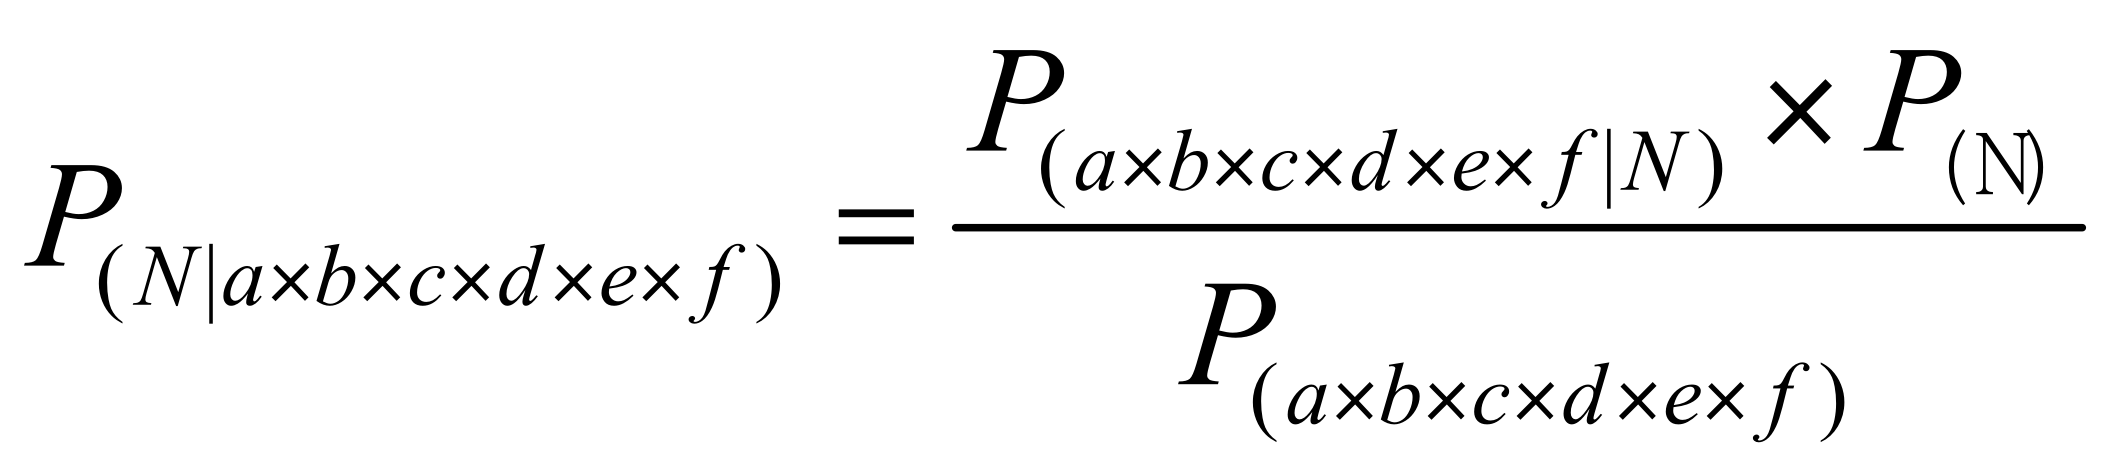
又有: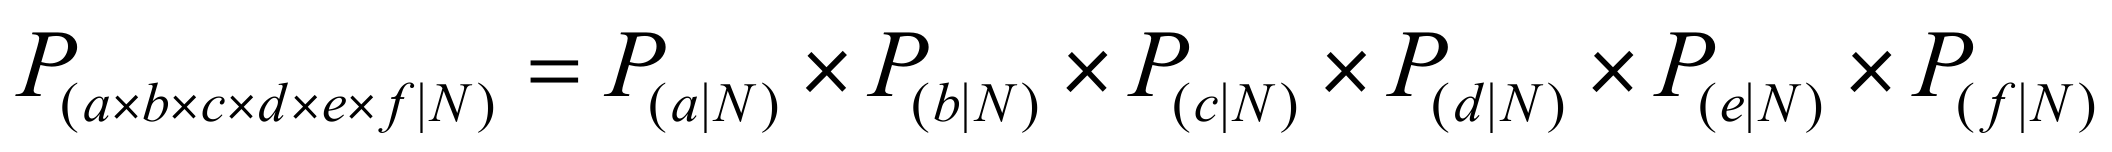
两个相除,得到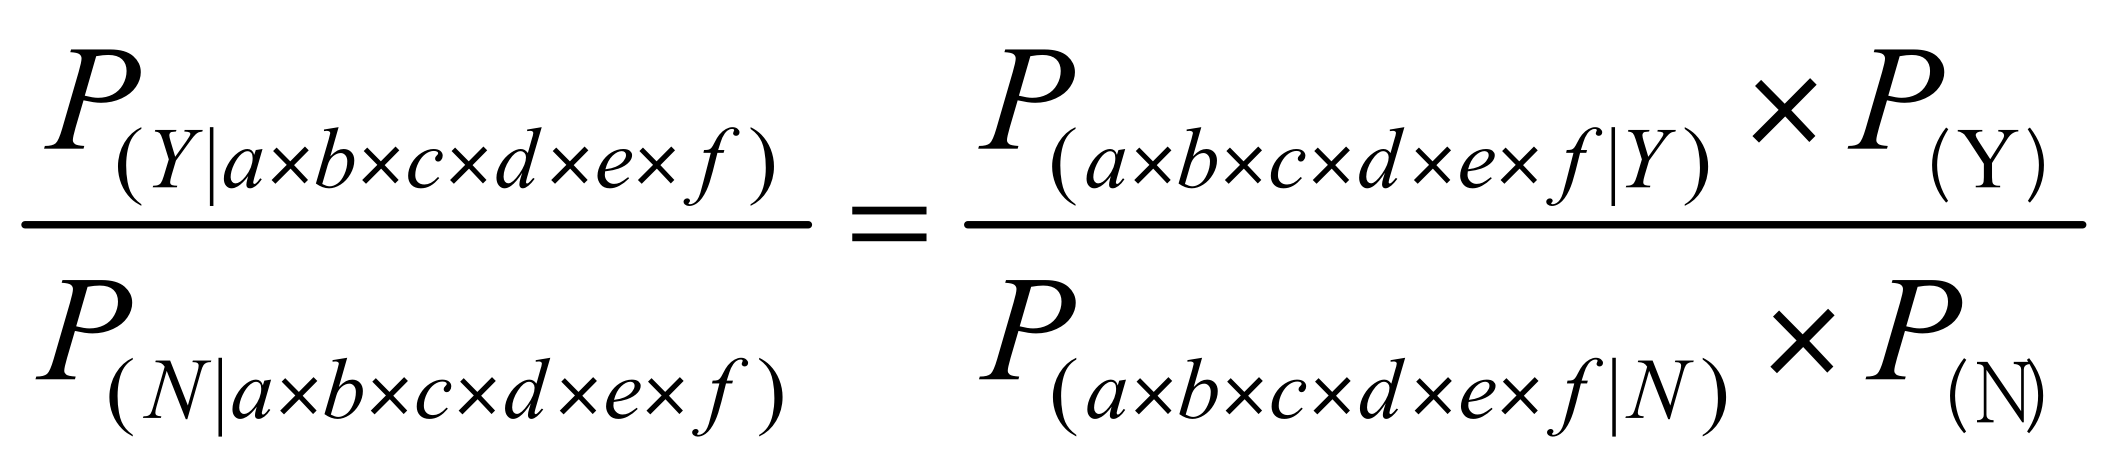
当其大于1是,可以判断西瓜是好瓜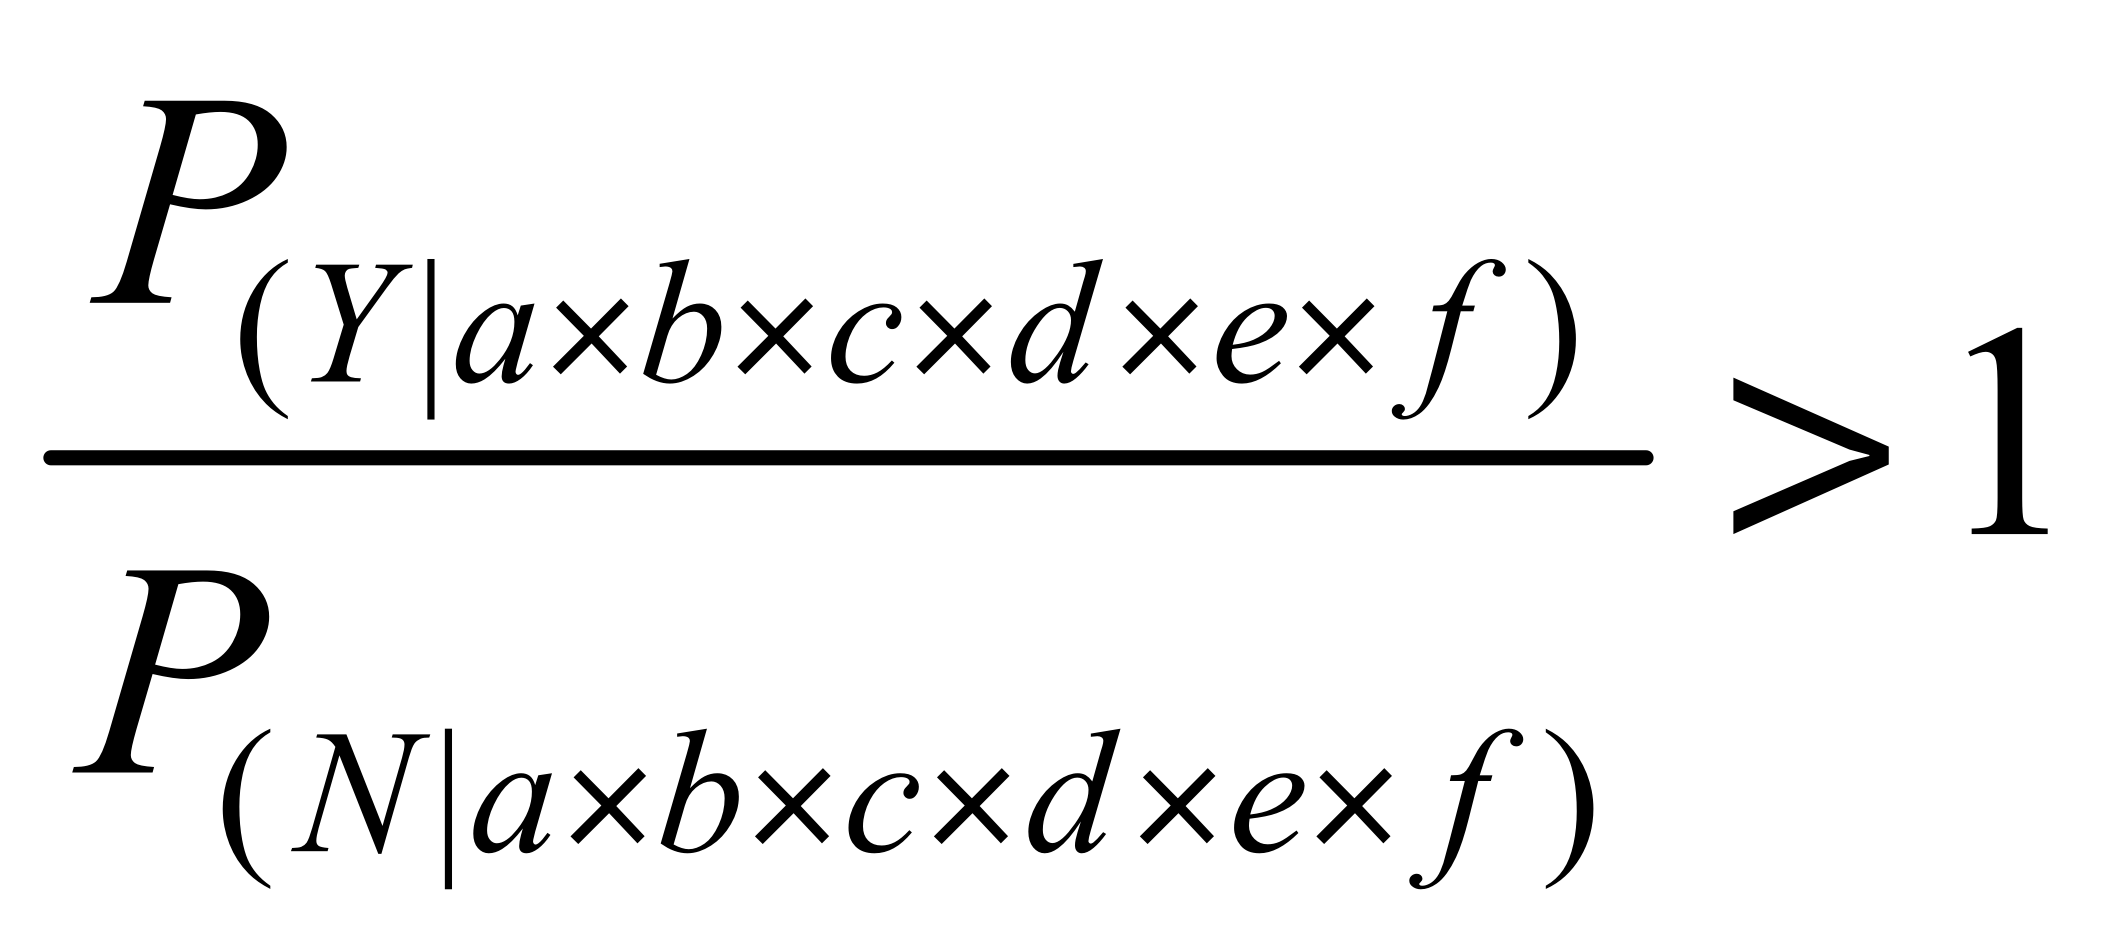
在计算过程中,有可能出现值为0或者值过于小的情况,所以进行log处理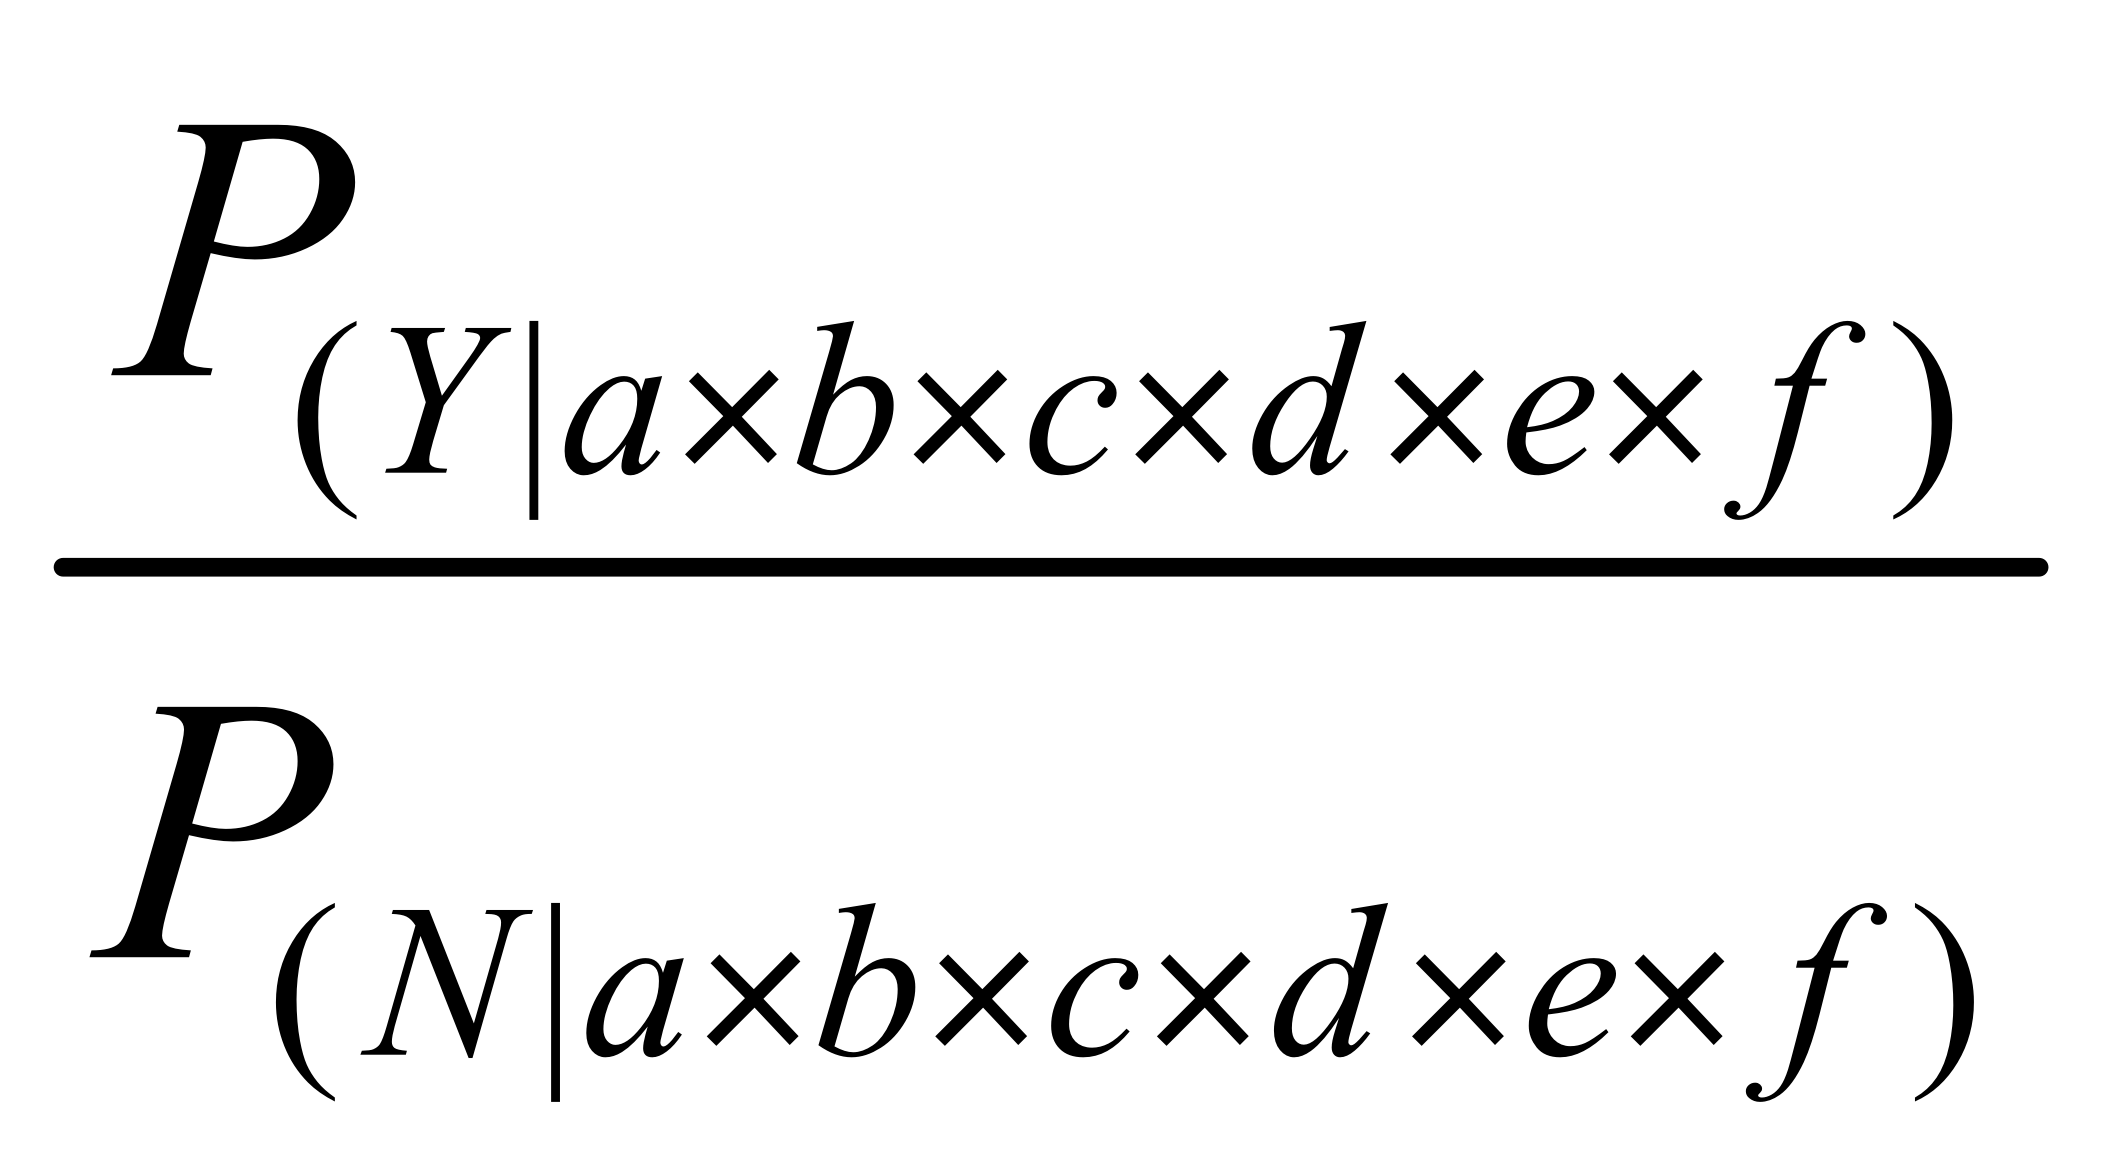
=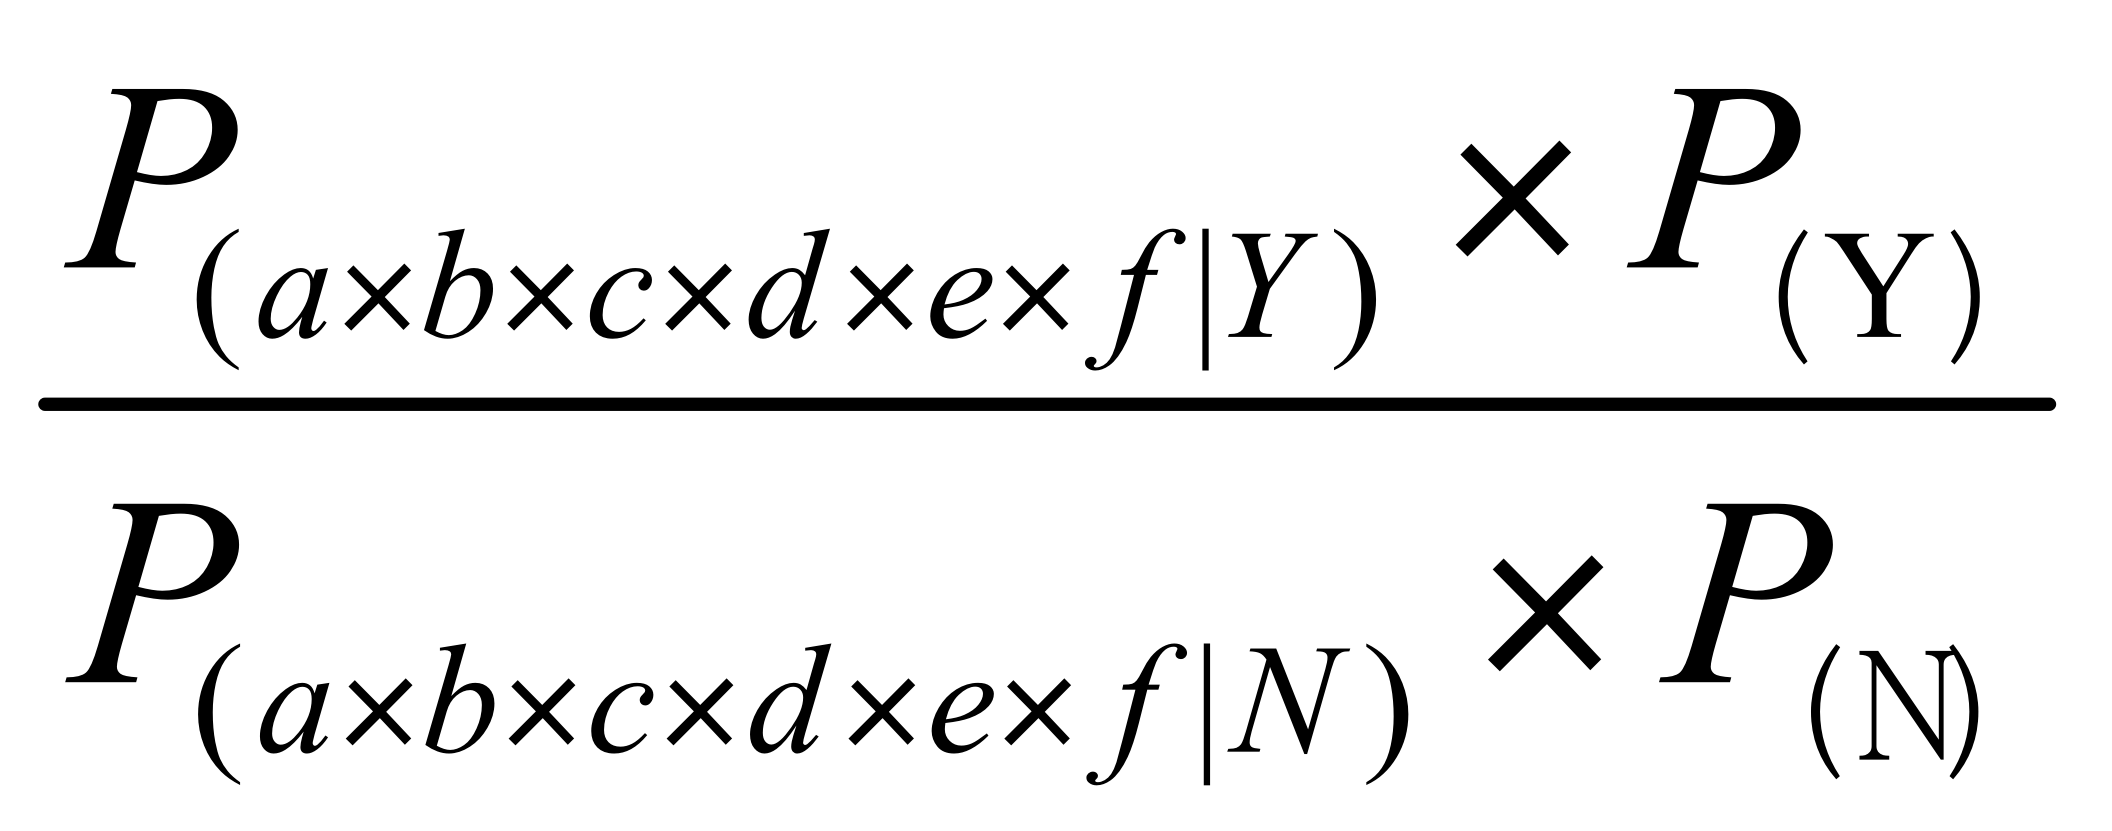
=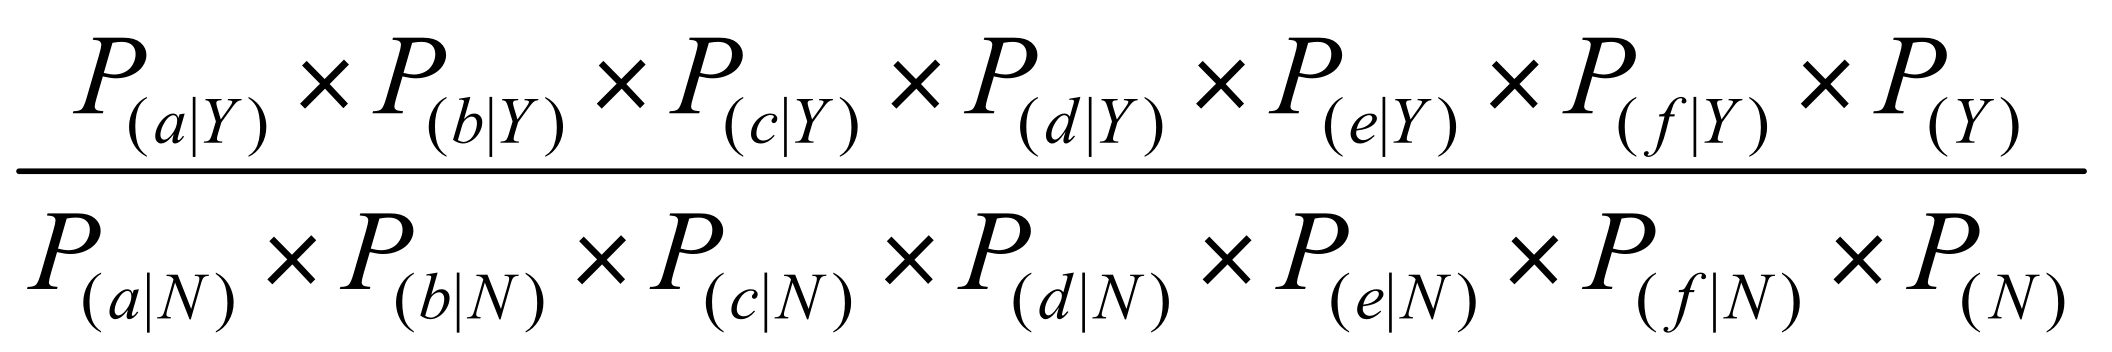
=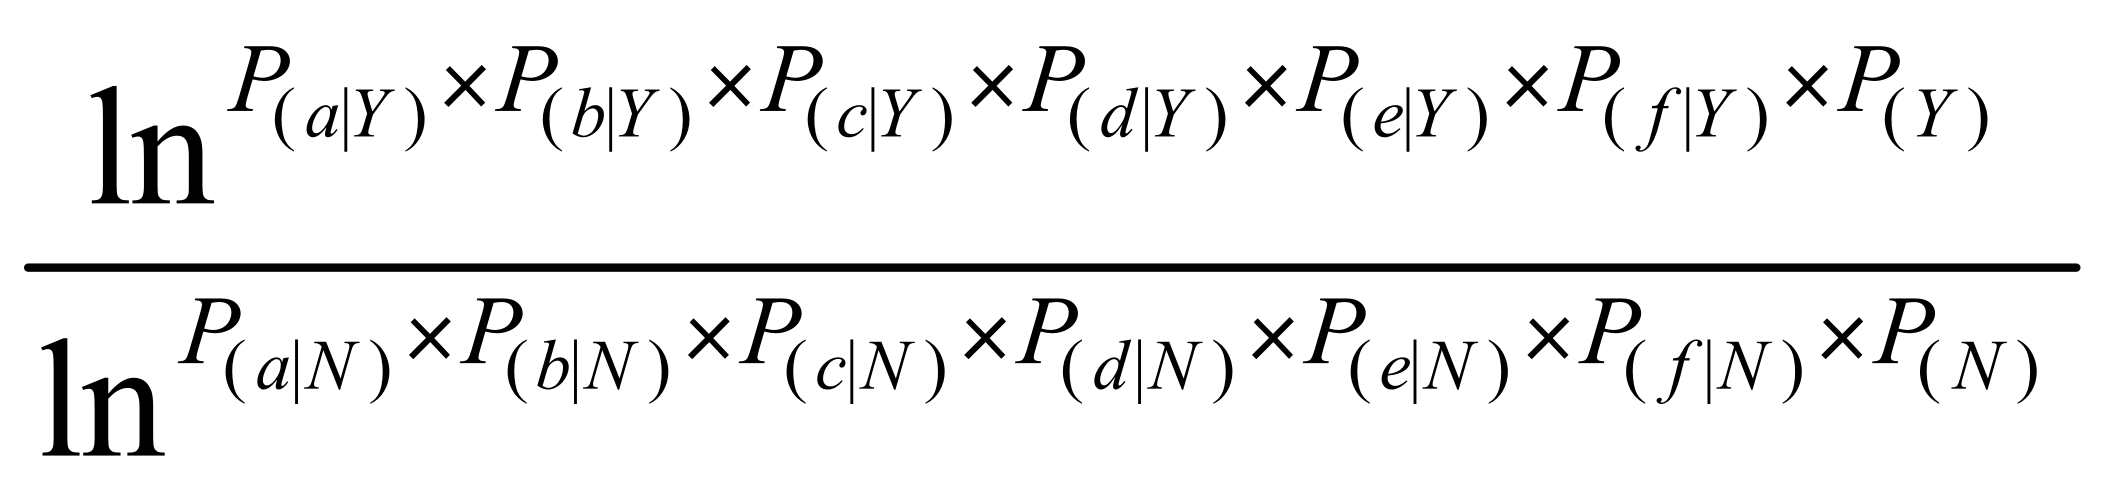
=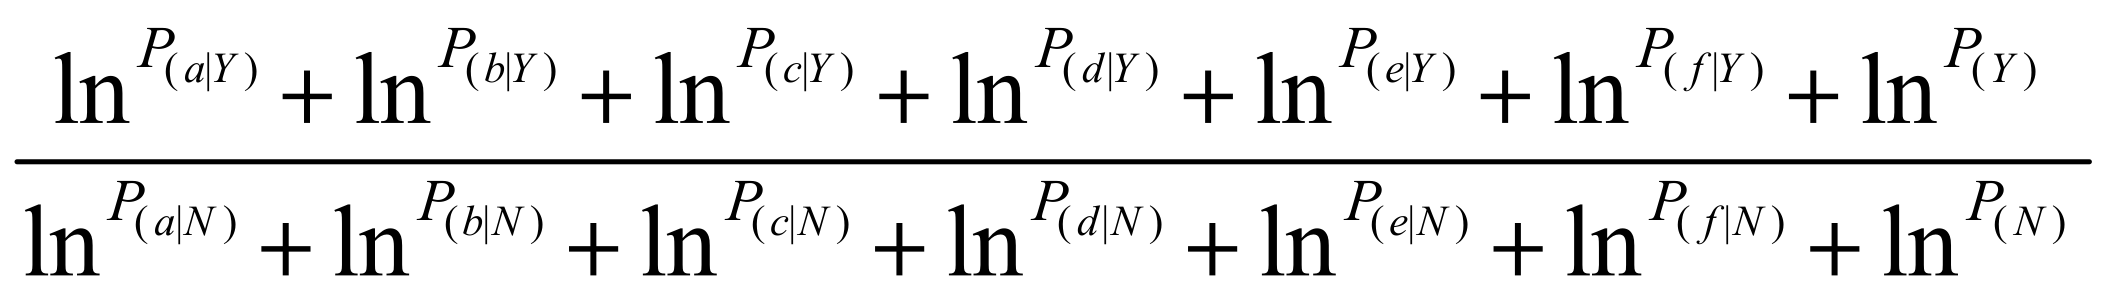
为了防止0的情况出现,所以我们进行全部加1来进行比较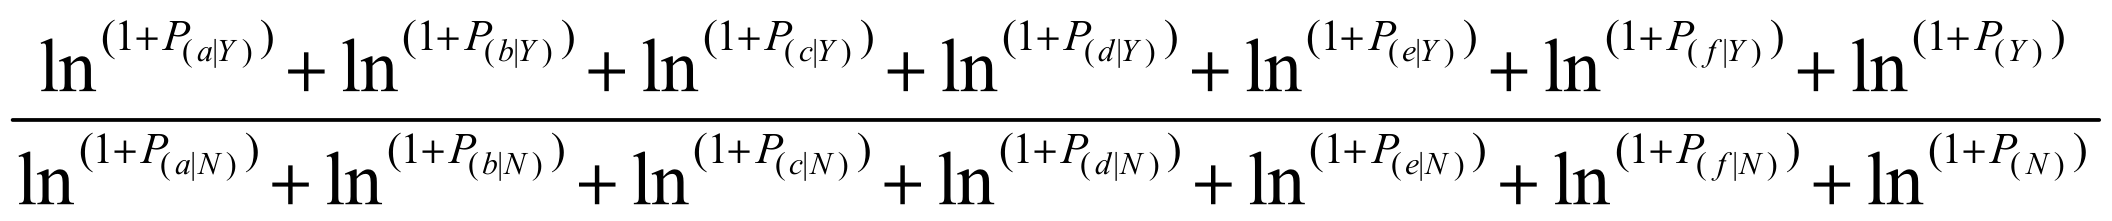
代码实现
需要安装的工具包
import numpyimport pandas
数据预处理
import jsonimport pandas as pd# 导入数据/生成数据表dataSheet = pd.read_csv("E:\\Data\\西瓜\\123.csv", encoding="utf-8")# print(dataSheet)# 预数据data_proba = {}# 标签/列名称header = dataSheet.columns# 案例个数/行数length = dataSheet.shape[0]# 数据表值values = dataSheet.values# 最后一列的不重复数据end_unique = dataSheet[header[-1]].unique()# 遍历for end in end_unique:# [header[-1]==end]时end出现的次数end_sum = dataSheet[dataSheet[header[-1]].isin([end])].shape[0]# [header[-1]==end]时end出现的频率end_proba = dataSheet[dataSheet[header[-1]].isin([end])].shape[0] / length# 预保存data_proba[end] = {'proba': end_proba, 'data': {}}# 遍历标签/列名称for head in header[:-1]:# 初始化data_proba[end]['data'][head] = {}# 该标签/名称下不重复值head_unique = dataSheet[head].unique()# 遍历属性for head_val in head_unique:# [header[-1]==end]时head_val出现的次数head_val_sum = dataSheet[dataSheet[head].isin([head_val]) & dataSheet[header[-1]].isin([end])].shape[0]# [header[-1]==end]时head_val出现的频率head_val_proba = head_val_sum / end_sum# 预保存data_proba[end]['data'][head][head_val] = head_val_proba# 打印结果print(json.dumps(data_proba, indent=4, ensure_ascii=False))
数据预测
import numpy as np# 创建一个存放判断结果的数组new = np.empty((length, 1), str)# 遍历values的每一行for val_num in np.arange(length):judge = {}# 遍历最后一列不重复数据for end in end_unique:# 标签/列名称除最后一列的数量header_sum = len(header[:-1])# 创建一个临时存放数据的数组tempor = np.empty(header_sum + 1, float)# 最后一个标签/列名称的属性对应的先验概率end_proba = data_proba[end]['proba']# 加1处理end_proba += 1# 临时保存tempor[-1] = end_proba# 遍历除最后一行的标签/列名称for head_num in np.arange(header_sum):# 标签/列名称head = header[head_num]# 该标签/列名称下的属性val = values[val_num][head_num]# 属性对应的先验概率head_val_proba = data_proba[end]['data'][head][val]# 加1处理head_val_proba += 1# 临时保存tempor[head_num] = head_val_proba# 对数据log处理并求和保存temp = np.log(tempor).sum()judge[temp] = end# 提取后验概率较大的值judge_max = np.max(list(judge.keys()))# 保存预测结果new[val_num] = judge[judge_max]# 将预测结果添加到数据表新列dataSheet['new'] = new# 预测正确的数量rate = dataSheet[dataSheet[header[-1]] == dataSheet['new']].shape[0]# 打印数据表print(dataSheet)# 准确率print('准确率: {rate:.7f}%'.format(rate=100 * rate / length))
完整代码
import jsonimport numpy as npimport pandas as pd# 导入数据/生成数据表dataSheet = pd.read_csv("E:\\Data\\西瓜\\123.csv", encoding="utf-8")# print(dataSheet)# 预数据data_proba = {}# 标签/列名称header = dataSheet.columns# 案例个数/行数length = dataSheet.shape[0]# 数据表值values = dataSheet.values# 最后一列的不重复数据end_unique = dataSheet[header[-1]].unique()# 遍历for end in end_unique:# [header[-1]==end]时end出现的次数end_sum = dataSheet[dataSheet[header[-1]].isin([end])].shape[0]# [header[-1]==end]时end出现的频率end_proba = dataSheet[dataSheet[header[-1]].isin([end])].shape[0] / length# 预保存data_proba[end] = {'proba': end_proba, 'data': {}}# 遍历标签/列名称for head in header[:-1]:# 初始化data_proba[end]['data'][head] = {}# 该标签/名称下不重复值head_unique = dataSheet[head].unique()# 遍历属性for head_val in head_unique:# [header[-1]==end]时head_val出现的次数head_val_sum = dataSheet[dataSheet[head].isin([head_val]) & dataSheet[header[-1]].isin([end])].shape[0]# [header[-1]==end]时head_val出现的频率head_val_proba = head_val_sum / end_sum# 预保存data_proba[end]['data'][head][head_val] = head_val_proba# 打印结果# print(json.dumps(data_proba, indent=4, ensure_ascii=False))# 创建一个存放判断结果的数组new = np.empty((length, 1), str)# 遍历values的每一行for val_num in np.arange(length):judge = {}# 遍历最后一列不重复数据for end in end_unique:# 标签/列名称除最后一列的数量header_sum = len(header[:-1])# 创建一个临时存放数据的数组tempor = np.empty(header_sum + 1, float)# 最后一个标签/列名称的属性对应的先验概率end_proba = data_proba[end]['proba']# 加1处理end_proba += 1# 临时保存tempor[-1] = end_proba# 遍历除最后一行的标签/列名称for head_num in np.arange(header_sum):# 标签/列名称head = header[head_num]# 该标签/列名称下的属性val = values[val_num][head_num]# 属性对应的先验概率head_val_proba = data_proba[end]['data'][head][val]# 加1处理head_val_proba += 1# 临时保存tempor[head_num] = head_val_proba# 对数据log处理并求和保存temp = np.log(tempor).sum()judge[temp] = end# 提取后验概率较大的值judge_max = np.max(list(judge.keys()))# 保存预测结果new[val_num] = judge[judge_max]# 将预测结果添加到数据表新列dataSheet['new'] = new# 预测正确的数量rate = dataSheet[dataSheet[header[-1]] == dataSheet['new']].shape[0]# 打印数据表print(dataSheet)# 准确率print('准确率: {rate:.7f}%'.format(rate=100 * rate / length))
未修改代码
import jsonimport numpy as npimport pandas as pddataTrain = pd.read_csv("E:\\Data\\西瓜\\123.csv", encoding="utf-8")# print(dataTrain)data = {}header = dataTrain.columnslength = dataTrain.shape[0]values = dataTrain.valuesfor i in dataTrain[header[-1]].unique():data[i] = {'proba': dataTrain[dataTrain[header[-1]].isin([i])].shape[0] / length, 'data': {}}for j in header[:-1]:data[i]['data'][j] = {}for n in dataTrain[j].unique():data[i]['data'][j][n] = \dataTrain[dataTrain[j].isin([n]) & dataTrain[header[-1]].isin([i])].shape[0] / \dataTrain[dataTrain[header[-1]].isin([i])].shape[0]# print(json.dumps(data, indent=4, ensure_ascii=False))r = np.empty((length, 1), str)for v in np.arange(values.shape[0]):a_l = {}for i in dataTrain[header[-1]].unique():a = np.log([data[i]['data'][header[j]][values[v][j]] + 1for j in np.arange(len(header[:-1]))]).sum()a_l[a + np.log(data[i]['proba']+1)] = ir[v] = a_l[np.max(list(a_l.keys()))]dataTrain['new'] = rrate = dataTrain[dataTrain[header[-1]] == dataTrain['new']].shape[0]print('准确率: {rate:.7f}%'.format(rate=100 * rate / length))
注意事项
1、根据数据预测正确率为88.24%
2、没有弄数据错误的处理,需要自行优化
python环境
电脑:Windows10
python:3.10.4

若有收获,就点个赞吧
0 人点赞


