记录维维的每一篇Hello World
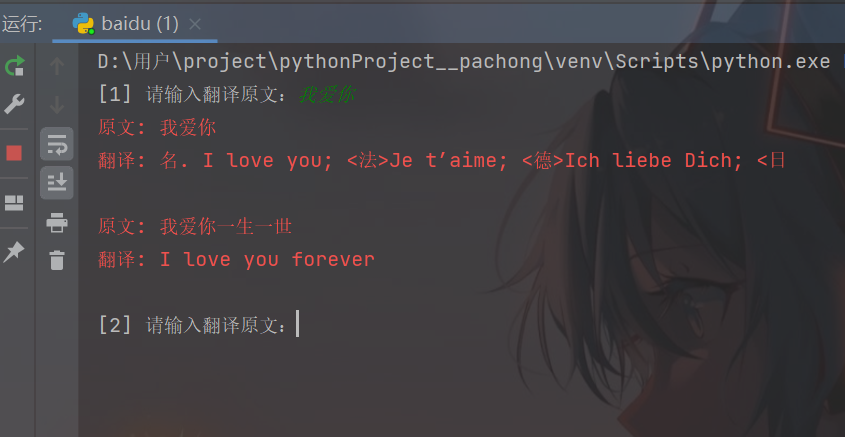
需要安装的第三方库
pip install requests
爬取步骤
一、获取请求url以及请求数据
1、首先前往百度翻译 ,在下面这个页面输入想要翻译的文本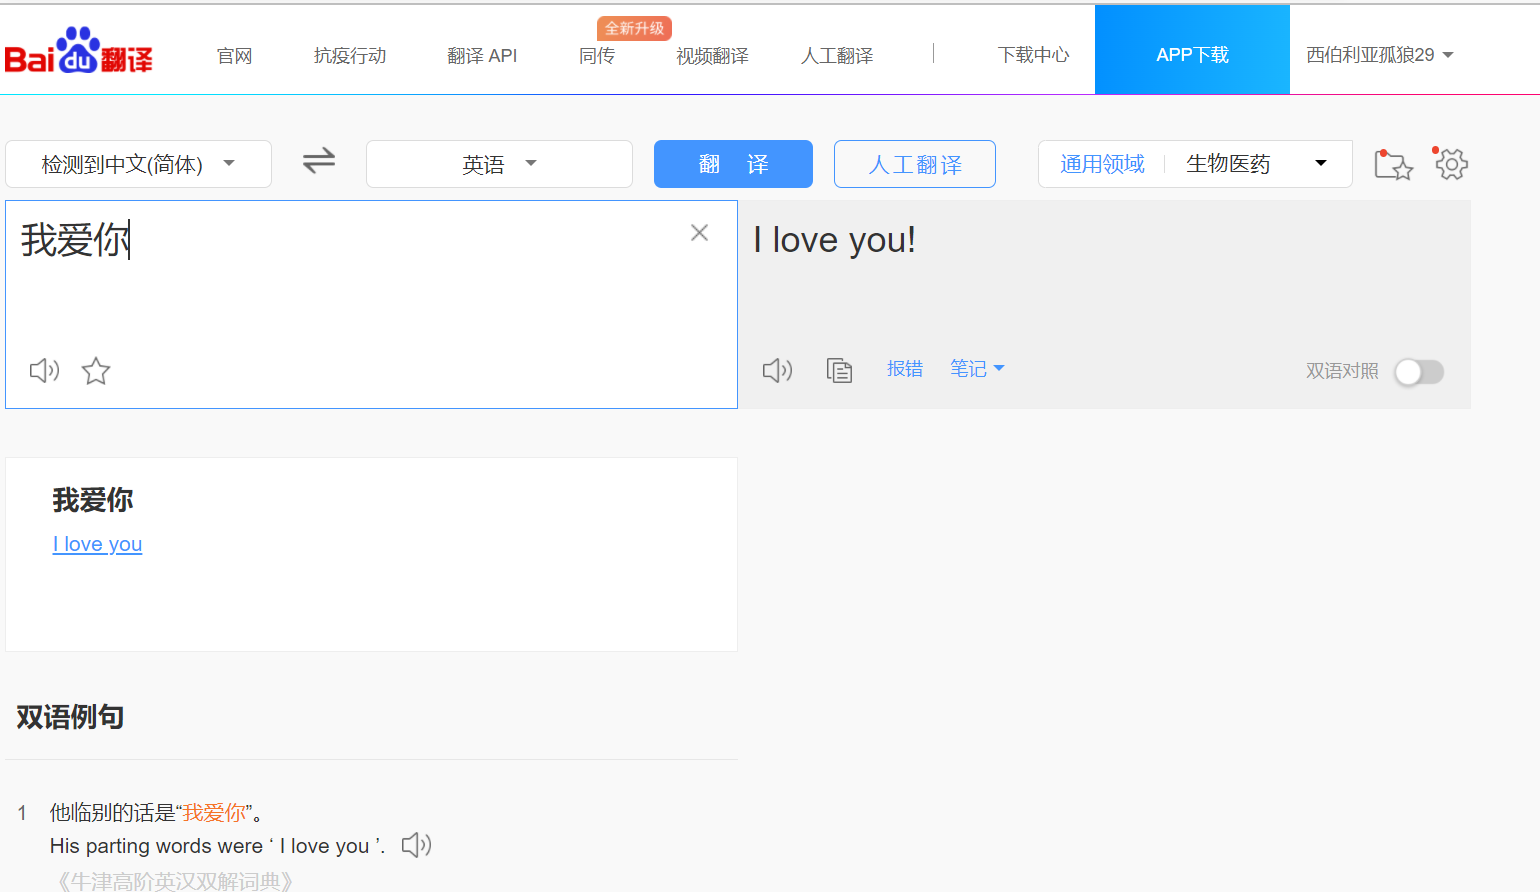
2、在这个页面按下F12打开开发者页面,点击网络,再点XHR进入如下页面,找到sug的请求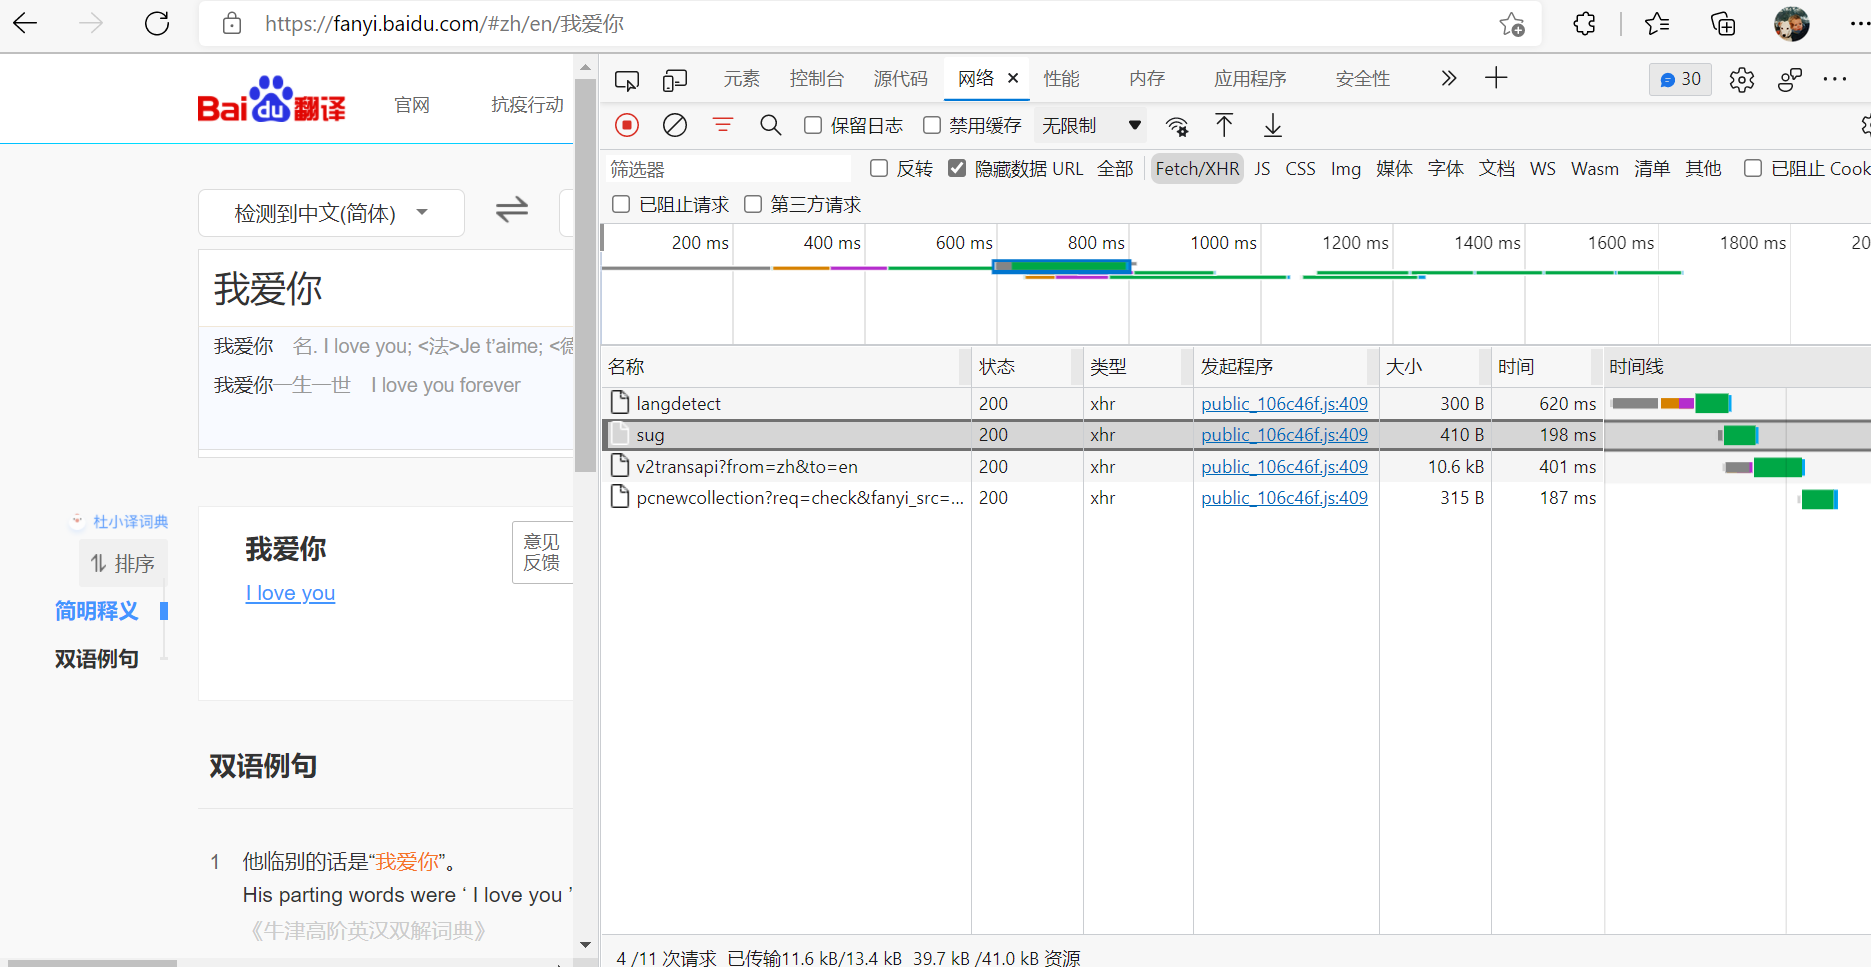
3、里面的请求url就是我们需要的,请求方法是post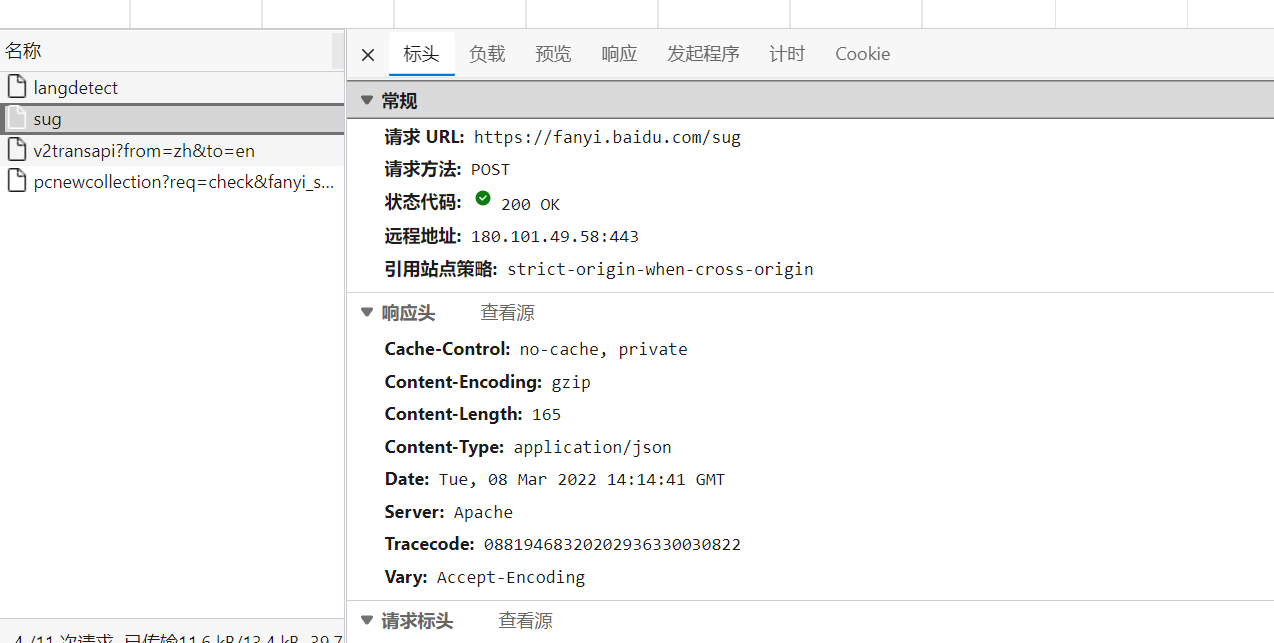
4、往下滑的,看到User-Agent也是我们需要的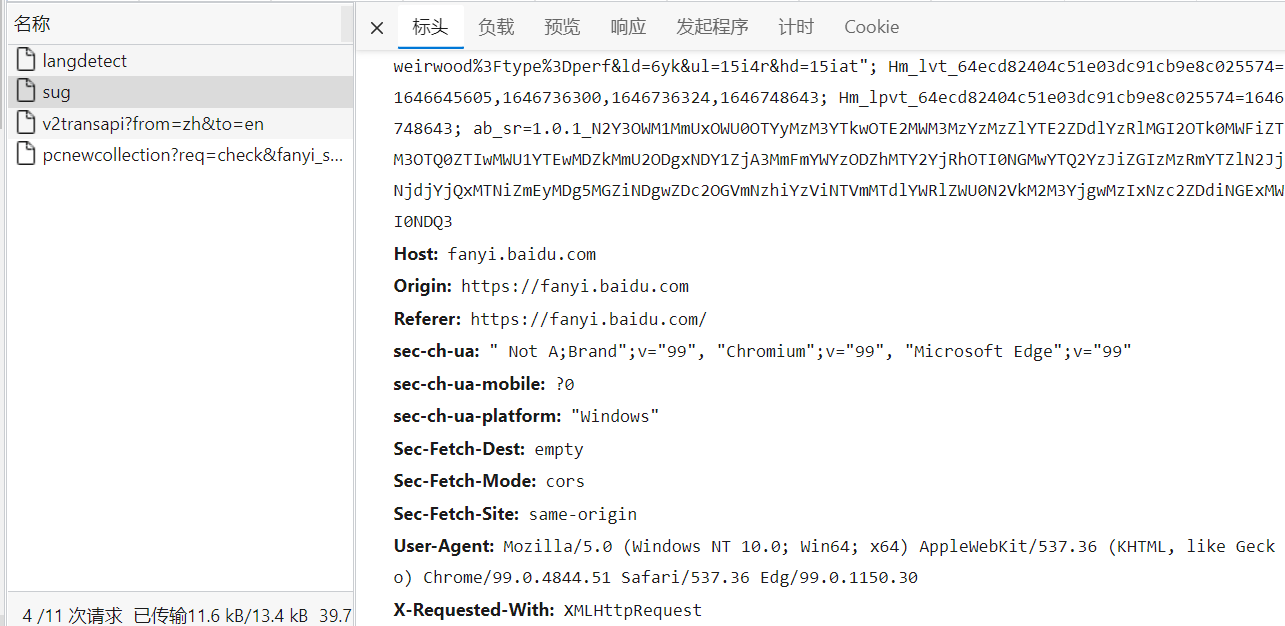
5、点击负载,可以看到请求的数据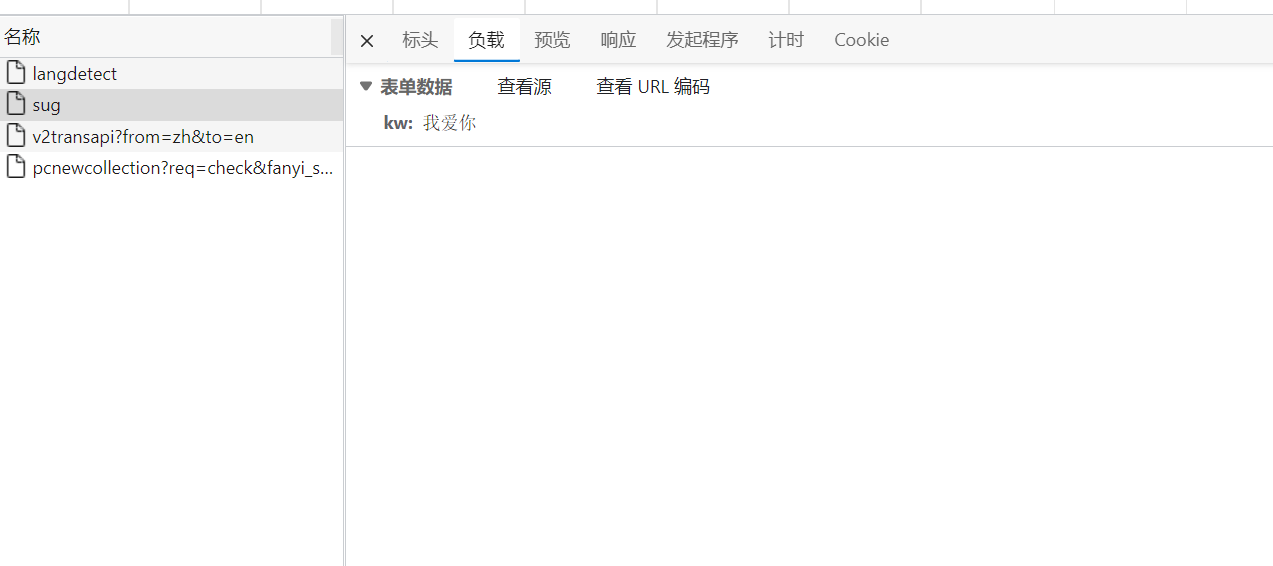
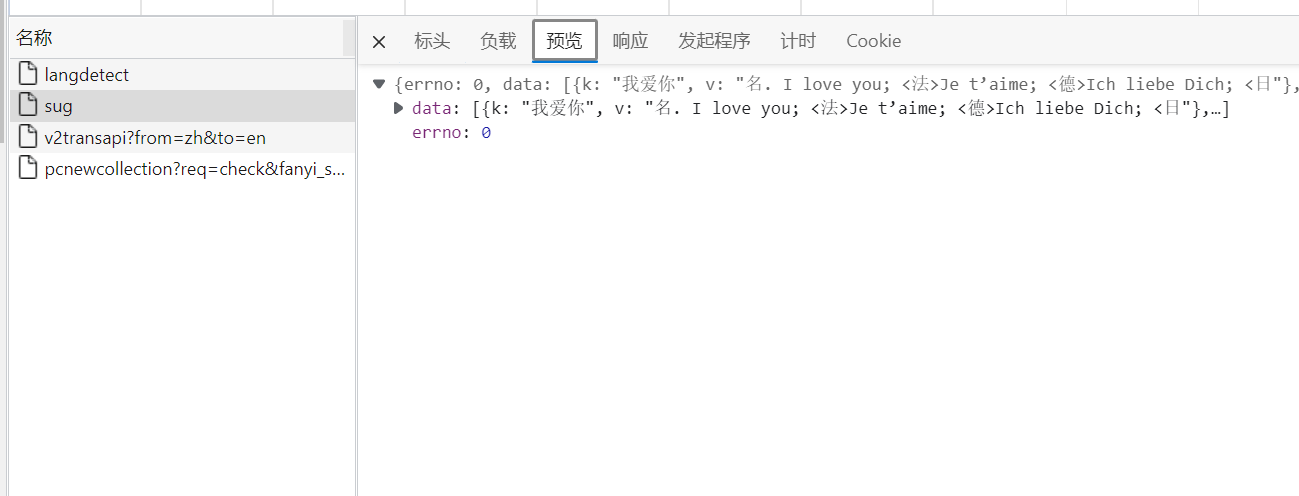
6、点击预览可以看到返回以下的内容
 二、基本的请求过程
有了请求url,请求方法,请求数据格式,我们就可以开始写一个简单的翻译请求过程
# 请求urlsug_url = 'https://fanyi.baidu.com/sug'# 请求数据key_word = "我爱你"data = {'kw': key_word}#请求头header = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) ""Chrome/99.0.4844.51 Safari/537.36 Edg/99.0.1150.30"}# 请求方法response = requests.post(sug_url, data=data, headers=header)# 设置编码response.encoding = 'utf-8'# 获得json数据result = response.json()# 打印数据print(result)
完整源码
#!../venv/Scripts python# -*- coding:utf-8 -*-# Project: 百度翻译# Created by 维维import requestsimport itertoolsdef baidu(key_word):# 请求链接sug_url = 'https://fanyi.baidu.com/sug'# 请求数据data = {'kw': key_word}# 请求头header = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) ""Chrome/99.0.4844.51 Safari/537.36 Edg/99.0.1150.30"}# 请求方法response = requests.post(sug_url, data=data, headers=header)# 设置编码response.encoding = 'utf-8'# 得到json数据result = response.json()# 打印结果if not result['errno'] == 0:# 翻译错误print(f'翻译错误: {key_word}\n')elif len(result['data']) == 0:# 翻译失败,打印原文print(f"原文: {key_word}")print(f"翻译: {key_word}\n")else:for res in result['data']:# 打印翻译print(f"原文: {res['k']}")print(f"翻译: {res['v']}\n")if __name__ == '__main__':# 生成迭代器m = itertools.count(1)while True:# 输入需要翻译的文本keyword = input(f'[{m.__next__()}] 请输入翻译原文:')# 输入q退出if keyword == 'q':break# 翻译baidu(keyword)
python环境
电脑:Windows10
python:3.8.8(建议3.7以上)
最新版requests(版本影响不大)

若有收获,就点个赞吧
0 人点赞


