记录维维的每一篇Hello World
需要用到的库
import reimport requestsimport tqdmimport osimport threadingimport timeimport itertools
完整源码
import reimport requestsimport tqdmimport osimport threadingimport timeimport itertoolsname = itertools.count(1)class Thread(threading.Thread):def __init__(self, function, parameter, delayed: int = 0):threading.Thread.__init__(self)# self.threadID = threadIDself.function = functionself.parameter = parameterself.delayed = delayeddef run(self):time.sleep(self.delayed)self.function(self.parameter)def get_pic(parameter):file_path = os.path.join(parameter[1], str(name.__next__()) + '.jpg')with open(file_path, 'wb') as f:f.write(requests.get(parameter[0]).content)# print("已完成")def get_url(text):init_path = "D:\\AppData\\picture"if not os.path.exists(init_path):os.mkdir(init_path)num = str(len(os.listdir(init_path)) + 1)now_path = os.path.join(init_path, num)os.mkdir(now_path)url_video_list = re.findall('http[s]?://[a-zA-Z0-9./_]*', text)headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) ""Chrome/99.0.4844.51 Safari/537.36 Edg/99.0.1150.30",}if len(url_video_list) == 0:print("."*20)returnresult = []for url_video in tqdm.tqdm(url_video_list, desc="正在获取图片链接"):html = requests.get(url=url_video, headers=headers).textpattern = re.compile('http[s]?://[a-zA-Z0-9./_]*?_[0-9][0-9]?.jpg')pic_url_list = re.findall(pattern, html)result.extend(pic_url_list[1:])os.startfile(now_path)for pic_url in result:Thread(function=get_pic, parameter=(pic_url, now_path)).start()time.sleep(0.1)if __name__ == '__main__':get_url(input("输入内容:"))
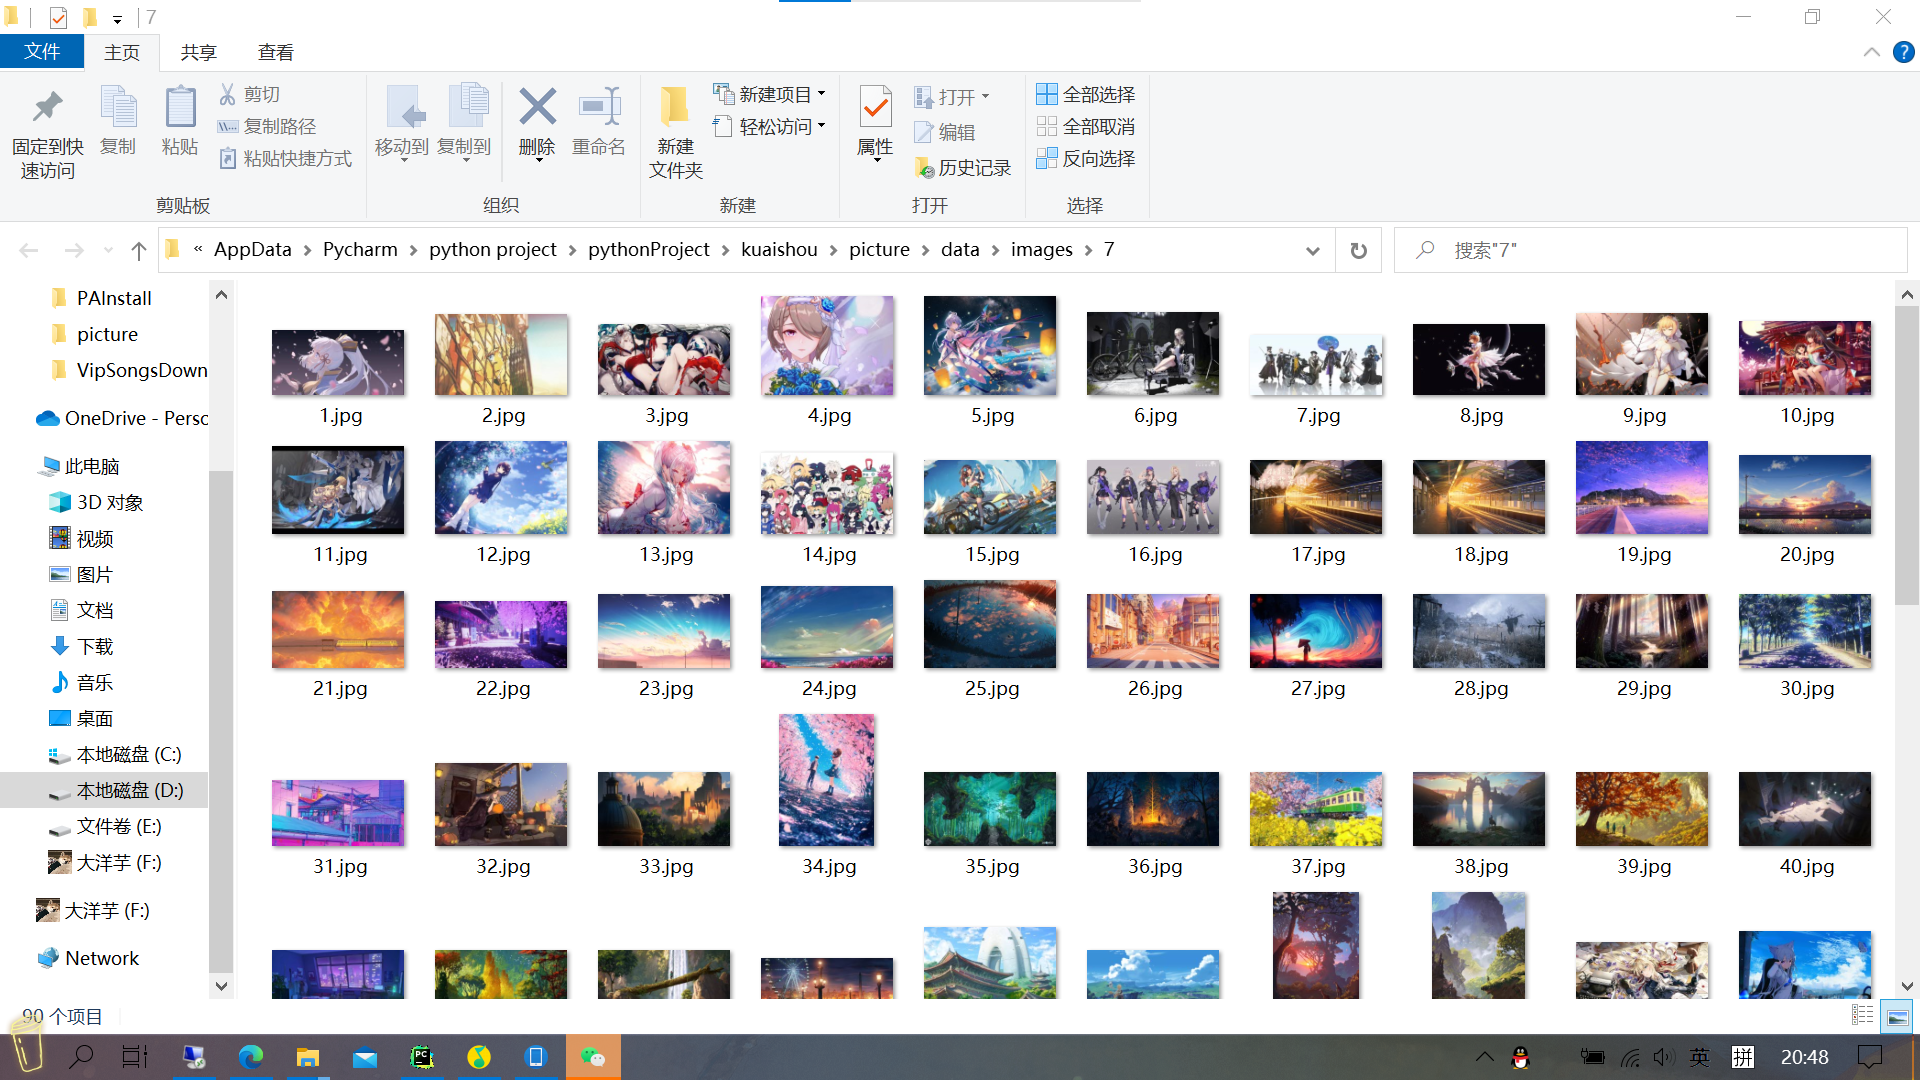
使用示例
注意事项
1、本示例使用多线程下载图片,在网速支持的情况可以实现秒完成
2、获取图片链接的过程使用的是循环,比较缓慢(可以使用多线程完成此过程)
4、复制链接可以是多个,未经过提取的原文本
4、默认路径为”D:\AppData\picture”(可自行更改)
5、无需担心文件会冲突,在不随意更改的情况下会自动避开
python环境
电脑:Windows10
python:3.10.4

若有收获,就点个赞吧
0 人点赞


