- 01、课程目标
- 02、Elasticsearch聚合搜索:聚合分类
- 03、Elasticsearch聚合搜索:Bucket(桶)聚合
- 04、Elasticsearch聚合搜索:Metric(管道)聚合
- 05、搜索实战:过滤条件聚合显示
- 06、Elasticsearch拼音搜索:拼音分词器
- 07、Elasticsearch拼音搜索:自定义分词器
- 08、搜索实战:实现酒店拼音搜索
- 09、Elasticsearch自动补全:自动补全功能
- 10、▲ 搜索实战:搜索关键词自动补全
- 11、△ * 数据同步:同步方案分析
- 12、数据同步:导入酒店管理后台项目
- 13、数据同步:创建交换机和队列
- 14、数据同步:生产者发送MQ消息
- 15、数据同步:消费者监听MQ消息更新索引
- 16、Elasticsearch集群:集群及相关概念
- 17、Elasticsearch集群:搭建集群环境
- 18、* Elasticsearch集群:JavaAPI操作集群
- 19、Elasticsearch集群:路由原理
- 20、Elasticsearch集群:脑裂问题
- 21、Elasticsearch集群:故障迁移
- 22、课程总结
01、课程目标
- 能够掌握Elasticsearch聚合搜索
- 能够掌握Elasticsearch拼音分词器使用
- 能够掌握Elasticsearch自定义分词器使用
- 能够完成酒店搜索自动补全功能
- 能够掌握酒店数据自动导入Elasticsearch
- 能够了解Elasticsearch集群相关知识
02、Elasticsearch聚合搜索:聚合分类
聚合常见的有三类:
- 桶(Bucket)聚合:用来对文档做分组 类似mysql的group by
- TermAggregation:按照文档字段值分组,例如按照品牌值分组、按照国家分组
- Date Histogram:按照日期阶梯分组,例如一周为一组,或者一月为一组
- 度量(Metric)聚合:用以计算一些值,比如:最大值、最小值、平均值等
- 类似于mysql统计函数 count,sum,max,min
- Avg:求平均值
- Max:求最大值
- Min:求最小值
- Stats:同时求max、min、avg、sum等
- 管道(pipeline)聚合:其它聚合的结果为基础做聚合,就是说一个聚合的结果会称为另外一个聚合的条件;
注意:参加聚合的字段必须是keyword、日期、数值、布尔类型
03、Elasticsearch聚合搜索:Bucket(桶)聚合
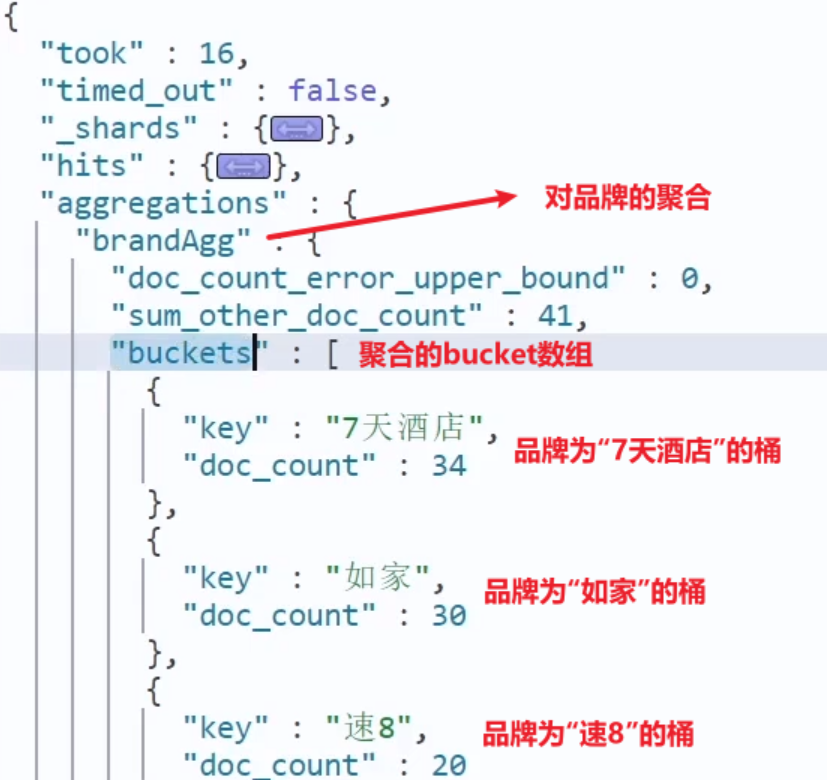
需求:统计所有数据中的酒店品牌有几种
根据这个需求,其实就是按照品牌对数据分组。此时可以根据酒店品牌的名称做聚合,也就是Bucket聚合。
1)Bucket聚合基本语法
桶聚合:使用全文检索:term 和 match的衍生类型:terms
GET /hotel/_search{"size": 0, // 设置size为0,结果中不包含文档,只包含聚合结果,取消查询列表的数据"aggs": { // 定义聚合"brandAgg": { //给聚合起个名字"terms": { // 聚合的类型,按照品牌值聚合,所以选择term"field": "brand", // 参与聚合的字段"size": 20 // 希望获取的聚合结果数量}}}}
结果如图:
2)聚合结果排序
默认情况下,Bucket聚合会统计Bucket内的文档数量,记为_count,并且按照_count降序排序。
我们可以指定order属性,自定义聚合的排序方式:
GET /hotel/_search{"size": 0,"aggs": {"brandAgg": {"terms": {"field": "brand","order": {"_count": "asc" // 按照_count升序排列},"size": 20}}}}
3)限定聚合范围
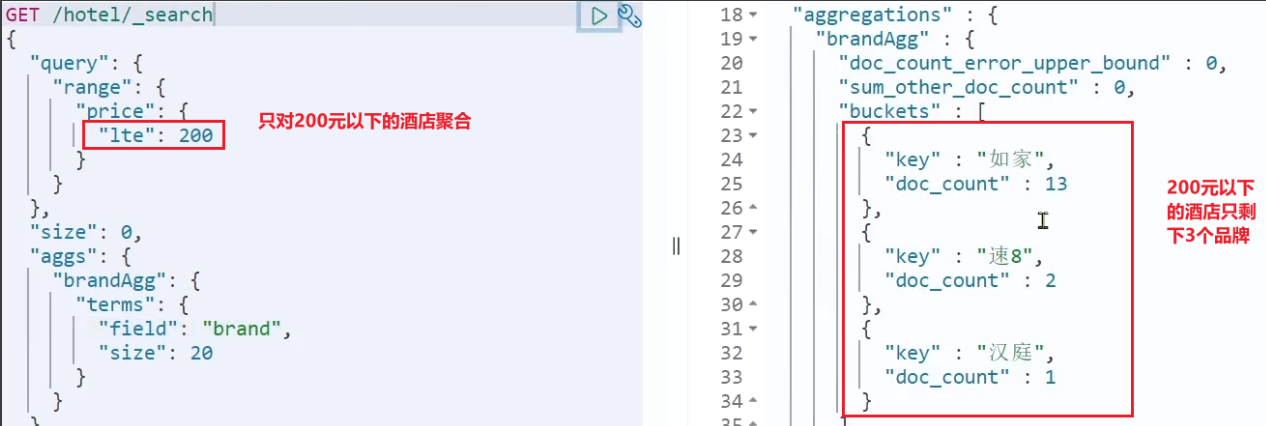
默认情况下,Bucket聚合是对索引库的所有文档做聚合,但真实场景下,用户会输入搜索条件,因此聚合必须是对搜索结果聚合。那么聚合必须添加限定条件。
我们可以限定要聚合的文档范围,只要添加query条件即可:
range
GET /hotel/_search{"query": {"range": {"price": {"lte": 200 // 只对200元以下的文档聚合}}},"size": 0,"aggs": {"brandAgg": {"terms": {"field": "brand","size": 20}}}}
这次,聚合得到的品牌明显变少了:
# 桶聚合


# 需求:统计酒店的品牌有有哪些


GET hotel/_search
{
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "size": 20
      }
    }
  }
}

# 聚合结果排序

GET hotel/_search
{
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "size": 20,
        "order": {
          "_count": "asc"
        }
      }
    }
  }
}

# 对聚合结果限定数据范围

GET hotel/_search
{
  "query": {
    "term": {
      "city": {
        "value": "北京"
      }
    }
  },
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "size": 20,
        "order": {
          "_count": "asc"
        }
      }
    }
  }
}
04、Elasticsearch聚合搜索:Metric(管道)聚合
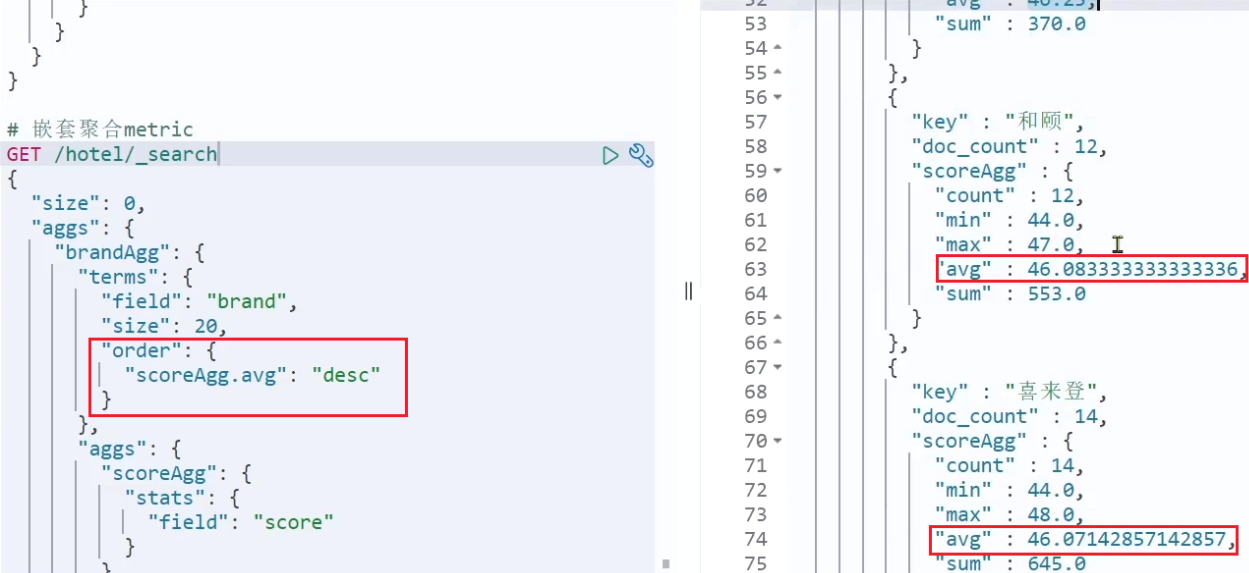
需求:统计每个品牌酒店的用户评分的min、max、avg等值
这就要用到Metric聚合了,例如stat聚合:就可以获取min、max、avg等结果。
语法如下:
stat聚合:是bucket聚合的子聚合
GET /hotel/_search
{
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "size": 20
      },
      "aggs": { // 是brands聚合的子聚合,也就是分组后对每组分别计算
        "score_stats": { // 聚合名称
          "stats": { // 聚合类型,这里stats可以计算min、max、avg等
            "field": "score" // 聚合字段,这里是score
          }
        }
      }
    }
  }
}
这次的score_stats聚合是在brandAgg的聚合内部嵌套的子聚合。因为我们需要在每个桶分别计算。
另外,我们还可以给聚合结果做个排序,例如按照每个桶的酒店平均分做排序:
# 度量聚合

# 需求:统计所有酒店的平均得分

GET hotel/_search
{
  "size": 0,
  "aggs": {
    "scoreAgg": {
      "avg": {
        "field": "score"
      }
    }
  }
}

GET hotel/_search
{
  "size": 0,
  "aggs": {
    "scoreAgg": {
      "stats": {
        "field": "score"
      }
    }
  }
}

# 桶聚合+度量聚合

# 需求:统计每个酒店品牌的平均得分


GET hotel/_search
{
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "size": 20
      },
      "aggs": {
        "scoreAgg": {
          "stats": {
            "field": "score"
          }
        }
      }
    }
  }

}

# 需求:统计每个酒店品牌的平均得分,根据平均分倒序
# 对评分进行排序 "scoreAgg.avg": "desc"

GET hotel/_search
{
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "size": 20,
        "order": {
          "scoreAgg.avg": "desc"
        }
      },
      "aggs": {
        "scoreAgg": {
          "stats": {
            "field": "score"
          }
        }
      }
    }
  }

}
RestAPI代码
 /**
     * 聚合查询
     */
    @Test
    public void testAgg() throws Exception {
        //创建请求对象
        SearchRequest request = new SearchRequest("hotel"); // hotel:索引库名称

        request.source().size(0);

        request.source().aggregation(AggregationBuilders
                .terms("brandAgg").field("brand").size(20).order(BucketOrder.aggregation("scoreAgg.avg",false))
                .subAggregation(
                        AggregationBuilders.stats("scoreAgg").field("score")
                ));

        //执行条件,获取结果
        SearchResponse response = highLevelClient.search(request, RequestOptions.DEFAULT);

        //获取聚合结果
        Aggregations aggregations = response.getAggregations();
        //***********注意:这里的返回结果要分情况进行设置,如果是bucket的话就使用terms来获取bucket;
        //要根据DSL语句查询的结果,在kibana查看;(建议先DSL查询后写java代码)
        Terms terms = aggregations.get("brandAgg");

        List<? extends Terms.Bucket> buckets = terms.getBuckets();
        for(Terms.Bucket bucket:buckets){
            String brandName = bucket.getKeyAsString();
            //stat聚合:就可以获取min、max、avg等结果
            Stats stats = bucket.getAggregations().get("scoreAgg");

            double sum = stats.getSum();
            double max = stats.getMax();
            double min = stats.getMin();
            double avg = stats.getAvg();

            System.out.println("品牌:"+brandName+",min:"+min+",max:"+max);
        }
    }
05、搜索实战:过滤条件聚合显示
1)需求说明
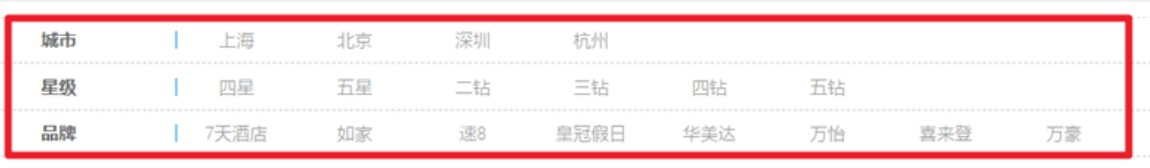
需求:搜索页面的品牌、城市等信息不应该是在页面写死,而是通过聚合索引库中的酒店数据得来的:
思路分析:
目前,页面的城市列表、星级列表、品牌列表都是写死的,并不会随着搜索结果的变化而变化。但是用户搜索条件改变时,搜索结果会跟着变化。
例如:用户搜索“东方明珠”,那搜索的酒店肯定是在上海东方明珠附近,因此,城市只能是上海,此时城市列表中就不应该显示北京、深圳、杭州这些信息了。
也就是说,搜索结果中包含哪些城市,页面就应该列出哪些城市;搜索结果中包含哪些品牌,页面就应该列出哪些品牌。
如何得知搜索结果中包含哪些品牌?如何得知搜索结果中包含哪些城市?
使用聚合功能,利用Bucket聚合,对搜索结果中的文档基于品牌分组、基于城市分组,就能得知包含哪些品牌、哪些城市了。
因为是对搜索结果聚合,因此聚合是限定范围的聚合,也就是说聚合的限定条件跟搜索文档的条件一致。
2)API接口说明
接口路径
POST /hotel/filters
参数说明
JSON格式
| 参数 | 说明 | 是否必须 | 数据类型 | 默认值 |
|---|---|---|---|---|
| key | 搜索关键词 | 是 | String | 无 |
| page | 页码 | 是 | Integer | 无 |
| size | 页面大小 | 是 | Integer | 无 |
| sortBy | 排序字段名称 | 否 | String | 无 |
| brand | 品牌 | 否 | String | 无 |
| city | 城市 | 否 | String | 无 |
| minPrice | 最小价格 | 否 | Integer | 无 |
| maxPrice | 最大价格 | 否 | Integer | 无 |
| starName | 星级 | 否 | String | 无 |
| location | 地理坐标 | 否 | String | 无 |
返回结果
json数据
{
    "brand":[
        "7天酒店",
        "万怡",
        "豪生",
        "如家"
        ......
    ],
    "starName":[
        "二钻",
        "三钻",
        "五星级",
        "四钻"
        ......
    ],
    "city":[
        "上海",
        "深圳",
        "深圳",
        "北京"
        ......
    ]
}
3)DSL语句
# 需求:酒店聚合搜索

GET hotel/_search
{
  "query": {
    "bool": {
      "must": [
        {
          "match": {
            "all": "7天"
          }
        }
      ]
    }
  },
  "size": 0,
  "aggs": {
    "cityAgg": {
      "terms": {
        "field": "city",
        "size": 100
      }
    },
    "starNameAgg":{
      "terms": {
        "field": "starName",
        "size": 100
      }
    },
    "brandAgg":{
      "terms": {
        "field": "brand",
        "size": 100
      }
    }
  }
}
4)Controller
在HotelController添加filters方法
    /**
     * 查询过滤条件列表
     */
    @PostMapping("/filters")
    public Map<String, List<String>> filters(@RequestBody RequestParams params){
        return hotelService.filters(params);
    }
5)Service
@Override
    public Map<String, List<String>> filters(RequestParams params) {
        try {
            SearchRequest request = new SearchRequest("hotel");

            BoolQueryBuilder boolQueryBuilder = buildBasicQuery(params);

            //query条件
            request.source().query(boolQueryBuilder);

            //size
            request.source().size(0);

            //聚合条件
            request.source().aggregation(AggregationBuilders.terms("brandAgg").field("brand").size(20));
            request.source().aggregation(AggregationBuilders.terms("cityAgg").field("city").size(20));
            request.source().aggregation(AggregationBuilders.terms("starNameAgg").field("starName").size(20));

            //执行聚合查询
            SearchResponse response = highLevelClient.search(request, RequestOptions.DEFAULT);

            //获取聚合结果并封装
            Aggregations aggregations = response.getAggregations();

            List<String> brandAggList = getAggregationByName(aggregations, "brandAgg");
            List<String> cityAggList = getAggregationByName(aggregations, "cityAgg");
            List<String> starNameAggList = getAggregationByName(aggregations, "starNameAgg");

            Map<String,List<String>> resultMap = new LinkedHashMap<>();
            resultMap.put("brand",brandAggList);
            resultMap.put("city",cityAggList);
            resultMap.put("starName",starNameAggList);
            return resultMap;
        } catch (IOException e) {
            e.printStackTrace();
            throw new RuntimeException(e);
        }
    }

    private List<String> getAggregationByName(Aggregations aggregations,String aggName) {
        List<String> list = new ArrayList<>();
        Terms terms = aggregations.get(aggName);
        List<? extends Terms.Bucket> buckets = terms.getBuckets();
        for(Terms.Bucket bucket:buckets){
            String key = bucket.getKeyAsString();
            list.add(key);
        }
        return list;
    }
这里把之前search方法的Query条件抽取成buildBasicQuery方法
private BoolQueryBuilder buildBasicQuery(RequestParams params) {
        //搜索条件
        BoolQueryBuilder boolQueryBuilder = QueryBuilders.boolQuery();
        if(StringUtils.isNotEmpty(params.getKey())){
            boolQueryBuilder.must(QueryBuilders.matchQuery("all",params.getKey()));
        }else{
            boolQueryBuilder.must(QueryBuilders.matchAllQuery());
        }
        //添加过滤条件
        //品牌
        if(StringUtils.isNotEmpty(params.getBrand())){
            boolQueryBuilder.filter(QueryBuilders.termQuery("brand",params.getBrand()));
        }
        //城市
        if(StringUtils.isNotEmpty(params.getCity())){
            boolQueryBuilder.filter(QueryBuilders.termQuery("city",params.getCity()));
        }
        //星级
        if(StringUtils.isNotEmpty(params.getStarName())){
            boolQueryBuilder.filter(QueryBuilders.termQuery("starName",params.getStarName()));
        }
        //价格
        if(params.getMinPrice()!=null && params.getMaxPrice()!=null){
            boolQueryBuilder.filter(QueryBuilders.rangeQuery("price").gte(params.getMinPrice()).lte(params.getMaxPrice()));
        }
        return boolQueryBuilder;
    }
06、Elasticsearch拼音搜索:拼音分词器
要实现拼音分词检索,就必须对文档按照拼音分词。在GitHub上恰好有elasticsearch的拼音分词插件。地址:https://github.com/medcl/elasticsearch-analysis-pinyin
使用了最新版的ES就应该尽量使用最新版的插件;
课前资料中也提供了拼音分词器的安装包:
安装方式与IK分词器一样,分三步:
①解压

②上传到虚拟机中,elasticsearch的plugin目录

③重启elasticsearch

④测试
详细安装步骤可以参考IK分词器的安装过程。
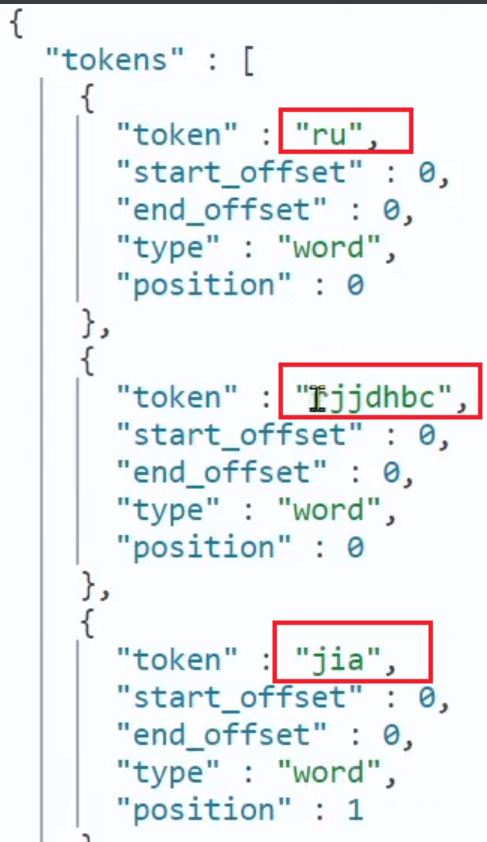
测试用法如下:
POST /_analyze
{
  "text": "如家酒店还不错",
  "analyzer": "pinyin"
}
结果:
07、Elasticsearch拼音搜索:自定义分词器
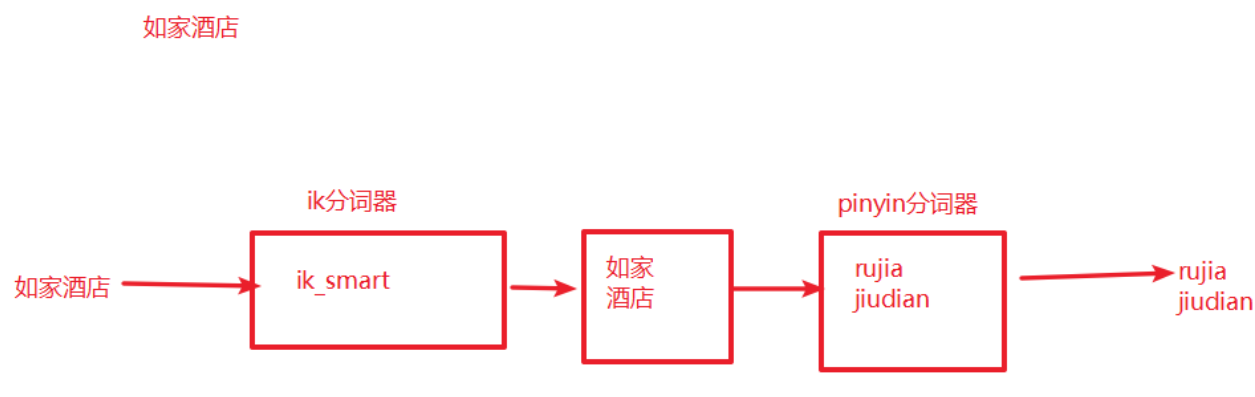
默认的拼音分词器会将每个汉字单独分为拼音,而我们希望的是每个词条形成一组拼音,需要对拼音分词器做个性化定制,形成自定义分词器。
elasticsearch中分词器(analyzer)的组成包含三部分:
- character filters:在tokenizer之前对文本进行处理。例如删除字符、替换字符
- tokenizer:将文本按照一定的规则切割成词条(term)。例如keyword,就是不分词;还有ik_smart
- tokenizer filter:将tokenizer输出的词条做进一步处理。例如大小写转换、同义词处理、拼音处理等
文档分词时会依次由这三部分来处理文档:
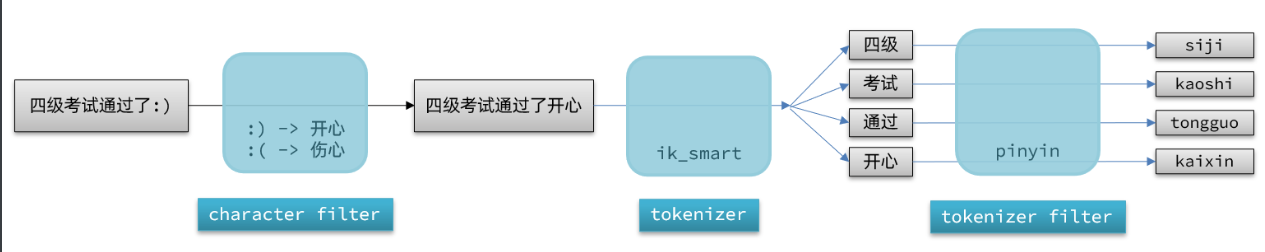
声明自定义分词器的语法如下:
PUT /test
{
  "settings": {
    "analysis": {
      "analyzer": { // 自定义分词器
        "my_analyzer": {  // 分词器名称
          "tokenizer": "ik_max_word",
          "filter": "py"
        }
      },
      "filter": { // 自定义tokenizer filter
        "py": { // 过滤器名称
          "type": "pinyin", // 过滤器类型,这里是pinyin
          "keep_full_pinyin": false,
          "keep_joined_full_pinyin": true,
          "keep_original": true,
          "limit_first_letter_length": 16,
          "remove_duplicated_term": true,
          "none_chinese_pinyin_tokenize": false
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "name": {
        "type": "text",
        "analyzer": "my_analyzer",
        "search_analyzer": "ik_max_word"
      }
    }
  }
}
测试:
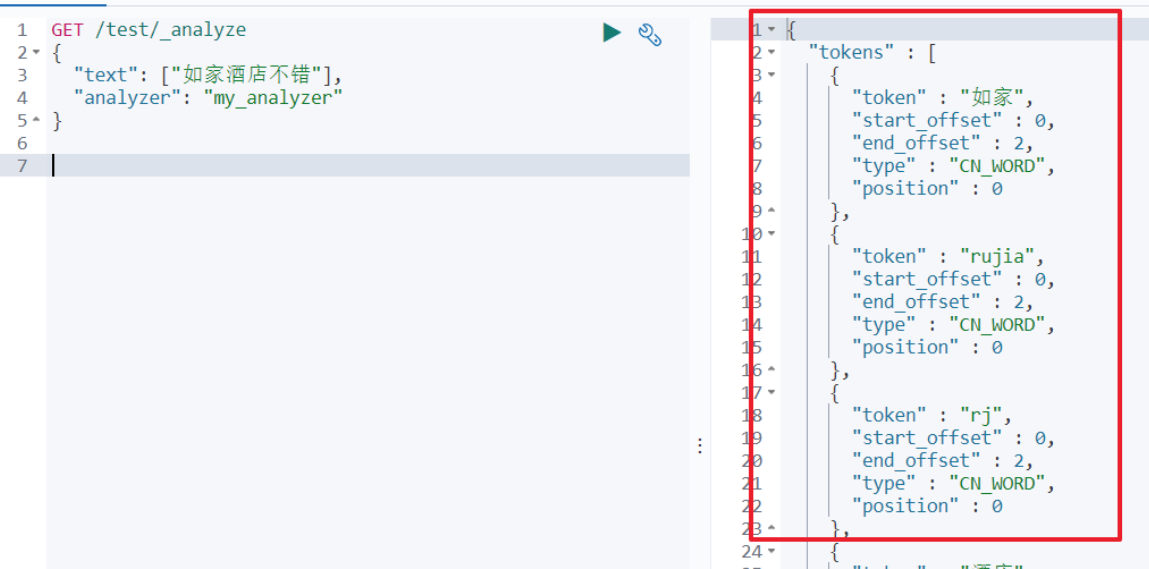
08、搜索实战:实现酒店拼音搜索
只需要3步即可实现酒店拼音搜索
1)删除酒店索引库
DELETE hotel
2)重新构建酒店索引库
PUT /hotel
{
  "settings": {
    "analysis": {
      "analyzer": {
        "text_anlyzer": {
          "tokenizer": "ik_max_word",
          "filter": "py"
        }
      },
      "filter": {
        "py": {
          "type": "pinyin",
          "keep_full_pinyin": false,
          "keep_joined_full_pinyin": true,
          "keep_original": true,
          "limit_first_letter_length": 16,
          "remove_duplicated_term": true,
          "none_chinese_pinyin_tokenize": false
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "id":{
        "type": "keyword"
      },
      "name":{
        "type": "text",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_max_word",
        "copy_to": "all"
      },
      "address":{
        "type": "keyword",
        "index": false
      },
      "price":{
        "type": "integer"
      },
      "score":{
        "type": "integer"
      },
      "brand":{
        "type": "keyword",
        "copy_to": "all"
      },
      "city":{
        "type": "keyword"
      },
      "starName":{
        "type": "keyword"
      },
      "business":{
        "type": "keyword",
        "copy_to": "all"
      },
      "location":{
        "type": "geo_point"
      },
      "pic":{
        "type": "keyword",
        "index": false
      },
      "all":{
        "type": "text",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_max_word"
      }
    }
  }
}
3)执行之前的批量导入酒店数据
完成后,就可以使用拼音搜索酒店啦!
09、Elasticsearch自动补全:自动补全功能
Elasticsearch提供了Completion Suggester查询来实现自动补全功能。这个查询会匹配以用户输入内容开头的词条并返回。为了提高补全查询的效率,对于文档中字段的类型有一些约束:
- 参与补全查询的字段必须是completion类型。
- 字段的内容一般是用来补全的多个词条形成的数组。[“如家酒店”,”如家宾馆”]
比如,一个这样的索引库:
PUT test
{
  "mappings": {
    "properties": {
      "title":{
        "type": "completion",
      }
    }
  }
}
然后插入下面的数据:
#  示例数据
POST test/_doc
{
  "title": ["Sony","WH-1000XM3"]
}

POST test/_doc
{
  "title":["SK-II","PITERA"]
}

POST test/_doc
{
 "title":["Nintendo","switch"]
}
查询的DSL语句如下:
“suggest”
// 自动补全查询
GET /test/_search
{
 "suggest":{
  "title_suggest":{
    "text":"s",
    "completion":{
      "field":"title",
      "skip_duplicates":true,
      "size":10
     }
  }
}
10、▲ 搜索实战:搜索关键词自动补全
需求:输入框搜索关键词时自动补全内容(品牌和商圈信息)
1)重构酒店索引库
PUT /hotel
{
  "settings": {
    "analysis": {
      "analyzer": {
        "text_anlyzer": {
          "tokenizer": "ik_max_word",
          "filter": "py"
        }
      },
      "filter": {
        "py": {
          "type": "pinyin",
          "keep_full_pinyin": false,
          "keep_joined_full_pinyin": true,
          "keep_original": true,
          "limit_first_letter_length": 16,
          "remove_duplicated_term": true,
          "none_chinese_pinyin_tokenize": false
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "id":{
        "type": "keyword"
      },
      "name":{
        "type": "text",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_max_word",
        "copy_to": "all"
      },
      "address":{
        "type": "keyword",
        "index": false
      },
      "price":{
        "type": "integer"
      },
      "score":{
        "type": "integer"
      },
      "brand":{
        "type": "keyword",
        "copy_to": "all"
      },
      "city":{
        "type": "keyword"
      },
      "starName":{
        "type": "keyword"
      },
      "business":{
        "type": "keyword",
        "copy_to": "all"
      },
      "location":{
        "type": "geo_point"
      },
      "pic":{
        "type": "keyword",
        "index": false
      },
      "all":{
        "type": "text",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_max_word"
      },
      "suggestion":{
        "type": "completion",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_max_word"
      }
    }
  }
}
2)修改HotelDoc
需要在之前的HotelDoc添加suggestion属性,类型为List , 内容存储品牌和商圈的数值
package cn.itcast.hotel.pojo;

import lombok.Data;
import lombok.NoArgsConstructor;

import java.util.ArrayList;
import java.util.Collections;
import java.util.List;

@Data
@NoArgsConstructor
public class HotelDoc {

    private Long id;

    private String name;

    private String address;

    private Integer price;

    private Integer score;

    private String brand;

    private String city;

    private String starName;

    private String business;

    private String pic;

    private String all;

    private String location;

    private Boolean isAD;

    //显示坐标距离值
    private Object distance;

    //用于自动补全的字段
    private List<String> suggestion;

    public HotelDoc(Hotel hotel) {
        this.id = hotel.getId();
        this.name = hotel.getName();
        this.address = hotel.getAddress();
        this.price = hotel.getPrice();
        this.score = hotel.getScore();
        this.brand = hotel.getBrand();
        this.city = hotel.getCity();
        this.starName = hotel.getStarName();
        this.business = hotel.getBusiness();
        this.pic = hotel.getPic();
        this.isAD = hotel.getIsAD();
        this.location = hotel.getLatitude() + ", " + hotel.getLongitude();
        this.all = hotel.getName()+hotel.getAddress()+hotel.getBusiness();

        //填充suggestion(品牌,商圈)
        this.suggestion = new ArrayList<>();
        if(hotel.getBusiness().contains("/")){
            String[] arr = hotel.getBusiness().split("/");
            this.suggestion.add(hotel.getBrand());
            Collections.addAll( this.suggestion, arr);
        }else if(hotel.getBusiness().contains("、")){
            String[] arr = hotel.getBusiness().split("、");
            this.suggestion.add(hotel.getBrand());
            Collections.addAll( this.suggestion, arr);
        }else{
            Collections.addAll( this.suggestion, hotel.getBusiness(),hotel.getBrand());
        }

    }
}
3)重新导入数据
重新执行之前编写的导入数据功能,可以看到新的酒店数据中包含了suggestion:
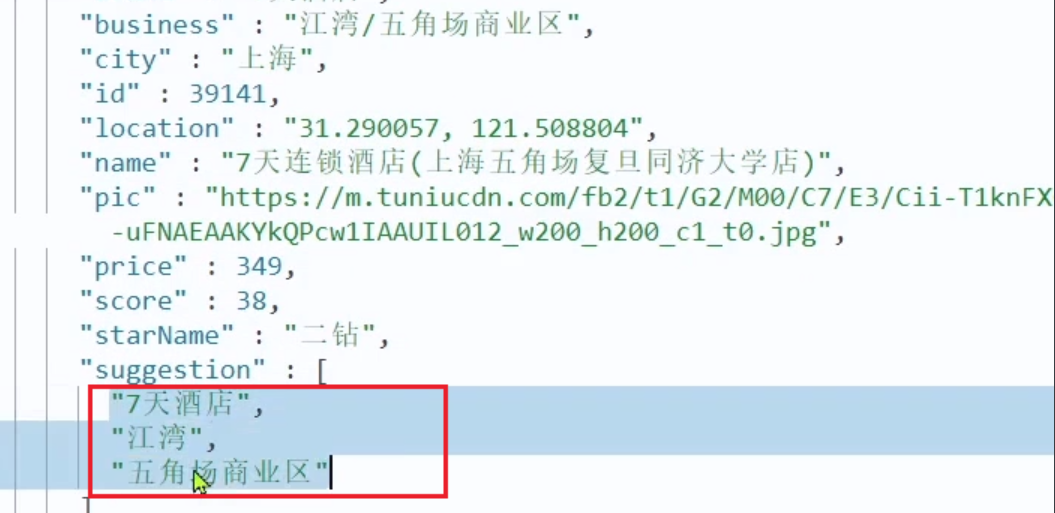
4)DSL语句
GET /hotel/_search
{
  "size": 0,
  "suggest": {
    "suggestions": {
      "text": "sz",
      "completion":{
        "field":"suggestion",
        "skip_duplicates":true,
        "size":10
      }
    }
  }
}
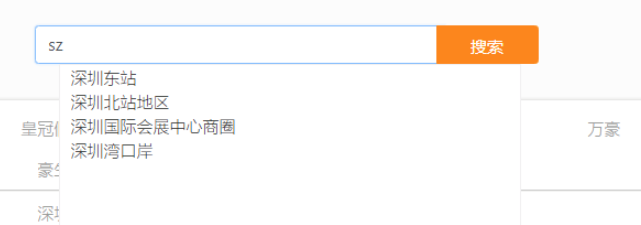
结果显示:
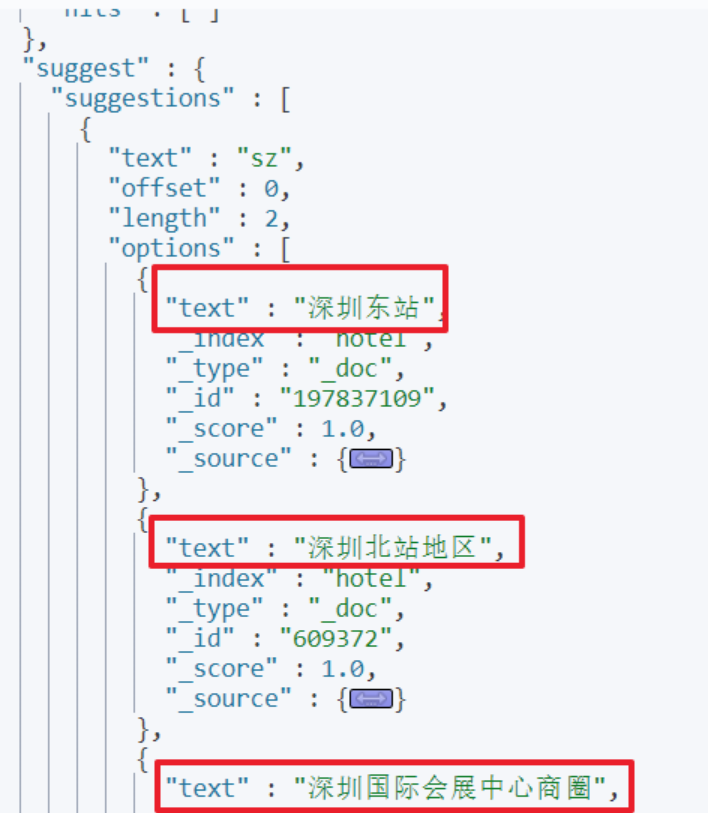
5)API接口说明
接口路径
GET /hotel/suggestion?key=xxx
参数说明
form表单参数
| 参数 | 说明 | 是否必须 | 数据类型 | 默认值 |
|---|---|---|---|---|
| key | 搜索关键词 | 是 | String | 无 |
返回结果
json数据
[
    "深圳东站",
    "深圳北站地区",
    "深圳国际会展中心商圈",
    ......
]
6)Controller
  /**
     * 搜索时自动补全
     */
    @GetMapping("/suggestion")
    public List<String> suggestion(@RequestParam String key){
        return hotelService.suggestion(key);
    }
7)Service
 @Override
    public List<String> suggestion(String key) {
        try {
            SearchRequest request = new SearchRequest("hotel");

            request.source().size(0);

            //添加自动补全条件
            request.source().suggest(new SuggestBuilder().addSuggestion("hotelSuggestion",
                    SuggestBuilders.completionSuggestion("suggestion")
                                    .prefix(key)
                                    .size(10)
                                    .skipDuplicates(true)));

            SearchResponse response = highLevelClient.search(request, RequestOptions.DEFAULT);

            //取出补全结果
            List<String> resultList = new ArrayList<>();
            CompletionSuggestion hotelSuggestion = response.getSuggest().getSuggestion("hotelSuggestion");
            List<CompletionSuggestion.Entry.Option> options = hotelSuggestion.getOptions();
            for(CompletionSuggestion.Entry.Option option:options){
                resultList.add(option.getText().string());
            }

            return resultList;
        } catch (IOException e) {
            e.printStackTrace();
            throw new RuntimeException(e);
        }
    }
效果如下:
11、△ * 数据同步:同步方案分析
常见的数据同步方案有三种:
- 同步调用
- 异步通知
- 监听binlog
1)同步调用
方案一:同步调用
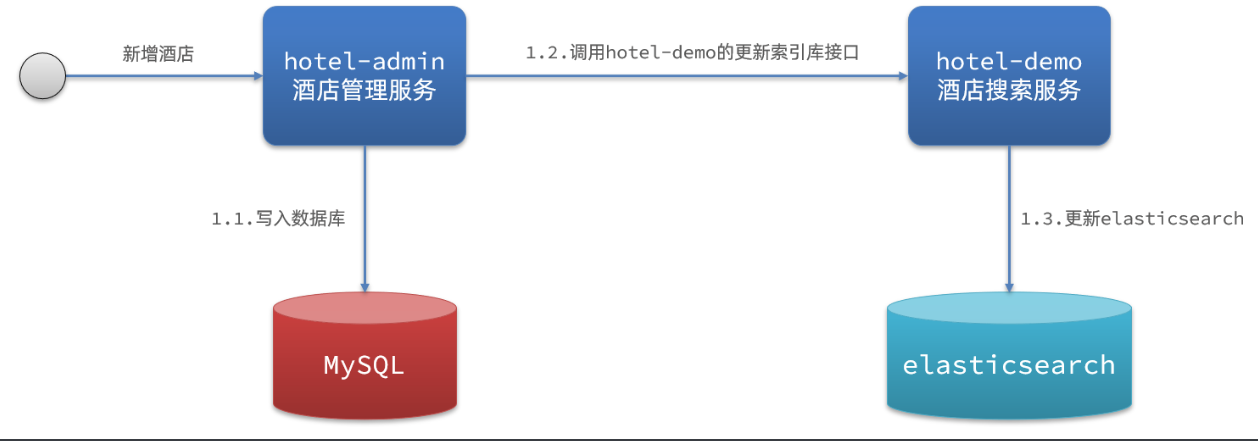
基本步骤如下:
- hotel-demo对外提供接口,用来修改elasticsearch中的数据
- 酒店管理服务在完成数据库操作后,直接调用hotel-demo提供的接口,
2)异步通知
方案二:异步通知
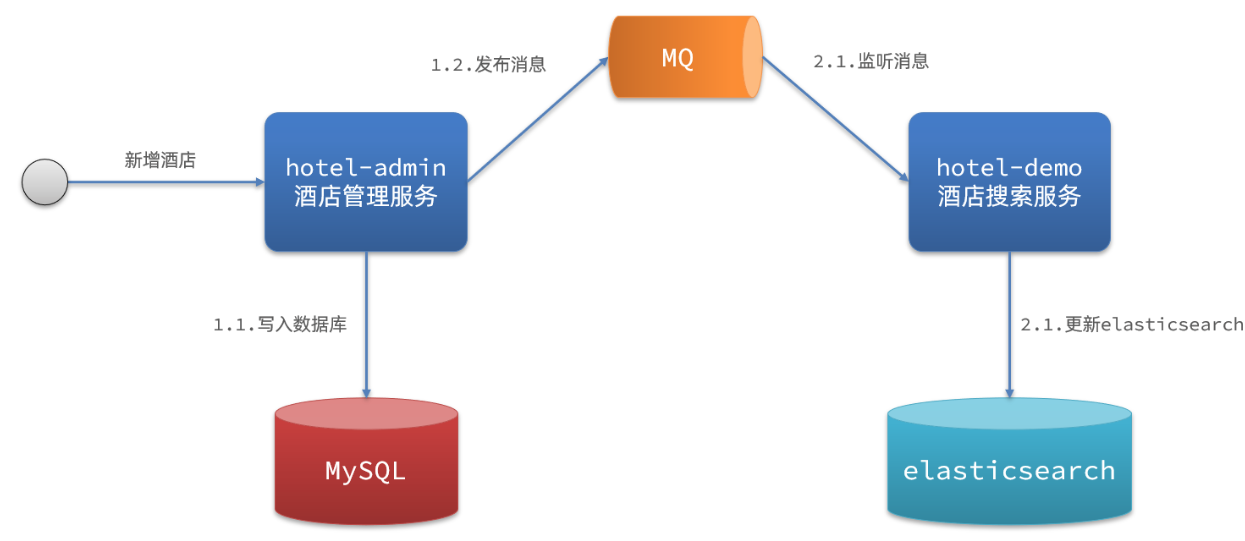
流程如下:
- hotel-admin对mysql数据库数据完成增、删、改后,发送MQ消息
- hotel-demo监听MQ,接收到消息后完成elasticsearch数据修改
3)Canal监听binlog
方案三:监听binlog
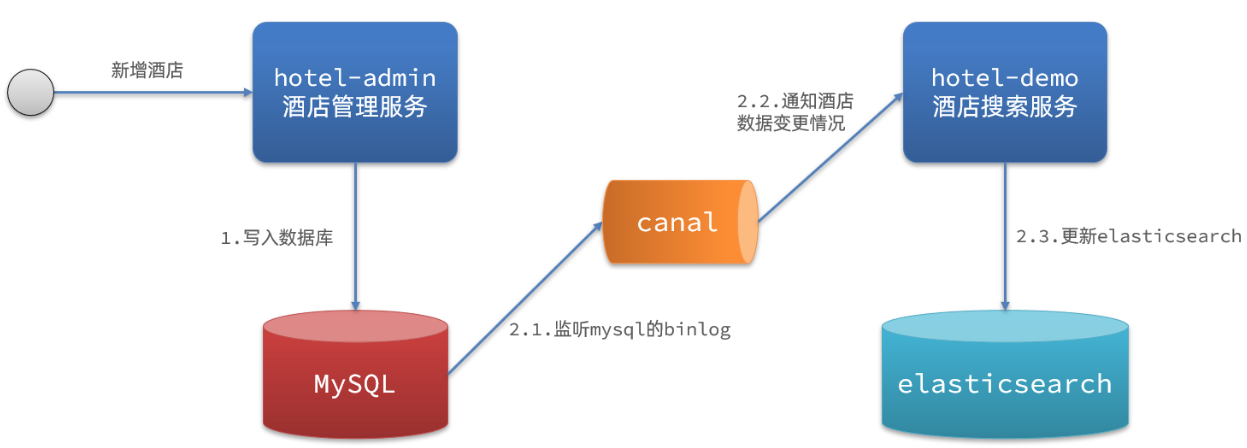
流程如下:
- 给mysql开启binlog功能
- mysql完成增、删、改操作都会记录在binlog中
- hotel-demo基于canal监听binlog变化,实时更新elasticsearch中的内容
4)优缺点分析
方式一:同步调用
- 优点:实现简单,粗暴
- 缺点:业务耦合度高
方式二:异步通知
- 优点:低耦合,实现难度一般
- 缺点:依赖mq的可靠性
方式三:监听binlog
- 优点:完全解除服务间耦合
- 缺点:开启binlog增加数据库负担、实现复杂度高,还有就是只能在MySQL中使用;
12、数据同步:导入酒店管理后台项目
1)安装RabbitMQ
- 拉取rabbitmq镜像
docker pull rabbitmq:management
创建并运行容器
docker run -di --name=myrabbit -e RABBITMQ_DEFAULT_USER=admin -e RABBITMQ_DEFAULT_PASS=admin -p 15672:15672 -p 5672:5672 -p 25672:25672 -p 61613:61613 -p 1883:1883 rabbitmq:management
15672: http端口,UI界面访问端口
5672:tcp端口,用于各类语言API整合端口其它容器命令
docker start myrabbit 启动
docker stop myrabbit 暂停
docker restart myrabbit 重启
docker logs -f myrabbit 查看启动日志
- 访问RabbitMQ管理控制台: http://192.168.66.133:15672
默认账户:root/root
2)导入项目
导入课前资料提供的hotel-admin项目:
运行后,访问 http://localhost:8099
其中包含了酒店的CRUD功能:

13、数据同步:创建交换机和队列
MQ结构如图:
FANOUT: 没有routingKey
DIRECT: 有固定的routingKey
TOPIC:有通配规则的routingKey
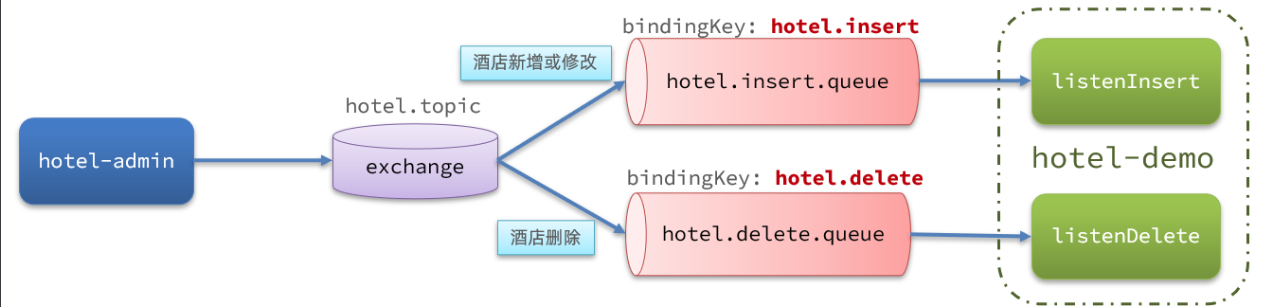
1)引入依赖和配置
在hotel-admin、hotel-demo中引入rabbitmq的依赖:
<!--amqp-->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-amqp</artifactId>
</dependency>
在hotel-admin、hotel-demo中application.yml添加RabbitMQ配置
spring:
  rabbitmq:
    host: 192.168.66.133
    port: 5672
    virtual-host: /
    username: admin
    password: admin
2)声明队列交换机名称
在hotel-admin和hotel-demo中的cn.itcast.hotel.constatnts包下新建一个类MqConstants:
package cn.itcast.hotel.constants;

public class MQConstants {
    /**
     * 交换机
     */
    public final static String HOTEL_EXCHANGE = "hotel.topic";
    /**
     * 监听新增和修改的队列
     */
    public final static String HOTEL_INSERT_QUEUE = "hotel.insert.queue";
    /**
     * 监听删除的队列
     */
    public final static String HOTEL_DELETE_QUEUE = "hotel.delete.queue";
    /**
     * 新增或修改的RoutingKey
     */
    public final static String HOTEL_INSERT_KEY = "hotel.insert";
    /**
     * 删除的RoutingKey
     */
    public final static String HOTEL_DELETE_KEY = "hotel.delete";
}
3)声明队列交换机
在hotel-demo中,定义配置类,声明队列、交换机:
package cn.itcast.hotel.config;

import cn.itcast.hotel.constants.MQConstants;
import org.elasticsearch.index.query.QueryBuilders;
import org.springframework.amqp.core.*;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

/**
 * 声明交换机和队列
 */
@Configuration
public class RabbitConfig {

    /**
     * 创建交换机
     */
    @Bean
    public TopicExchange createExchnage(){
        return new TopicExchange(MQConstants.HOTEL_EXCHANGE,true,false);
    }

    /**
     * 创建insert、update队列
     */
    @Bean
    public Queue createInsertQueue(){
        return QueueBuilder.durable(MQConstants.HOTEL_INSERT_QUEUE).build();
    }


    /**
     * 创建delete队列
     */
    @Bean
    public Queue createDeleteQueue(){
        return QueueBuilder.durable(MQConstants.HOTEL_DELETE_QUEUE).build();
    }

    /**
     * insert、update队列绑定交换机
     */
    @Bean
    public Binding bindInsertQueue(){
        /**
         * bind: 指定绑定队列
         * to:绑定到哪个交换机
         * with: 指定绑定routingKey
         */
        return BindingBuilder.bind(createInsertQueue()).to(createExchnage()).with(MQConstants.HOTEL_INSERT_KEY);
    }

    /**
     * delete队列绑定交换机
     */
    @Bean
    public Binding bindDeleteQueue(){
        /**
         * bind: 指定绑定队列
         * to:绑定到哪个交换机
         * with: 指定绑定routingKey
         */
        return BindingBuilder.bind(createDeleteQueue()).to(createExchnage()).with(MQConstants.HOTEL_DELETE_KEY);
    }
}
14、数据同步:生产者发送MQ消息
在hotel-admin中的增、删、改业务中分别发送MQ消息:
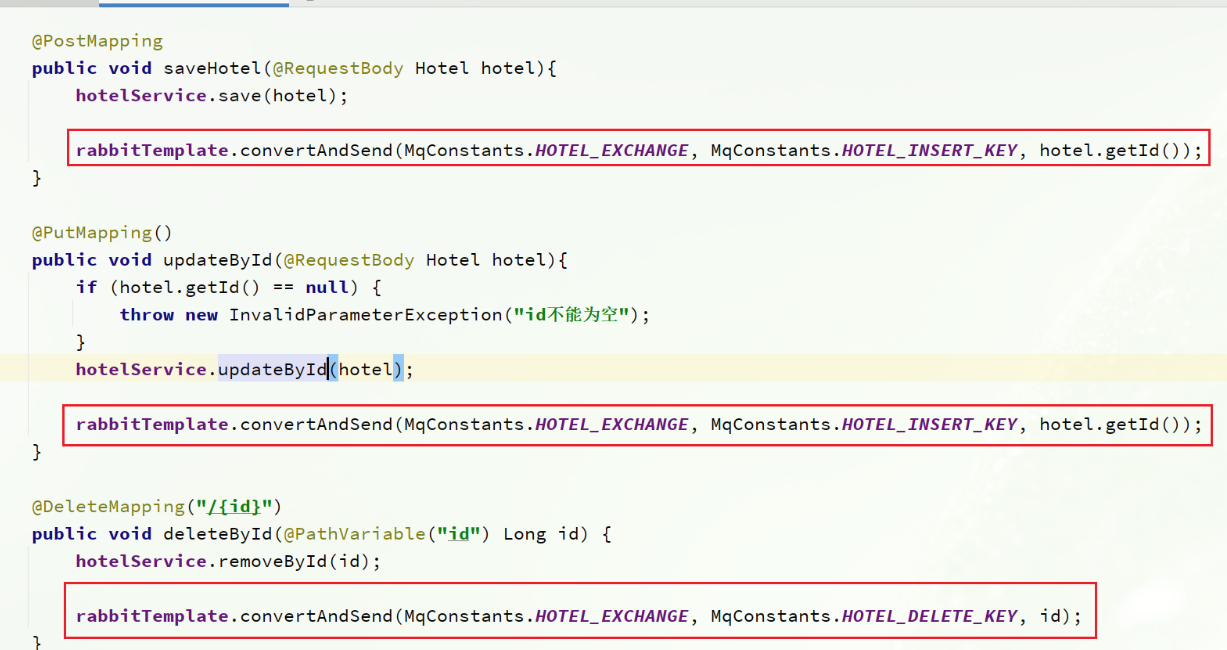
    @PostMapping
    public void saveHotel(@RequestBody Hotel hotel){
        hotelService.save(hotel);

        rabbitTemplate.convertAndSend(MQConstants.HOTEL_EXCHANGE,MQConstants.HOTEL_INSERT_QUEUE,hotel.getId());
    }

    @PutMapping()
    public void updateById(@RequestBody Hotel hotel){
        if (hotel.getId() == null) {
            throw new InvalidParameterException("id不能为空");
        }
        hotelService.updateById(hotel);

        rabbitTemplate.convertAndSend(MQConstants.HOTEL_EXCHANGE,MQConstants.HOTEL_INSERT_KEY,hotel.getId());
    }

    @DeleteMapping("/{id}")
    public void deleteById(@PathVariable("id") Long id) {
        hotelService.removeById(id);

        rabbitTemplate.convertAndSend(MQConstants.HOTEL_EXCHANGE,MQConstants.HOTEL_DELETE_KEY,id);
    }
15、数据同步:消费者监听MQ消息更新索引
hotel-demo接收到MQ消息要做的事情包括:
- 新增消息:根据传递的hotel的id查询hotel信息,然后新增一条数据到索引库
- 删除消息:根据传递的hotel的id删除索引库中的一条数据
1)首先在hotel-demo的cn.itcast.hotel.service包下的IHotelService中新增新增、删除业务
void deleteById(Long id);

void insertById(Long id);
2)给hotel-demo中的cn.itcast.hotel.service.impl包下的HotelService中实现业务:
    @Override
    public void insertById(Long id) {
        try {
            Hotel hotel = getById(id);
            HotelDoc hotelDoc = new HotelDoc(hotel);
            String json = mapper.writeValueAsString(hotelDoc);

            IndexRequest request = new IndexRequest("hotel").id(hotelDoc.getId().toString());
            request.source(json, XContentType.JSON);
            highLevelClient.index(request,RequestOptions.DEFAULT);
        } catch (Exception e) {
            e.printStackTrace();
            throw new RuntimeException(e);
        }
    }

    @Override
    public void deleteById(Long id) {
        try {
            DeleteRequest request = new DeleteRequest("hotel").id(id.toString());
            highLevelClient.delete(request,RequestOptions.DEFAULT);
        } catch (Exception e) {
            e.printStackTrace();
            throw new RuntimeException(e);
        }
    }
3)编写监听器
在hotel-demo中的cn.itcast.hotel.listener包新增一个类:
package cn.itcast.hotel.listener;

import cn.itcast.hotel.constants.MQConstants;
import cn.itcast.hotel.pojo.Hotel;
import cn.itcast.hotel.pojo.HotelDoc;
import cn.itcast.hotel.service.IHotelService;
import com.fasterxml.jackson.core.JsonProcessingException;
import com.fasterxml.jackson.databind.ObjectMapper;
import lombok.extern.slf4j.Slf4j;
import org.elasticsearch.action.delete.DeleteRequest;
import org.elasticsearch.action.delete.DeleteResponse;
import org.elasticsearch.action.index.IndexRequest;
import org.elasticsearch.action.index.IndexResponse;
import org.elasticsearch.client.RequestOptions;
import org.elasticsearch.client.RestHighLevelClient;
import org.elasticsearch.common.xcontent.XContentType;
import org.springframework.amqp.rabbit.annotation.RabbitListener;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.stereotype.Component;

/**
 * MQ消息监听
 */
@Component
@Slf4j
public class HotelListener {
    @Autowired
    private IHotelService hotelService;

    private ObjectMapper mapper = new ObjectMapper();

    @Autowired
    private RestHighLevelClient highLevelClient;

    /**
     * 处理insert/update消息
     */
    @RabbitListener(queues = MQConstants.HOTEL_INSERT_QUEUE)
    public void handlerInsertMsg(Long id){
        try {
            //更新文档
            Hotel hotel = hotelService.getById(id);

            //2.把Hotel转换为HotelDoc
            HotelDoc hotelDoc = new HotelDoc(hotel);

            //3.转换成json字符串
            String hotelJson = mapper.writeValueAsString(hotelDoc);

            //4.创建操作请求
            IndexRequest request = new IndexRequest("hotel").id(hotelDoc.getId().toString()).source(hotelJson, XContentType.JSON);

            //5.执行请求
            IndexResponse response = highLevelClient.index(request, RequestOptions.DEFAULT);

            log.info("索引导入成功,id:{}",hotel.getId());
        } catch (Exception e) {
            e.printStackTrace();
            throw new RuntimeException(e);
        }
    }

    /**
     * 处理delete消息
     */
    @RabbitListener(queues = MQConstants.HOTEL_DELETE_QUEUE)
    public void handlerDeleteMsg(Long id){
        try {
            DeleteRequest request = new DeleteRequest("hotel").id(id.toString());

            //2.执行请求
            DeleteResponse response = highLevelClient.delete(request, RequestOptions.DEFAULT);

            log.info("索引移除成功,id:{}",id);
        } catch (Exception e) {
            e.printStackTrace();
            throw new RuntimeException(e);
        }
    }
}
16、Elasticsearch集群:集群及相关概念
目标:理解什么是集群、分布式
- 集群:多个人做一样的事。
- 分布式:多个人做不一样的事。
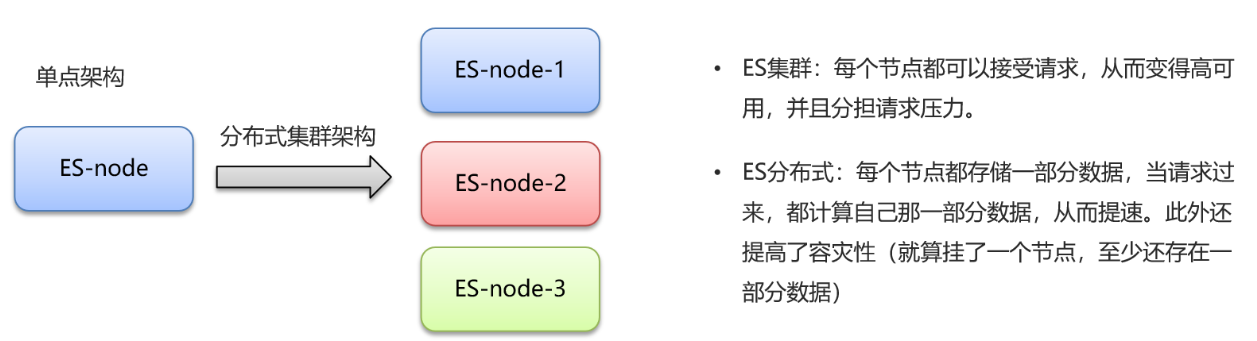
说明:在一个系统中,往往分布式和集群是并存的。
- 节点(node) :集群中的一个 Elasticearch 服务实例。在Elasticsearch中,节点的类型主要分为如下三种:
- master eligible节点:有资格参加选举成为Master的节点,默认为true(可以通过node.master: false设置)。
- data节点:保存数据的节点,默认为true(可以通过node.data: false设置)。
- Coordinating 节点:客户端节点。负责接收客户端请求,将请求发送到合适的节点,最终把结果汇集到一起返回,默认为true。
- 集群(cluster):一组拥有相同集群名称的节点,集群名称默认是elasticsearch。
- 索引(index) :es存储数据的地方,相当于关系数据库中的database。
- 分片(shard):索引库可以被拆分为不同的部分进行存储,称为分片。在集群环境下,一个索引库的不同分片可以拆分到放到不同的节点中,分片的好处有如下两点。
- 提高查询性能(多个节点并行查询)
- 提高数据安全性(鸡蛋不要放在一个篮子里)
- 主分片(Primary shard):相对于副本分片的定义。
- 副本分片(Replica shard):即对主分片数据的备份,每个主分片可以有一个或者多个副本,数据和主分片一样,副本的好处有如下两点:
- 数据备份,防止数据丢失
- 一定程度提高查询的并发能力(同一份完整的索引库的数据,分成了两份,都可以查询)
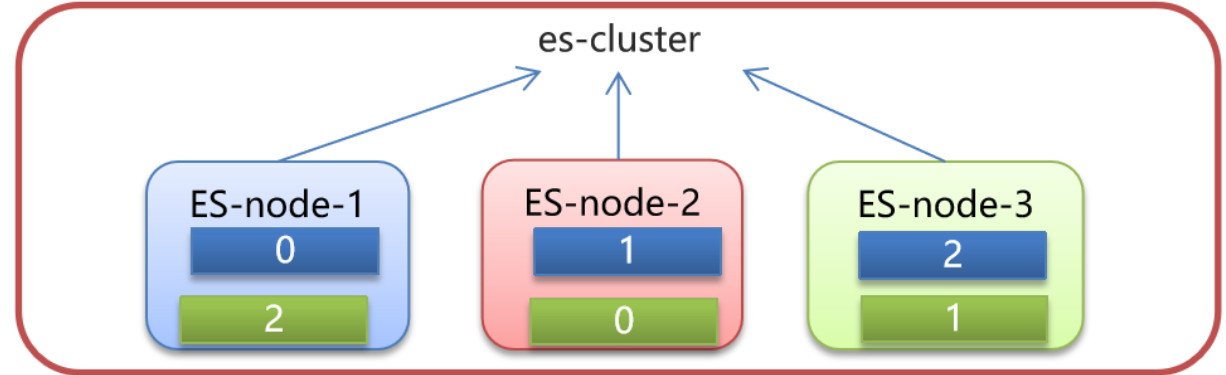
说明:主分片和副本分片永远不会分配在同一个节点上
17、Elasticsearch集群:搭建集群环境
为了方便搭建ES集群,我们采用docker-compose方式
1)创建相应目录(已完成)
在/root/es-cluster目录下创建以下目录
mkdir -p es01/data
mkdir -p es01/logs

mkdir -p es02/data
mkdir -p es02/logs

mkdir -p es03/data
mkdir -p es03/logs

mkdir -p kibana_config
2)创建配置文件(已完成)
创建docker-compose.yml
version: '3'
services:
  es01:
    image: elasticsearch:7.4.0
    container_name: es01
    environment:
      - node.name=es01
      - cluster.name=es-docker-cluster
      - discovery.seed_hosts=es02,es03
      - cluster.initial_master_nodes=es01,es02,es03
      - bootstrap.memory_lock=true
      - "ES_JAVA_OPTS=-Xms512m -Xmx512m"
    ulimits:
      memlock:
        soft: -1
        hard: -1
    volumes:
      - ./es01/data:/usr/share/elasticsearch/data
      - ./es01/logs:/usr/share/elasticsearch/logs
      - ./elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
    ports:
      - 9201:9200
    networks:
      - elastic

  es02:
    image: elasticsearch:7.4.0
    container_name: es02
    environment:
      - node.name=es02
      - cluster.name=es-docker-cluster
      - discovery.seed_hosts=es01,es03
      - cluster.initial_master_nodes=es01,es02,es03
      - bootstrap.memory_lock=true
      - "ES_JAVA_OPTS=-Xms512m -Xmx512m"
    ulimits:
      memlock:
        soft: -1
        hard: -1
    volumes:
      - ./es02/data:/usr/share/elasticsearch/data
      - ./es02/logs:/usr/share/elasticsearch/logs
      - ./elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
    ports:
      - 9202:9200
    networks:
      - elastic

  es03:
    image: elasticsearch:7.4.0
    container_name: es03
    environment:
      - node.name=es03
      - cluster.name=es-docker-cluster
      - discovery.seed_hosts=es01,es02
      - cluster.initial_master_nodes=es01,es02,es03
      - bootstrap.memory_lock=true
      - "ES_JAVA_OPTS=-Xms512m -Xmx512m"
    ulimits:
      memlock:
        soft: -1
        hard: -1
    volumes:
      - ./es03/data:/usr/share/elasticsearch/data
      - ./es03/logs:/usr/share/elasticsearch/logs
      - ./elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
    ports:
      - 9203:9200
    networks:
      - elastic

  kibana01:
    image: kibana:7.4.0
    container_name: kibana01
    links:
      - es01
      - es02
      - es03
    ports:
      - 5602:5601
    volumes:
      - ./kibana_config/:/usr/local/kibana/config/
    environment:
      ELASTICSEARCH_HOSTS: http://es01:9200
    networks:
      - elastic

networks:
  elastic:
    driver: bridge
创建elasticsearch.yml文件
network.host: 0.0.0.0

http.cors.enabled: true
http.cors.allow-origin: "*"
3)修改目录文件权限(已完成)
sudo chown -R 1000:1000 /root/es-cluster/
4)运行docker-compose命令
进入/root/es-cluster目录下,执行以下名称
docker-compose up -d
如果需要停止则输入
docker-compose down
5)安装cerebro监控ES集群
docker search cerebro

docker pull yannart/cerebro

docker run -d --name cerebro -p 9000:9000 yannart/cerebro
访问:http://192.168.66.133:9000/
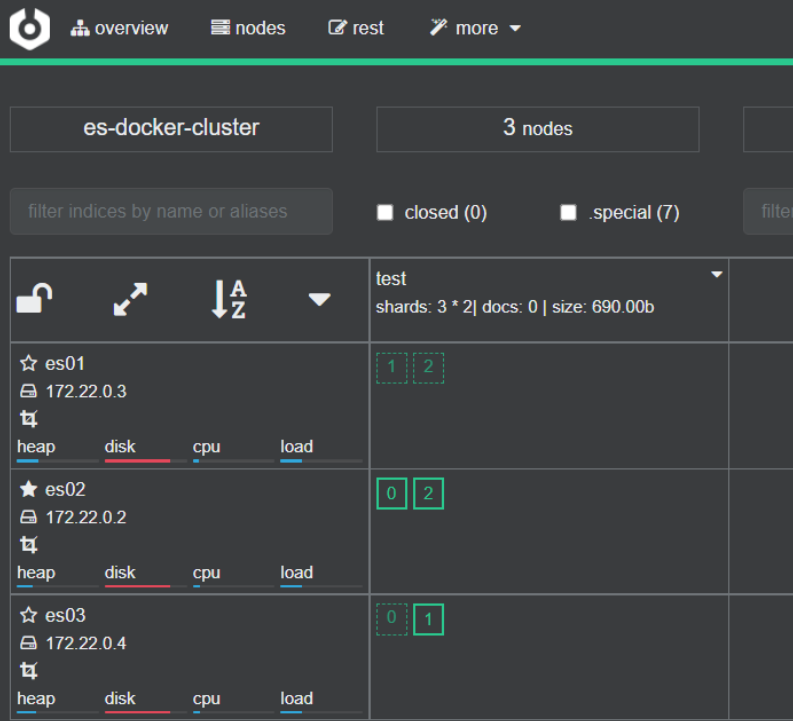
6)创建索引库
创建一个test索引库,指定分片数为3,副本数为1
PUT test
{
  "settings": {
    "number_of_shards": 3
    , "number_of_replicas": 1
  }
}
18、* Elasticsearch集群:JavaAPI操作集群
目标:掌握如何使用javaApi操作集群
1)spring-boot-data-elasticsearch,修改yml配置即可
spring:
  elasticsearch:
    rest:
      uris: http://192.168.66.133:9201,http://192.168.66.133:9202,http://192.168.66.133:9203
2)运行导入数据的方法
发现可以正常导入数据到ES
19、Elasticsearch集群:路由原理
目标:理解ES中路由的原理
- 文档存入对应的分片,ES计算分片编号的过程,称为路由。
- Elasticsearch 是怎么知道一个文档应该存放到哪个分片中呢?
- 查询时,根据文档id查询文档, Elasticsearch 又该去哪个分片中查询数据呢?
- 路由算法 :shard_index(分片编号) = hash(文档id) % number_of_primary_shards(主分片个数)
假设有三个节点,三个主分片,三个副本分片
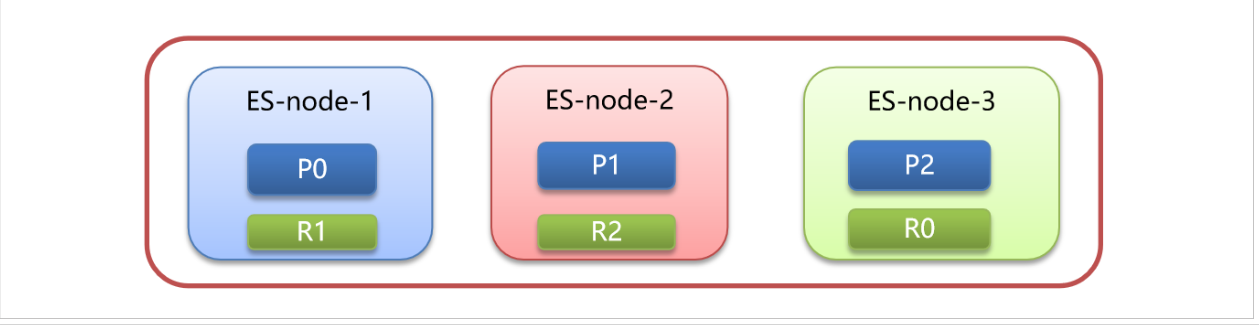
现在有个 id=5 文档要进行存储,会先会id进行hash运算得到一个数字17,17对3(分片数量)取模运算:17 % 3 = 2
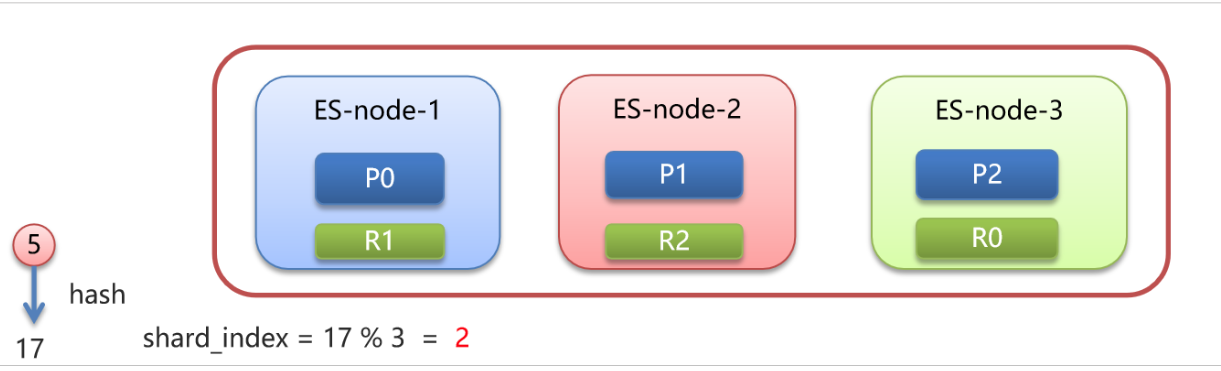
最终决定存储在编号为2的分片上,即放到ES-node-3上,并且在ES-node-2节点上的副本分片上进行数据备份。
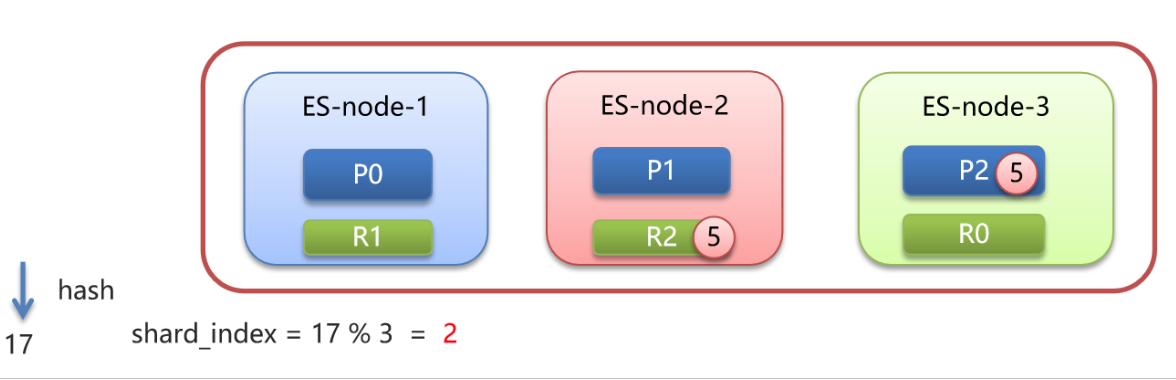
当要查询 id = 5 的文档,同样也要先进行hash计算,计算分片位置,路由到对应的分片进行数据查询。
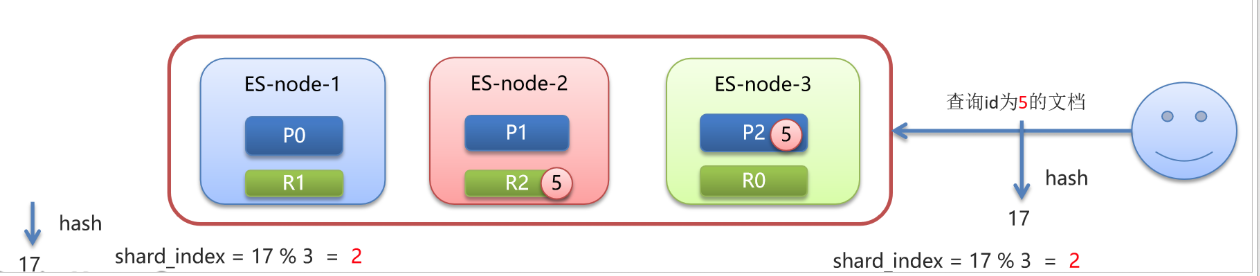
说明:任何一个节点收到查询请求后,如果是一些词条搜索,也会根据倒排索引找到对应的id集合,再分别计算每个id的hash值,所存储的分片位置,再转发请求到分片所在的节点,最终汇总查询结果。
20、Elasticsearch集群:脑裂问题
目标:理解何为脑裂以及如何防止脑裂
何为脑裂?
- 一个正常es集群中只有一个主节点(Master),主节点负责管理整个集群。如创建或删除索引,并决定哪些分片分配给哪些节点。此外还跟踪哪些节点是集群的一部分。
- 脑裂就是一个集群出现多个主节点从而使集群分裂,使得集群处于异常状态。简单来说就是一个集群里只能有一个老大来指挥工作,如果有多个老大,就乱套了。
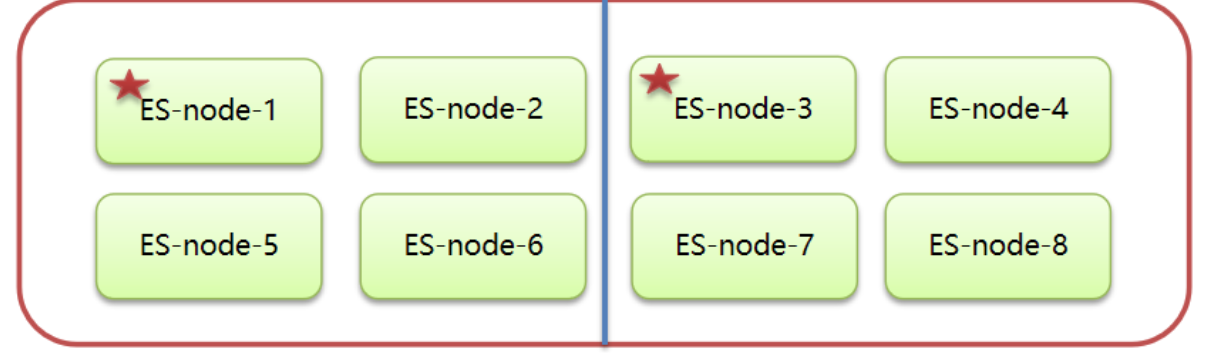
脑裂原因
- 网络原因:网络延迟
一般es集群会在内网部署,也可能在外网部署,比如阿里云。
内网一般不会出现此问题,外网的网络出现问题的可能性大些。 - 节点负载
主节点的角色既为master又为data。数据访问量较大时,可能会导致Master节点停止响应(假死状态)。 - JVM内存回收
当Master节点设置的JVM内存较小时,引发JVM的大规模内存回收,造成ES进程失去响应
避免脑裂
脑裂产生的原因:
- 网络原因:网络延迟较高
- 节点负载:主节点的角色既为master又为data
- JVM内存回收:JVM内存设置太小
避免脑裂:
- 网络原因:discovery.zen.ping.timeout 超时时间配置大一点。默认是3S
- 节点负载:角色分离策略
- 主节点配置:
node.master: true # 是否有资格参加选举成为master
node.data: false # 是否存储数据
- 主节点配置:
- 数据节点配置:
node.master: false # 是否有资格参加选举成为master
node.data: true # 是否存储数据
- JVM内存回收:修改 config/jvm.options 文件的 -Xms 和 -Xmx 为服务器的物理内存一半。
- 还可以在选举层面解决脑裂问题(即不让第二个老大产生):
# 声明获4得大于几票,主节点才有效,请设置为(master eligble nodes / 2) + 1
discovery.zen.minimum_master_nodes: 2
比如上面存在8个节点(假如都是master eligble节点),那需要设置discovery.zen.minimum_master_nodes: 5,代表至少5票投某个节点,才有效。如果某个时刻两个机房网络中断了,右边的机房里四个节点揭竿而起从新选举,也不够票数。
21、Elasticsearch集群:故障迁移
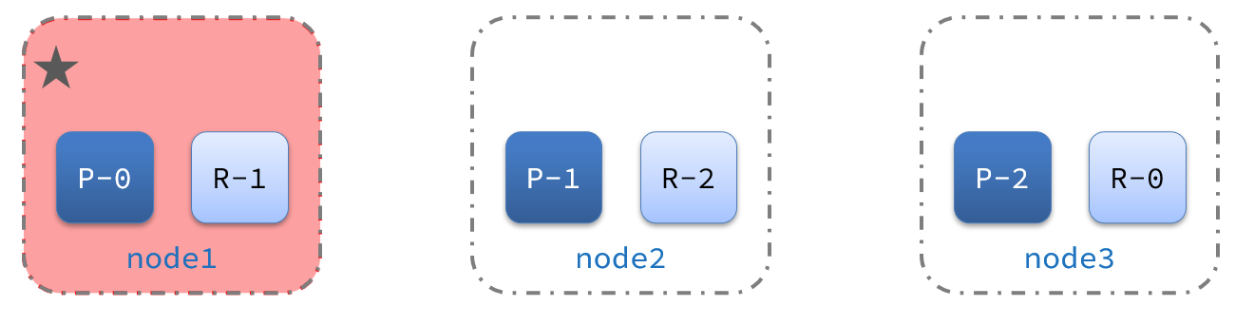
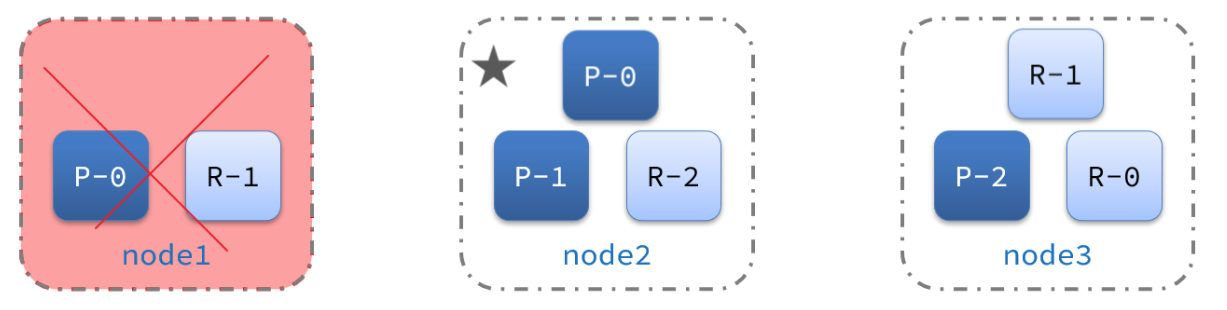
集群的master节点会监控集群中的节点状态,如果发现有节点宕机,会立即将宕机节点的分片数据迁移到其它节点,确保数据安全,这个叫做故障转移。
1)例如一个集群结构如图:
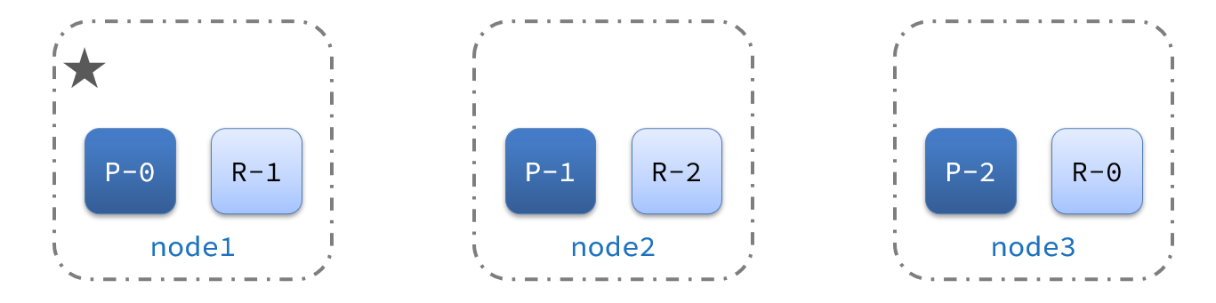
现在,node1是主节点,其它两个节点是从节点。
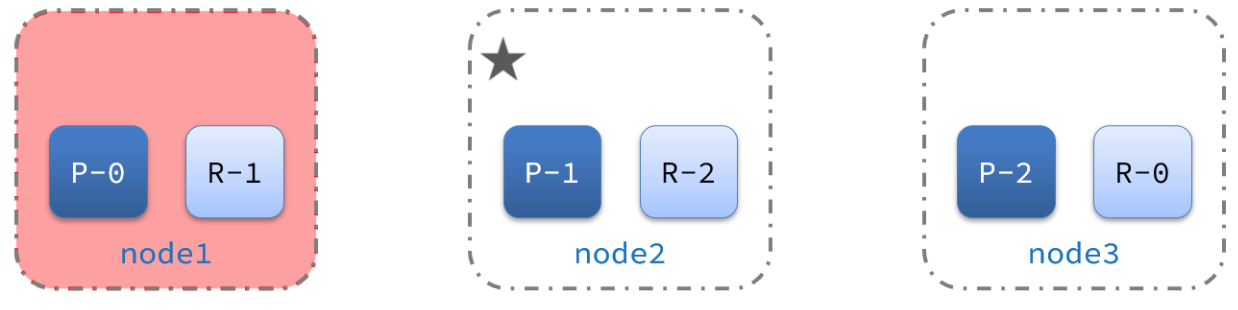
2)突然,node1发生了故障:
docker-compose stop es01
宕机后的第一件事,需要重新选主,例如选中了node2:
node2成为主节点后,会检测集群监控状态,发现:shard-1、shard-0没有副本节点。因此需要将node1上的数据迁移到node2、node3:
22、课程总结

若有收获,就点个赞吧
0 人点赞


