一、单层感知器(二分类问题)
1.原理及其理论
详细原理可以参考CSDN专栏https://blog.csdn.net/pxhdky/article/details/86360535,博主为齐在
这个原理是感知器的原理,与神经网络的感知机原理有些出入,两者可以对比来看
关于神经网络中单层感知机原理,可以参考专栏https://www.cnblogs.com/pythonlearing/p/9947051.html,博主为小纯洁的兄弟
2.代码实现
import numpy as npimport matplotlib.pyplot as plt#输入数据X = np.array([[1,3,3],[1,4,3],[1,1,1],[1,0,2]]) #第一个值为偏置值,恒为1.要习惯写二维数组的形式!shape为4*3#标签Y = np.array([[1],[1],[-1],[-1]])#权值初始化,3行1列,取值范围-1到1W = (np.random.random([3,1])-0.5)*2 #本来生成0~1之间的值,这里进行转化成生成-1到1的值print(W) #查看初始值#学习率设置lr = 0.11#神经网络输出O = 0def update(): #更新权值global X,Y,W,lr #在函数内部对函数外部进行操作,需要用global声明O = np.sign(np.dot(X,W)) # shape:(3,1),np.dot为矩阵乘法,这里也可以表示为np.dot(W.T,X)W_C = lr*(X.T.dot(Y-O))/int(X.shape[0]) #delta wi = lr*(t-y)xi,这里t-y是(Y-O),X.T是xi,这里除以int是因为要求平均的误差,数据量比较小的情况下可以不用除,数据量较大时会导致权值调整过大而出现误差W = W + W_Cfor i in range(100):update()#更新权值print(W)#打印当前权值print(i)#打印迭代次数O = np.sign(np.dot(X,W))#计算当前输出if(O == Y).all(): #如果实际输出等于期望输出,模型收敛,循环结束print('Finished')print('epoch:',i)break#画图#正样本x1 = [3,4] #定义X1y1 = [3,3] #定义X2#负样本x2 = [1,0]y2 = [1,2]#计算分界线的斜率以及截距k = -W[1]/W[2] #w0 + w1x1 + w2x2 = 0d = -W[0]/W[2]print('k=',k)print('d=',d)xdata = (0,5)plt.figure()plt.plot(xdata,xdata*k+d,'r')plt.scatter(x1,y1,c='b')plt.scatter(x2,y2,c='y')plt.show() #初始化w值不同,会出现不同的线
3.单层感知机的异或问题
单层感知机一个缺陷依赖于初始权值,不同的权值会导致不同的超平面,有些超平面会导致最后分类的效果比较差;还有一个缺陷不能解决非线性的问题
一般单层感知机的异或问题是非线性问题,比如上面的程序,把数据集改为
X = np.array([[1,0,0],
[1,0,1],
[1,1,0],
[1,1,1]])
此时没有一个线性超平面把点准确分开,会出现迭代多次后仍没有最优解,这是单层感知机不能做到的
二、线性神经网络
1.原理及其理论
线性神经网络的原理思想可以参考CSDN专栏https://blog.csdn.net/jerry_liufeng/article/details/107886872,作者为jerry_liufeng
Delta学习规则:线性神经网络的一种基于梯度下降法的学习规则
这里的损失函数为二次代价函数:E = 1/2(t-y) = 1/2[t - f(WX)],f(WX)是激活函数(不一定是哪种形式)E是权向量W的函数,可以使用梯度下降法进行: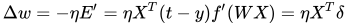
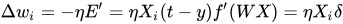 ,δ是一个符号,代表了(t-y)f(WX)
线性神经网络可以解决异或性,第一个方法是用多个线性函数对区域进行划分,第二个方法是添加非线性输入,从而引入非线性成分
2.代码实现
import numpy as npimport matplotlib.pyplot as plt#输入数据X = np.array([[1,3,3],[1,4,3],[1,1,1],[1,0,2]]) #X是4*3的#标签Y = np.array([[1],[1],[-1],[-1]])#权值初始化,3行1列,取值范围-1到1W = (np.random.random([3,1])-0.5)*2print(W)#学习率设置lr = 0.11#神经网络输出O = 0def update():global X,Y,W,lrO = np.dot(X,W) #此时没有激活函数sign,而是利用新的激活函数y = x,O是4*1维的W_C = lr*(X.T.dot(Y-O))/int(X.shape[0]) #W是3*1的,X.T是3*4的,Y-O是4*1的,乘完之后是3*1的W = W + W_C #更新权值#画图求解for _ in range(100):update()#更新权值print(W)#打印当前权值print(i)#打印迭代次数O = np.sign(np.dot(X,W))#计算当前输出if(O == Y).all(): #如果实际输出等于期望输出,模型收敛,循环结束print('Finished')print('epoch:',i)break#正样本x1 = [3,4]y1 = [3,3]#负样本x2 = [1,0]y2 = [1,2]#计算分界线的斜率以及截距k = -W[1]/W[2]d = -W[0]/W[2]print('k=',k)print('d=',d)xdata = (0,5)plt.figure()plt.plot(xdata,xdata*k+d,'r')plt.scatter(x1,y1,c='b')plt.scatter(x2,y2,c='y')plt.show()
3.线性神经网络解决异或问题
import numpy as npimport matplotlib.pyplot as plt#输入数据X = np.array([[1,0,0,0,0,0],[1,0,1,0,0,1],[1,1,0,1,0,0],[1,1,1,1,1,1]])#x0全为1,x1为(0,0,1,1)',x2为(0,1,0,1)'第四列为x1平方,第五列是x1x2,第六列是x2平方(加入非线性项)#标签Y = np.array([[-1],[1],[1],[-1]]) #y为4*1维#权值初始化,3行1列,取值范围-1到1W = (np.random.random([6,1])-0.5)*2 #W为6*1维print(W)#学习率设置lr = 0.11#神经网络输出O = 0def update():global X,Y,W,lrO = np.dot(X,W) #此时没有激活函数sign,而是使用y = xW_C = lr*(X.T.dot(Y-O))/int(X.shape[0]) #这里的一定不要搞错,否则后面很容易出问题!W = W + W_Cfor _ in range(100):update()#更新权值#正样本x1 = [0,1]y1 = [1,0]#负样本x2 = [0,1]y2 = [0,1]def calculate(x,root):#这里是计算x0w0 + x1w1 +x2w2 + x1^2w3 + x1x2w4 +x2^2w5 = 0的根情况,这里最终计算x2的根的情况a = W[5]b = W[2]+x*W[4]c = W[0]+x*W[1]+x*x*W[3]if root == 1:return(-b+np.sqrt(b*b-4*a*c))/(2*a)if root == 2:return(-b-np.sqrt(b*b-4*a*c))/(2*a)xdata =np.linspace(-1,2) # linspace是线性划分区间,生成一系列的点plt.figure()plt.plot(xdata,calculate(xdata,1),'r') #生成两条边界线,达成线性神经网络可以实现解决异或问题plt.plot(xdata,calculate(xdata,2),'r') #生成两条边界线,达成线性神经网络可以实现解决异或问题plt.scatter(x1,y1,c='b')plt.scatter(x2,y2,c='y')plt.show()
三、BP神经网络(重点)
基本的算法原理比较复杂,可以参考周志华的西瓜书,这里只给出最后的结果形式,可以参照简书专栏https://www.jianshu.com/p/7f1cb367a852的图例帮助理解BP神经网络的过程,作者为暑水。
CSDN专栏有专业的数学推导和最终形式,可以参考https://blog.csdn.net/u014303046/article/details/78200010,博主为痴澳超
1.代码实例实现——解决异或问题
首先要有一个构建神经网络的思路,这里以简单的三层感知器为例,假设输入层有三个值x0,x1,x2,(其中x0恒为1为偏置值),隐藏层有一层,包含四个神经元y0,y1,y2,y3,输出层有一个神经元O
设V00,V01,V02,V03是输入层X0到隐藏层的权值,V10,V11,V12,V13是输入层X1到隐藏层的权值,V20,V21,V22,V23是输入层X2到隐藏层的权值;W0,W1,W2,W3是隐藏层到输出层的权值,于是有: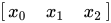 =
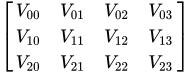
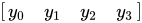
 = O
import numpy as np#输入数据X = np.array([[1,0,0],[1,0,1],[1,1,0],[1,1,1]]) #X是4*3的#标签Y = np.array([[0,1,1,0]])#权值初始化,取值范围-1到1V = np.random.random((3,4))*2-1 #这里假设输入值有x0,x1,x2三个,隐藏层只有一层,且隐藏层的神经元有4个,输出值只有一个,那么在输入层和隐藏层之间有3*4维的权值W = np.random.random((4,1))*2-1 #这里是隐藏层和输出层之间的权值,为4*1维print(V)print(W)#学习率设置lr = 0.11def sigmoid(x): #定义激活函数sigmoid函数return 1/(1+np.exp(-x))def dsigmoid(x): #定义激活函数的求导形式return x*(1-x)def update(): #更新权值global X,Y,W,V,lrL1 = sigmoid(np.dot(X,V))#隐藏层输出(4,4) (y0,y1,y2,y3)L2 = sigmoid(np.dot(L1,W))#输出层输出(4,1) (O)L2_delta = (Y.T - L2)*dsigmoid(L2) #4*1维;权值更新公式,由于是反向先更新L2_delta:delta = (dk - ok)ok(1-ok),其中dk是期望输出对应Y,ok是实际运算得到的输出L1_delta = L2_delta.dot(W.T)*dsigmoid(L1) #4*4维;权值更新公式,L1_delta = L2_delta*W*yj(1-yj),这里L2_delta*W在多层下是加权平均,在这里只是单层,后面是激活函数的导数L1W_C = lr*L1.T.dot(L2_delta) #权值调整公式,为lr*L2_Delta*yj(隐藏层输出)V_C = lr*X.T.dot(L1_delta) #权值调整公式,为lr*L1_Delta*xi(输入层输出)W = W + W_CV = V + V_Cfor i in range(20000): #进行迭代update()#更新权值if i%500==0: #每隔500次输出一次误差变化L1 = sigmoid(np.dot(X,V))#隐藏层输出(4,4)L2 = sigmoid(np.dot(L1,W))#输出层输出(4,1)print('Error:',np.mean(np.abs(Y.T-L2)))L1 = sigmoid(np.dot(X,V))#隐藏层输出(4,4)L2 = sigmoid(np.dot(L1,W))#输出层输出(4,1)print(L2) #循环结束后输出L2情况def judge(x):if x>=0.5:return 1else:return 0for i in map(judge,L2): #map() 会根据提供的函数对指定序列做映射。第一个参数 function 以参数序列中的每一个元素调用 function 函数,返回包含每次 function 函数返回值的新列表。print(i)

若有收获,就点个赞吧
0 人点赞


