一、一元线性回归
1.一元线性回归的梯度下降法
import numpy as npimport matplotlib.pyplot as plt# 载入数据data = np.genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\data.csv", delimiter=",") #注意这是csv文件的读取,第二个参数是指定分隔符符号x_data = data[:,0] #选取csv的第一列数据y_data = data[:,1] #选取csv的第二列数据plt.scatter(x_data,y_data) #散点图显示,做回归之前最好还是先看看数据点的分布情况plt.show()# 学习率learning ratelr = 0.0001 #定义学习率,开始时设定较小一下# 截距b = 1 #指定初值# 斜率k = 1 #指定初值# 最大迭代次数epochs = 50 #指定迭代次数,一般梯度下降法都要设置一个迭代的次数保证算法的收敛性# 最小二乘法的应用def compute_error(b, k, x_data, y_data): #这里是构造损失函数totalError = 0 #先设置代价函数的初值为0for i in range(0, len(x_data)):totalError += (y_data[i] - (k * x_data[i] + b)) ** 2 #相当于sum求和求残差平方和,y_data是真实值,k * x_data[i] + b是预测值return totalError / float(len(x_data)) / 2.0 #这里返回的是之前代价函数的公式情况#梯度下降的具体应用def gradient_descent_runner(x_data, y_data, b, k, lr, epochs):# 计算总数据量m = float(len(x_data))# 循环epochs次for i in range(epochs):b_grad = 0 #定义初值k_grad = 0 #定义初值# 计算梯度的总和再求平均for j in range(0, len(x_data)):b_grad += (1/m) * (((k * x_data[j]) + b) - y_data[j]) #这里的+=还是一个最小二乘中求和的形式k_grad += (1/m) * x_data[j] * (((k * x_data[j]) + b) - y_data[j])# 更新b和kb = b - (lr * b_grad)k = k - (lr * k_grad)# 每迭代5次,输出一次图像if i % 5==0:print("epochs:",i)plt.plot(x_data, y_data, 'b.')plt.plot(x_data, k*x_data + b, 'r')plt.show()return b, kprint("Starting b = {0}, k = {1}, error = {2}".format(b, k, compute_error(b, k, x_data, y_data))) #依次打印b的值,k的值,代价函数的值,大括号中的0,1,2表示传入数据的位次print("Running...")b, k = gradient_descent_runner(x_data, y_data, b, k, lr, epochs)print("After {0} iterations b = {1}, k = {2}, error = {3}".format(epochs, b, k, compute_error(b, k, x_data, y_data))) #输出迭代次数到50次时的值# 画图→迭代第50次的值plt.plot(x_data, y_data, 'b.')plt.plot(x_data, k*x_data + b, 'r')plt.show()
2.一元线性回归的sklearn库的应用
from sklearn.linear_model import LinearRegressionimport numpy as npimport matplotlib.pyplot as plt# 载入数据data = np.genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\data.csv", delimiter=",")x_data = data[:,0]y_data = data[:,1]plt.scatter(x_data,y_data)plt.show()print(x_data.shape) #这里显示x_data的形状,会发现这是一个向量形式,后面要对它转变形式,sklearn库才会识别并拟合模型#x_data = data[:,0,np.newaxis] #这个代码表示100行1列的数据,这里相当于给数据加上一个维度,否则sklearn库模型拟合会出现错误#x_data.shape #重新检查x_data的形状x_data = data[:,0,np.newaxis]y_data = data[:,1,np.newaxis]# 创建并拟合模型model = LinearRegression() #先创建一个模型model.fit(x_data, y_data) #进行建模display(model.intercept_) #截距display(model.coef_) #线性模型的系数model.score(x_data,y_data) #计算R方# 画图plt.plot(x_data, y_data, 'b.')plt.plot(x_data, model.predict(x_data), 'r')plt.show()
二、多元线性回归
1.多元线性回归的梯度下降法
import numpy as npfrom numpy import genfromtxtimport matplotlib.pyplot as pltfrom mpl_toolkits.mplot3d import Axes3D #这个库是画3D图的# 读入数据data = genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\Delivery.csv",delimiter=',')print(data)# 切分数据x_data = data[:,:-1] #取前两列数据,作为x向量的值,属性是numpy的一个二维数组y_data = data[:,-1] #取y值print(x_data)print(y_data)# 学习率learning ratelr = 0.0001# 参数theta0 = 0theta1 = 0theta2 = 0 #设置三个参数# 最大迭代次数epochs = 1000# 最小二乘法def compute_error(theta0, theta1, theta2, x_data, y_data):totalError = 0for i in range(0, len(x_data)):totalError += (y_data[i] - (theta1 * x_data[i,0] + theta2 * x_data[i,1] + theta0)) ** 2 #最小二乘法,这里相当于求和return totalError / float(len(x_data))def gradient_descent_runner(x_data, y_data, theta0, theta1, theta2, lr, epochs):# 计算总数据量m = float(len(x_data))# 循环epochs次for i in range(epochs):theta0_grad = 0theta1_grad = 0theta2_grad = 0 #先进行初始化# 计算梯度的总和再求平均for j in range(0, len(x_data)):theta0_grad += (1/m) * ((theta1 * x_data[j,0] + theta2*x_data[j,1] + theta0) - y_data[j]) #利用for循环进行求和过程!预测值减真实值!theta1_grad += (1/m) * x_data[j,0] * ((theta1 * x_data[j,0] + theta2*x_data[j,1] + theta0) - y_data[j])theta2_grad += (1/m) * x_data[j,1] * ((theta1 * x_data[j,0] + theta2*x_data[j,1] + theta0) - y_data[j])# 更新b和ktheta0 = theta0 - (lr*theta0_grad)theta1 = theta1 - (lr*theta1_grad)theta2 = theta2 - (lr*theta2_grad)return theta0, theta1, theta2print("Starting theta0 = {0}, theta1 = {1}, theta2 = {2}, error = {3}".format(theta0, theta1, theta2, compute_error(theta0, theta1, theta2, x_data, y_data)))print("Running...")theta0, theta1, theta2 = gradient_descent_runner(x_data, y_data, theta0, theta1, theta2, lr, epochs)print("After {0} iterations theta0 = {1}, theta1 = {2}, theta2 = {3}, error = {4}".format(epochs, theta0, theta1, theta2, compute_error(theta0, theta1, theta2, x_data, y_data)))#一下代码为画图ax = plt.figure().add_subplot(111, projection = '3d')ax.scatter(x_data[:,0], x_data[:,1], y_data, c = 'r', marker = 'o', s = 100) #点为红色三角形x0 = x_data[:,0]x1 = x_data[:,1]# 生成网格矩阵x0, x1 = np.meshgrid(x0, x1) #注意!这是生成一个较为密集的网格矩阵,便于观察点的位置z = theta0 + x0*theta1 + x1*theta2# 画3D图ax.plot_surface(x0, x1, z)#设置坐标轴ax.set_xlabel('Miles')ax.set_ylabel('Num of Deliveries')ax.set_zlabel('Time')#显示图像plt.show()
注:网格矩阵np.meshgrid()的用法
x0,x1 = np.meshgrid([1,2,3],[4,5,6])x0 #代表横坐标array([[1, 2, 3],[1, 2, 3],[1, 2, 3]]) #x0的outputx1 #代表纵坐标array([[4, 4, 4],[5, 5, 5],[6, 6, 6]]) #x1的output#上述的x0,x1可以表示成(1,4)(2,4)(3,4)(1,5)(2,5)(3,5)(1,6)(2,6)(3,6)plt.scatter(x0,x1)plt.show() #生成一个网格矩阵的模型样式
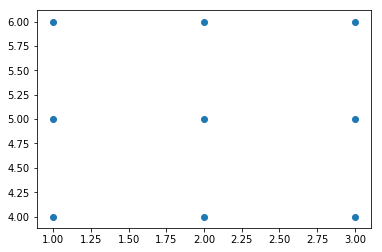 此为图的output情况
2.多元线性回归的sklearn库方法
(1)基本形式
import numpy as npfrom numpy import genfromtxtfrom sklearn import linear_modelimport matplotlib.pyplot as pltfrom mpl_toolkits.mplot3d import Axes3D# 读入数据data = genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\Delivery.csv",delimiter=',')print(data)# 切分数据x_data = data[:,:-1]y_data = data[:,-1]print(x_data)print(y_data)# 创建模型model = linear_model.LinearRegression()model.fit(x_data, y_data) #利用fit方法来进行模型拟合# 系数print("coefficients:",model.coef_)# 截距print("intercept:",model.intercept_)# 测试x_test = [[102,4]]predict = model.predict(x_test)print("predict:",predict)ax = plt.figure().add_subplot(111, projection = '3d')ax.scatter(x_data[:,0], x_data[:,1], y_data, c = 'r', marker = 'o', s = 100) #点为红色三角形x0 = x_data[:,0]x1 = x_data[:,1]# 生成网格矩阵x0, x1 = np.meshgrid(x0, x1)z = model.intercept_ + x0*model.coef_[0] + x1*model.coef_[1]# 画3D图ax.plot_surface(x0, x1, z)#设置坐标轴ax.set_xlabel('Miles')ax.set_ylabel('Num of Deliveries')ax.set_zlabel('Time')#显示图像plt.show()
(2)其他用法
详见https://blog.csdn.net/weixin_40014576/article/details/79918819查询具体用法
三、多项式回归
1.sklearn库的多项式回归应用
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.preprocessing import PolynomialFeaturesfrom sklearn.linear_model import LinearRegression# 载入数据data = np.genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\job.csv", delimiter=",")x_data = data[1:,1]y_data = data[1:,2]plt.scatter(x_data,y_data) #先观察散点情况,根据分布情况拟合曲线plt.show()x_data = x_data[:,np.newaxis] #原始的x_data形式是不合适的,sklearn库封装的函数使用这种形式会报错(需要二维格式),于是需要修改!y_data = y_data[:,np.newaxis]# 创建并拟合模型(一元线性回归形式)model = LinearRegression()model.fit(x_data, y_data)# 画图plt.plot(x_data, y_data, 'b.')plt.plot(x_data, model.predict(x_data), 'r')plt.show()model.score(x_data,y_data) #其实可以发现R方比较小,拟合效果比较差# 定义多项式回归,degree的值可以调节多项式的特征poly_reg = PolynomialFeatures(degree=5) #degree表示拟合的最高次数# 特征处理x_poly = poly_reg.fit_transform(x_data) #此步最前面会产生1这个偏置值,这是用来拟合β0的# 定义回归模型lin_reg = LinearRegression()# 训练模型lin_reg.fit(x_poly, y_data)#注:x_poly的值如下表现array([[1.0000e+00, 1.0000e+00, 1.0000e+00, 1.0000e+00, 1.0000e+00,1.0000e+00],[1.0000e+00, 2.0000e+00, 4.0000e+00, 8.0000e+00, 1.6000e+01,3.2000e+01],[1.0000e+00, 3.0000e+00, 9.0000e+00, 2.7000e+01, 8.1000e+01,2.4300e+02],[1.0000e+00, 4.0000e+00, 1.6000e+01, 6.4000e+01, 2.5600e+02,1.0240e+03],[1.0000e+00, 5.0000e+00, 2.5000e+01, 1.2500e+02, 6.2500e+02,3.1250e+03],[1.0000e+00, 6.0000e+00, 3.6000e+01, 2.1600e+02, 1.2960e+03,7.7760e+03],[1.0000e+00, 7.0000e+00, 4.9000e+01, 3.4300e+02, 2.4010e+03,1.6807e+04],[1.0000e+00, 8.0000e+00, 6.4000e+01, 5.1200e+02, 4.0960e+03,3.2768e+04],[1.0000e+00, 9.0000e+00, 8.1000e+01, 7.2900e+02, 6.5610e+03,5.9049e+04],[1.0000e+00, 1.0000e+01, 1.0000e+02, 1.0000e+03, 1.0000e+04,1.0000e+05]])# 画图plt.plot(x_data, y_data, 'b.')plt.plot(x_data, lin_reg.predict(poly_reg.fit_transform(x_data)), c='r') #这里要传入经过特征处理的数据才对plt.title('Truth or Bluff (Polynomial Regression)')plt.xlabel('Position level')plt.ylabel('Salary')plt.show()lin_reg.score(poly_reg.fit_transform(x_data),y_data) #计算R方lin_reg.coef_ #计算回归系数lin_reg.intercept_ #计算截距
四、线性回归的标准方程法
标准方程法即利用代数方法将系数以矩阵的形式求出,由多元线性回归知识可以得到:
βhat = (XX)XY
注:矩阵不可逆情况:
1.多重共线性
2.特征数据太多,样本数小于特征数量
#这里是一元线性回归的方式,多元也可以类似import numpy as npfrom numpy import genfromtxtimport matplotlib.pyplot as plt# 载入数据data = np.genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\data.csv", delimiter=",")x_data = data[:,0,np.newaxis]y_data = data[:,1,np.newaxis]plt.scatter(x_data,y_data)plt.show()print(np.mat(x_data).shape) #转化成矩阵形式print(np.mat(y_data).shape) #转化成矩阵形式# 给样本添加偏置项X_data = np.concatenate((np.ones((100,1)),x_data),axis=1) #np.ones((100,1))这里是生成100行1列的数据为1的矩阵,添加偏置项;np.concatenate是用来进行矩阵的合并的,axis是指定合并的方向,1是列方向print(X_data.shape) #查看新数据的格式#注:观察X_data的形式# print(X_data[:3])#[[ 1. 32.50234527][ 1. 53.42680403][ 1. 61.53035803]] output形式# 标准方程法求解回归参数def weights(xArr, yArr): #定义回归系数公式形式xMat = np.mat(xArr) #转化矩阵形式yMat = np.mat(yArr) #转化矩阵形式xTx = xMat.T*xMat # 矩阵乘法# 计算矩阵的值,如果值为0,说明该矩阵没有逆矩阵if np.linalg.det(xTx) == 0.0: #如果行列式等于0,则没有逆print("This matrix cannot do inverse")return# xTx.I为xTx的逆矩阵ws = xTx.I*xMat.T*yMatreturn wsws = weights(X_data,y_data)print(ws)# 画图x_test = np.array([[20],[80]])y_test = ws[0] + x_test*ws[1]plt.plot(x_data, y_data, 'b.')plt.plot(x_test, y_test, 'r')plt.show()
五、其他库的回归模型用法(statsmodel库的用法)
这个库可以跟R语言一样直接输出其他统计量的信息,详细用法请见https://blog.csdn.net/chongminglun/article/details/104242342
六、岭回归
为了解决(XX)无法计算的情况(不可逆),于是引入岭回归概念,在标准方程法中,令
w = (XX+λI)Xy
其中,λ是岭系数,I为单位矩阵
岭回归是一个有偏估计
λ的选取:选择λ值,使得:各回归系数的岭估计基本稳定;残差平方和(代价函数的第一个部分)增大不太多
1.sklearn库的岭回归
import numpy as npfrom numpy import genfromtxtfrom sklearn import linear_modelimport matplotlib.pyplot as plt#读入数据data = genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\longley.csv",delimiter=',') #getfromtext只能获取数值数据,不能获取字符串等数据print(data)# 切分数据x_data = data[1:,2:]y_data = data[1:,1]print(x_data)print(y_data)# 创建模型# 生成50个值alphas_to_test = np.linspace(0.001, 1) #从0.001到1取50个λ值进行岭回归实验# 创建模型,保存误差值model = linear_model.RidgeCV(alphas=alphas_to_test, store_cv_values=True) #CV代表交叉验证,利用交叉验证法训练模型model.fit(x_data, y_data)model.coef_ #岭回归系数# 岭系数print(model.alpha_) #选取最合适的λ值# loss值print(model.cv_values_.shape) #model.cv_values_会产生16行50列的数据,16行是指交叉验证法在16个样本中随机选取一个样本当测试集,其余的样本当作训练集进行拟合,50列是指50个λ值对应的loss值# 画图# 岭系数跟loss值的关系plt.plot(alphas_to_test, model.cv_values_.mean(axis=0)) #axis = 0表示对行16个值求平均值(每个值对应一个模型的loss)# 选取的岭系数值的位置plt.plot(model.alpha_, min(model.cv_values_.mean(axis=0)),'ro')plt.show()model.predict(x_data[2,np.newaxis]) #查看第二行数据对应预测的y值,这里要传入2维数据,否则模型会报错
2.标准方程法的岭回归
标准方程法需要自己进行交叉验证,这里书写是比较麻烦的,所以调包可能会更好一点,在这里只写算法思想之类的代码,后续需要再补充(学习交叉验证法的手写命令!)。
import numpy as npfrom numpy import genfromtxtimport matplotlib.pyplot as plt# 读入数据data = genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\longley.csv",delimiter=',')print(data)# 切分数据x_data = data[1:,2:]y_data = data[1:,1,np.newaxis]print(x_data)print(y_data)print(np.mat(x_data).shape) #将数据转化成矩阵形式,方便标准方程法print(np.mat(y_data).shape) #将数据转化成矩阵形式,方便标准方程法# 给样本添加偏置项X_data = np.concatenate((np.ones((16,1)),x_data),axis=1)print(X_data.shape)#可以查看新的数据集的内容#print(X_data[:3])# 岭回归标准方程法求解回归参数def weights(xArr, yArr, lam=0.2):xMat = np.mat(xArr)yMat = np.mat(yArr)xTx = xMat.T*xMat # 矩阵乘法rxTx = xTx + np.eye(xMat.shape[1])*lam #np.eye(xMat.shape[1])传入单位矩阵,这里要传入和xTx相同维度的的单位矩阵,于是利用.shape函数# 计算矩阵的值,如果值为0,说明该矩阵没有逆矩阵if np.linalg.det(rxTx) == 0.0:print("This matrix cannot do inverse")return# xTx.I为xTx的逆矩阵ws = rxTx.I*xMat.T*yMatreturn wsws = weights(X_data,y_data)print(ws) #打印岭回归系数值# 计算预测值np.mat(X_data)*np.mat(ws)
七、lasso回归
由于损失函数和lasso系数范围的切点多在坐标轴上,因此采用lasso回归会出现系数稀疏的现象,即有很多系数的估计值都为零(在λ较小的情况下时),因此lasso回归有时比岭回归具有优势, 因为可以剔除模型中不显著的变量,使得简化模型
import numpy as npfrom numpy import genfromtxtfrom sklearn import linear_model# 读入数据data = genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\longley.csv",delimiter=',')print(data)# 切分数据x_data = data[1:,2:]y_data = data[1:,1]print(x_data)print(y_data)# 创建模型model = linear_model.LassoCV() #这里是应用lasso的交叉验证法择λ值model.fit(x_data, y_data)# lasso系数print(model.alpha_)# 相关系数print(model.coef_)model.predict(x_data[-2,np.newaxis]) #传入倒数第二行进行预测y值,还是要传入二维数组形式才不会报错
八、弹性网(Elastic Net)
在弹性网中,正则项部分为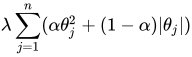 ,效果会比lasso和岭回归要好一点
import numpy as npfrom numpy import genfromtxtfrom sklearn import linear_model# 读入数据data = genfromtxt(r"C:\Users\小新\Desktop\课程pdf\py\机器学习\线性回归及非线性回归\longley.csv",delimiter=',')print(data)# 切分数据x_data = data[1:,2:]y_data = data[1:,1]print(x_data)print(y_data)# 创建模型model = linear_model.ElasticNetCV() #利用弹性网交叉验证法求λ值model.fit(x_data, y_data)# 弹性网系数print(model.alpha_)# 相关系数print(model.coef_)model.predict(x_data[-2,np.newaxis]) #预测

若有收获,就点个赞吧
0 人点赞


