与线性回归一样,softmax回归也是一个单层神经网络。由于计算每个输出o1、o2和o3取决于所有输入x1、x2、x3和x4,所以softmax回归的输出层也是全连接层。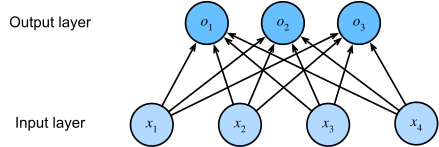
在这里要采取的主要方法是将模型的输出视作为概率。我们将优化参数以最大化观测数据的概率。为了得到预测结果,我们将设置一个阈值,如选择具有最大概率的标签。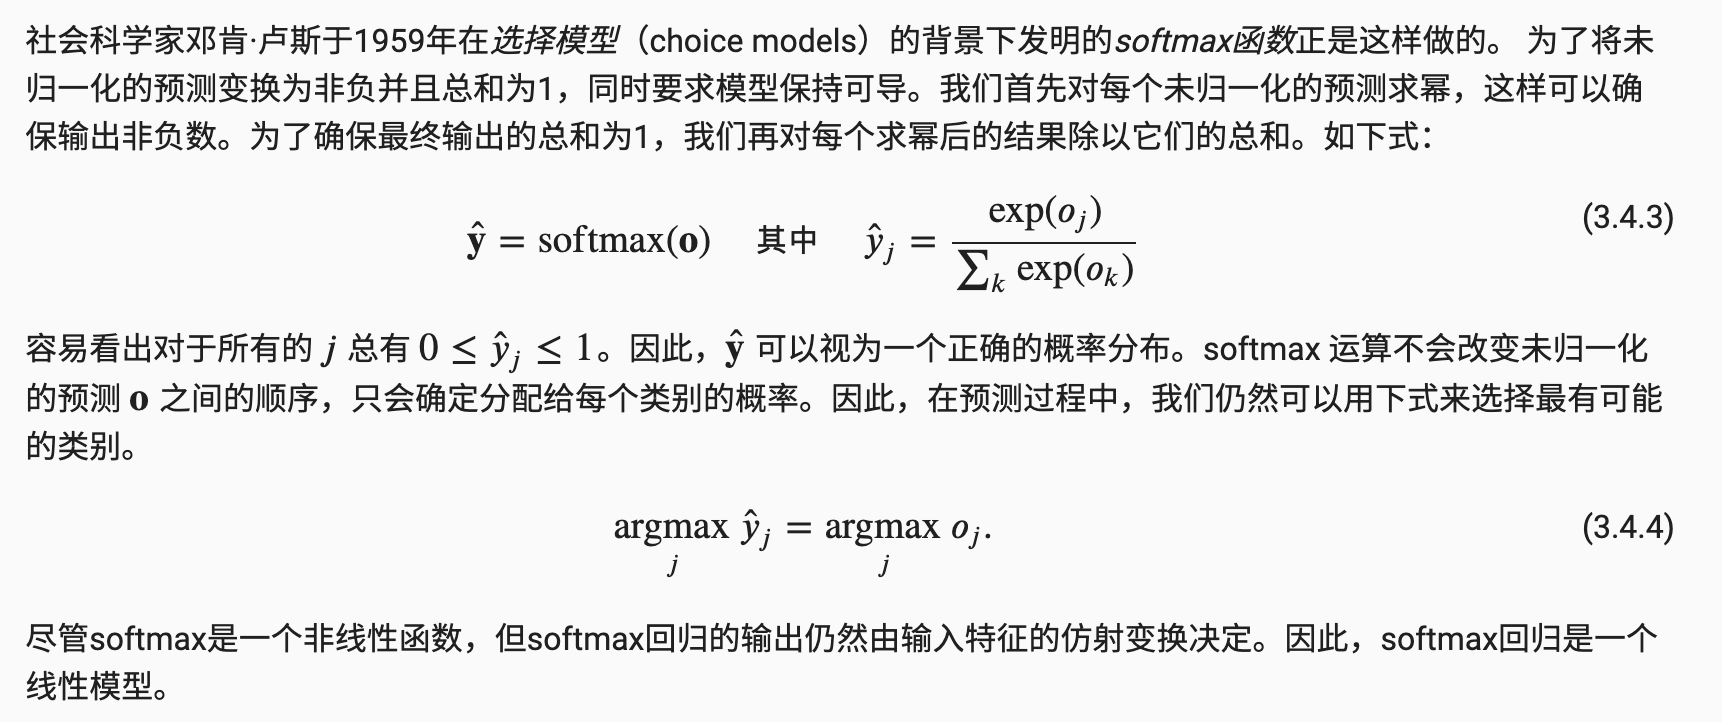
损失函数
我们需要一个损失函数来度量预测概率的效果。我们依赖最大似然估计,线性回归中的均方误差目标提供概率证明时遇到的概念完全相同。
对数似然
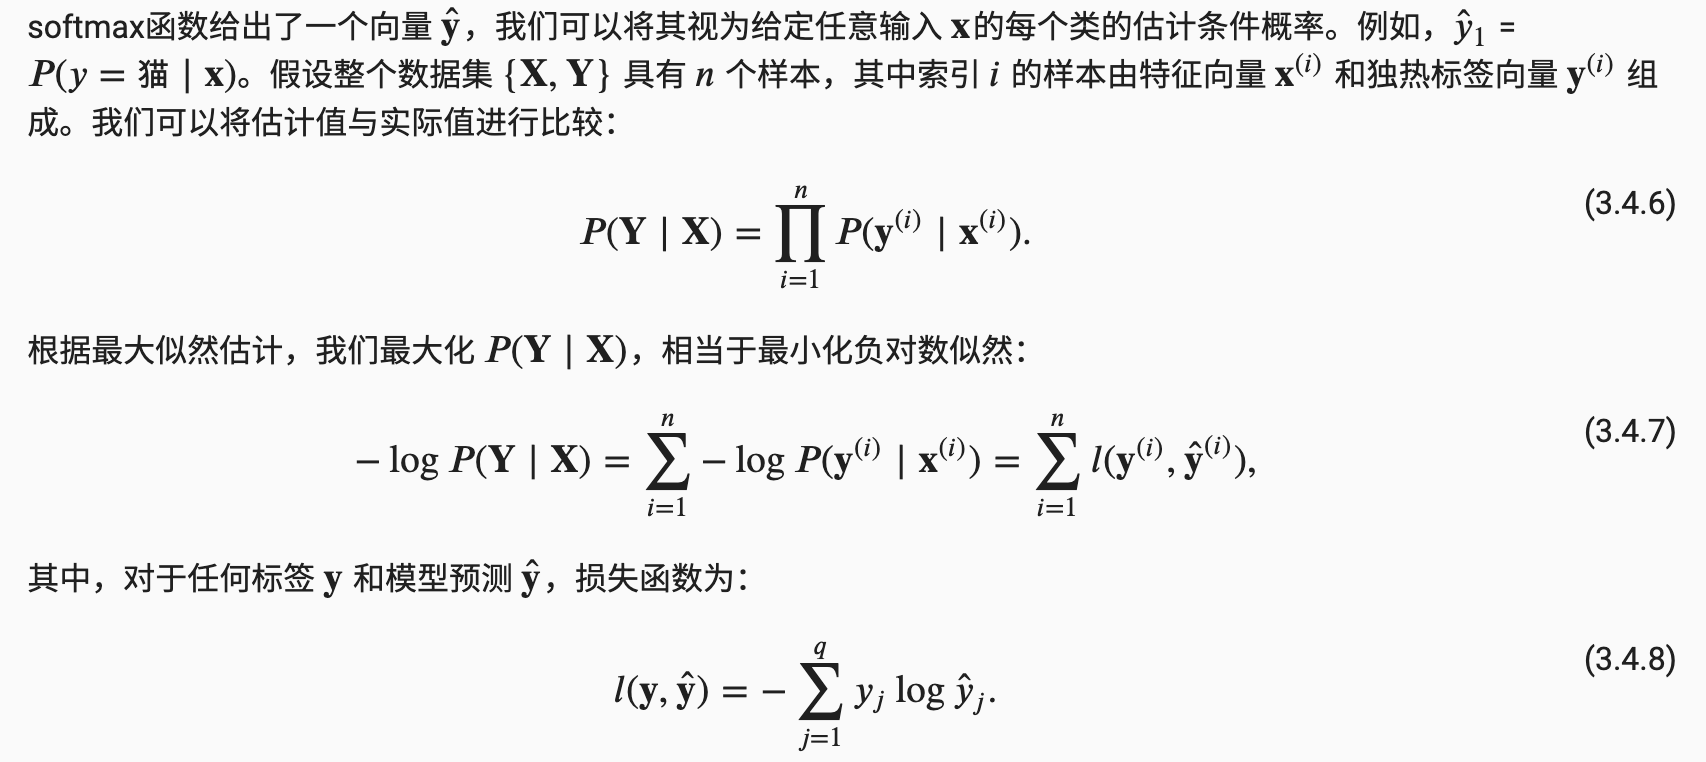
这里损失函数通常被称为交叉熵损失(cross-entropy loss)。由于𝐲是一个长度为𝑞的独热编码向量,所以除了一个项以外的所有项𝑗都消失了。由于所有𝑦̂𝑗都是预测的概率,所以它们的对数永远不会大于0。 因此,如果正确地预测实际标签,即,如果实际标签𝑃(𝐲∣𝐱)=1,则损失函数不能进一步最小化。 注意,这往往是不可能的。
Softmax 导数
损失函数写为:
考虑相对于任何未归一化的预测𝑜𝑗的导数。我们得到:
换句话说,导数是我们模型分配的概率(由softmax得到)与实际发生的情况(由独热标签向量表示)之间的差异。从这个意义上讲,与我们在回归中看到的非常相似,其中梯度是观测值𝑦和估计值𝑦̂之间的差异。
熵

若有收获,就点个赞吧
0 人点赞


