从头实现
数据导入
下载和导入 Fashion-MNIST 数据集,并设置数据迭代器的批量大小为256。
import torchfrom IPython import displayfrom d2l import torch as d2lbatch_size = 256train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
初始化模型参数
这里的每个样本都用固定长度向量表示。原始数据集中的每个样本都是28×28的图像。在本节中,我们将展平每个图像,将它们视为长度为784的向量。以后我们将讨论能够利用图像空间结构的复杂策略,但现在我仅将每个像素位置视为一个特征。
num_inputs = 784num_outputs = 10W = torch.normal(0, 0.01, size=(num_inputs, num_outputs), requires_grad=True)b = torch.zeros(num_outputs, requires_grad=True)
定义 Softmax 操作
softmax 由三个步骤组成: (1)对每个项求幂(使用exp); (2)对每一行求和(小批量中每个样本是一行),得到每个样本的归一化常数; (3)将每一行除以其归一化常数,确保结果的和为1。 在查看代码之前,让我们回顾一下这个表达式: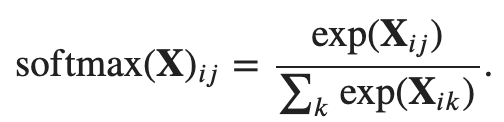
def softmax(X):X_exp = torch.exp(X)partition = X_exp.sum(1, keepdim=True)return X_exp / partition # 这里应用了广播机制
对于任何随机输入,我们将每个元素变成一个非负数。此外,因为概率的要求,每行总和为1。
X = torch.normal(0, 1, (2, 5))X_prob = softmax(X)X_prob, X_prob.sum(1)
定义模型
现在我们已经定义了softmax操作,我们可以实现softmax回归模型。下面的代码定义了输入如何通过网络映射到输出。注意,在将数据传递到我们的模型之前,我们使用reshape函数将每张原始图像展平为向量。
def net(X):return softmax(torch.matmul(X.reshape((-1, W.shape[0])), W) + b)
定义损失函数
交叉熵采用真实标签的预测概率的负对数似然。
y = torch.tensor([0, 2])y_hat = torch.tensor([[0.1, 0.3, 0.6], [0.3, 0.2, 0.5]])y_hat[[0, 1], y]def cross_entropy(y_hat, y):return -torch.log(y_hat[range(len(y_hat)), y])cross_entropy(y_hat, y)
分类准确率
当预测与标签分类y一致时,它们是正确的。分类准确率即正确预测数量与总预测数量之比。虽然直接优化准确率可能很困难(因为准确率的计算不可导),但准确率通常是我们最关心的性能衡量标准,我们在训练分类器时几乎总是会报告它。
为了计算准确率,我们执行以下操作。首先,如果y_hat是矩阵,第二个维度存储每个类的预测分数。我们使用argmax获得每行中最大元素的索引来获得预测类别。然后我们将预测类别与真实y元素进行比较。由于等式运算符==对数据类型很敏感,因此我们将y_hat的数据类型转换为与y的数据类型一致。结果是一个包含 0(错)和 1(对)的张量。进行求和会得到正确预测的数量。
def accuracy(y_hat, y):  #@save
    """计算预测正确的数量。"""
    if len(y_hat.shape) > 1 and y_hat.shape[1] > 1:
        y_hat = y_hat.argmax(axis=1)
    cmp = y_hat.type(y.dtype) == y
    return float(cmp.type(y.dtype).sum())
我们可以评估数据迭代器data_iter访问的数据集在任意模型net上的准确率。
def evaluate_accuracy(net, data_iter):  #@save
    """计算在指定数据集上模型的精度。"""
    if isinstance(net, torch.nn.Module):
        net.eval()  # 将模型设置为评估模式
    metric = Accumulator(2)  # 正确预测数、预测总数
    for X, y in data_iter:
        metric.add(accuracy(net(X), y), y.numel())
    return metric[0] / metric[1]
下面的类用于多个变量的累加:
class Accumulator:  #@save
    """在`n`个变量上累加。"""
    def __init__(self, n):
        self.data = [0.0] * n

    def add(self, *args):
        self.data = [a + float(b) for a, b in zip(self.data, args)]

    def reset(self):
        self.data = [0.0] * len(self.data)

    def __getitem__(self, idx):
        return self.data[idx]
训练
首先,我们定义一个函数来训练一个迭代周期。请注意,updater是更新模型参数的常用函数,它接受批量大小作为参数。它可以是封装的d2l.sgd函数,也可以是框架的内置优化函数。
def train_epoch_ch3(net, train_iter, loss, updater):  #@save
    """训练模型一个迭代周期(定义见第3章)。"""
    # 将模型设置为训练模式
    if isinstance(net, torch.nn.Module):
        net.train()
    # 训练损失总和、训练准确度总和、样本数
    metric = Accumulator(3)
    for X, y in train_iter:
        # 计算梯度并更新参数
        y_hat = net(X)
        l = loss(y_hat, y)
        if isinstance(updater, torch.optim.Optimizer):
            # 使用PyTorch内置的优化器和损失函数
            updater.zero_grad()
            l.backward()
            updater.step()
            metric.add(
                float(l) * len(y), accuracy(y_hat, y),
                y.size().numel())
        else:
            # 使用PyTorch内置的优化器和损失函数
            l.sum().backward()
            updater(X.shape[0])
            metric.add(float(l.sum()), accuracy(y_hat, y), y.numel())
    # 返回训练损失和训练准确率
    return metric[0] / metric[2], metric[1] / metric[2]
在展示训练函数的实现之前,我们定义了一个在动画中绘制数据的实用程序类。它能够简化本书其余部分的代码。
class Animator:  #@save
    """在动画中绘制数据。"""
    def __init__(self, xlabel=None, ylabel=None, legend=None, xlim=None,
                 ylim=None, xscale='linear', yscale='linear',
                 fmts=('-', 'm--', 'g-.', 'r:'), nrows=1, ncols=1,
                 figsize=(3.5, 2.5)):
        # 增量地绘制多条线
        if legend is None:
            legend = []
        d2l.use_svg_display()
        self.fig, self.axes = d2l.plt.subplots(nrows, ncols, figsize=figsize)
        if nrows * ncols == 1:
            self.axes = [self.axes,]
        # 使用lambda函数捕获参数
        self.config_axes = lambda: d2l.set_axes(self.axes[
            0], xlabel, ylabel, xlim, ylim, xscale, yscale, legend)
        self.X, self.Y, self.fmts = None, None, fmts

    def add(self, x, y):
        # 向图表中添加多个数据点
        if not hasattr(y, "__len__"):
            y = [y]
        n = len(y)
        if not hasattr(x, "__len__"):
            x = [x] * n
        if not self.X:
            self.X = [[] for _ in range(n)]
        if not self.Y:
            self.Y = [[] for _ in range(n)]
        for i, (a, b) in enumerate(zip(x, y)):
            if a is not None and b is not None:
                self.X[i].append(a)
                self.Y[i].append(b)
        self.axes[0].cla()
        for x, y, fmt in zip(self.X, self.Y, self.fmts):
            self.axes[0].plot(x, y, fmt)
        self.config_axes()
        display.display(self.fig)
        display.clear_output(wait=True)
接下来我们实现一个训练函数,它会在train_iter访问到的训练数据集上训练一个模型net。该训练函数将会运行多个迭代周期(由num_epochs指定)。在每个迭代周期结束时,利用test_iter访问到的测试数据集对模型进行评估。我们将利用Animator类来可视化训练进度。
设置参数和优化算法:
lr = 0.1

def updater(batch_size):
    return d2l.sgd([W, b], lr, batch_size)
现在,我们训练模型10个迭代周期。请注意,迭代周期(num_epochs)和学习率(lr)都是可调节的超参数。通过更改它们的值,我们可以提高模型的分类准确率。
num_epochs = 10
train_ch3(net, train_iter, test_iter, cross_entropy, num_epochs, updater)

预测
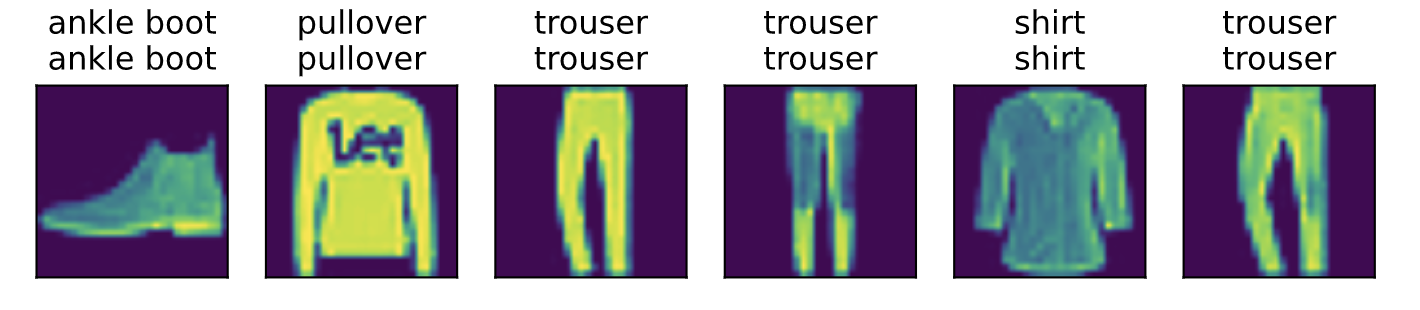
现在训练已经完成,我们的模型已经准备好对图像进行分类。给定一系列图像,我们将比较它们的实际标签(文本输出的第一行)和模型预测(文本输出的第二行)。
def predict_ch3(net, test_iter, n=6):  #@save
    """预测标签(定义见第3章)。"""
    for X, y in test_iter:
        break
    trues = d2l.get_fashion_mnist_labels(y)
    preds = d2l.get_fashion_mnist_labels(net(X).argmax(axis=1))
    titles = [true + '\n' + pred for true, pred in zip(trues, preds)]
    d2l.show_images(X[0:n].reshape((n, 28, 28)), 1, n, titles=titles[0:n])

predict_ch3(net, test_iter)
简洁实现
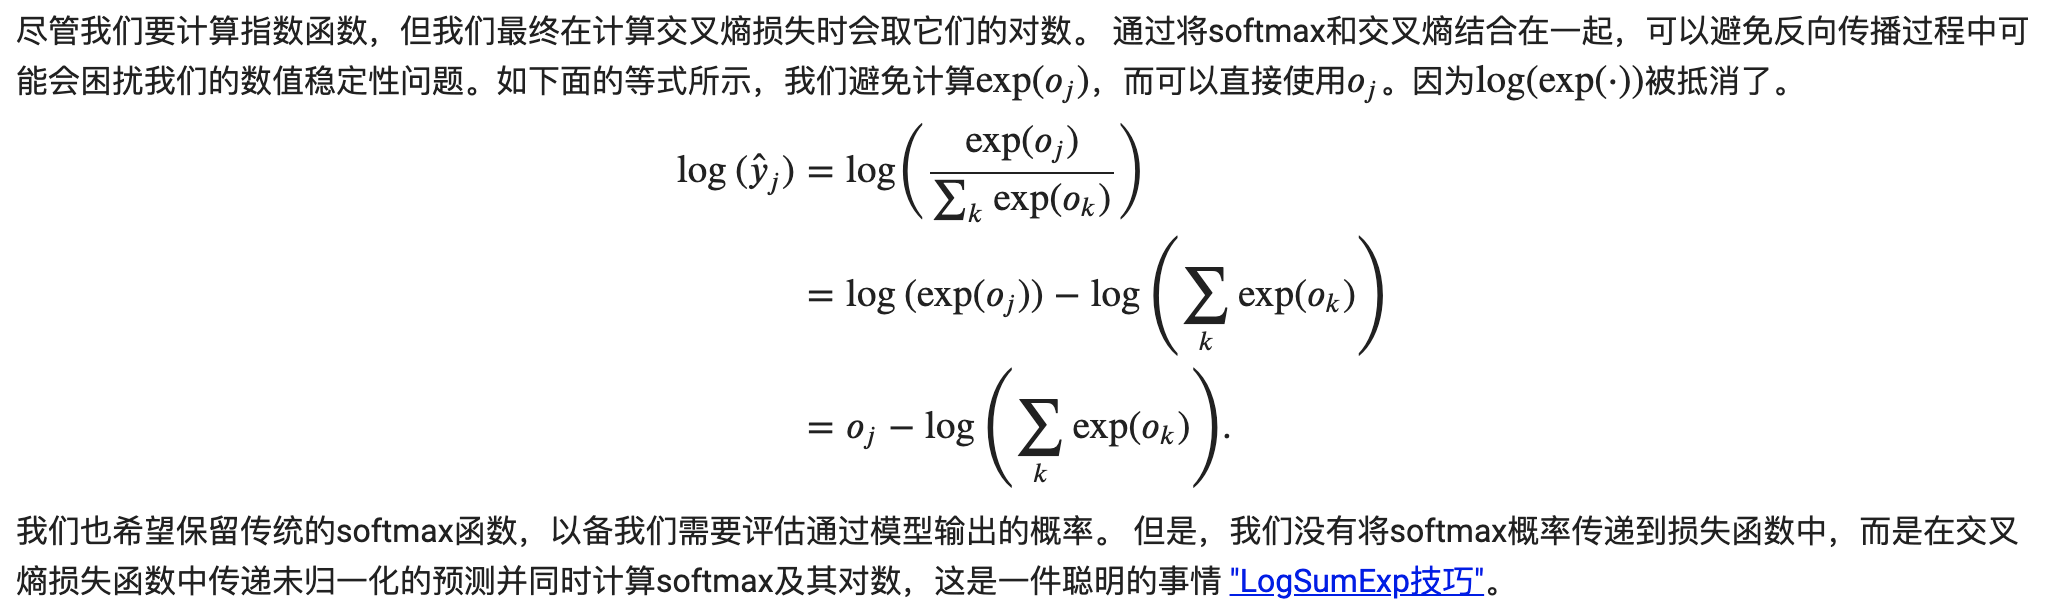
import torch
from torch import nn
from d2l import torch as d2l

batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)

# PyTorch不会隐式地调整输入的形状。
# 因此,我们定义了展平层(flatten)在线性层前调整网络输入的形状
net = nn.Sequential(nn.Flatten(), nn.Linear(784, 10))

def init_weights(m):
    if type(m) == nn.Linear:
        nn.init.normal_(m.weight, std=0.01)

net.apply(init_weights);

loss = nn.CrossEntropyLoss()

trainer = torch.optim.SGD(net.parameters(), lr=0.1)

num_epochs = 10
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)

若有收获,就点个赞吧
0 人点赞


