1. 高可用
在 HBase 中 HMaster 负责监控 HRegionServer 的生命周期,均衡 RegionServer 的负载,如果 HMaster 挂掉了,那么整个 HBase 集群将陷入不健康的状态,并且此时的工作状态并不会维持太久。所以 HBase 原生就自带支持对 HMaster 的高可用配置。
1.1 手动高可用
集群启动正常启动后,如果想要增加HMaster,只需要在目标机器启动HMaster即可
# 在目标机器启动HMaster$ ./hbase-daemon.sh start master
1.2 自动高可用
关闭 HBase 集群(如果没有开启则跳过此步)
$ ./stop-hbase.sh
在 conf 目录下创建 backup-masters 文件(文件名不能更换)
$ touch conf/backup-masters
在 backup-masters 文件中配置高可用 HMaster 节点
hadoop103
将backup-masters文件分发给所有机器
$ xsync.sh backup-masters
1.3 结果
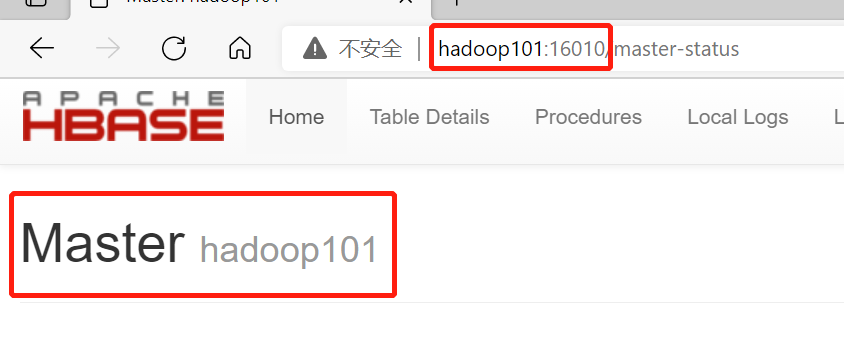
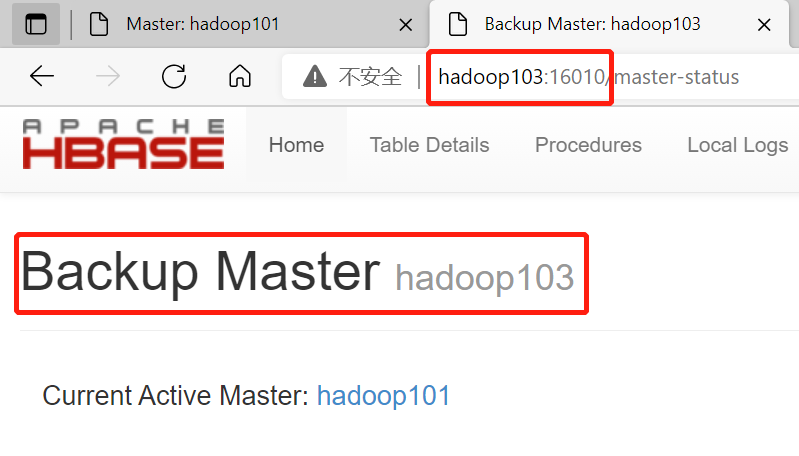
kill -9 杀掉原Master后,BackupMaster会自动升为Master,如果有多个BackupMaster,需要争抢资源选取leader(类似Kafka的Controller选主)
2. 预分区(重点,结合3.RowKey设计,解决数据倾斜)
2.1 预分区原则:
**集群量**:每台机器放**2-3个**region分区。例:3台机器,分区范围:6-9个,再大性能可能就会变差**数据量**:提前预估数据量,预估原则是未来半年到1年的数据量,目的是为了不让HBase后面再自己切分区,例: 预估100G的数据量,那预分区数量要>10个注意:
- 默认情况下每个分区是10G,如果没有做好预分区,分区写满10G后HBase会自己重新切分区
- 如果预估数据量失败,分区快满了但又不想让HBase自己重新分区,解决方案如下:
- 方案一:换一张新表入
- 方案二(不常用):如果数据量有一些,但也不是特别大的情况,可以手动切一次,动态扩展1-2个,如下:
// 不常用,数据量过大即将写满分区,可以手动切分某张表admin.split(TableName tableName,byte[] splitPoint);
2.2 设置分区键方法
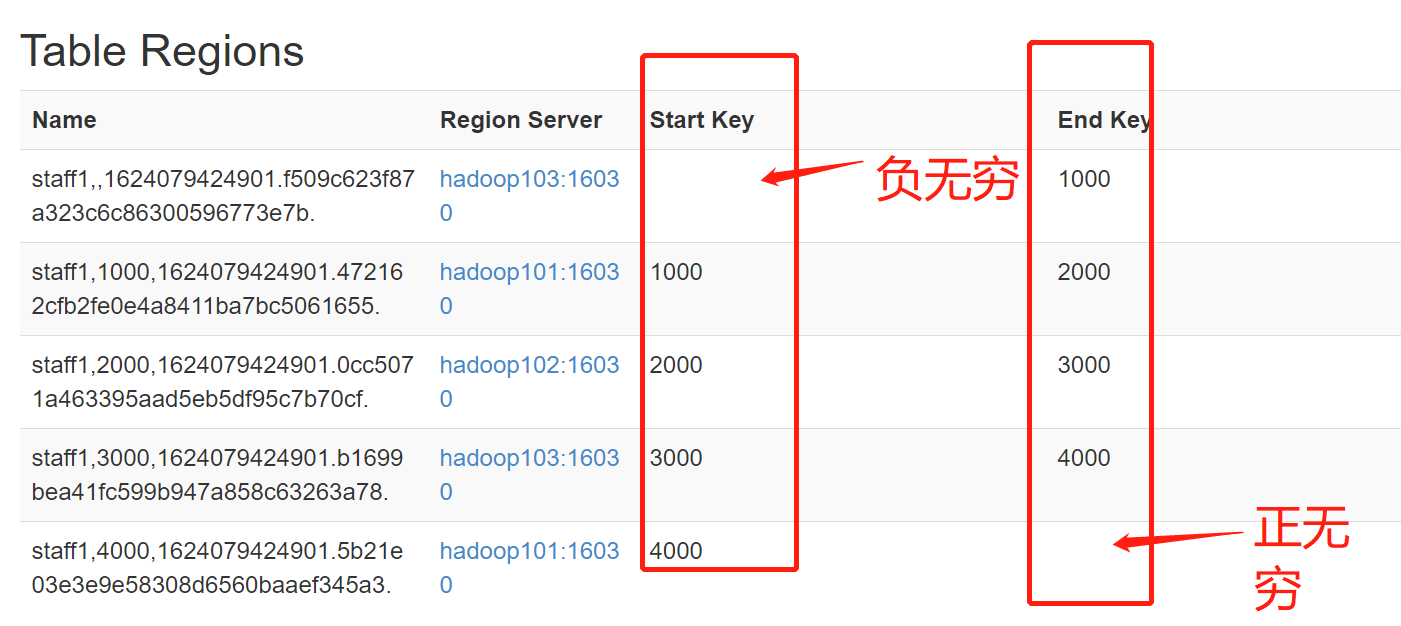
每一个 region 维护着一对分区键Start Key 与 End Key(下图),如果加入的数据某个符合Region 维护的分区键范围(注意:这里的范围比较,不是大小,而是根据位进行比较(从左至右依次比较,比数值+有比没有大),例:范围0-1000,1000-2000,2000-3000,而RowKey是200,根据每一位比较,200落在1000-2000这个分区内),则该数据交给这个 Region 维护。那么依照这个原则,可以将数据所要投放的分区提前大致的规划好,以提高 HBase 性能。
2.2.1 手动设定预分区(常用)
SPLITS指定每一个分区点
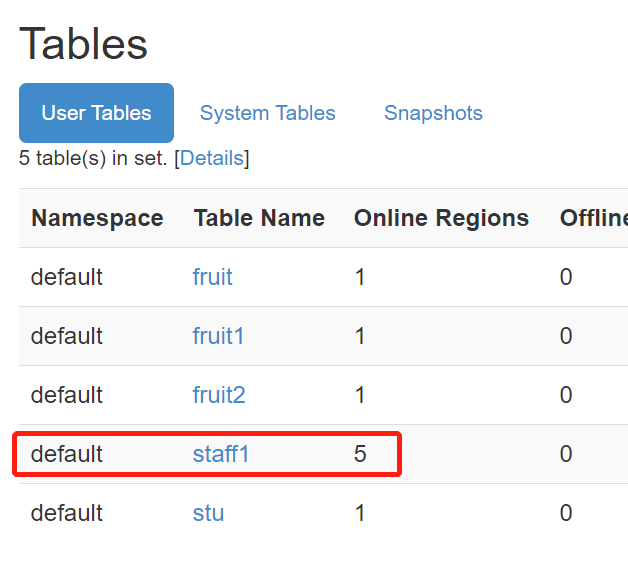
# 负无穷-1000,1000-2000,2000-3000,3000-4000,4000-正无穷Hbase> create 'staff1','info','partition1',SPLITS => ['1000','2000','3000','4000']
2.2.2 生成 16 进制序列预分区(不常用)
NUMREGIONS指定分区数,SPLITALGO指定16进制
create 'staff2','info','partition2',{NUMREGIONS => 15, SPLITALGO => 'HexStringSplit'}
2.2.3 按照文件中设置的规则预分区(常用)
按照文件中的内容进行分区,例:
文件内容
aaaabbbbccccdddd
执行
create 'staff3','partition3',SPLITS_FILE => '/opt/module/hbase/splits.txt'
2.2.4 使用 JavaAPI 创建预分区(常用)
// 自定义算法,产生一系列 hash 散列值存储在二维数组中// 例:[[1000],[2000],[3000],[4000]]byte[][] splitKeys = 某个散列值函数// 创建 HbaseAdmin 实例HBaseAdmin hAdmin = new HBaseAdmin(HbaseConfiguration.create());// 创建 HTableDescriptor 实例HTableDescriptor tableDesc = new HTableDescriptor(tableName);// 通过 HTableDescriptor 实例和散列值二维数组创建带有预分区的 Hbase 表hAdmin.createTable(tableDesc, splitKeys);
3. RowKey设计(重点,结合2. 预分区,解决数据倾斜)
3.1 设计原则
3.3.1 散列性
3.3.1.1 方式一———生成随机数、hash、散列值
比如:原 本 rowKey 为 1001 的 , SHA1 后 变 成 :dd01903921ea24941c26a48f2cec24e0bb0e8cc7原 本 rowKey 为 3001 的 , SHA1 后 变 成 :49042c54de64a1e9bf0b33e00245660ef92dc7bd原 本 rowKey 为 5001 的 , SHA1 后 变 成 :7b61dec07e02c188790670af43e717f0f46e8913在做此操作之前,一般会先选择从数据集中抽取样本,来决定什么样的 rowKey 来 Hash后作为每个分区的分区键。
3.3.1.2 方式二———字符串反转(一般选时间戳)
20210619000001 转成 1000004250710220210619000002 转成 20000042507102
3.3.1.3 方式三———字符串拼接
20210619000001_a12e20210619000001_93i7
3.3.2 唯一性
3.3.3 长度原则
一般在70-100位
3.2 案例
4. 内存优化
HBase 操作过程中需要大量的内存开销,毕竟 Table 是可以缓存在内存中的,一般会分配整个可用内存的 70%给 HBase 的 Java 堆。但是不建议分配非常大的堆内存,因为GC 过程持续太久会导致 RegionServer 处于长期不可用状态(RegionServer有一个flush阶段,40%阻塞写,内存过大,flush时间就长),一般 16~48G 内存就可以了,如果因为框架占用内存过高导致系统内存不足,框架一样会被系统服务拖死。
5. 基础优化
5.1 允许在 HDFS 的文件中追加内容
hdfs-site.xml、hbase-site.xml
属性:dfs.support.append解释:默认值为 true。开启 HDFS 追加同步,可以优秀的配合 HBase 的数据同步和持久化。
5.2 优化 DataNode 允许的最大文件打开数
hdfs-site.xml
属性:dfs.datanode.max.transfer.threads解释:HBase 一般都会同一时间操作大量的文件,根据集群的数量和规模以及数据动作,设置为4096 或者更高。默认值:4096
5.3 优化延迟高的数据操作的等待时间
hdfs-site.xml
属性:dfs.image.transfer.timeout解释:如果对于某一次数据操作来讲,延迟非常高,socket 需要等待更长的时间,建议把该值设置为更大的值(默认 60000 毫秒),以确保 socket 不会被 timeout 掉。
5.4 优化数据的写入效率
mapred-site.xml
属性:mapreduce.map.output.compressmapreduce.map.output.compress.codec解释:开启这两个数据可以大大提高文件的写入效率,减少写入时间。第一个属性值修改为true,第二个属性值修改为:org.apache.hadoop.io.compress.GzipCodec 或者其他压缩方式。
5.5 设置 RPC 监听数量
hbase-site.xml
属性:Hbase.regionserver.handler.count解释:默认值为 30,用于指定 RPC 监听的数量,可以根据客户端的请求数进行调整,读写请求较多时,增加此值。
5.6 优化 HStore 文件大小
hbase-site.xml
属性:hbase.hregion.max.filesize解释:默认值 10737418240(10GB),如果需要运行 HBase 的 MR 任务,可以减小此值,因为一个 region 对应一个 map 任务,如果单个 region 过大,会导致 map 任务执行时间过长。该值的意思就是,如果 HFile 的大小达到这个数值,则这个 region 会被切分为两个 Hfile。
5.7 优化 HBase 客户端缓存
hbase-site.xml
属性:hbase.client.write.buffer解释:用于指定 Hbase 客户端缓存,增大该值可以减少 RPC 调用次数,但是会消耗更多内存,反之则反之。一般需要设定一定的缓存大小,以达到减少 RPC 次数的目的。
5.8 指定 scan.next 扫描 HBase 所获取的行数
hbase-site.xml
属性:hbase.client.scanner.caching解释:用于指定 scan.next 方法获取的默认行数,值越大,消耗内存越大。
5.9 flush、compact、split 机制
当 MemStore 达到阈值,将 Memstore 中的数据 Flush 进 Storefile;compact 机制则是把 flush出来的小文件合并成大的 Storefile 文件。split 则是当 Region 达到阈值,会把过大的 Region一分为二。
涉及属性:
# 128M 就是 Memstore 的默认阈值hbase.hregion.memstore.flush.size:134217728
即:这个参数的作用是当单个 HRegion 内所有的 Memstore 大小总和超过指定值时,flush该 HRegion 的所有 memstore。RegionServer 的 flush 是通过将请求添加一个队列,模拟生产消费模型来异步处理的。那这里就有一个问题,当队列来不及消费,产生大量积压请求时,可能会导致内存陡增,最坏的情况是触发 OOM。
hbase.regionserver.global.memstore.upperLimit:0.4hbase.regionserver.global.memstore.lowerLimit:0.38
即:当 MemStore 使用内存总量达到hbase.regionserver.global.memstore.upperLimit 指定值时,将会有多个 MemStores flush 到文件中,MemStore flush 顺序是按照大小降序执行的,直到刷新到 MemStore 使用内存略小于 lowerLimit

若有收获,就点个赞吧
0 人点赞


