机器学习的优化目标
通过进行某种方式的训练,来最小化损失函数loss(x)
个模型的损失函数: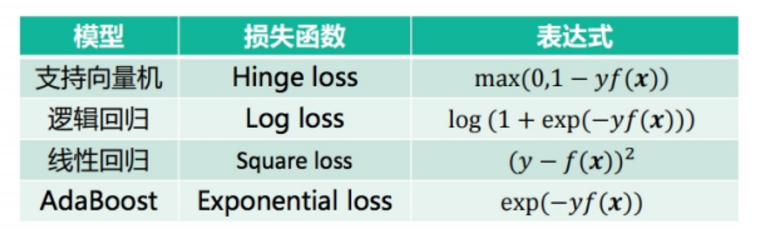
随机梯度下降(SGD)
梯度下降
batch梯度下降:使用全部训练集样本,计算代价太高
mini-batch梯度下降:随机采样一个子集
mini-batch是SGD的推广,通常所说SGD即是mini-batch,设定学习率很重要,随着迭代次数的增加降低学习率
设定学习率的方法:
线性衰减,然后保持为常数
开始为常数,当训练误差不在变化或变化非常小时,缩小为原来的1/10或1/2.
所遇挑战:病态条件、局部最小、鞍点、平台、梯度爆炸与悬崖
学习率是非常重要的一个超参数,甚至能左右模型的好坏,但是,学习率也是非常难确定取值的,因为它不是靠学习而来,而是往往由人的经验来设置它。所以考虑是否可以有优化算法,自适应的调节学习率的大小。
动量法
主要是为了解决Hessian矩阵病态条件问题(直观上讲就是梯度高度敏感于参数空间的某些方向)的
自适应学习率方法
基于小批量的训练数据的性能更好的自适应学习率算法:
AdaGrad:能独立地适应所有模型参数的学习率,当参数损失偏导值比较大时,有一个较大的学习率;当参数的损失偏导值较小时,有一个较小的学习率。
RMSProp:在AdaGrad算法的基础上经过修改得到。RMSProp算法采用了指数衰减平均的方式淡化遥远过去的历史对当前步骤参数更新量的影响。RMSProp引入了一个新的参数用于控制历史梯度值的衰减速率。
Newterov动量法:受Nesterov加速梯度算法NAG的启发,梯度计算在施加当前速度之后,在动量法基础上添加了一校正因子。
Adam:同时考虑栋梁和学习率自适应。
二阶方法
常见的最优化器,如 Adam、AdaGrad、SGD+Momentum 等,都是一阶的。但是二阶梯度的收敛速度相比它们就快了太多。
如果我们希望找到「谷底」,那么沿着坡度一步一步往下走就行了。对于机器学习来说,「谷底」就是最优解,一步一步就是迭代过程。之前,我们采用一阶梯度,也就是坡度的陡和缓来确定步子要迈多大。而当坡度是有变化的,即逐渐变陡或变缓,根据当前坡度来确定步子大小就有一些问题。
之前我们可以慢慢多走几步,就能根据坡度的变化直接调整。现在如果能用二阶梯度,相当于梯度的梯度,那么也就知道坡度变化的趋势,因此一步就能走到位。所以二阶梯度本质上比一阶梯度多出一些信息,模型收敛也就会更快。
如何选择优化算法
在大数据场景(样本量大,特征维数大),一阶方法最实用(随机梯度)
自适应学习率算法族(以RMSProp为代表)表现相当鲁棒
Adam可能时最佳选择
使用者对算法的熟悉程度,以便调节超参数。

若有收获,就点个赞吧
0 人点赞


