- 四层模型:网络连接层、服务层、存储引擎层、系统文件层
- 日志文件
- 错误日志
- 通用查询
- binlog
- 慢查询日志
- 数据文件
- frm
- ibd(独享表空间)
- SQL运行机制
- 缓存
- MySQL8把查询缓存去掉了?
- 原因:尽管目的是为了提高性能,可伸缩性差,多核条件下不好扩展,性能瓶颈;5.6就默认禁用了
- 网上博客说:容易失效,容易更新
- MySQL8把查询缓存去掉了?
- InnoDB和MyISAM引擎对比(高频面试题)
- 事务和外键: 支持 / 不支持
- 锁机制: 行级锁,基于索引加锁; 表锁
- 索引结构: 聚集索引 ; 非聚集索引
- 并发处理能力: 表锁,写并发率低,读写阻塞;与隔离级别有关,MVCC支持高并发
- 存储文件: .frm 和 .ibd ; .frm MYD .MYI
- 内存模型:
- 读缓存
- 写缓存
- 自适应hash
- log buffer
- 磁盘模型
- 写盘时机: 事务提交 or 每秒 or 其他; 不是立即写
- 预写日志(WAL,Write Ahead Log)是关系型数据库中用于实现事务性和持久性的一系列技术。简单来说就是,做一个操作之前先讲这件事情记录下来。
- 线程模型
- master
- IO
- purge: 清理undo
- pageCleaner: 在那个数据刷盘
- 数据文件行格式(ibd的格式)
- A格式
- B格式: 支持压缩、增强型长列数据
- *undo、redo
- innodb的功能
- undo: 撤销回滚; redo: 恢复
- 平时执行,要么undo;要么redo
- 与事务关系很大
- 减少IO操作
- binlog
- mysql的功能
- 主从复制时候; 数据恢复时候开启
- 记录模式:ROW(数据行;常用)、STATEMENT(语句)、MIXED(两种混合)
- mysqlbinlog查看
- redo和binlog区别
- 顺序
- 事务 commit
- 写redo
- 写binlog
- redo提交
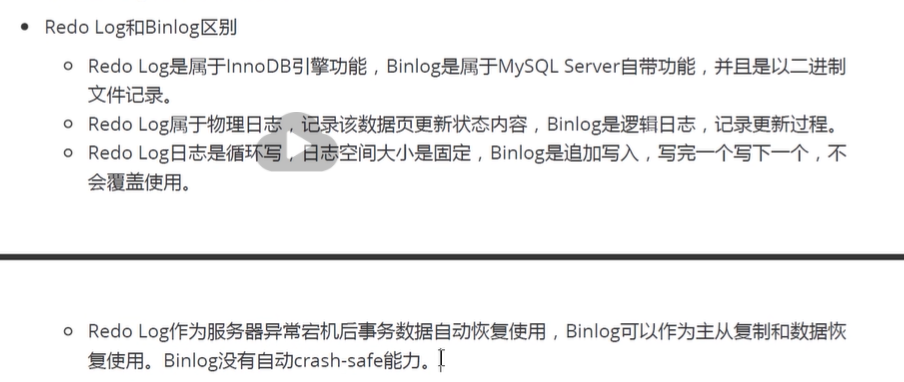
- 提问:写了update以后,binlog和redo哪个先写?
- 猜测:没提交了,肯定redo
- 提交了才能写bin吧
- 索引按照功能分/ 类型
- 普通索引
- 唯一索引
- 主键索引
- 组合索引
- 全文索引
- 索引结构 / 索引原理
- HASH
- B+树
- B-树 和 B树 是一回事
- B-每个节点存了数据;B+树只有叶子节点
- 在最底下有next链接

- 聚簇索引
- 数据存在叶子节点上
- 辅助索引
- 非聚簇: 内部字段值、主键值
- 补充:Tomcat的并发量
- 非聚簇: 内部字段值、主键值
- 最简单的业务:1000
- *explain分析:
- 普通程序员需要提升
- ID相同上到下;ID先大后小
- type: ALL index(基于索引的全表索引) range
- Extra
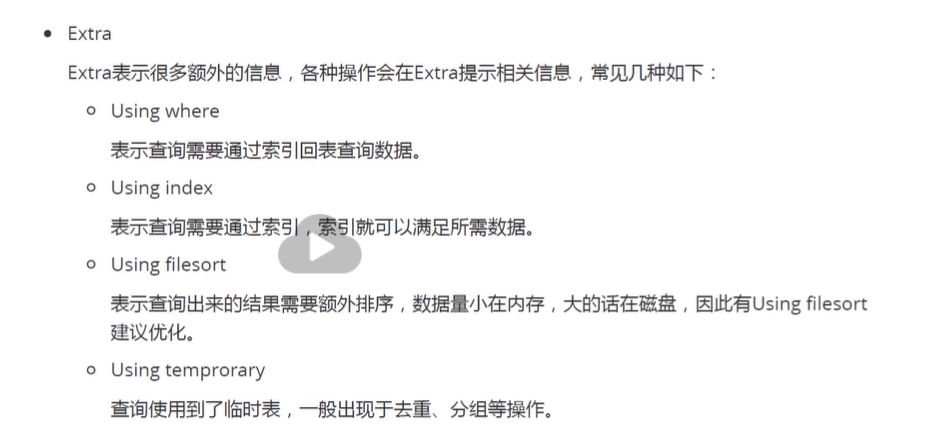
- *回表查询
- *覆盖索引
- *最左前缀原则
- 不建议使用null, 建议not null
- 索引与排序
- 出现 using filesort 出现额外排序
- 查询优化
- 慢查询定位
- 慢查询优化:
- explain查看索引
- 提高过滤性
- 慢查询原因总结:
- 全表扫描
- 全索引扫描
- 索引过滤性不好
- 频繁回表: 尽量少使用select *
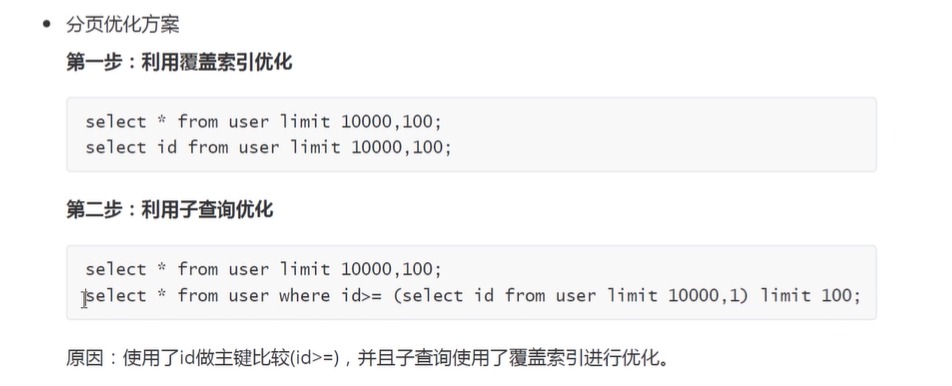
- 分页优化
事务和锁
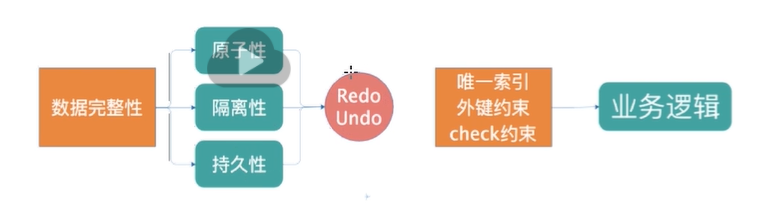
- ACID:
- 原子性;
- 持久性;
- 隔离性;
- 一致性
- 并发事务问题: 脏赌、不可重复读、幻读、更新丢失
- *读写锁(怎么处理读写)
- MVCC: 解锁读和写问题,没有使用锁就能解决读写并发的问题
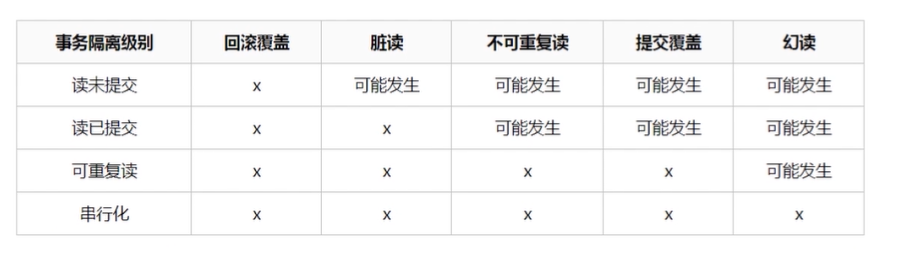
- 锁的分类
- 还有很多其他的,不用管
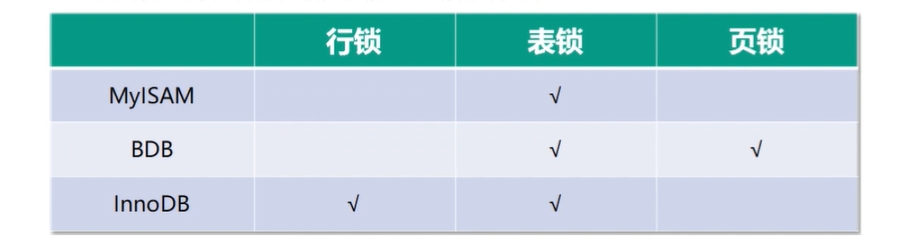
- InnoDB行锁原理
- 通过对索引上的数据进行加锁
- 主键是在数据上加锁;其他是索引树上加锁
- 非唯一健: 锁间隙
- 无索引:锁全表;容易导致死锁

- 乐观锁
- 业务执行
- 版本字段
- 时间戳
- 死锁与解决方案
- 原因是互相锁表
- 查看死锁日志:show engin innodb status
- 查看锁状态数量:
- show status like ‘innodb_row_lock’
-
系统设计和集群架构
保证高可用的方法是冗余
- 架构模式
- 主从模式
- 读写分离;写操作高可用自行处理
- 双主模式:
- 很尴尬、太容易冲突了,;就没人用
- 如果写瓶颈,直接分库分表
- 建议改成主备模式
- 主从模式
- 如何扩展:
- 主从
- 分库分表
- 主从复制
- 传统的主从复制
- 开启binlog、relay_log和server_id
- 半同步复制: 会有响应
- 基于GTID的主从复制
- 并行复制
- 读写分离
- 传统的主从复制
- 主从延迟
- 写后先让读主库,过一会再读从库
- 二次查询: 先读从;读不到再读主;需要控制安全
- 特殊处理:重要数据只在主读
- 读写分离
- 程序端控制
- 服务端代理
- MHA集群架构:一主多从、主要方案;
- 分库分表
- 拆分方式
- 水平拆分
- 垂直拆分
- 主键策略
- UUID
- SNOWFLAKE
- 数据库ID表
- 分片策略
- 基于范围
- 哈希取模
- 一致性hash(mycat,其他没见到)
- 扩容方案
- 平滑扩容(不停机,但是需要翻倍)
- 停机扩容
- 拆分方式
MySQL优化
- 硬件
- CPU
- 内存
- 硬盘
- 网络
- 数据库配置
- 系统全局内存参数
- 线程全局内存参数
- 各种buffer_size;cache_szie
前面是运维级的,后面是开发的
- 表设计优化
- 自增主键/雪花算法
- tiny代替enum
- 禁止字段null
- 时间字段使用datetime
- 使用尽可能小的存储类型
- varchar也不要使用过长的声明
- 减少宽表的设计(binlog)
- 少使用text等大字段
- 避免大SQL、大批量、复杂计算
- SQL语句优化
- explain分析
- 索引优化: 别回表了
架构优化
- 主从架构
- 读写分离
- 分库分表
- 订单库表数量控制在2000以内
- 单标分表控制在1024以内
- 单标字段5-以内
- 开发规范
- 单标查询
- 少量join
- 禁止大事务操作
- 禁止视图、触发器等
- 避免重复索引
- 不在有限的数据上索引
- 不使用select *
- 减少数据库访问
- 本地缓存
- 分布式缓存
- 主从架构
多表查询的优化
- explain分析
- 记录少的连大的表
- 索引使用情况
- where、group by条件前置,然后再join
- ps.连接缓存池大小
SQL语句的执行过程
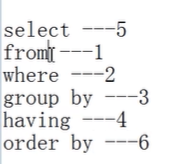
查询表链接算法select @@optimizer_switch;
A: 1000
B: 20000
A join B
join三种: nestedloop;hash;merge
NestedLoop JOIN : 两个嵌套
Block Nested-Loop Join: 一个缓存块的去连下
- MHA高可用搭建起来,实现了主故障,从切换为主;如果主修复了,如何再成为主?
从库再切换成主库时候,在MHA日志中会有记录,哪个从库变成主库了。
旧的主库修好了,可以将旧主库挂到新主库上做从库。
MHA主从切换分为:故障切换和在线切换
- 索引下沉
- https://zhuanlan.zhihu.com/p/121084592
- 5.6开始; 本来是name like ‘说的%’ and age = 15; 会不会遍历索引时候判断age的区别;
- 索引(name, age)
- 索引为什么不用其他树: 二叉树、红黑树
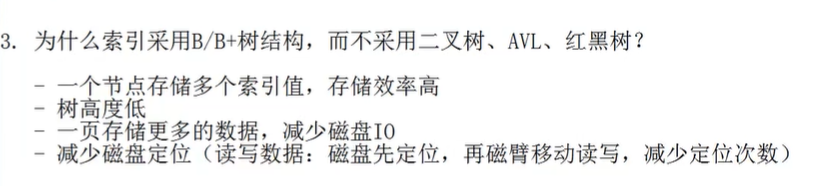 - 为什么不使用hash索引
- 不能范围;适合等值
- 如何做查询优化?
- explain
- 重点查看type 、 range 、key、rows
- using filesort 二次排序
- 是否范围?左模糊查询?隐式转换
- show profiles 查看执行时间
- 覆盖索引
- 慢查询定位分析
- 分页查询
- or 改成 union all
- 不写什么 ? 太low
- explain
- InnoDB引擎锁原理
- 行锁: 对索引数据
- 并发处理
- MVCC机制:多版本控制
- 通过undo log,实现快照读
- RC读当前;RR读第一次的快照
- 锁机制
- MVCC机制:多版本控制
- 死锁
- 处理方法
- 查询死锁信息,然后杀死进程
- 处理方法

若有收获,就点个赞吧
0 人点赞


