- 整体架构
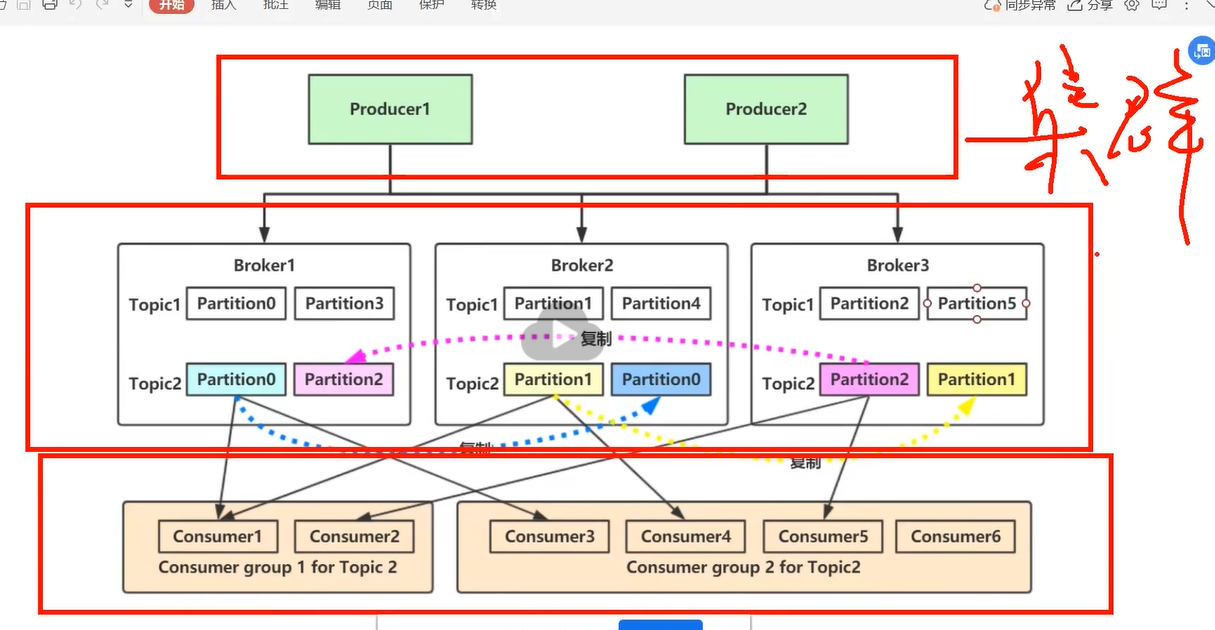
- 没有推荐系统,不能成为互联网公司
- 类似京东公司,每一个页面操作都要埋点,实现闭环
- 双十一 21秒PB; 在线计算、离线计算
- kafka设计思想:
- 生产者扩展
- 消费者扩展
- broker扩展
- 核心:topic
- 主题划分分区,为了横向扩展
- 通过副本实现高可用
- AR = ISR + OSR
- AR: 所有副本
- ISR: 同步副本 ; 保持一定同步
- OSR: 非同步副本
- 没有过半机制
- 剩一个就可以升级
- 过半机制: 网络繁忙、减轻网络负担
- zookeeper最多一个node里面有1M
- HW和LEO
- 高水位:ISR里面最低的那一个: 整体的长度
- LEO: 下一条写入的偏移量: 本broker的长度
- 生产流程
- 拦截器;序列化器;分区器
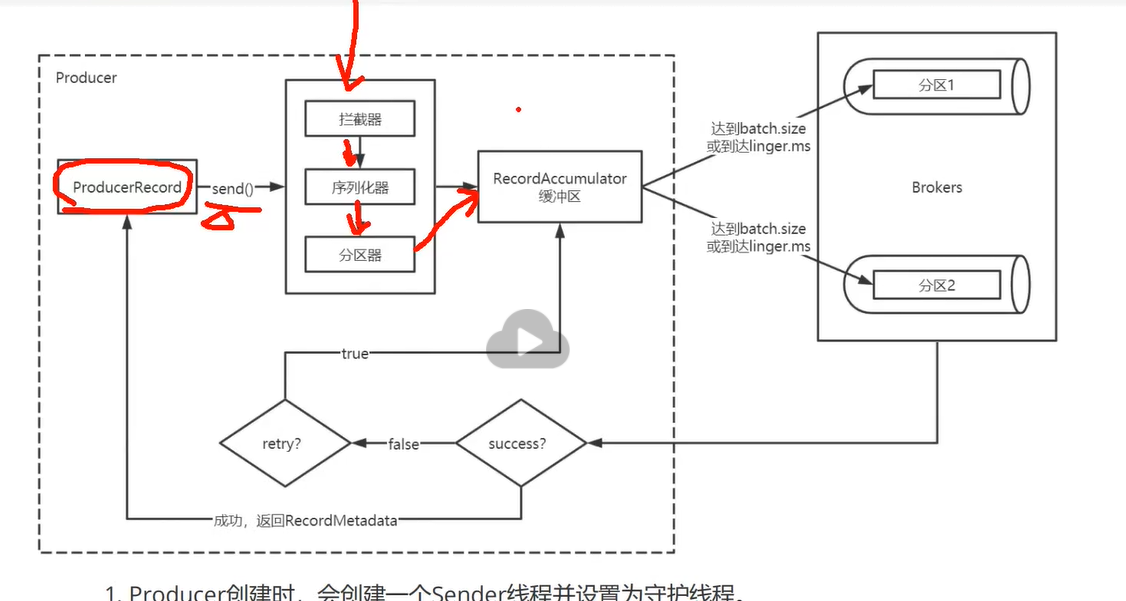
- 分区可以压缩分区;批处理
- acks
- -1: all ; 所有ISR确认
- 0: 不需要确认 ; 用户收集
- 1: leader分区确认;
- 大数据允许数据不完整
- 消费者和消费组
- 同一消费组只有一个消费进度
- 基于这点,一个topic最多只能被同一个组的一个消费者消费
- 消费组再平衡问题
- 基于这点,一个topic最多只能被同一个组的一个消费者消费
- topic或者消费者变化
- 消费者偏移量问题
- 存在哪里? 存在kafka的offset主题里面; 老版本是zk里面,zk不适合高并发读写
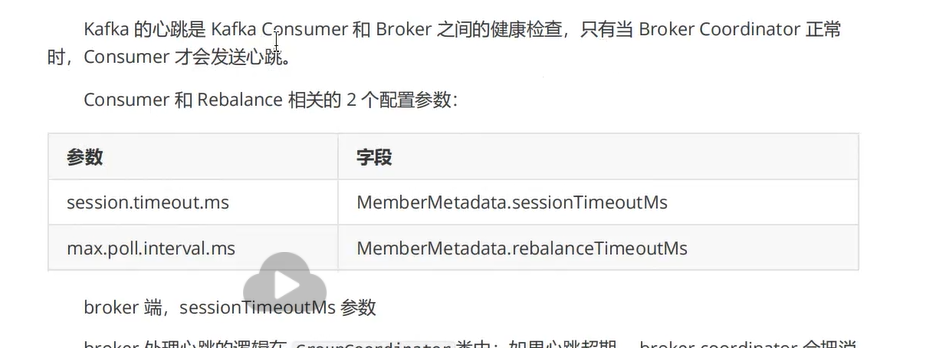
- 消费组的心跳机制
- 消费者和分区有心跳
- 一旦消费者变化需要再平衡
- 有一个broker专门用来作为消费者协调器
- 拦截器
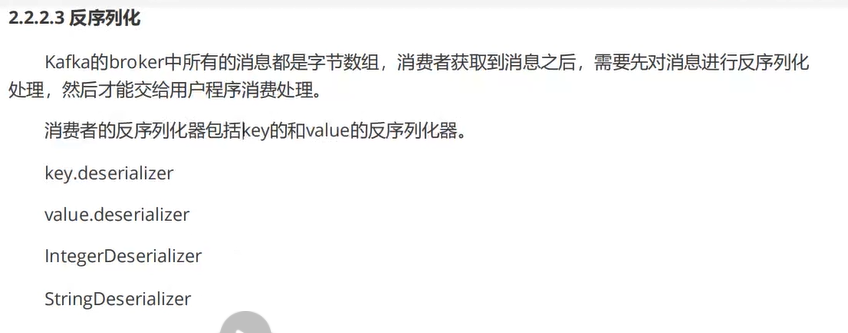
- 收到消息后需要反序列化
- 消息只有拉取方式
- 考虑背景: 大数据
- 如果有推,会很轻松的压垮消费者
- 更加方便控制数据流
- rocket模拟了一个推模式: 每次拉取玩就发送一个请求
- 位移提交
- 自动提交
- 每隔5秒
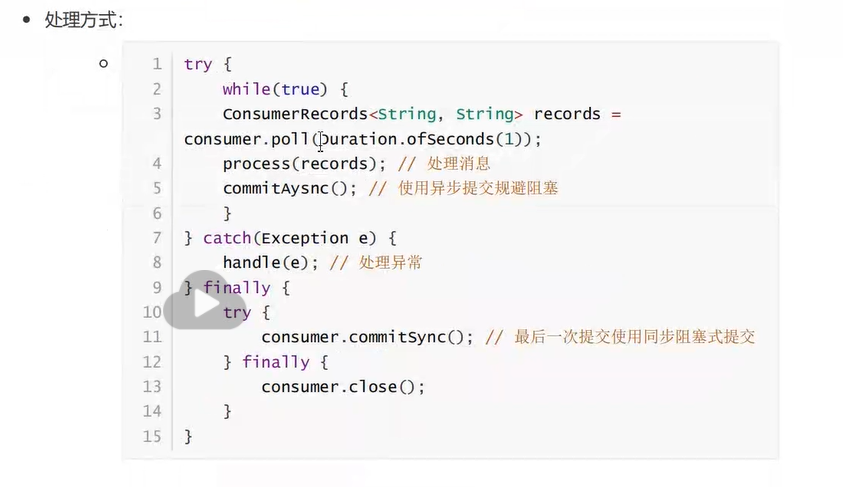
- 手动
- 同步:
- 消息失败可以控制不提交
- 等确认后再继续,会很慢
- 异步:
- 为了提高效率
- 同步:
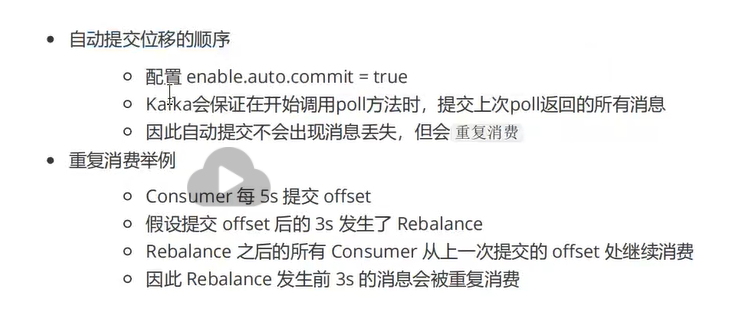
- 异步提交最佳实践
- 消费者有API可以手动修改偏移量: seek
- 可以手动指定分区吗?
- 自定义分片策略:可以手动指定分区

- 如何指定分区:
- API里面有分区参数
- KafkaAdminClient
- 管理分区
- 偏移量管理
- 一个offset主题里面
- 早期用的zk
- 选举leader
- 在zk上维护了ISR,随机选一个
- ISR都没了,可以配置
- 等待ISR;
- 找一个OSR;消息可能流失
- 分区分配策略
- Range: 有偏向
- 轮训: 有偏向
- sticky: 根据上一次分配;更均衡
- 日志文件
- .index
- .log
- .timeindex
- 索引分为: 偏移量和时间戳
- 不是每一条,而是每4k创建一个
- 清理策略:
- 删除: 默认七天
- 压缩: 只留下某一个key最新的数据
- 磁盘存储
- 零拷贝
- 面试问的比较多
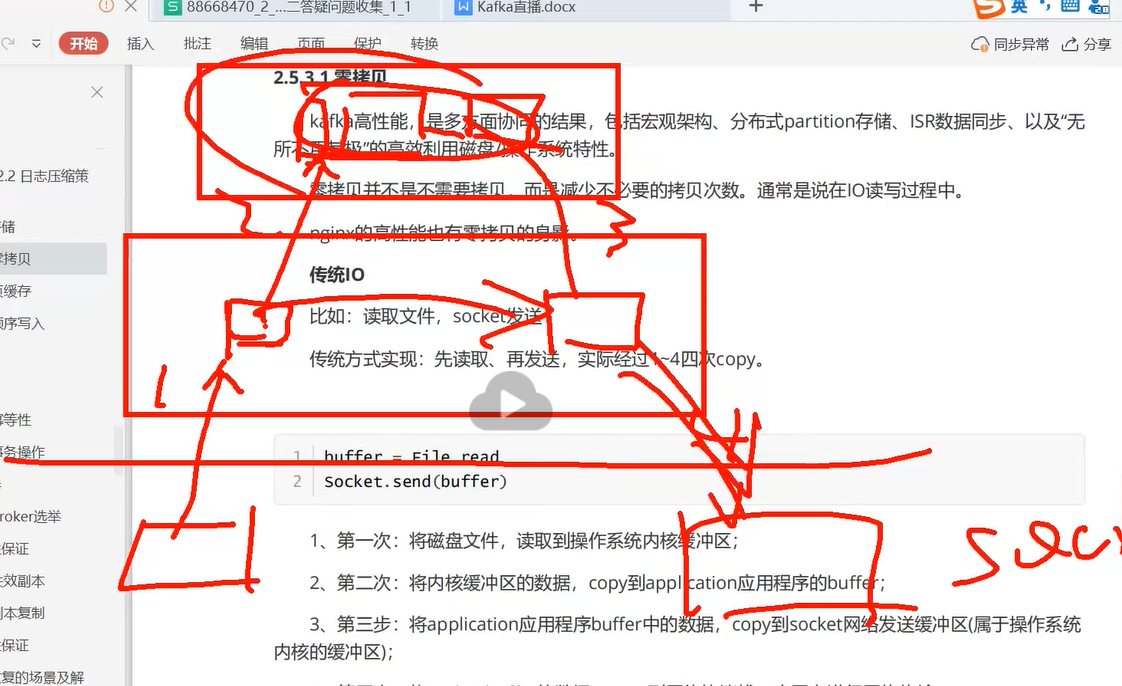
- broker内部直接发出去,不需要拷贝到JVM里面
- 页缓存
- 操作系统不用拷贝
- 顺序写
- 批处理
- 零拷贝
- 事务
- 两次提交
- 失效副本: ISR变成OSR
- 延时、重试自身不支持;用的不多
- 集群没啥好说的
- zookeeper作用
- 元信息存储
- consumer的消费状态
- group的管理
- 选举和检测broker存活
- kefka支持精确一次;最多一次;最少一次

若有收获,就点个赞吧
0 人点赞


