1.主从复制过程
MySQl主从复制:
- 原理:将主服务器的binlog日志复制到从服务器上执行一遍,达到主从数据的一致状态。
- 过程:从库开启一个I/O线程,向主库请求Binlog日志。主节点开启一个binlog dump线程,检查自己的二进制日志,并发送给从节点;从库将接收到的数据保存到中继日志(Relay log)中,另外开启一个SQL线程,把Relay中的操作在自身机器上执行一遍
- 优点:
- 作为备用数据库,并且不影响业务
- 可做读写分离,一个写库,一个或多个读库,在不同的服务器上,充分发挥服务器和数据库的性能,但要保证数据的一致性
binlog记录格式:statement、row、mixed
基于语句statement的复制、基于行row的复制、基于语句和行(mix)的复制。其中基于row的复制方式更能保证主从库数据的一致性,但日志量较大,在设置时考虑磁盘的空间问题
2.数据一致性问题
“主从复制有延时”,这个延时期间读取从库,可能读到不一致的数据。
- 缓存记录写key法:
在cache里记录哪些记录发生过的写请求,来路由读主库还是读从库
- 异步复制:
在异步复制中,主库执行完操作后,写入binlog日志后,就返回客户端,这一动作就结束了,并不会验证从库有没有收到,完不完整,所以这样可能会造成数据的不一致。
半同步复制:
当主库每提交一个事务后,不会立即返回,而是等待其中一个从库接收到Binlog并成功写入Relay-log中才返回客户端,通过一份在主库的Binlog,另一份在其中一个从库的Relay-log,可以保证了数据的安全性和一致性。
全同步复制:
指当主库执行完一个事务,所有的从库都执行了该事务才返回给客户端。因为需要等待所有从库执行完该事务才能返回,所以全同步复制的性能必然会收到严重的影响。
3.集群架构
- Keepalived + VIP + MySQL 主从/双主
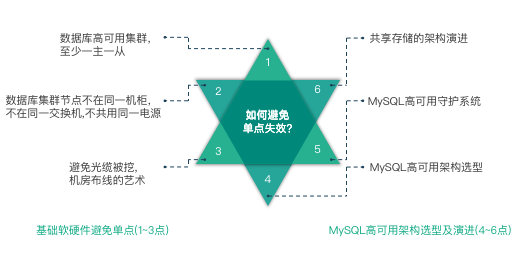
当写节点 Master db1出现故障时,由MMM Monitor 或 Keepalived 触发切换脚本,将 VIP 漂移到可用的 Master db2 上。当出现网络抖动或网络分区时,MMM Monitor会误判,严重时来回切换写VIP 导致集群双写,当数据复制延迟时,应用程序会出现数据错乱或数据冲突的故障。有效避免单点失效的架构就是采用共享存储,单点故障切换可以通过分布式哨兵系统监控。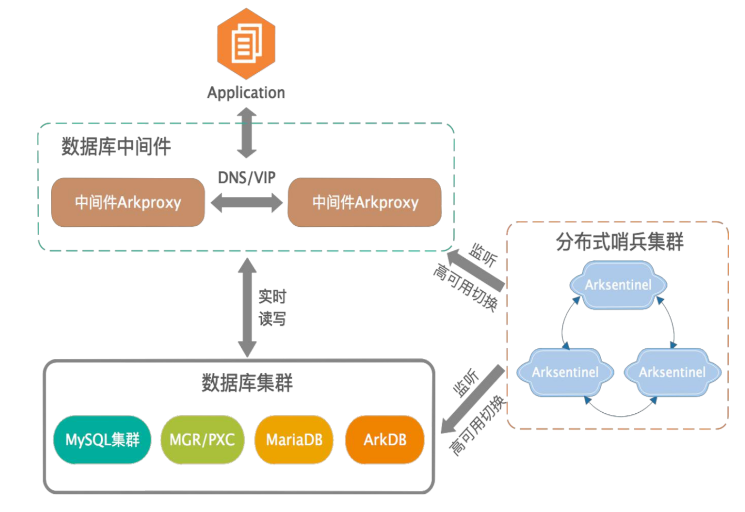
- 架构选型:MMM 集群 -> MHA集群 -> MHA+Arksentinel。
4.如何进行分库分表
分表用户id进行分表,每个表控制在300万数据。 分库根据业务场景和地域分库,每个库并发不超过2000
4.1.Sharding-jdbc
这种 client 层方案的优点在于不用部署,运维成本低,不需要代理层的二次转发请求,性能很高,但是各个系统都需要耦合Sharding-jdbc的依赖,升级比较麻烦
4.2.Mycat
这种 proxy 层方案的缺点在于需要部署,自己运维一套中间件,运维成本高,但是好处在于对于各个项目是透明的,如果遇到升级之类的都是自己中间件那里搞就行了
4.3.水平拆分
一个表放到多个库,分担高并发,加快查询速度
- id保证业务在关联多张表时可以在同一库上操作
- range方便扩容和数据统计
- hash可以使得数据更加平均
4.4.垂直拆分
一个表拆成多个表,可以将一些冷数据拆分到冗余库中 不是写瓶颈优先进行分表
- 分库数据间的数据无法再通过数据库直接查询了。会产生深分页的问题
- 分库越多,出现问题的可能性越大,维护成本也变得更高。
- 分库后无法保障跨库间事务,只能借助其他中间件实现最终一致性。
4.5.分库首先需考虑满足业务最核心的场景
- 订单数据按用户分库,可以提升用户的全流程体验
- 超级客户导致数据倾斜可以使用最细粒度唯一标识进行hash拆分
- 按照最细粒度如订单号拆分以后,数据库就无法进行单库排重了
三个问题:
富查询:采用分库分表之后,如何满足跨越分库的查询?使用ES的宽表
借助分库网关+分库业务虽然能够实现多维度查询的能力,但整体上性能不佳且对正常的写入请求有一定的影响。业界应对多维度实时查询的最常见方式便是借助 ElasticSearch
数据倾斜:数据分库基础上再进行分表
分布式事务:跨多库的修改及多个微服务间的写操作导致的分布式事务问题?
深分页问题:按游标查询,或者叫每次查询都带上上一次查询经过排序后的最大ID
5.如何生成自增的id主键
- 使用redis可以
- 并发不高可以单独起一个服务,生成自增id
- 设置数据库step自增步长可以支撑水平伸缩
- UUID适合文件名、编号,但是不适合做主键
- snowflake雪花算法,综合了41时间(ms)、10机器、12序列号(ms内自增)

若有收获,就点个赞吧
0 人点赞


