1.什么是三级缓存?
IoC,主要是将对象的创建、管理都交给了 Spring 来管理,能够解决对象之间的耦合问题,对开发人员来说也是省时省力的。
AOP,主要是在不改变原有业务逻辑情况下,增强横切逻辑代码,也是解耦合,避免横切逻辑代码重复;也是对 OOP 的延续、补充。
Spring底层管理bean的实例化方式是通过反射实现的。而实例化的方式有很多种,使用构造器实例化的方式是不能解决循环依赖的,因为构造器实例化必须保证参数已经被实例化过,容易形成死循环。例如:A与B构成循环依赖。B b = new B(a),A a = new A(b)。无法解决循环依赖。所以Spring解决循环依赖的方式是通过setter方式。思路:
- A a = new A(),说明 A 只是实例化,还未初始化
- 同理,B b = new B() 也只是实例化,并未初始化
- a.setB(b);, 对 a 的属性赋值,完成 a 的初始化
- b.setA(a);, 对 b 的属性赋值,完成 b 的初始化
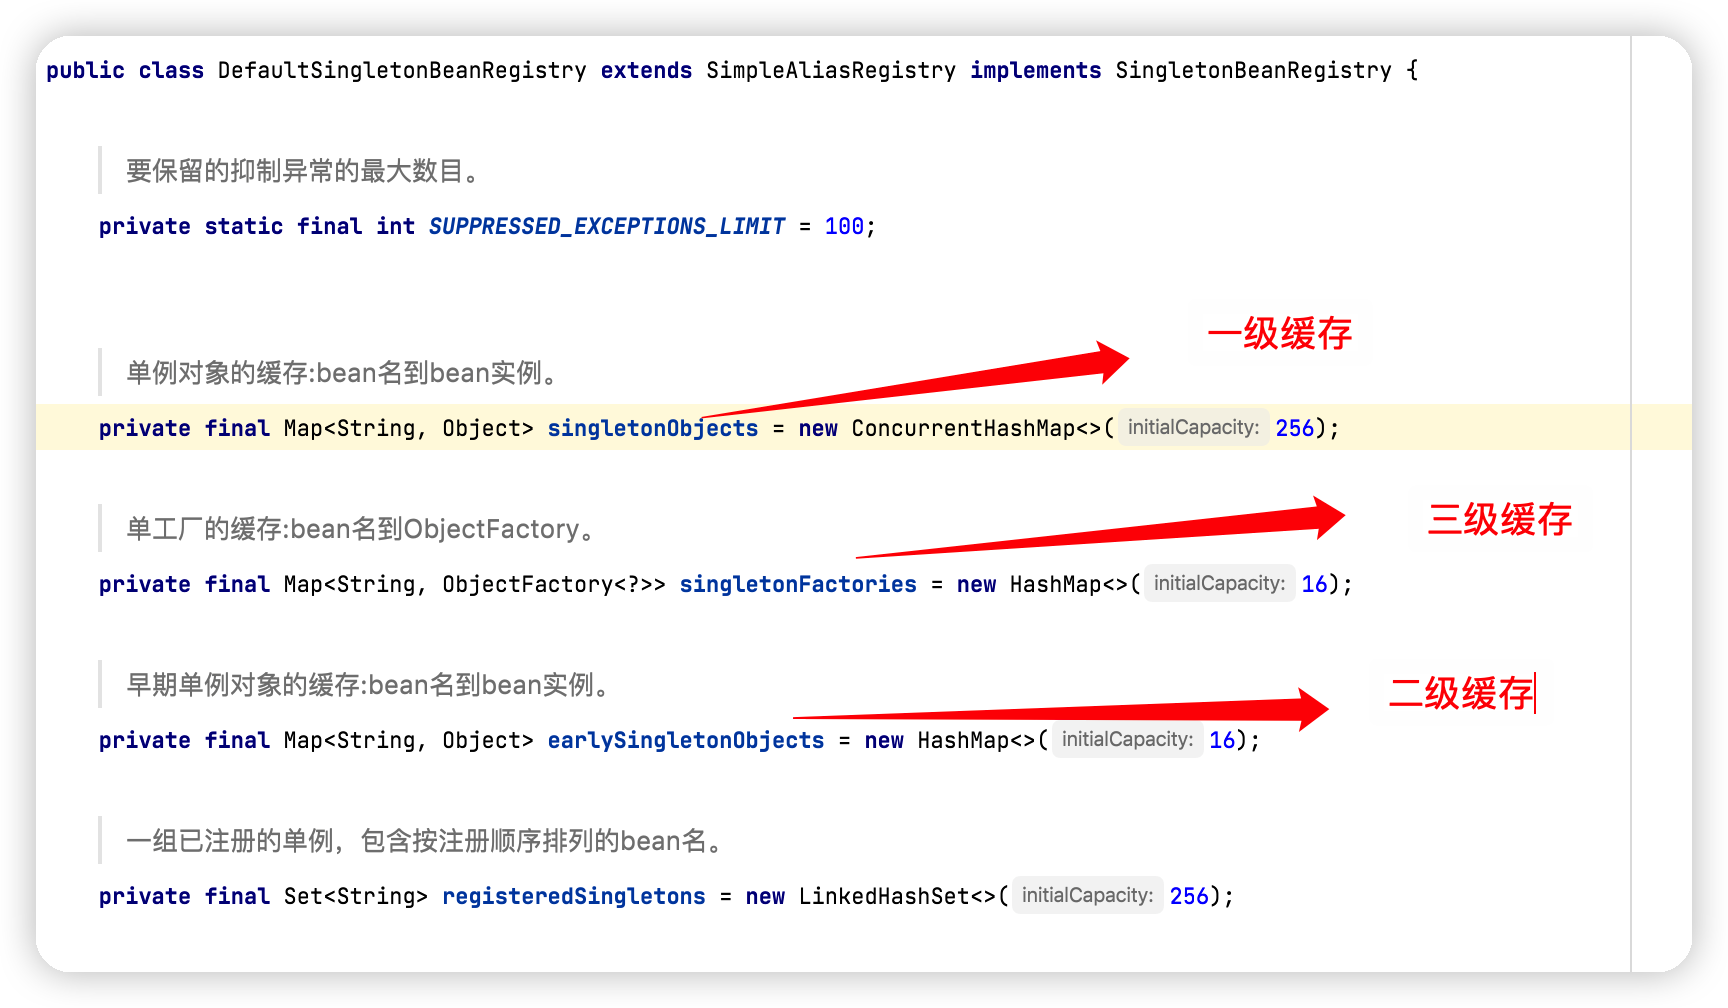
/*** 单例对象的缓存:bean 名称——bean 实例,即:所谓的单例池。* 表示已经经历了完整生命周期的 Bean 对象* <b>第一级缓存</b>*/Map<String, Object> singletonObjects = new ConcurrentHashMap<>(256);/*** 早期的单例对象的高速缓存:bean 名称——bean 实例。* 表示 Bean 的生命周期还没走完(Bean的属性还未填充)就把这个 Bean 存入该缓存中* 也就是实例化但未初始化的 bean 放入该缓存里* <b>第二级缓存</b>*/Map<String, Object> earlySingletonObjects = new HashMap<>(16);/*** 单例工厂的高速缓存:bean 名称——ObjectFactory。* 表示存放生成 bean 的工厂* <b>第三级缓存</b>*/Map<String, ObjectFactory<?>> singletonFactories = new HashMap<>(16);
第一级缓存(也叫单例池):Map
第二级缓存:Map
第三级缓存:Map
Spring 管理的 Bean 其实默认都是单例的,也就是说 Spring 将最终可以使用的 Bean 统一放入第一级缓存中,也就是 singletonObjects(单例池)里,以后凡是用到某个 Bean 了都从这里获取就行了。
2.可以只使用一级缓存吗?
不能,因为一级缓存虽然存的是完全的初始化好的Bean。如果我们直接将未完成初始化的Bean放入singleObjects里边,这个未初始化完的bean很有可能会被其他类拿去使用,他由于未完成初始化,很大概率抛出NPE。例如:
A、B、C三个对象
- 先实例化 A 类,叫 a
- 将 a 放入 singletonObjects 中(此时 a 中的 b 属性还是空的呢)
- C 类需要使用 A 类,去 singletonObjects 获取,且获取到了 a
- C 类使用 a,拿出 a 类的 b 属性,然后 NPE了
3.可以使用二级缓存?
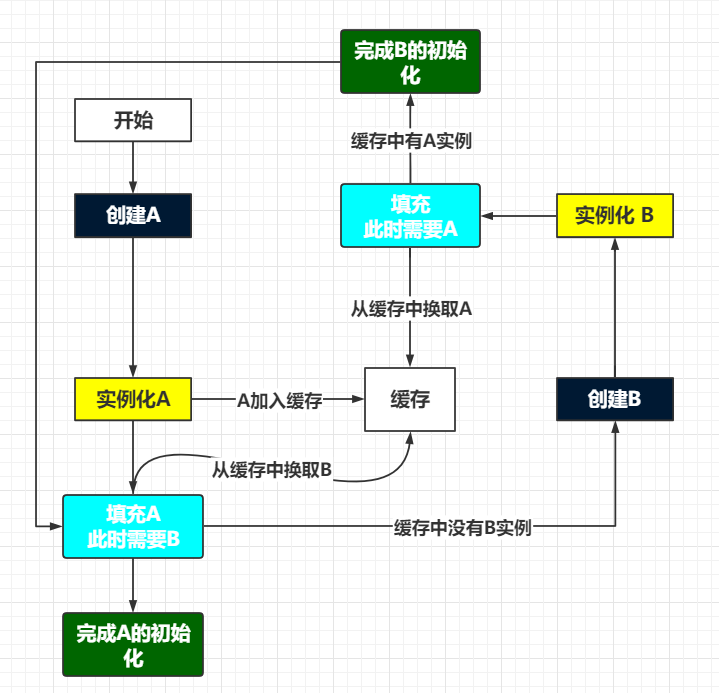
图中的缓存是二级缓存。创建A—->实例化A之后将A加入二级缓存—->开始填充A的属性发现需要B—->去缓存中查询没有B的实例—->创建B—->进行B的实例化—->将实例化的结果放入二级缓存—>填充B的属性发现需要A—->去缓存中查询发现有A的实例——>从缓存中取出A设置到B的属性上——>完成B的初始化—->返回A填充A的属性B—->完成A的初始化
4.为什么要用三级缓存
和Spring的生命周期有关
Spring 中 Bean 的生命周期,指的就是 Bean 从创建到销毁的一系列生命活动。那么由 Spring 来管理 Bean,要经过的主要步骤有:
- 1.Spring 根据开发人员的配置,扫描哪些类由 Spring 来管理,并为每个类生成一个 BeanDefintion,里面封装了类的一些信息,如全限定类名、哪些属性、是否单例等等
- 2.根据 BeanDefintion 的信息,通过反射,去实例化 Bean(此时就是实例化但未初始化 的 Bean)
- 3.填充上述未初始化对象中的属性(依赖注入)
- 4.如果上述未初始化对象中的方法被 AOP 了,那么就需要生成代理类(也叫包装类)
- 5.最后将完成初始化的对象存入缓存中(此处缓存 Spring 里叫: singletonObjects),下次用从缓存获取 ok 了
如果没有涉及到AOP,那么第四步就没有生成代理类,将第三步完成初始化的对象填入缓存中。
4.1.二级缓存会有什么问题
如果 Bean 没有 AOP,那么用二级缓存其实没有什么问题的,一旦有上述生命周期中第四步,就会导致的一个问题。因为 AOP 处理后,往往是需要生成代理对象的,代理对象和原来的对象根本就不是 1 个对象。
以二级缓存的场景来说,假设 A 类的某个方法会被 AOP,过程就是这样的:
- 1.生成 a 的实例,然后放入缓存,a 需要 b
- 2.再生成 b ,填充 b 的时候,需要 a,从缓存中取到了 a,完成 b 的初始化;
- 3.紧接着 a 把初始化好的 b 拿过来用,完成 a 的属性填充和初始化
- 4.由于 A 类涉及到了 AOP,再然后 a 要生成一个代理类,这里就叫:代理 a 吧
结果就是:a 最终的产物是代理 a,那 b 中其实也应该用代理 a,而现在 b 中用的却是原始的 a 代理 a 和原始的 a 不是一个对象,现在这就有问题了。
4.2.使用三级缓存如何解决?
二级缓存还是有问题,那就再加一层缓存,也就是第三级缓存:Map
singletonFactories 中存的是某个 beanName 及对应的 ObjectFactory,这个 ObjectFactory 其实就是生成这个 Bean 的工厂。实际中,这个 ObjectFactory 是个 Lambda 表达式:() -> getEarlyBeanReference(beanName, mbd, bean),而且,这个表达式并没有执行。
getEarlyBeanReference 具体做了什么事情?
- 第一步:根据 beanName 将它对应的实例化后且未初始化完的 Bean,存入 Map
- 第二步:生成该 Bean 对应的代理类返回
这个 earlyProxyReferences其实就是用于记录哪些 Bean 执行过 AOP,防止后期再次对 Bean 进行 AOP。那么getEarlyBeanReference 什么时候被触发,什么时候执行?
在二级缓存示例中,填充 B 的属性时候,需要 A,然后去缓存中拿 A,此时先去第三级缓存中去取 A,如果存在,此时就执行 getEarlyBeanReference 函数,然后该函数就会返回 A 对应的代理对象。
后续再将该代理对象放入第二级缓存中,也就是 Map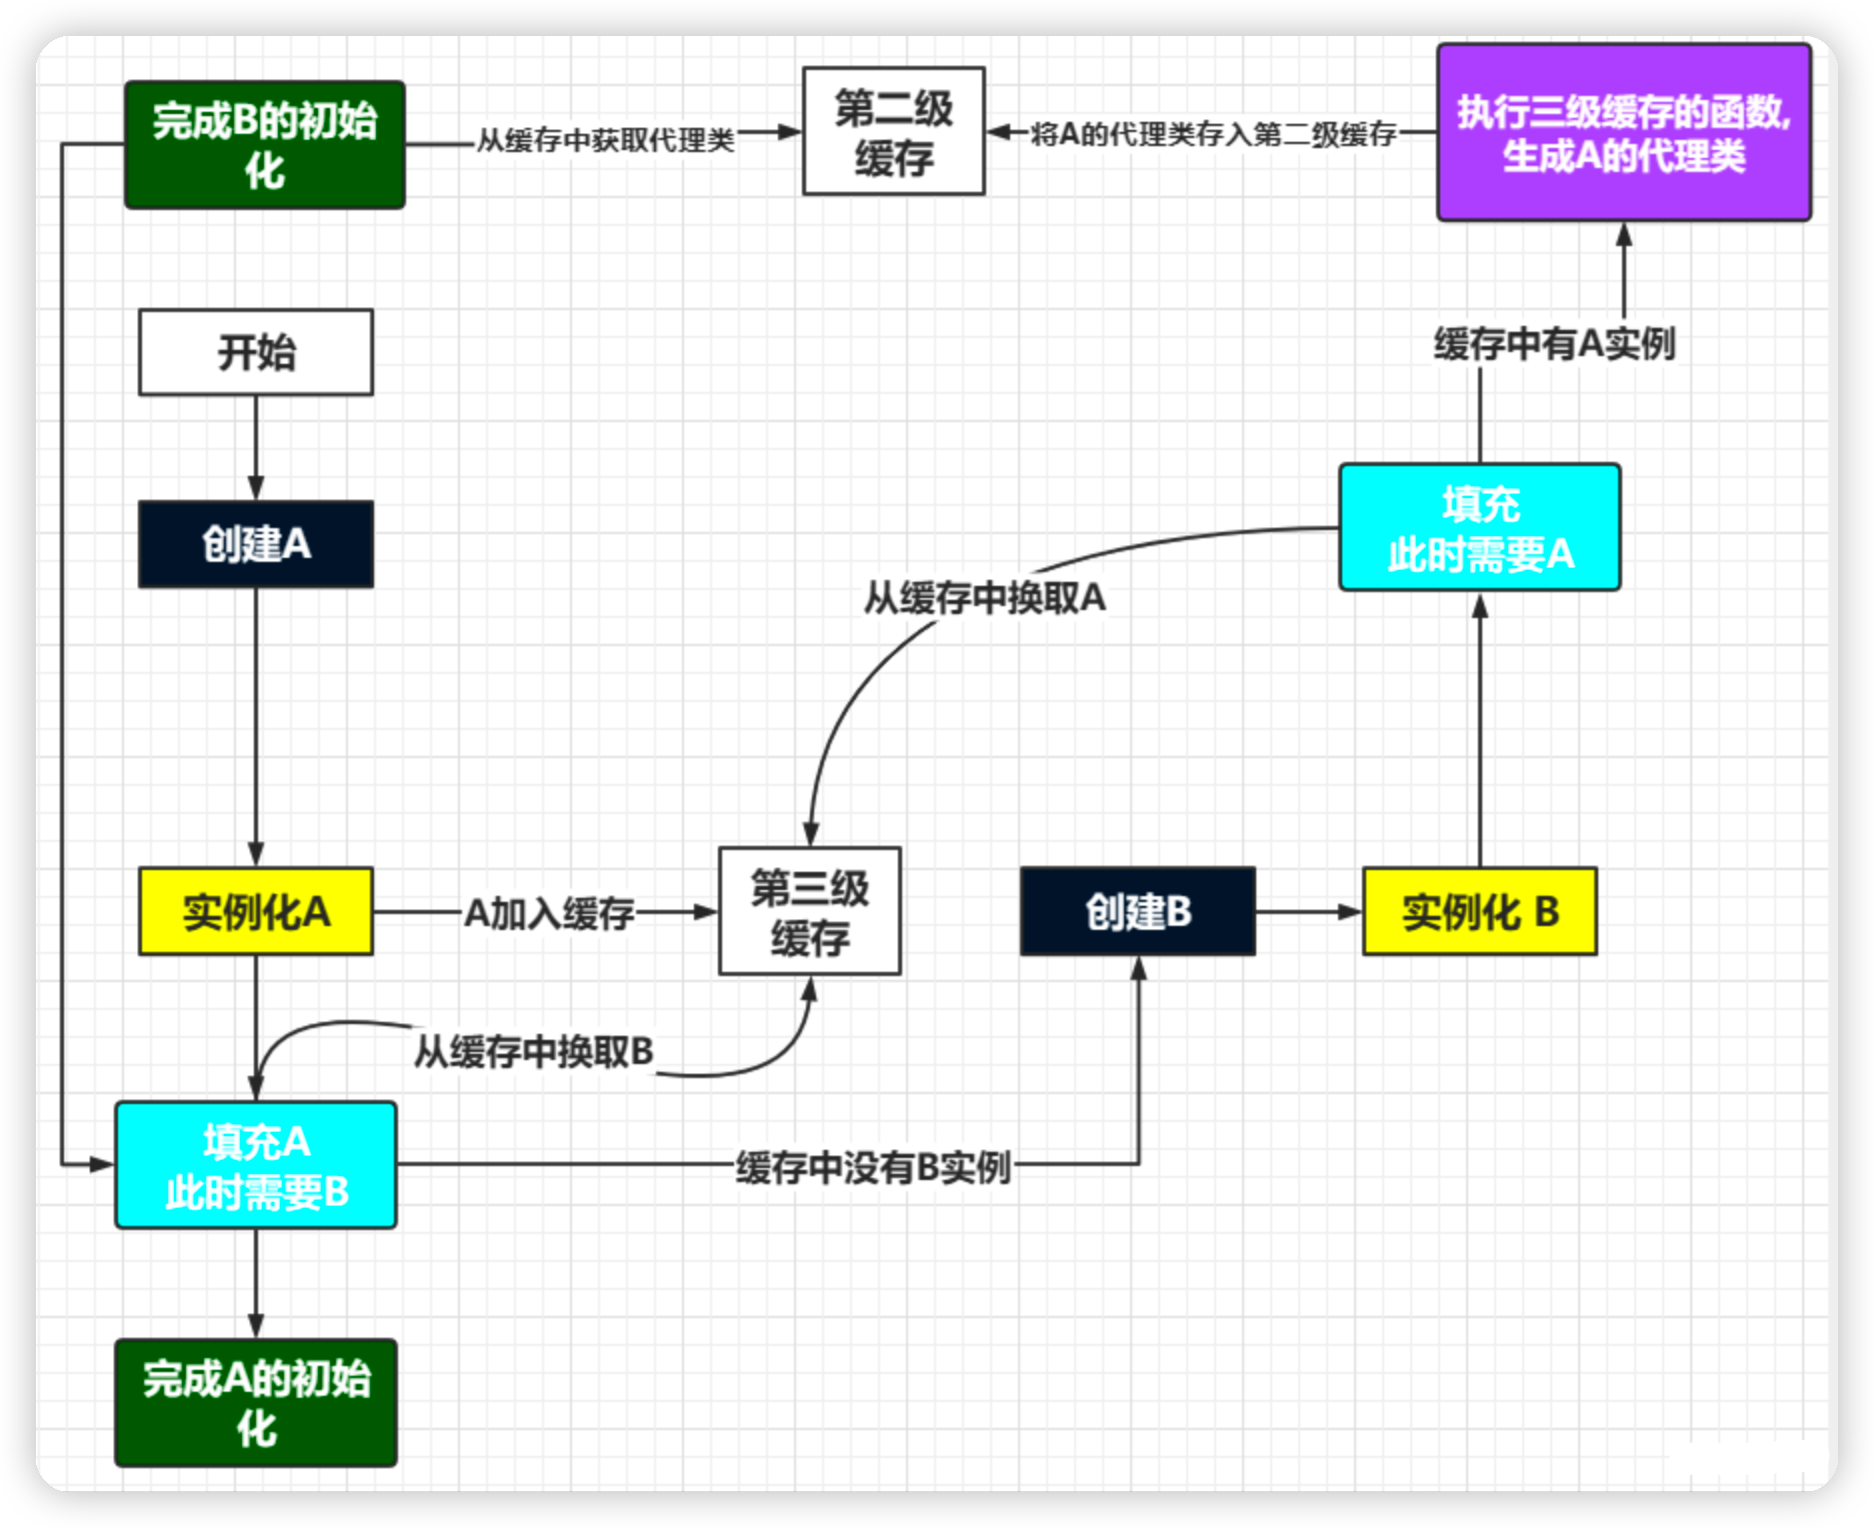
创建A—>实例化A—->将A加入三级缓存—->填充A属性发现需要B

- A绑定到ObjectFactory 注册到工厂缓存singletonFactory中,
- B在填充A时,先查成品缓存有没有,再查半成品缓存有没有,最后看工厂缓存有没有单例工厂类,有A的ObjectFactory。调用getObject ,执行扩展逻辑,可能返回的代理引用,也可能返回原始引用。
- 成功获取到A的早期引用,将A放入到半成品缓存中,B填充A引用完毕。
- 代理问题, 循环依赖问题都解决了。

若有收获,就点个赞吧
0 人点赞


