HashMap遍历
1.遍历方法
HashMap 遍历从大的方向来说,可分为以下 4 类:
- 迭代器(Iterator)方式遍历;
- For Each 方式遍历(加强for循环);
- Lambda 表达式遍历(JDK 1.8+);
- Streams API 遍历(JDK 1.8+)。
但每种类型下又有不同的实现方式,因此具体的遍历方式又可以分为以下 7 种:
- 使用迭代器(Iterator)EntrySet 的方式进行遍历;
- 使用迭代器(Iterator)KeySet 的方式进行遍历;
- 使用 For Each EntrySet 的方式进行遍历;
- 使用 For Each KeySet 的方式进行遍历;
- 使用 Lambda 表达式的方式进行遍历;
- 使用 Streams API 单线程的方式进行遍历;
- 使用 Streams API 多线程的方式进行遍历。
接下来我们来看每种遍历方式的具体实现代码。
1.1.迭代器 EntrySet
public class HashMapTest {public static void main(String[] args) {// 创建并赋值 HashMapMap<Integer, String> map = new HashMap();map.put(1, "Java");map.put(2, "JDK");map.put(3, "Spring Framework");map.put(4, "MyBatis framework");map.put(5, "Java中文社群");// 遍历Iterator<Map.Entry<Integer, String>> iterator = map.entrySet().iterator();while (iterator.hasNext()) {Map.Entry<Integer, String> entry = iterator.next();System.out.print(entry.getKey());System.out.print(entry.getValue());// 1 Java 2 JDK 3 Spring Framework 4 MyBatis framework 5 Java中文社群}}}
1.2.迭代器 KeySet
public class HashMapTest {public static void main(String[] args) {// 创建并赋值 HashMapMap<Integer, String> map = new HashMap();map.put(1, "Java");map.put(2, "JDK");map.put(3, "Spring Framework");map.put(4, "MyBatis framework");map.put(5, "Java中文社群");// 遍历Iterator<Integer> iterator = map.keySet().iterator();while (iterator.hasNext()) {Integer key = iterator.next();System.out.print(key);System.out.print(map.get(key));// 1 Java 2 JDK 3 Spring Framework 4 MyBatis framework 5 Java中文社群}}}
1.3.ForEach EntrySet
public class HashMapTest {public static void main(String[] args) {// 创建并赋值 HashMapMap<Integer, String> map = new HashMap();map.put(1, "Java");map.put(2, "JDK");map.put(3, "Spring Framework");map.put(4, "MyBatis framework");map.put(5, "Java中文社群");// 遍历for (Map.Entry<Integer, String> entry : map.entrySet()) {System.out.print(entry.getKey());System.out.print(entry.getValue());// 1 Java 2 JDK 3 Spring Framework 4 MyBatis framework 5 Java中文社群}}}
1.4.ForEach KeySet
public class HashMapTest {public static void main(String[] args) {// 创建并赋值 HashMapMap<Integer, String> map = new HashMap();map.put(1, "Java");map.put(2, "JDK");map.put(3, "Spring Framework");map.put(4, "MyBatis framework");map.put(5, "Java中文社群");// 遍历for (Integer key : map.keySet()) {System.out.print(key);System.out.print(map.get(key));// 1 Java 2 JDK 3 Spring Framework 4 MyBatis framework 5 Java中文社群}}}
1.5.Lambda
public class HashMapTest {public static void main(String[] args) {// 创建并赋值 HashMapMap<Integer, String> map = new HashMap();map.put(1, "Java");map.put(2, "JDK");map.put(3, "Spring Framework");map.put(4, "MyBatis framework");map.put(5, "Java中文社群");// 遍历map.forEach((key, value) -> {System.out.print(key);System.out.print(value);// 1 Java 2 JDK 3 Spring Framework 4 MyBatis framework 5 Java中文社群});}}
1.6.Streams API 单线程
public class HashMapTest {public static void main(String[] args) {// 创建并赋值 HashMapMap<Integer, String> map = new HashMap();map.put(1, "Java");map.put(2, "JDK");map.put(3, "Spring Framework");map.put(4, "MyBatis framework");map.put(5, "Java中文社群");// 遍历map.entrySet().stream().forEach((entry) -> {System.out.print(entry.getKey());System.out.print(entry.getValue());// 1 Java 2 JDK 3 Spring Framework 4 MyBatis framework 5 Java中文社群});}}
1.7.Streams API 多线程
public class HashMapTest {public static void main(String[] args) {// 创建并赋值 HashMapMap<Integer, String> map = new HashMap();map.put(1, "Java");map.put(2, "JDK");map.put(3, "Spring Framework");map.put(4, "MyBatis framework");map.put(5, "Java中文社群");// 遍历map.entrySet().parallelStream().forEach((entry) -> {System.out.print(entry.getKey());System.out.print(entry.getValue());// 1 Java 2 JDK 3 Spring Framework 4 MyBatis framework 5 Java中文社群});}}
2.性能测试
接下来我们使用 Oracle 官方提供的性能测试工具 JMH(Java Microbenchmark Harness,JAVA 微基准测试套件)来测试一下这 7 种循环的性能。
首先,我们先要引入 JMH 框架,在 pom.xml 文件中添加如下配置:
<!-- https://mvnrepository.com/artifact/org.openjdk.jmh/jmh-core --><dependency><groupId>org.openjdk.jmh</groupId><artifactId>jmh-core</artifactId><version>1.23</version></dependency>
然后编写测试代码,如下所示:
import org.openjdk.jmh.annotations.*;import org.openjdk.jmh.runner.Runner;import org.openjdk.jmh.runner.RunnerException;import org.openjdk.jmh.runner.options.Options;import org.openjdk.jmh.runner.options.OptionsBuilder;import java.util.HashMap;import java.util.Iterator;import java.util.Map;import java.util.concurrent.TimeUnit;@BenchmarkMode(Mode.Throughput) // 测试类型:吞吐量@OutputTimeUnit(TimeUnit.MILLISECONDS)@Warmup(iterations = 2, time = 1, timeUnit = TimeUnit.SECONDS) // 预热 2 轮,每次 1s@Measurement(iterations = 5, time = 3, timeUnit = TimeUnit.SECONDS) // 测试 5 轮,每次 3s@Fork(1) // fork 1 个线程@State(Scope.Thread) // 每个测试线程一个实例public class HashMapCycle {static Map<Integer, String> map = new HashMap() {{// 添加数据for (int i = 0; i < 10; i++) {put(i, "val:" + i);}}};public static void main(String[] args) throws RunnerException {// 启动基准测试Options opt = new OptionsBuilder().include(HashMapCycle.class.getSimpleName()) // 要导入的测试类.output("/Users/admin/Desktop/jmh-map.log") // 输出测试结果的文件.build();new Runner(opt).run(); // 执行测试}@Benchmarkpublic void entrySet() {// 遍历Iterator<Map.Entry<Integer, String>> iterator = map.entrySet().iterator();while (iterator.hasNext()) {Map.Entry<Integer, String> entry = iterator.next();System.out.println(entry.getKey());System.out.println(entry.getValue());}}@Benchmarkpublic void keySet() {// 遍历Iterator<Integer> iterator = map.keySet().iterator();while (iterator.hasNext()) {Integer key = iterator.next();System.out.println(key);System.out.println(map.get(key));}}@Benchmarkpublic void forEachEntrySet() {// 遍历for (Map.Entry<Integer, String> entry : map.entrySet()) {System.out.println(entry.getKey());System.out.println(entry.getValue());}}@Benchmarkpublic void forEachKeySet() {// 遍历for (Integer key : map.keySet()) {System.out.println(key);System.out.println(map.get(key));}}@Benchmarkpublic void lambda() {// 遍历map.forEach((key, value) -> {System.out.println(key);System.out.println(value);});}@Benchmarkpublic void streamApi() {// 单线程遍历map.entrySet().stream().forEach((entry) -> {System.out.println(entry.getKey());System.out.println(entry.getValue());});}@Benchmarkpublic void parallelStreamApi() {// 多线程遍历map.entrySet().parallelStream().forEach((entry) -> {System.out.println(entry.getKey());System.out.println(entry.getValue());});}}
所有被添加了 @Benchmark 注解的方法都会被测试,测试结果如下:

其中 Score 列表示平均执行时间, ± 符号表示误差。从以上结果可以看出,如果加上后面的误差值的话,可以得出的结论是,除了并行循环的 parallelStream 性能比极高之外(多线程方式性能肯定比较高),其他方式的遍历方法在性能方面几乎没有任何差别。
注:以上结果基于测试环境:JDK 1.8 / Mac mini (2018) / Idea 2020.1
3.性能原理分析
要理解性能测试的结果,我们需要把所有遍历代码通过 javac,编译成字节码来看具体的原因,编译之后我们使用 Idea 打开字节码信息,内容如下:
// Source code recreated from a .class file by IntelliJ IDEA// (powered by Fernflower decompiler)package com.example;import java.util.HashMap;import java.util.Iterator;import java.util.Map;import java.util.Map.Entry;public class HashMapTest {static Map<Integer, String> map = new HashMap() {{for(int var1 = 0; var1 < 2; ++var1) {this.put(var1, "val:" + var1);}}};public HashMapTest() {}public static void main(String[] var0) {entrySet();keySet();forEachEntrySet();forEachKeySet();lambda();streamApi();parallelStreamApi();}public static void entrySet() {Iterator var0 = map.entrySet().iterator();while(var0.hasNext()) {Entry var1 = (Entry)var0.next();System.out.println(var1.getKey());System.out.println((String)var1.getValue());}}public static void keySet() {Iterator var0 = map.keySet().iterator();while(var0.hasNext()) {Integer var1 = (Integer)var0.next();System.out.println(var1);System.out.println((String)map.get(var1));}}public static void forEachEntrySet() {Iterator var0 = map.entrySet().iterator();while(var0.hasNext()) {Entry var1 = (Entry)var0.next();System.out.println(var1.getKey());System.out.println((String)var1.getValue());}}public static void forEachKeySet() {Iterator var0 = map.keySet().iterator();while(var0.hasNext()) {Integer var1 = (Integer)var0.next();System.out.println(var1);System.out.println((String)map.get(var1));}}public static void lambda() {map.forEach((var0, var1) -> {System.out.println(var0);System.out.println(var1);});}public static void streamApi() {map.entrySet().stream().forEach((var0) -> {System.out.println(var0.getKey());System.out.println((String)var0.getValue());});}public static void parallelStreamApi() {map.entrySet().parallelStream().forEach((var0) -> {System.out.println(var0.getKey());System.out.println((String)var0.getValue());});}}
从结果可以看出,除了 Lambda 和 Streams API 之外,通过迭代器循环和 for 循环的遍历的 EntrySet 最终生成的代码是一样的,他们都是在循环中创建了一个遍历对象 Entry ,如下所示:
public static void entrySet() {Iterator var0 = map.entrySet().iterator();while(var0.hasNext()) {Entry var1 = (Entry)var0.next();System.out.println(var1.getKey());System.out.println((String)var1.getValue());}}public static void forEachEntrySet() {Iterator var0 = map.entrySet().iterator();while(var0.hasNext()) {Entry var1 = (Entry)var0.next();System.out.println(var1.getKey());System.out.println((String)var1.getValue());}}
而通过迭代器和 for 循环遍历的 KeySet 代码也是一样的,如下所示:
public static void keySet() {Iterator var0 = map.keySet().iterator();while(var0.hasNext()) {Integer var1 = (Integer)var0.next();System.out.println(var1);System.out.println((String)map.get(var1));}}public static void forEachKeySet() {Iterator var0 = map.keySet().iterator();while(var0.hasNext()) {Integer var1 = (Integer)var0.next();System.out.println(var1);System.out.println((String)map.get(var1));}}
可以看出 KeySet 在循环中创建了一个 Integer 的局部变量,并且值是从 map 对象中直接获取的。
所以通过字节码来看,使用 EntrySet 和 KeySet 代码差别不是很大,并不像网上说的那样 KeySet 的性能远不如 EntrySet,因此从性能的角度来说 EntrySet 和 KeySet 几乎是相近的,但从代码的优雅型和可读性来说,还是推荐使用 EntrySet。
4.安全性测试
从上面的性能测试结果和原理分析,我想大家应该选用那种遍历方式,已经心中有数的,而接下来我们就从「安全」的角度入手,来分析那种遍历方式更安全。我们把以上遍历划分为四类进行测试:迭代器方式、For 循环方式、Lambda 方式和 Stream 方式,测试代码如下。
4.1.迭代器方式
Iterator<Map.Entry<Integer, String>> iterator = map.entrySet().iterator();while (iterator.hasNext()) {Map.Entry<Integer, String> entry = iterator.next();if (entry.getKey() == 1) {// 删除System.out.println("del:" + entry.getKey());iterator.remove();} else {System.out.println("show:" + entry.getKey());}}
以上程序的执行结果:
show:0
del:1
show:2
测试结果:迭代器中循环删除数据安全。
4.2.For 循环方式
for (Map.Entry<Integer, String> entry : map.entrySet()) {if (entry.getKey() == 1) {// 删除System.out.println("del:" + entry.getKey());map.remove(entry.getKey());} else {System.out.println("show:" + entry.getKey());}}
以上程序的执行结果:
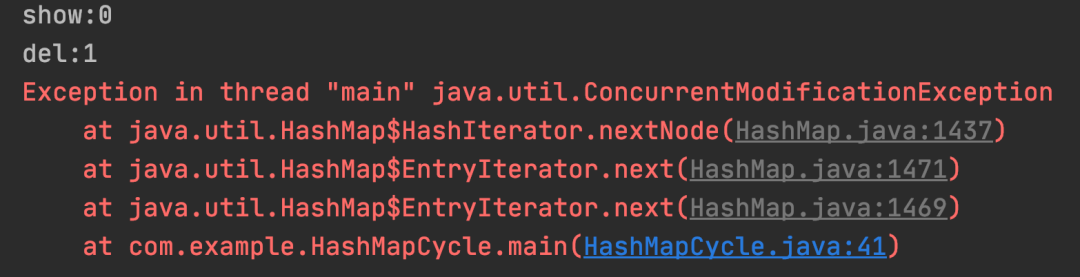
测试结果:For 循环中删除数据非安全。
3.Lambda 方式
map.forEach((key, value) -> {if (key == 1) {System.out.println("del:" + key);map.remove(key);} else {System.out.println("show:" + key);}});
以上程序的执行结果:
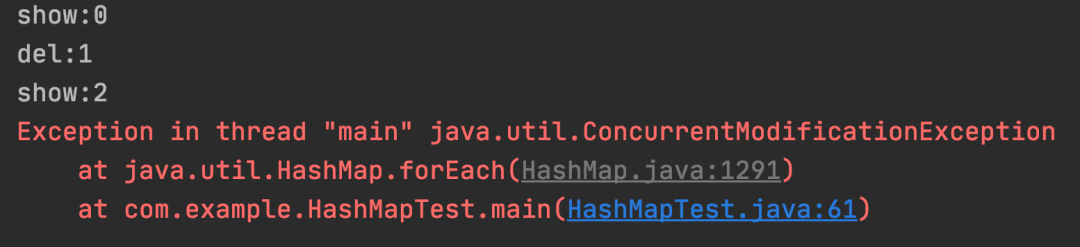 测试结果:Lambda 循环中删除数据非安全。
Lambda 删除的正确方式:
// 根据 map 中的 key 去判断删除
map.keySet().removeIf(key -> key == 1);
map.forEach((key, value) -> {
    System.out.println("show:" + key);
});
以上程序的执行结果:
show:0
show:2
从上面的代码可以看出,可以先使用 Lambda 的 removeIf 删除多余的数据,再进行循环是一种正确操作集合的方式。
4.Stream 方式
map.entrySet().stream().forEach((entry) -> {
    if (entry.getKey() == 1) {
        System.out.println("del:" + entry.getKey());
        map.remove(entry.getKey());
    } else {
        System.out.println("show:" + entry.getKey());
    }
});
以上程序的执行结果:
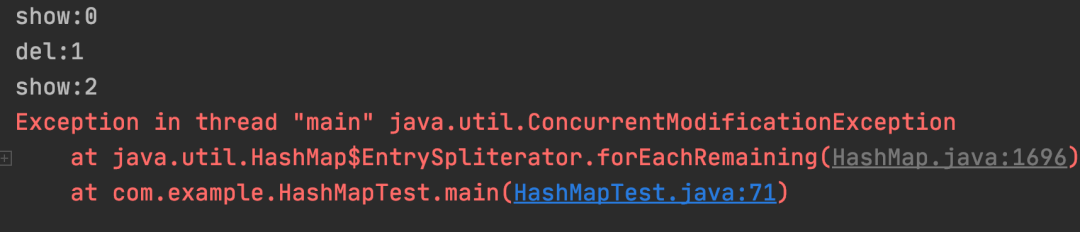
测试结果:Stream 循环中删除数据非安全。
Stream 循环的正确方式:
map.entrySet().stream().filter(m -> 1 != m.getKey()).forEach((entry) -> {
    if (entry.getKey() == 1) {
        System.out.println("del:" + entry.getKey());
    } else {
        System.out.println("show:" + entry.getKey());
    }
});
以上程序的执行结果:
show:0
show:2
从上面的代码可以看出,可以使用 Stream 中的 filter 过滤掉无用的数据,再进行遍历也是一种安全的操作集合的方式。
小结
我们不能在遍历中使用集合 map.remove() 来删除数据,这是非安全的操作方式,但我们可以使用迭代器的 iterator.remove() 的方法来删除数据,这是安全的删除集合的方式。同样的我们也可以使用 Lambda 中的 removeIf 来提前删除数据,或者是使用 Stream 中的 filter 过滤掉要删除的数据进行循环,这样都是安全的,当然我们也可以在 for 循环前删除数据再遍历也是线程安全的。
总结
本文我们讲了 HashMap 4 大类(迭代器、for、lambda、stream)遍历方式,以及具体的 7 种遍历方法,除了 Stream 的并行循环,其他几种遍历方法的性能差别不大,但从简洁性和优雅性上来看,Lambda 和 Stream 无疑是最适合的遍历方式。除此之外我们还从「安全性」方面测试了 4 大类遍历结果,从安全性来讲,我们应该使用迭代器提供的 iterator.remove() 方法来进行删除,这种方式是安全的在遍历中删除集合的方式,或者使用 Stream 中的 filter 过滤掉要删除的数据再进行循环,也是安全的操作方式。
总体来说,本文提供了 7 种方式肯定也不是最全的,只是想给读者在使用 HashMap 时多一种选择,然而选择那一种形式的写法,要综合:性能、安全性、使用环境的 JDK 版本以及优雅性和可读性等方面来综合考虑。

若有收获,就点个赞吧
0 人点赞


