kettle入门
1、了解’E T L‘是什么?
我们说的ETL就是
Extract-Transform-Load
的缩写,即数据抽取、转换、装载的一个过程。
我们在工作中可能要经常解决各种数据的处理,转换,迁移,解决ETL这种过程的话掌握一种工具是最方便的,kettle就是这样一种ETL工具。
2、kettle的介绍
1、什么是kettle?

总结来说:
- 无需安装,高效稳定:Kettle是一款国外开源的ETL工具,纯java编写,可以在Window、Linux、Unix上运行,绿色无需安装,数据抽取高效稳定。
- kettle是数据抽取并转换的“水壶”:该项目的主程序员MATT 希望把各种数据放到一个壶里,然后以一种指定的格式流出。
- kettle是ETL工具集:它允许你管理来自不同数据库的数据,通过提供一个图形化的用户环境来描述你想做什么,而不是你想怎么做。
- 两种脚本文件:transformation(.ktr)和job(.kjb),transformation完成针对数据的基础转换,job则完成整个工作流的控制。

2、kettle的结构

左边结构:

- Data Integration Server是能够监测到活动进行时间;
- Spoon是构建工具;
右边结构:

3、kettle的一些核心组件
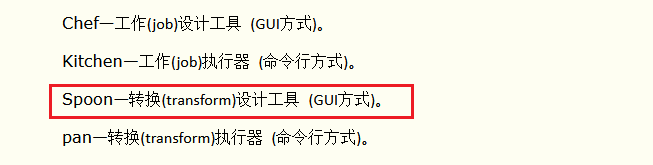
Chef(中文:厨师)、Kitchen(中文:厨房)、Spoon(中文:勺子)、Pan(中文:平底锅)

3、kettle概念模型

Kettle的执行分为两个层次:
- Job
- Transformation
这两个层次的最主要的区别在于数据的传递和运行方式。
Transformation分两步:

3.1、Transfprmation
是定义对数据怎么操作的容器,数据操作是指数据从输入到输出的过程。它可以理解为比job粒度更小的容器,通俗点说,我们先将任务分解成job,再将job分解成transformation,然后每个transformation只完成一小部分工作。
3.2、job
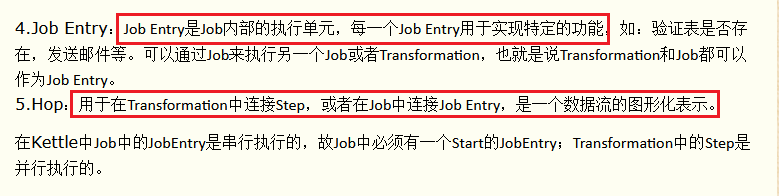
负责将一个个Transformation组织在一起进而完成某一项工作,通常我们需要把一个大的任务分解成几个逻辑上隔离的Job,当这几个Job都完成了,也就说明这项任务完成了。
3.3、step
是Transformation内部的最小单元,每一个Step完成一个特定的功能。
3.4、job Entry
4、kettle的下载解压
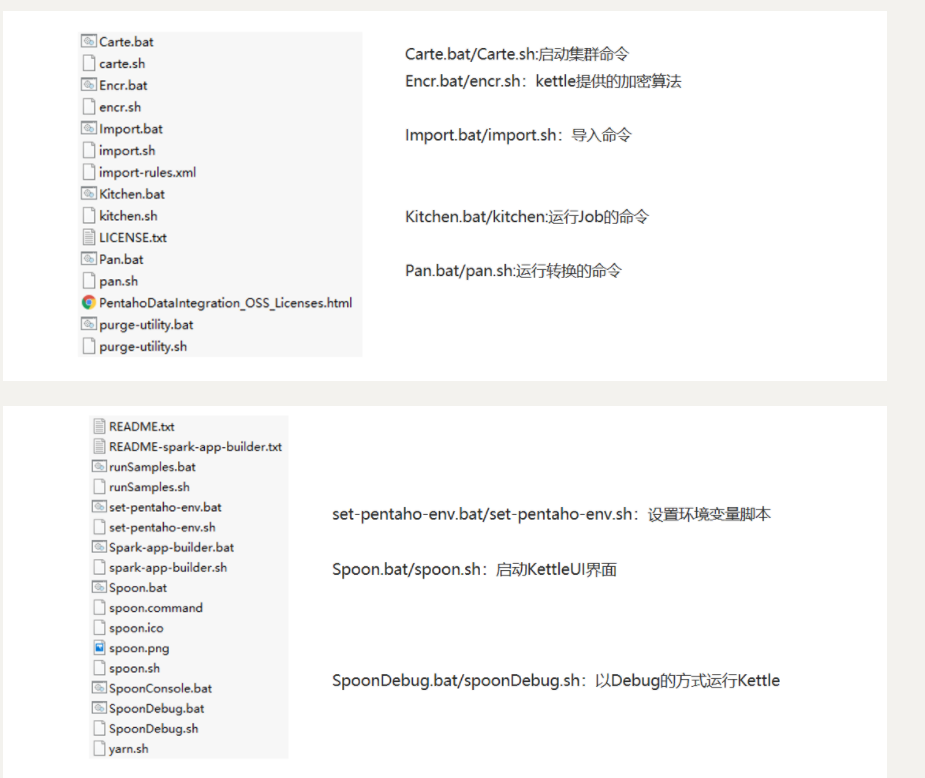
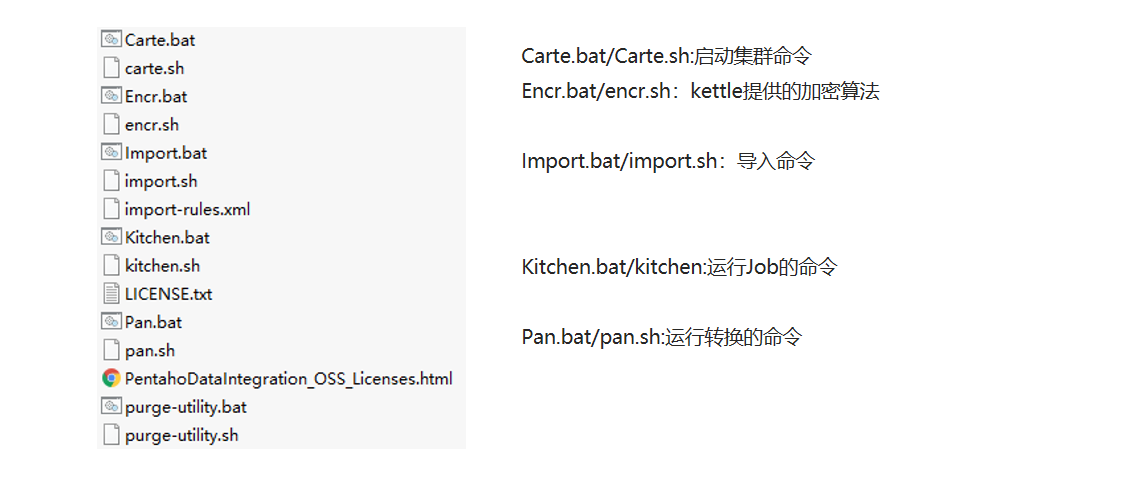
4.1、kettle解压后的目录

5、kettle的环境部署
5.1、kettle的运行需要JDK支持
由于Kettle是由java语言开发,该软件的允许需要java运行环境的依赖,需要先安装好JDK,准备好运行环境。
5.2、环境变量配置
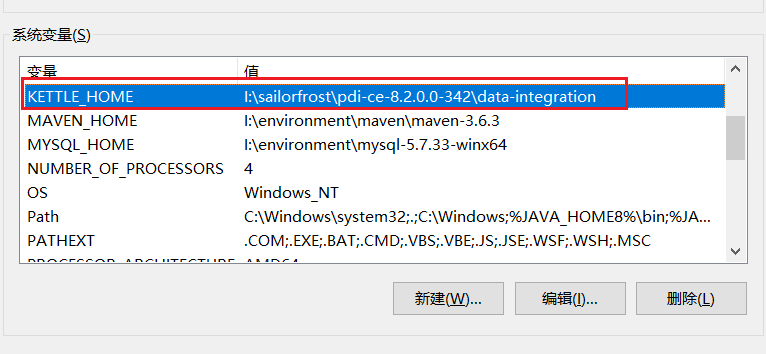
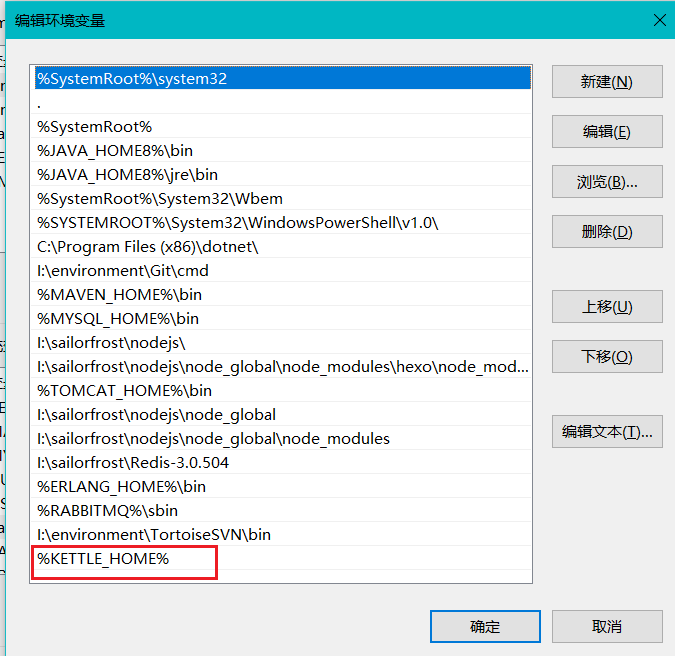
和JDK一样,配置一个“KETTLE_HOME”
6、kettle的图形界面
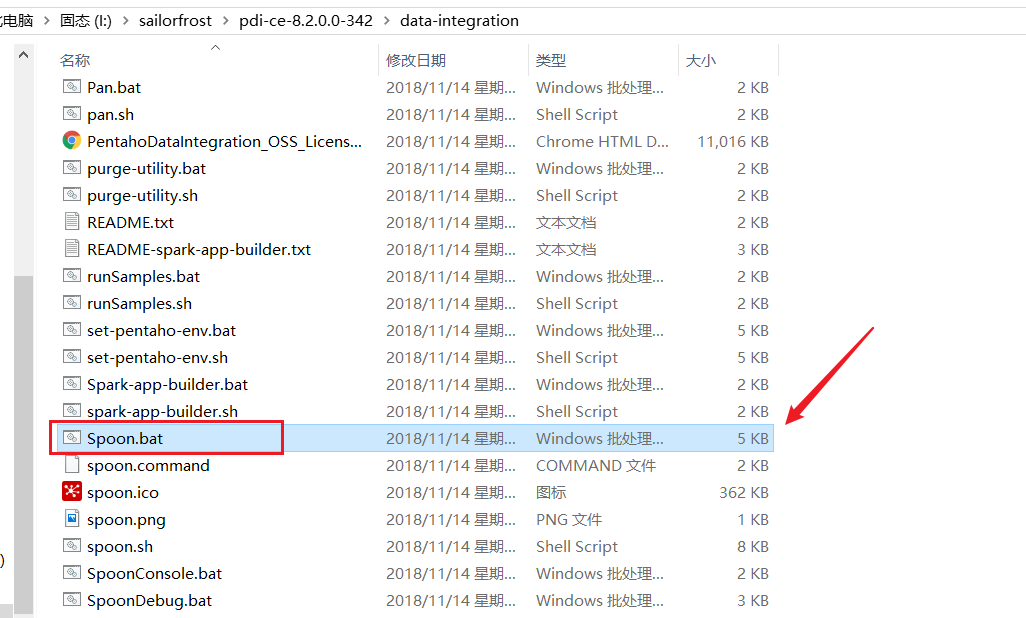
点击.bat文件运行Spoon工具图形界面

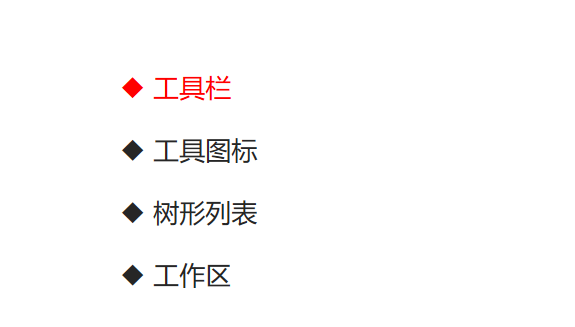
7、kettle界面板块介绍

8、转换初体验
8.1、新建转换并命名保存
打开“输入”,鼠标拖动“CSV文见输入”到工作区

双击“控件”

获取字段
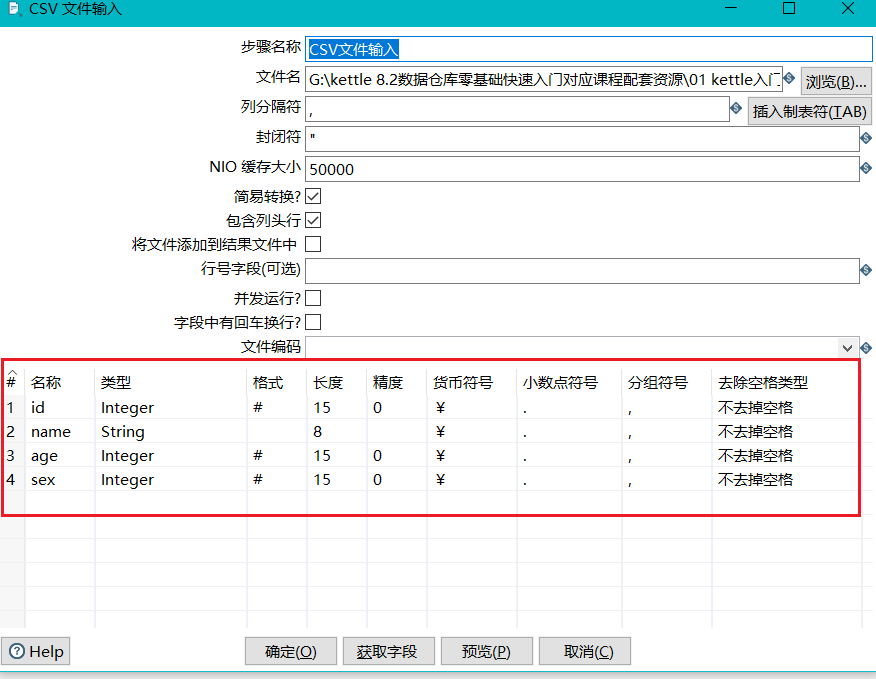
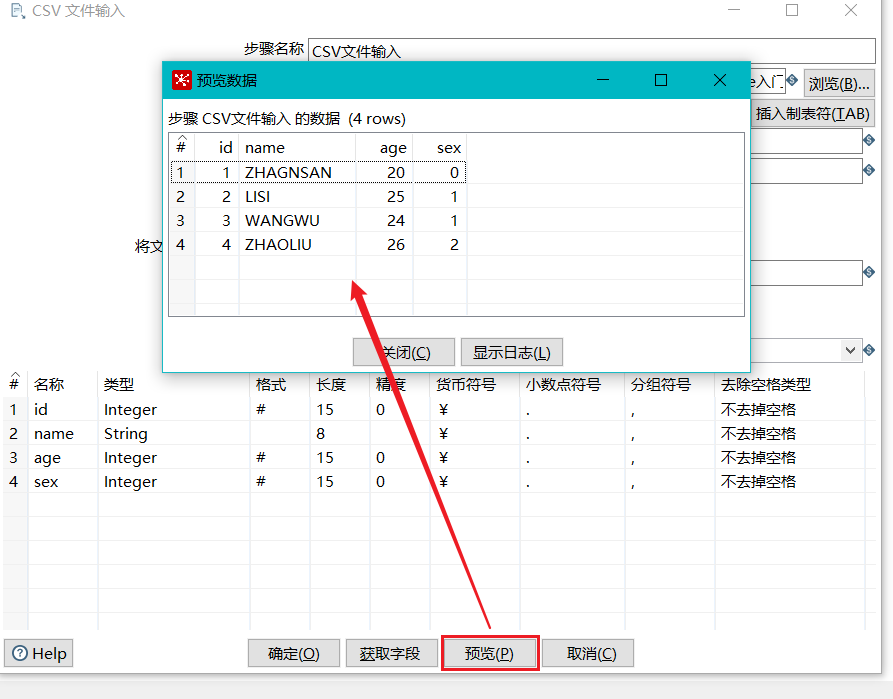
点击预览
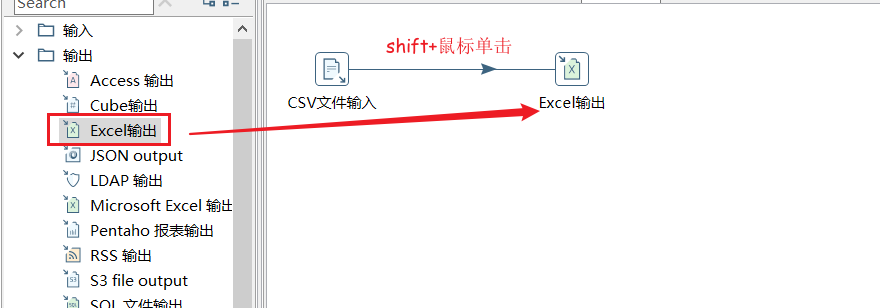
打开“输出”
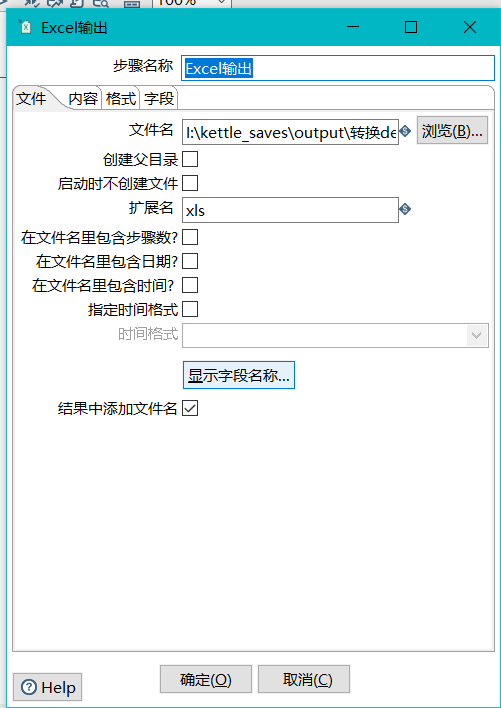
双击“输出控件”
点击“运行”

点击“启动”
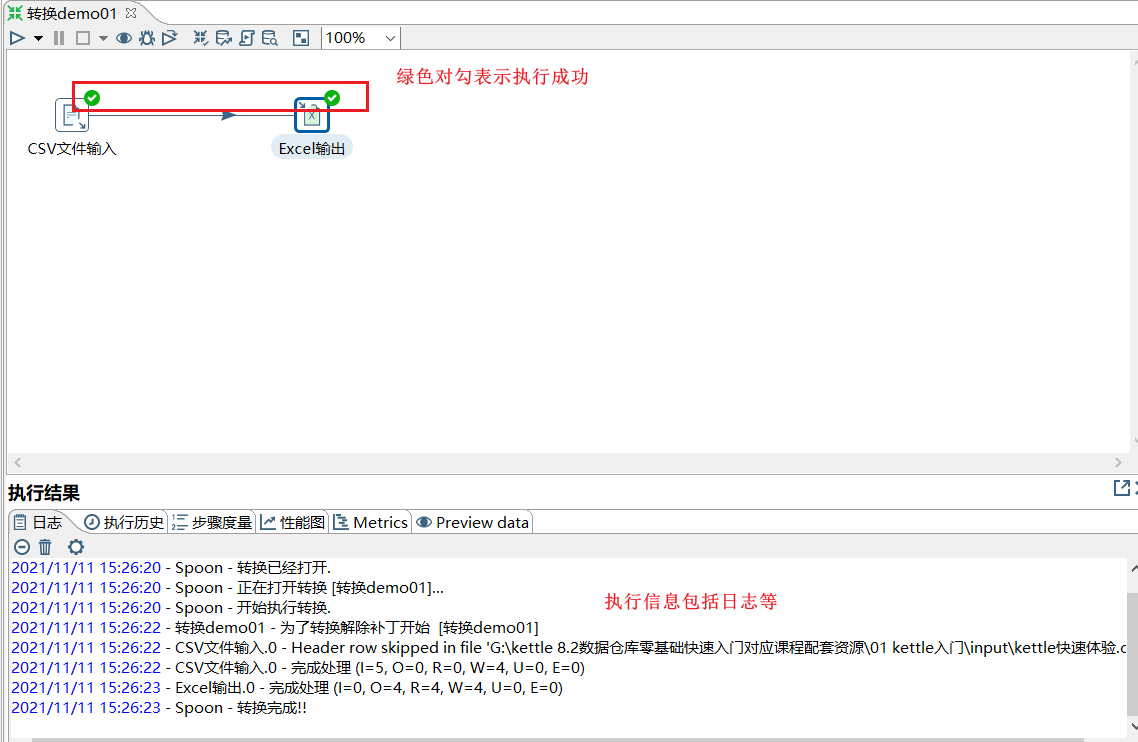
执行结果详解
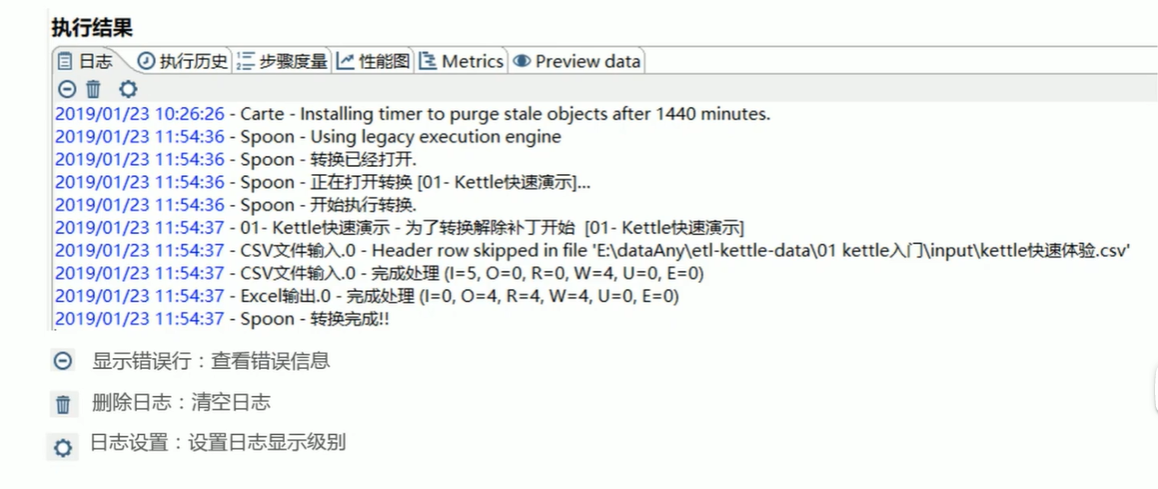
9、kettle的核心概念

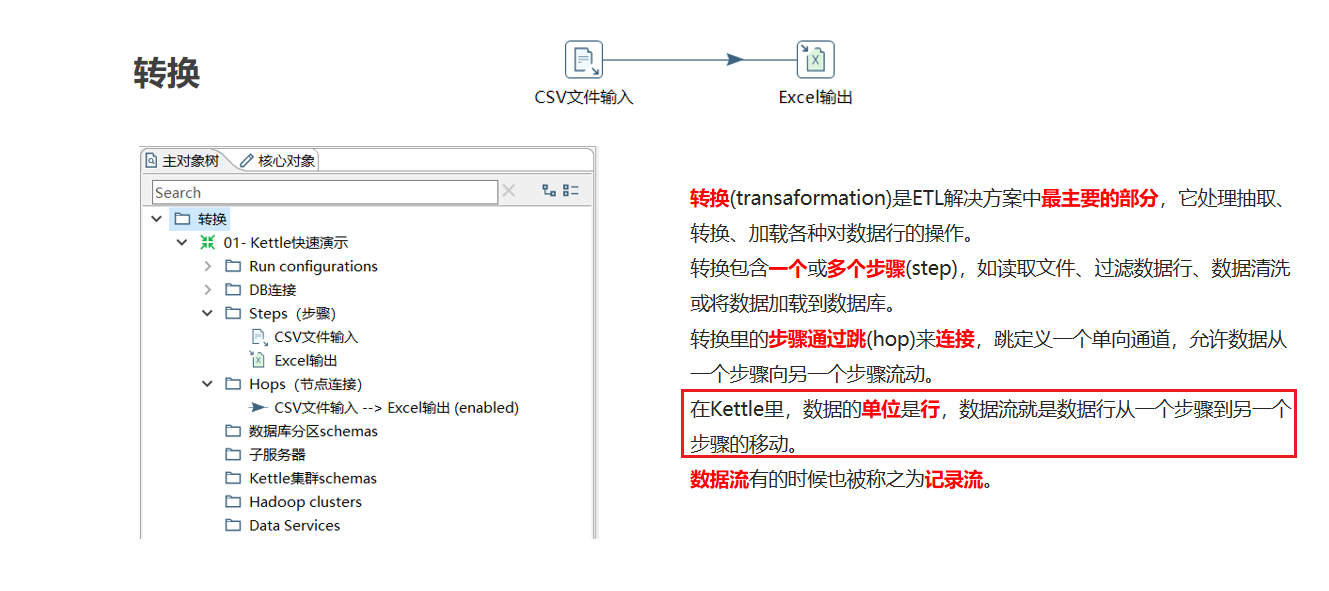
9.1、转换

若有收获,就点个赞吧
0 人点赞


