框架集成-SpringData-整体介绍
Spring Data是一个用于简化数据库、非关系型数据库、索引库访问,并支持云服务的开源框架。其主要目标是使得对数据的访问变得方便快捷,并支持 map-reduce框架和云计算数据服务。Spring Data可以极大的简化JPA(Elasticsearch…)的写法,可以在几乎不用写实现的情况下,实现对数据的访问和操作。除了CRUD 外,还包括如分页、排序等一些常用的功能。
Spring Data 的官网:https://spring.io/projects/spring-data
- Spring Data 常用的功能模块如下:
Spring Data JDBCSpring Data JPASpring Data LDAPSpring Data MongoDBSpring Data RedisSpring Data R2DBCSpring Data RESTSpring Data for Apache CassandraSpring Data for Apache GeodeSpring Data for Apache SolrSpring Data for Pivotal GemFireSpring Data CouchbaseSpring Data ElasticsearchSpring Data EnversSpring Data Neo4jSpring Data JDBC ExtensionsSpring for Apache Hadoop
Spring Data Elasticsearch 介绍
Spring Data Elasticsearch基于Spring Data API简化 Elasticsearch 操作,将原始操作Elasticsearch 的客户端API进行封装。Spring Data为Elasticsearch 项目提供集成搜索引擎。Spring Data Elasticsearch POJO的关键功能区域为中心的模型与Elastichsearch交互文档和轻松地编写一个存储索引库数据访问层。
Spring Data Elasticsearch 官网:https://spring.io/projects/spring-data-elasticsearch
创建elasticsearch-springdata项目
修改pom文件,增加依赖关系
<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.org/POM/4.0.0"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"><parent><artifactId>tian996cloud2020</artifactId><groupId>com.tian996.cloud</groupId><version>1.0-SNAPSHOT</version></parent><modelVersion>4.0.0</modelVersion><artifactId>elasticsearch-springdata</artifactId><properties><maven.compiler.source>8</maven.compiler.source><maven.compiler.target>8</maven.compiler.target></properties><dependencies><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-data-elasticsearch</artifactId></dependency><dependency><groupId>org.projectlombok</groupId><artifactId>lombok</artifactId><optional>true</optional></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-devtools</artifactId><scope>runtime</scope><optional>true</optional></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-starter-test</artifactId><scope>test</scope></dependency><dependency><groupId>org.springframework.boot</groupId><artifactId>spring-boot-test</artifactId></dependency><dependency><groupId>junit</groupId><artifactId>junit</artifactId></dependency><dependency><groupId>org.springframework</groupId><artifactId>spring-test</artifactId></dependency><!-- hutool工具类 --><dependency><groupId>cn.hutool</groupId><artifactId>hutool-all</artifactId><version>${hutool.version}</version></dependency></dependencies></project>
增加配置文件
在 resources 目录中增加application.properties文件
# es 服务地址elasticsearch.host=127.0.0.1# es 服务端口elasticsearch.port=9200# 配置日志级别,开启 debug 日志logging.level.com.atguigu.es=debug
Spring Boot 主程序
主启动类
```java @SpringBootApplication public class ElasticsearchApplicationMain {
public static void main(String[] args) {
SpringApplication.run(ElasticsearchApplicationMain.class,args);
}
}
<a name="xDY4i"></a>#### 实体类```java@Data@NoArgsConstructor@AllArgsConstructor@ToString@Document(indexName = "shopping",shards = 3,replicas = 1)public class Product {/*** 商品唯一标识* 必须有 id,这里的 id 是全局唯一的标识,等同于 es 中的"_id"*/@Idprivate Long id;/*** 商品名称* type : 字段数据类型* analyzer : 分词器类型* index : 是否索引(默认:true)* Keyword : 短语,不进行分词*/@Field(type = FieldType.Text , analyzer = "ik_max_word")private String title;/*** 分类名称*/@Field(type = FieldType.Keyword)private String category;/*** 商品价格*/@Field(type = FieldType.Double)private Double price;/*** 图片地址*/@Field(type = FieldType.Keyword, index = false)private String images;}
配置类
- ElasticsearchRestTemplate是spring-data-elasticsearch项目中的一个类,和其他spring项目中的 template类似。在新版的spring-data-elasticsearch 中,ElasticsearchRestTemplate 代替了原来的ElasticsearchTemplate。
- 原因是ElasticsearchTemplate基于TransportClient,TransportClient即将在8.x 以后的版本中移除。所以,我们推荐使用ElasticsearchRestTemplate。
- ElasticsearchRestTemplate基于RestHighLevelClient客户端的。需要自定义配置类,继承AbstractElasticsearchConfiguration,并实现elasticsearchClient()抽象方法,创建RestHighLevelClient对象。
需要自定义配置类,继承AbstractElasticsearchConfiguration,并实现elasticsearchClient()抽象方法,创建RestHighLevelClient对象。
@ConfigurationProperties(prefix = "elasticsearch")@Configuration@Datapublic class ElasticsearchConfig extends AbstractElasticsearchConfiguration {private String host;private Integer port;@Overridepublic RestHighLevelClient elasticsearchClient() {RestClientBuilder builder = RestClient.builder(new HttpHost(host, port));RestHighLevelClient restHighLevelClient = new RestHighLevelClient(builder);return restHighLevelClient;}}
- AbstractElasticsearchConfiguration源码: ```java package org.springframework.data.elasticsearch.config;
import org.elasticsearch.client.RestHighLevelClient; import org.springframework.context.annotation.Bean; import org.springframework.data.elasticsearch.core.ElasticsearchOperations; import org.springframework.data.elasticsearch.core.ElasticsearchRestTemplate;
public abstract class AbstractElasticsearchConfiguration extends ElasticsearchConfigurationSupport { public AbstractElasticsearchConfiguration() { }
public abstract RestHighLevelClient elasticsearchClient();@Bean(name = {"elasticsearchOperations", "elasticsearchTemplate"})public ElasticsearchOperations elasticsearchOperations() {return new ElasticsearchRestTemplate(this.elasticsearchClient(), this.elasticsearchConverter(), this.resultsMapper());}
}
<a name="TPmzz"></a>#### DAO数据访问对象```javaimport com.tian996.elasticsearch.entity.Product;import org.springframework.data.elasticsearch.repository.ElasticsearchRepository;import org.springframework.stereotype.Repository;@Repositorypublic interface ProductDao extends ElasticsearchRepository<Product,Long> {}
索引操作
import com.tian996.elasticsearch.entity.Product;import org.junit.Test;import org.junit.runner.RunWith;import org.springframework.beans.factory.annotation.Autowired;import org.springframework.boot.test.context.SpringBootTest;import org.springframework.data.elasticsearch.core.ElasticsearchRestTemplate;import org.springframework.test.context.junit4.SpringRunner;@RunWith(SpringRunner.class)@SpringBootTestpublic class SpringDataESIndexTest {@Autowiredprivate ElasticsearchRestTemplate elasticsearchRestTemplate;@Testpublic void createIndex(){//创建索引,系统初始化会自动创建索引boolean index = elasticsearchRestTemplate.createIndex(Product.class);System.out.println("创建索引 = " + index);}@Testpublic void deleteIndex(){//创建索引,系统初始化会自动创建索引boolean flg = elasticsearchRestTemplate.deleteIndex(Product.class);System.out.println("删除索引 = " + flg);}}
- 用Postman 检测有没有创建和删除。
#GET http://localhost:9200/_cat/indices?v
文档操作
```java import com.tian996.elasticsearch.dao.ProductDao; import com.tian996.elasticsearch.entity.Product; import org.junit.Test; import org.junit.runner.RunWith; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.test.context.SpringBootTest; import org.springframework.data.domain.Page; import org.springframework.data.domain.PageRequest; import org.springframework.data.domain.Sort; import org.springframework.test.context.junit4.SpringRunner;
import java.util.ArrayList; import java.util.List;
@RunWith(SpringRunner.class) @SpringBootTest public class SpringDataESProductDaoTest {
@Autowiredprivate ProductDao productDao;/*** 新增* POSTMAN, GET http://localhost:9200/product/_doc/1*/@Testpublic void save(){Product images = Product.builder().id(1L).title("华为手机").category("手机").price(4999.0).images("http://www.atguigu/hw.jpg").build();productDao.save(images);
// Product images2 = Product.builder().id(2L).title(“小米手机”).category(“手机”).price(2999.0).images(“http://www.atguigu/hw.jpg").build(); // productDao.save(images2); }
/*** 修改* POSTMAN, GET http://localhost:9200/product/_doc/1*/@Testpublic void update(){Product product = Product.builder().id(2L).title("小米 2 手机").category("手机").price(9999.0).images("http://www.atguigu/xm.jpg").build();productDao.save(product);}/*** 根据 id 查询**/@Testpublic void findById(){Product product = productDao.findById(1L).get();System.out.println(product.toString());}@Testpublic void findAll(){Iterable<Product> products = productDao.findAll();for (Product product : products) {System.out.println(product);}}/*** 删除*/@Testpublic void delete(){Product product = new Product();product.setId(2L);productDao.delete(product);}/*** 批量新增*/@Testpublic void saveAll(){List<Product> productList = new ArrayList<>();for (int i = 10; i < 20; i++) {Product product = Product.builder().id(Long.valueOf(i)).title("["+i+"]小米手机").category("手机").price(2999.0).images("http://www.atguigu/hw.jpg").build();productList.add(product);}productDao.saveAll(productList);}/*** 分页查询*/@Testpublic void findByPageable(){//设置排序(排序方式,正序还是倒序,排序的 id)Sort sort = Sort.by(Sort.Direction.DESC,"id");//当前页,第一页从 0 开始, 1 表示第二页int currentPage=0;//每页显示多少条int pageSize = 5;//设置查询分页PageRequest pageRequest = PageRequest.of(currentPage, pageSize,sort);//分页查询Page<Product> productPage = productDao.findAll(pageRequest);for (Product Product : productPage.getContent()) {System.out.println(Product);}}
}
<a name="jQRhn"></a># Spark Streaming 框架集成<a name="pVTGb"></a>## Spark Streaming 框架介绍Spark Streaming 是 Spark core API 的扩展,支持实时数据流的处理,并且具有可扩展,高吞吐量,容错的特点。数据可以从许多来源获取,如 Kafka,Flume,Kinesis 或 TCP sockets,并且可以使用复杂的算法进行处理,这些算法使用诸如 map,reduce,join 和 window 等高级函数表示。 最后,处理后的数据可以推送到文件系统,数据库等。 实际上,您可以将Spark 的机器学习和图形处理算法应用于数据流。<br />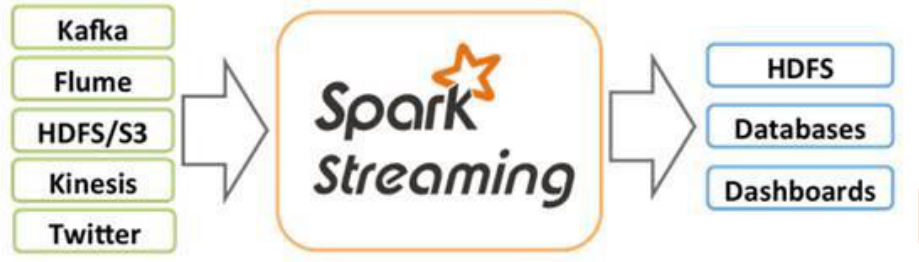**需要有scala编程语言**<a name="kg2E6"></a>## 创建elasticsearch-sparkstreaming项目<a name="ILmF5"></a>### 修改pom文件,增加依赖关系```xml<dependencies><dependency><groupId>org.apache.spark</groupId><artifactId>spark-core_2.12</artifactId><version>3.0.0</version></dependency><dependency><groupId>org.apache.spark</groupId><artifactId>spark-streaming_2.12</artifactId><version>3.0.0</version></dependency><dependency><groupId>org.elasticsearch</groupId><artifactId>elasticsearch</artifactId><version>7.9.3</version></dependency><!-- elasticsearch 的客户端 --><dependency><groupId>org.elasticsearch.client</groupId><artifactId>elasticsearch-rest-high-level-client</artifactId><version>7.9.3</version></dependency><!-- elasticsearch 依赖 2.x 的 log4j --><dependency><groupId>org.apache.logging.log4j</groupId><artifactId>log4j-api</artifactId><version>2.8.2</version></dependency><dependency><groupId>org.apache.logging.log4j</groupId><artifactId>log4j-core</artifactId><version>2.8.2</version></dependency><!-- <dependency>--><!-- <groupId>com.fasterxml.jackson.core</groupId>--><!-- <artifactId>jackson-databind</artifactId>--><!-- <version>2.11.1</version>--><!-- </dependency>--><!-- <!– junit 单元测试 –>--><!-- <dependency>--><!-- <groupId>junit</groupId>--><!-- <artifactId>junit</artifactId>--><!-- <version>4.12</version>--><!-- </dependency>--></dependencies>
功能实现(不会scala语法直接拷贝的教程代码)
package com.atguigu.esimport org.apache.http.HttpHostimport org.apache.spark.SparkConfimport org.apache.spark.streaming.dstream.ReceiverInputDStreamimport org.apache.spark.streaming. {Seconds,StreamingContext}import org.elasticsearch.action.index.IndexRequestimport org.elasticsearch.client.indices.CreateIndexRequestimport org.elasticsearch.client. {RequestOptions,RestClient,RestHighLevelClient}import org.elasticsearch.common.xcontent.XContentTypeimport java.util.Dateobject SparkStreamingESTest {def main(args: Array[String]) : Unit = {val sparkConf = new SparkConf().setMaster("local[*]").setAppName("ESTest")val ssc = new StreamingContext(sparkConf, Seconds(3))val ds: ReceiverInputDStream[String] = ssc.socketTextStream("localhost", 9999)ds.foreachRDD(rdd = >{println("*************** " + new Date())rdd.foreach(data = >{val client = new RestHighLevelClient(RestClient.builder(new HttpHost("localhost", 9200, "http")));// 新增文档 - 请求对象val request = new IndexRequest();// 设置索引及唯一性标识val ss = data.split(" ") println("ss = " + ss.mkString(",")) request.index("sparkstreaming").id(ss(0));val productJson =s """| { "data ":"$ {ss(1)}" }|""".stripMargin;// 添加文档数据,数据格式为 JSON 格式request.source(productJson, XContentType.JSON);// 客户端发送请求,获取响应对象val response = client.index(request, RequestOptions.DEFAULT);System.out.println("_index:" + response.getIndex());System.out.println("_id:" + response.getId());System.out.println("_result:" + response.getResult());client.close()})})ssc.start()ssc.awaitTermination()}}
Flink 框架集成
Flink 框架介绍

Apache Spark 是一种基于内存的快速、通用、可扩展的大数据分析计算引擎。
Apache Spark 掀开了内存计算的先河,以内存作为赌注,赢得了内存计算的飞速发展。
但是在其火热的同时,开发人员发现,在 Spark 中,计算框架普遍存在的缺点和不足依然没
有完全解决,而这些问题随着 5G 时代的来临以及决策者对实时数据分析结果的迫切需要而
凸显的更加明显:
- 数据精准一次性处理(Exactly-Once)
- 乱序数据,迟到数据
- 低延迟,高吞吐,准确性
- 容错性
Apache Flink 是一个框架和分布式处理引擎,用于对无界和有界数据流进行有状态计算。在 Spark 火热的同时,也默默地发展自己,并尝试着解决其他计算框架的问题。 慢慢地,随着这些问题的解决,Flink 慢慢被绝大数程序员所熟知并进行大力推广,阿里公 司在 2015 年改进 Flink,并创建了内部分支 Blink,目前服务于阿里集团内部搜索、推荐、 广告和蚂蚁等大量核心实时业务。
创建elasticsearch-flink项目
修改pom文件,增加依赖关系
<dependencies><dependency><groupId>org.apache.flink</groupId><artifactId>flink-scala_2.12</artifactId><version>1.12.0</version></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-streaming-scala_2.12</artifactId><version>1.12.0</version></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-clients_2.12</artifactId><version>1.12.0</version></dependency><dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-elasticsearch7_2.11</artifactId><version>1.12.0</version></dependency><!-- jackson --><dependency><groupId>com.fasterxml.jackson.core</groupId><artifactId>jackson-core</artifactId><version>2.11.1</version></dependency></dependencies>
功能实现(不会scala语法直接拷贝的教程代码)
package com.atguigu.es;import org.apache.flink.api.common.functions.RuntimeContext;import org.apache.flink.streaming.api.datastream.DataStreamSource;import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;import org.apache.flink.streaming.connectors.elasticsearch.ElasticsearchSinkFunction;import org.apache.flink.streaming.connectors.elasticsearch.RequestIndexer;import org.apache.flink.streaming.connectors.elasticsearch7.ElasticsearchSink;import org.apache.http.HttpHost;import org.elasticsearch.action.index.IndexRequest;import org.elasticsearch.client.Requests;import java.util.ArrayList;import java.util.HashMap;import java.util.List;import java.util.Map;public class FlinkElasticsearchSinkTest {public static void main(String[] args) throws Exception {StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();DataStreamSource<String> source = env.socketTextStream("localhost", 9999);List<HttpHost> httpHosts = new ArrayList<>();httpHosts.add(new HttpHost("127.0.0.1", 9200, "http"));//httpHosts.add(new HttpHost("10.2.3.1", 9200, "http"));// use a ElasticsearchSink.Builder to create an ElasticsearchSinkElasticsearchSink.Builder<String> esSinkBuilder = new ElasticsearchSink.Builder<>(httpHosts,new ElasticsearchSinkFunction<String>() {public IndexRequest createIndexRequest(String element) {Map<String, String> json = new HashMap<>();json.put("data", element);return Requests.indexRequest().index("my-index")//.type("my-type").source(json);}@Overridepublic void process(String element, RuntimeContext ctx, RequestIndexer indexer) {indexer.add(createIndexRequest(element));}});// configuration for the bulk requests; this instructs the sink to emit after every element, otherwise they would be bufferedesSinkBuilder.setBulkFlushMaxActions(1);// provide a RestClientFactory for custom configuration on the internally created REST client// esSinkBuilder.setRestClientFactory(// restClientBuilder -> {// restClientBuilder.setDefaultHeaders(...)// restClientBuilder.setMaxRetryTimeoutMillis(...)// restClientBuilder.setPathPrefix(...)// restClientBuilder.setHttpClientConfigCallback(...)// }// );source.addSink(esSinkBuilder.build());env.execute("flink-es");}}

若有收获,就点个赞吧
0 人点赞


.build()