1. MapReduce思想
MapReduce的思想核⼼是分而治之
MapReduce任务过程是分为两个处理阶段:
- Map阶段
Map阶段的主要作⽤是“分”,即把复杂的任务分解为若干个“简单的任务”来并⾏处理。 Map阶段的这些任务可以并行计算,彼此间没有依赖关系。
- Reduce阶段
Reduce阶段的主要作⽤是“合”,即对map阶段的结果进⾏全局汇总。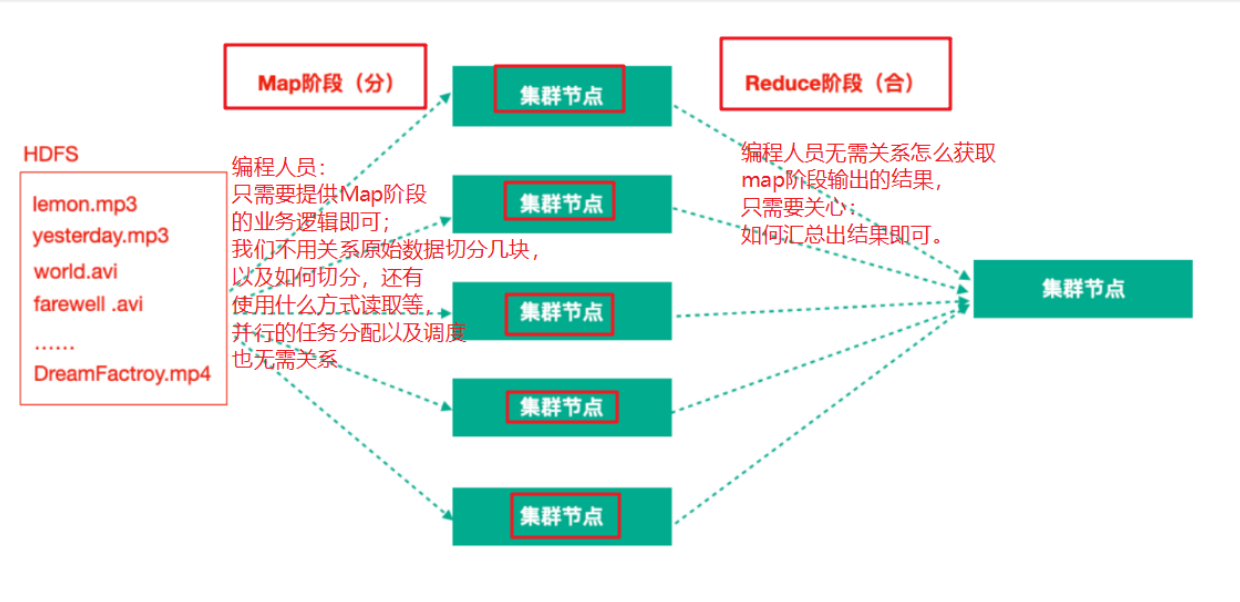
2. MapReduce编程规范
2.1 序列化
序列化主要是我们通过网络通信传输数据时或者把对象持久化到⽂件,需要把对象序列化成⼆进制的结构。
- Hadoop使用的是自己的序列化格式Writable,它比java的序列化serialization更紧凑速度更快。⼀个对象使用Serializable序列化后,会携带很多额外信息比如校验信息,Header,继承体系等。
为什么Hadoop要选择建立自己的序列化格式而不使用java自带serializable
- 序列化在分布式程序中非常重要,在Hadoop中,集群中多个节点的进程间的通信是通过RPC(远程过程调用:Remote Procedure Call)实现;RPC将消息序列化成⼆进制流发送到远程节点,远程节点再将接收到的⼆进制数据反序列化为原始的消息,因此RPC往往追求如下特点:
- 紧凑:数据更紧凑,能充分利⽤网络带宽资源
- 快速:序列化和反序列化的性能开销更低
Java基本数据类型与Hadoop常用序列化类型
| Java基本数据类型 | Hadoop Writable类型 | | —- | —- | | boolean | BooleanWritable | | byte | ByteWritable | | int | IntWritable | | float | FloatWritable | | long | LongWritable | | double | DoubleWritable | | String | Text | | map | MapWritable | | array | ArrayWritable |
自定义类序列化
基本序列化类型往往不能满足所有需求,⽐如在Hadoop框架内部传递⼀个自定义bean对象,那么该对象就需要实现Writable序列化接口
步骤
- 实现writalbe接口
- 必须有空参构造,反序列化时需要反射调用空参构造函数
重写序列化方法
@Overridepublic void write(DataOutput out) throws IOException {out.writeUTF(name);out.writeLong(money);....}
重写发序列化方法
@Overridepublic void readFields(DataInput in) throws IOException {this.name = in.readUTF(name);this.money = in.readLong(money);....}
反序列化的字段顺序和序列化字段的顺序必须完全一致
- ⽅便展示结果数据,需要重写bean对象的toString()⽅法,可以⾃定义分隔符
- 如果⾃定义Bean对象需要放在Mapper输出KV中的K,则该对象还需实现Comparable接口,因为MapReduce框中的Shuffle过程要求对key必须能排序!!
2.2 Mapper类
- 用户自定义一个Mapper类继承Hadoop的Mapper类
- Mapper的输入数据KV对的形式(类型可以自定义)
- 重写map方法,即Map阶段的业务逻辑
- Mapper的输出数据是KV对的形式(类型可以自定义)
注意:map()方法是对输入的一个KV对调用一次
以单词统计为例
Hadoop mr glhhive mr hadoopglh nn haoop
public class WordCountMapper extends Mapper<LongWritable, Text, Text, IntWritable> {// 第一组kv对代表输入数据类型// LongWriteable 代表文本偏移量,我们每行都从头读取,这里没用到// Text 代表文本// 第二组kv对代表输出数据类型// Text 代表文本,即单词// IntWritable 代表int型数据,/*1 接收到文本内容,转为String类型2 按照空格进行切分3 输出<单词,1>*///提升为全局变量,避免每次执行map方法都执行此操作final Text word = new Text();final IntWritable one = new IntWritable(1);// LongWritable, Text-->文本偏移量,一行文本内容,map方法的输入参数,一行文本就调用一次map方法@Overrideprotected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {// 1 接收到文本内容,转为String类型 即每次调用map方法,输入了一行数据 例如"Hadoop mr glh"final String str = value.toString();// 2 按照空格进行切分final String[] words = str.split(" ");// 3 输出<单词,1>//遍历数据for (String s : words) {word.set(s);context.write(word, one);}}}// 经过map后输出了多对的KV 形如<Hadoop,1>,<mr,1>,<glh,1>,<Hadoop,1>...
2.3 Reducer类
- ⽤户⾃定义Reducer类要继承Hadoop的Reducer类
- Reducer的输⼊数据类型对应Mapper的输出数据类型(KV对)
- Reducer的业务逻辑写在reduce()⽅法中
- Reduce()方法是对相同K的⼀组KV对调用执行⼀次
例如 map输出
则reduce的输入为
//继承的Reducer类有四个泛型参数,2对kv//第一对kv:类型要与Mapper输出类型一致:Text, IntWritable//第二队kv:自己设计决定输出的结果数据是什么类型:Text, IntWritablepublic class WordCountReducer extends Reducer<Text, IntWritable, Text, IntWritable> {//1 重写reduce方法//Text key:map方法输出的key,本案例中就是单词,// Iterable<IntWritable> values:一组key相同的kv的value组成的集合/*假设map方法输出:hello 1;hello 1;hello 1,hadoop 1, mapreduce 1,hadoop 1reduce的key和value是什么?reduce方法何时调用:一组key相同的kv中的value组成集合然后调用一次reduce方法第一次:key:hello ,values:<1,1,1>第二次:key:hadoop ,values<1,1>第三次:key:mapreduce ,values<1>*/IntWritable total = new IntWritable();@Overrideprotected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {//2 遍历key对应的values,然后累加结果int sum = 0;for (IntWritable value : values) {int i = value.get();sum += 1;}// 3 直接输出当前key对应的sum值,结果就是单词出现的总次数total.set(sum);context.write(key, total);}}
2.4 Driver阶段
创建提交YARN集群运⾏的Job对象,其中封装了MapReduce程序运⾏所需要的相关参数,输入数据路径,输出数据路径等,也相当于是⼀个YARN集群的客户端,主要作⽤就是提交我们MapReduce程序运行。
public class DataDriver {public static void main(String[] args) {// 1. 获取配置文件对象,获取job对象实例Configuration conf = new Configuration();Job job =null;boolean flag = false;try {job = Job.getInstance(conf, "DataDriver");} catch (IOException e) {e.printStackTrace();}// 2. 指定程序jar的本地路径job.setJarByClass(DataDriver.class);// 3. 指定Mapper/Reducer类job.setMapperClass(DataMapper.class);job.setReducerClass(DateReducer.class);// 4. 指定Mapper输出的kv数据类型job.setMapOutputKeyClass(IntWritable.class);job.setMapOutputValueClass(NullWritable.class);// 5. 指定最终输出的kv数据类型job.setOutputKeyClass(IntWritable.class);job.setOutputValueClass(IntWritable.class);// 6. 指定job处理的原始数据路径try {FileInputFormat.setInputPaths(job,new Path("E:\\hadooptest\\hwinput"));} catch (IOException e) {e.printStackTrace();}// 7. 指定job输出结果路径FileOutputFormat.setOutputPath(job,new Path("e:\\hadooptest\\hwoutput"));// 8. 提交作业try {flag = job.waitForCompletion(true);} catch (IOException | InterruptedException | ClassNotFoundException e) {e.printStackTrace();}System.exit(flag?0:1);}}
2.5 运行任务
2.5.1 本地运行
参考pom.xmlpom.xml
参考log4j.propertieslog4j.zip
直接在IDEA中运行驱动类即可,使用多线程模拟
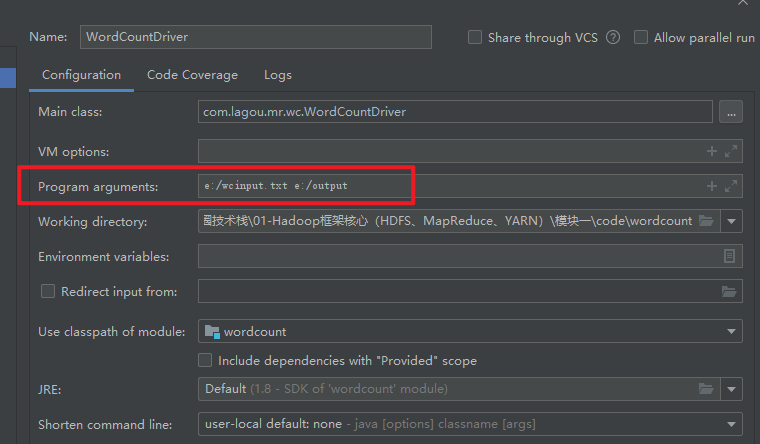
如果main方法需要传入参数,如下所示,运行结束后去输出结果路径查看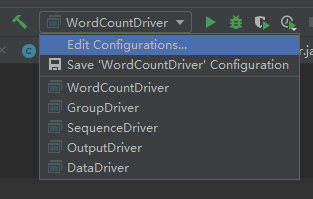
2.5.2 yarn集群模式运行
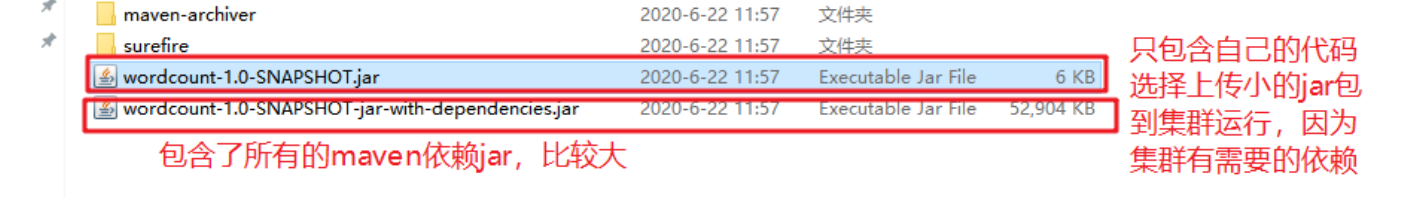
- 把程序打成jar包,上传到Linux,选择较小的那个(只包含自己的代码,没有依赖)
- 准备原始数据文件,上传到HDFS
- 使用Hadoop命令提交任务运行
hadoop jar xx.jar 驱动类的全限定名 输入文件路径 输出文件路径hadoop jar wc.jar com.lagou.wordcount.WordcountDriver /user/lagou/input /lagou/output
3. MapReduce原理分析及高级命令
3.1 MapTask运行机制详解
MapTask流程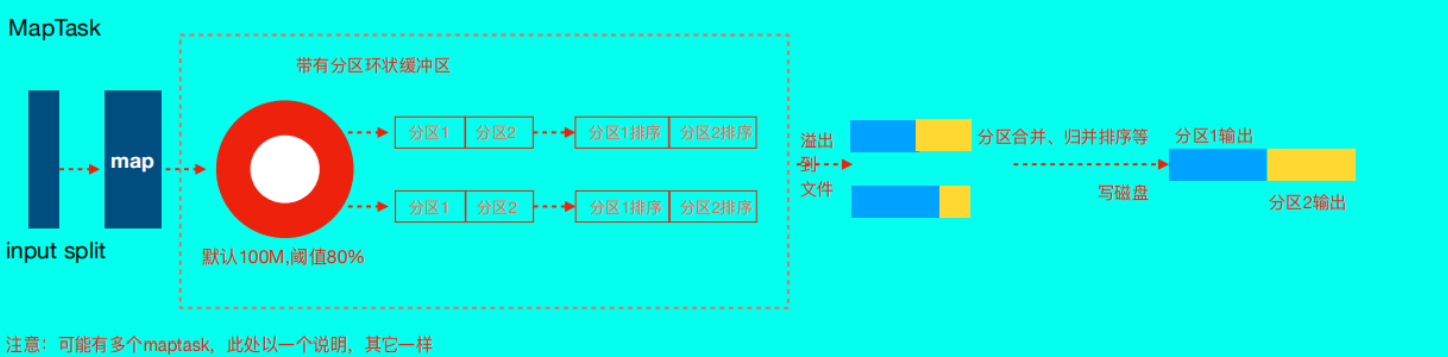
详细步骤
- ⾸先,读取数据组件InputFormat(默认TextInputFormat)会通过getSplits⽅法对输入目录中的文件进⾏逻辑切⽚规划得到splits,有多少个split就对应启动多少个MapTask。split与block的对应关系默认是⼀对⼀。
- 将输入文件切分为splits之后,由RecordReader对象(默认LineRecordReader)进⾏读取,以\n作为分隔符,读取⼀⾏数据,返回
。Key表示每⾏⾸字符偏移值,value表示这⼀⾏⽂本内容。 - 读取split返回
- map逻辑完之后,将map的每条结果通过context.write进⾏collect数据收集。在collect中,会先对其进⾏分区处理,默认使⽤HashPartitioner。MapReduce提供Partitioner接口,它的作⽤就是根据key或value及reduce的数量来决定当前的这对输出数据最终应该交由哪个reduce task处理。默认对key hash后再以reduce task数量取模。默认的取模⽅式只是为了平均reduce的处理能⼒,如果⽤户⾃⼰对Partitioner有需求,可以订制并设置到job上。一个分区对应一个ReduceTask,对应一个最终输出文件。
- 接下来会将数据写⼊内存,内存中这⽚区域叫做环形缓冲区,缓冲区的作⽤是批量收集map结果,减少磁盘IO的影响。我们的key/value对以及Partition的结果都会被写⼊缓冲区。当然写⼊之前,key与value值都会被序列化成字节数组。
- 环形缓冲区其实是⼀个数组,数组中存放着key、value的序列化数据和key、value的元数据信息,包括partition、key的起始位置、value的起始位置以及value的⻓度。环形结构是⼀个抽象概念。缓冲区是有⼤⼩限制,默认是100MB。当map task的输出结果很多时,就可能会撑爆内存,所以需要在⼀定条件下将缓冲区中的数据临时写⼊磁盘,然后重新利⽤这块缓冲区。这个从内存往磁盘写数据的过程被称为Spill,中⽂可译为溢写。这个溢写是由单独线程来完成,不影响往缓冲区写map结果的线程。溢写线程启动时不应该阻⽌map的结果输出,所以整个缓冲区有个溢写的⽐例spill.percent。这个⽐例默认是0.8,也就是当缓冲区的数据已经达到阈值(buffer size spill percent = 100MB 0.8 = 80MB),溢写线程启动,锁定这80MB的内存,执⾏溢写过程。Maptask的输出结果还可以往剩下的20MB内存中写,互不影响。
- 当溢写线程启动后,需要对这80MB空间内的key做排序(Sort)。排序是MapReduce模型默认的行为! 如果job设置过Combiner,那么现在就是使⽤Combiner的时候了。将有相同key的key/value对的value加起来,减少溢写到磁盘的数据量。Combiner会优化MapReduce的中间结果,所以它在整个模型中会多次使⽤。
- 那哪些场景才能使⽤Combiner呢?从这⾥分析,Combiner的输出是Reducer的输⼊,Combiner绝不能改变最终的计算结果。Combiner只应该⽤于那种Reduce的输⼊key/value与输出key/value类型完全⼀致,且不影响最终结果的场景。比如累加,最⼤值等。Combiner的使⽤⼀定得慎重,如果⽤好,它对job执⾏效率有帮助,反之会影响reduce的最终结果。
- 合并溢写⽂件:每次溢写会在磁盘上⽣成⼀个临时⽂件(写之前判断是否有combiner),如果map的输出结果真的很⼤,有多次这样的溢写发⽣,磁盘上相应的就会有多个临时⽂件存在。当整个数据处理结束之后开始对磁盘中的临时⽂件进行merge合并(也会排序),因为最终的⽂件只有⼀个,写⼊磁盘,并且为这个⽂件提供了⼀个索引⽂件,以记录每个reduce对应数据的偏移量。
至此map整个阶段结束!!
MapTask的一些配置
https://hadoop.apache.org/docs/r2.9.2/hadoop-mapreduce-client/hadoopmapreduce-client-core/mapred-default.xml
3.2 MapTask的并行度
MapTask的并行度决定Map阶段的任务处理并发度,从而影响到整个Job的处理速度。切片数量决定了MapTask数量。
数据块:Block是HDFS物理上把数据分成⼀块⼀块。
切片:数据切片只是在逻辑上对输入进行切片,并不会在磁盘上将其切分成片进⾏存储。
移动计算就是指把代码分发到对应的服务器运行,代码比数据小多了。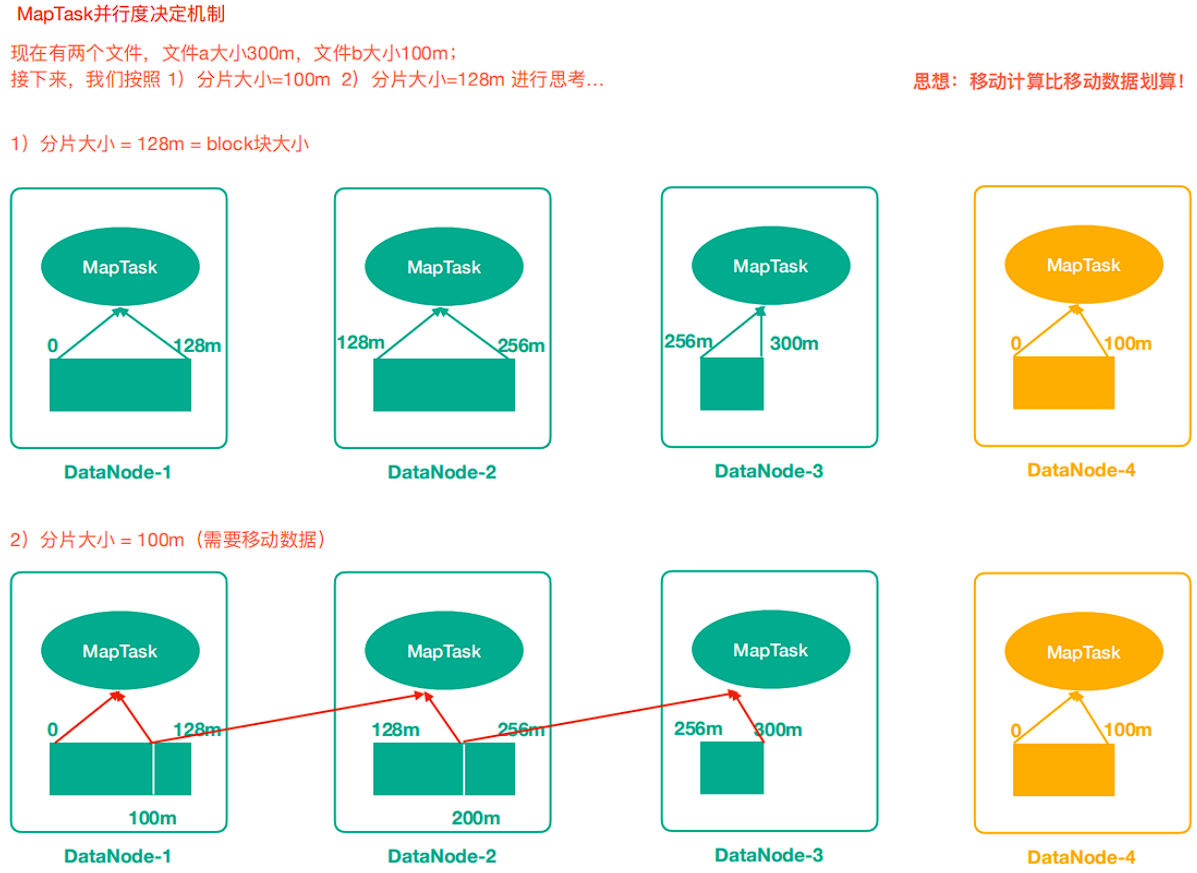
3.3 ReduceTask工作机制
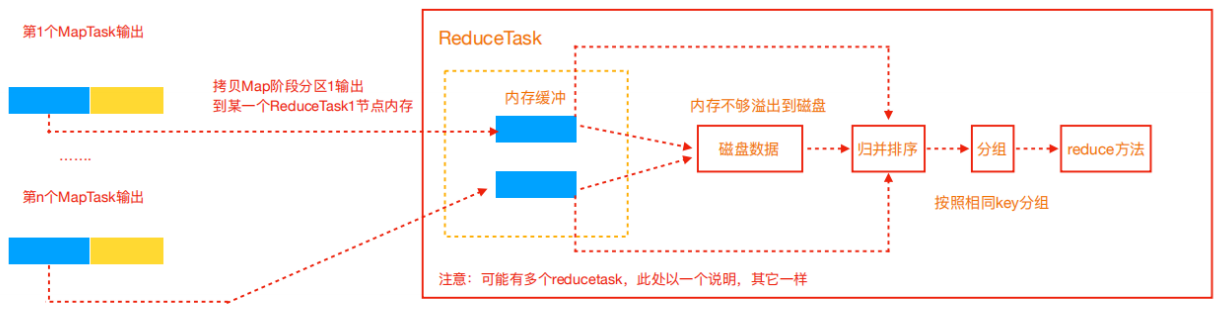
Reduce⼤致分为copy、sort、reduce三个阶段,重点在前两个阶段。
copy阶段包含⼀个 eventFetcher来获取已完成的map列表,由Fetcher线程去copy数据,在此过程中会启动两个merge线程,分别为inMemoryMerger和onDiskMerger,分别将内存中的数据merge到磁盘和将磁盘中的数据进⾏merge。
待数据copy完成之后,copy阶段就完成了,开始进⾏sort阶段,sort阶段主要是执⾏ finalMerge操作,纯粹的sort阶段。
完成之后就是reduce阶段,调⽤⽤户定义的reduce函数进⾏处理。
详细步骤
- Copy阶段,简单地拉取数据。Reduce进程启动⼀些数据copy线程(Fetcher),通过HTTP⽅式请求 maptask获取属于自己的文件。
- Merge阶段。这里的merge如map端的merge动作,只是数组中存放的是不同map端copy来的数值。Copy过来的数据会先放⼊内存缓冲区中,这⾥的缓冲区大小要比map端的更为灵活。merge 有三种形式:内存到内存;内存到磁盘;磁盘到磁盘。默认情况下第⼀种形式不启用。当内存中的数据量到达⼀定阈值,就启动内存到磁盘的merge。与map 端类似,这也是溢写的过程,这个过程中如果你设置有Combiner,也是会启用的,然后在磁盘中⽣成了众多的溢写文件。第⼆种 merge⽅式⼀直在运⾏,直到没有map端的数据时才结束,然后启动第三种磁盘到磁盘的merge方式生成最终的⽂件。 合并排序,把分散的数据合并成⼀个⼤的数据后,还会再对合并后的数据排序。 对排序后的键值对调⽤reduce方法,键相等的键值对调⽤⼀次reduce方法,每次调⽤会产⽣零个或者多个键值对,最后把这些输出的键值对写入到HDFS文件中。
3.4 ReduceTask并行度
ReduceTask的并⾏度同样影响整个Job的执行并发度和执⾏效率,但与MapTask的并发数由切片数决定不同,ReduceTask数量的决定是可以直接⼿动设置:
注意事项// 默认值是1,手动设置为4job.setNumReduceTasks(4)
- ReduceTask=0,表示没有Reduce阶段,输出⽂件数和MapTask数量保持⼀致;
- ReduceTask数量不设置默认就是⼀个,输出⽂件数量为1个;
-
3.5 Shuffle机制
map阶段处理的数据如何传递给reduce阶段,是MapReduce框架中最关键的⼀个流程,这个流程就叫 shuffle。
shuffle: 洗牌、发牌——(核心机制:数据分区,排序,分组,combine,合并等过程)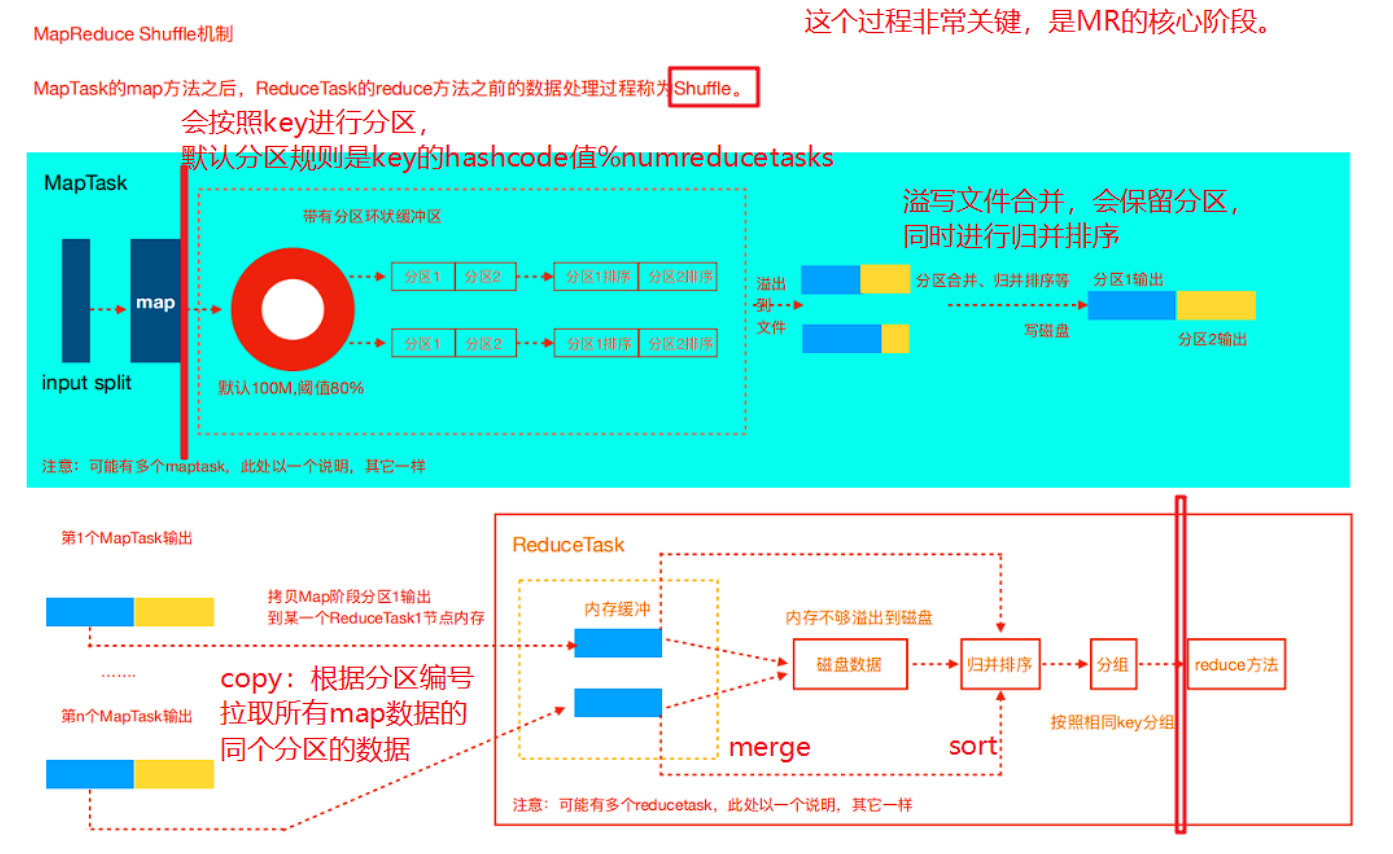
3.5.1 MapReduce的分区与reduceTask的数量
在MapReduce中,通过我们指定分区,会将同⼀个分区的数据发送到同⼀个reduce当中进⾏处理(默认 是key相同去往同个分区),例如我们为了数据的统计,我们可以把⼀批类似的数据发送到同⼀个reduce 当中去,在同⼀个reduce当中统计相同类型的数据, 如何才能保证相同key的数据去往同个reduce呢?只需要保证相同key的数据分发到同个分区即可。此处的KV指map输出的KV。
分区源码
翻阅源码验证以上规则,MR程序默认使⽤的HashPartitioner,保证了相同的key去往同个分区!!
假如numReduceTasks=2,则取余结果为0或1,0分区的数据去往 a ReduceTask,1分区的数据去往b ReduceTask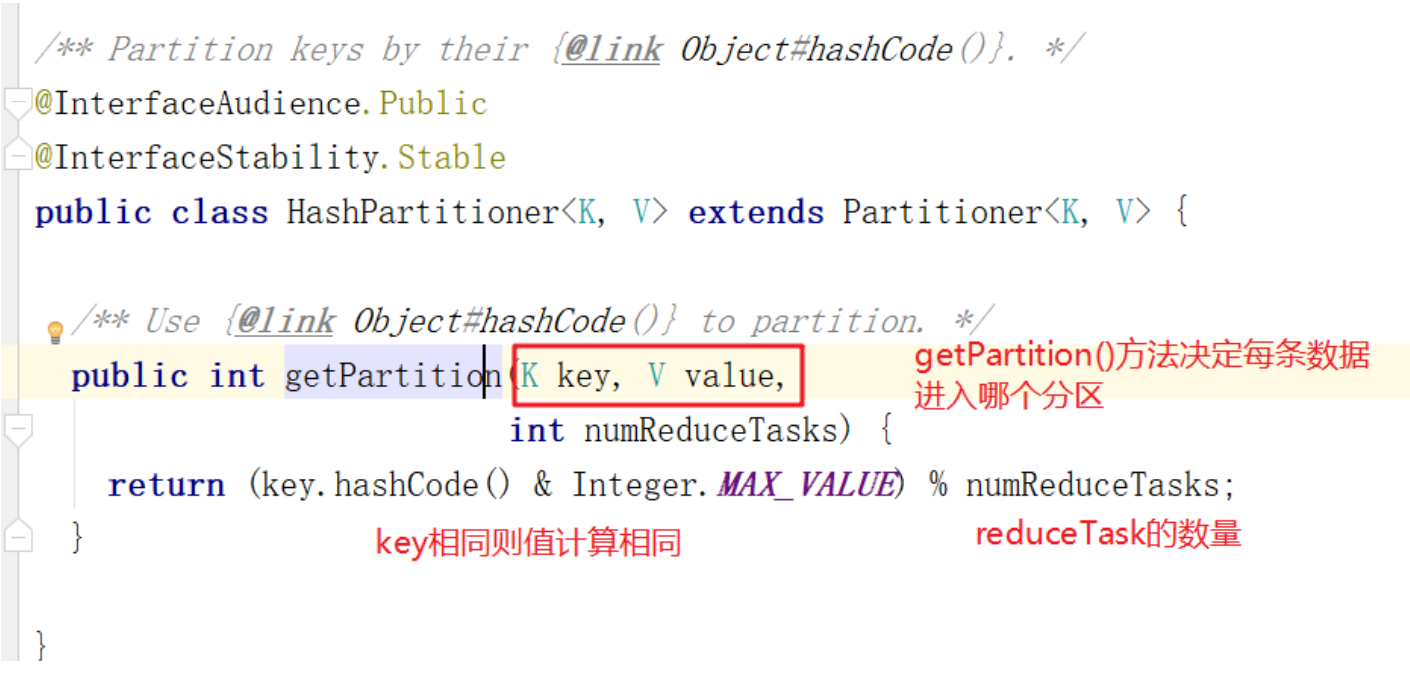
自定义分区Partitioner
步骤
自定义类继承Partitioner,重写getPartition()方法
- 在Driver驱动中,指定使用自定义Partitioner
- 在Driver驱动中,根据自定义分区的逻辑设置相应数量的ReduceTask数量
总结
- ⾃定义分区器时最好保证分区数量与reduceTask数量保持⼀致;
- 如果分区数量不止1个,但是reduceTask数量1个,此时只会输出⼀个⽂件。
- 如果reduceTask数量大于分区数量,会输出多个空⽂件
-
3.5.2 Combiner
Combiner是MR程序中Mapper和Reducer之外的⼀种组件
- Combiner组件的⽗类就是Reducer
- Combiner和reducer的区别在于运⾏的位置
- MaptTask溢写时会调用combiner,进行局部汇总,减小文件容量
- ReduceTask拷贝数据从内存merge到磁盘时,也会调用combiner,进行局部汇总
- Combiner的意义就是对每⼀个maptask的输出进⾏局部汇总,以减小网络传输量。
- Combiner能够应⽤的前提是不能影响最终的业务逻辑,此外,Combiner的输出kv应该跟reducer
的输⼊kv类型要对应起来。
自定义combiner
- 自定义combiner继承reduce,重写reduce方法
-
3.6 MapReduce中的排序
排序是MapReduce框架中最重要的操作之⼀
MapTask和ReduceTask均会对数据按照key进⾏排序。该操作属于Hadoop的默认行为。任何应⽤程序中的数据均会被排序,而不管逻辑上是否需要。默认排序是按照字典顺序排序,且实现该排序的⽅法是快速排序。 MapTask
- 它会将处理的结果暂时放到环形缓冲区中,当环形缓冲区使⽤率达到⼀定阈值后,再对缓冲区中的数据进行⼀次快速排序,并将这些有序数据溢写到磁盘上
- 溢写完毕后,它会对磁盘上所有文件进⾏归并排序
- ReduceTask
当所有数据拷贝完毕后,ReduceTask统一对内存和磁盘上的所有数据进行⼀次归并排序。
- 部分排序. MapReduce根据输⼊记录的键对数据集排序。保证输出的每个⽂件内部有序。
- 全排序 最终输出结果只有⼀个⽂件,且⽂件内部有序。实现⽅式是只设置一个ReduceTask。但该方法在处理大型⽂件时效率极低,因为一台机器处理所有⽂件,完全丧失了MapReduce所提供的并⾏架构。
- 辅助排序: ( GroupingComparator分组) 在Reduce端对key进⾏分组(相同key分为1组)。应用于在接收的key为bean对象时,想让⼀个或几个字段相同(全部字段比较相同)的key进⼊到同⼀个reduce⽅法时,可以采⽤分组排序。
- ⼆次排序. 在⾃定义排序过程中,如果compareTo中的判断条件为两个即为⼆次排序。
WritableComparable接口
Bean对象如果作为Map输出的key时,需要实现WritableComparable接⼝并重写compareTo⽅法指定排序规则
GroupingComparator
GroupingComparator是mapreduce当中reduce端的⼀个功能组件,主要的作⽤是决定哪些数据作为⼀组,调用⼀次reduce的逻辑
默认是每个不同的key,作为多个不同的组,每个组调用⼀次reduce逻辑,我们可以⾃定义GroupingComparator实现不同的key作为同⼀个组,调用⼀次reduce逻辑。
public class CustomGroupingComparator extends WritableComparator {//将我们⾃定义的OrderBean注册到我们⾃定义的CustomGroupIngCompactor当中来//表示我们的分组器在分组的时候,对OrderBean这⼀种类型的数据进⾏分组//传⼊作为key的bean的class类型,以及制定需要让框架做反射获取实例对象public CustomGroupingComparator() {super(OrderBean.class, true);}@Overridepublic int compare(WritableComparable a, WritableComparable b) {OrderBean first = (OrderBean) a;OrderBean second = (OrderBean) b;final int i = first.getOrderId().compareTo(second.getOrderId());if (i == 0) {System.out.println(first.getOrderId() + "----" +second.getOrderId());}// i为0的就会进入同一个组return i;}}
3.7 MapReduce读取和输出数据
3.7.1 InputFormat
InputFormat是MapReduce框架用来读取数据的类。
常见子类包括:
- TextInputFormat (普通⽂本⽂件,MR框架默认的读取实现类型)
- KeyValueTextInputFormat(读取⼀⾏⽂本数据按照指定分隔符,把数据封装为kv类型)
- NLineInputFormat(读取数据按照⾏数进⾏划分分⽚)
- CombineTextInputFormat(合并小文件,避免启动过多MapTask任务)
-
CombineTextInputFormat
MR框架默认的TextInputFormat切片机制按文件划分切片,文件无论多小,都是单独⼀个切片, 然后由⼀个MapTask处理,如果有⼤量小文件,就对应的会生成并启动⼤量的 MapTask,而每个 MapTask处理的数据量很小,大量时间浪费在初始化资源启动收回等阶段,这种方式导致资源利用率不⾼。 CombineTextInputFormat用于小文件过多的场景,它可以将多个小文件从逻辑上划分成⼀个切片,这样多个小文件就可以交给⼀个MapTask处理,提高资源利用率。
使用方式 ```java // 如果不设置InputFormat,它默认⽤的是TextInputFormat.class job.setInputFormatClass(CombineTextInputFormat.class);
//虚拟存储切⽚最⼤值设置4m,设置越大,最终切片数量越小 CombineTextInputFormat.setMaxInputSplitSize(job, 4194304);
- **CombineTextInputFormat切片原理**切片生成过程分为两部分:虚拟存储过程和切片过程<br />假设设置setMaxInputSplitSize值为4M<br />四个小文件:1.txt -->2M ;2.txt-->7M;3.txt-->0.3M;4.txt--->8.2M- **虚拟存储过程:**把输⼊⽬录下所有⽂件大小,依次和设置的setMaxInputSplitSize值进⾏比较,如果不⼤于设置的最⼤值,逻 辑上划分⼀个块。如果输⼊⽂件⼤于设置的最⼤值且⼤于两倍,那么以最⼤值切割⼀块;当剩余数据大小超 过设置的最⼤值且不⼤于最⼤值2倍,此时将⽂件均分成2个虚拟存储块(防止出现过小的块)。<br />1.txt-->2M;2M<4M;⼀个块;<br />2.txt-->7M;7M>4M,但是不⼤于两倍,均匀分成两块;两块:每块3.5M;<br />3.txt-->0.3M;0.3<4M ,0.3M<4M ,⼀个块<br />4.txt-->8.2M;⼤于最⼤值且⼤于两倍;⼀个4M的块,剩余4.2M分成两块,每块2.1M<br />所有块信息:<br />2M,3.5M,3.5M,0.3M,4M,2.1M,2.1M 共7个虚拟存储块。- **切片过程**判断虚拟存储的⽂件大小是否大于setMaxInputSplitSize值,大于等于单独形成⼀个切片。如果不大于则跟下⼀个虚拟存储⽂件进⾏合并,共同形成⼀个切片。<br />按照之前输⼊⽂件:有4个小文件大小分别为2M、7M、0.3M以及8.2M,<br />则虚拟存储之后形成7个⽂件块,大小分别为: 2M,3.5M,3.5M,0.3M,4M,2.1M,2.1M<br />最终会形成3个切⽚,大小分别为: (2+3.5)M,(3.5+0.3+4)M,(2.1+2.1)M<a name="Ckl3z"></a>#### 自定义InputFormatHDFS和MapReduce,在处理小文件时效率都非常低,但又难免面临处理大量小文件的场景,此时,就需要有相应解决⽅案。可以⾃定义InputFormat实现小文件的合并<br />**步骤**1. 定义一个类继承FileInputFormat1. 重写isSplitable()指定为不可切分;重写createRecordReader()方法,创建自己的RecorderReader对象1. 改写默认读取数据方式,实现一次读取一个完整文件作为kv输出1. Driver指定使用的InputFormat类型案列[sequence.zip](https://www.yuque.com/attachments/yuque/0/2020/zip/2639423/1602325782207-dfac8965-7a38-468e-a6b3-f0b649953ad4.zip?_lake_card=%7B%22uid%22%3A%221602325782767-0%22%2C%22src%22%3A%22https%3A%2F%2Fwww.yuque.com%2Fattachments%2Fyuque%2F0%2F2020%2Fzip%2F2639423%2F1602325782207-dfac8965-7a38-468e-a6b3-f0b649953ad4.zip%22%2C%22name%22%3A%22sequence.zip%22%2C%22size%22%3A4294%2C%22type%22%3A%22application%2Fx-zip-compressed%22%2C%22ext%22%3A%22zip%22%2C%22progress%22%3A%7B%22percent%22%3A99%7D%2C%22status%22%3A%22done%22%2C%22percent%22%3A0%2C%22id%22%3A%22gJW1t%22%2C%22card%22%3A%22file%22%7D)<a name="qVjNy"></a>### 3.7.2 OutputFormatOutputFormat:是MapReduce输出数据的基类,所有MapReduce的数据输出都实现了OutputFormat 抽象类。下面我们介绍⼏种常见的OutputFormat子类- TextOutputFormat默认的输出格式是TextOutputFormat,它把每条记录写为文本行。它的键和值可以是任意类型, 因为 TextOutputFormat调⽤toString()方法把它们转换为字符串- SequenceFileOutputFormat将SequenceFileOutputFormat输出作为后续MapReduce任务的输⼊,这是⼀种好的输出格式, 因为它的格式<br />紧凑,很容易被压缩。- 自定义OutputFormat- 自定义一个类继承FileOutputFormat- 改写RecordWriter,改写输出数据的方法write()案列[output.zip](https://www.yuque.com/attachments/yuque/0/2020/zip/2639423/1602326794611-45e6039b-8a26-462e-b845-6daf0c6f9259.zip?_lake_card=%7B%22uid%22%3A%221602326795190-0%22%2C%22src%22%3A%22https%3A%2F%2Fwww.yuque.com%2Fattachments%2Fyuque%2F0%2F2020%2Fzip%2F2639423%2F1602326794611-45e6039b-8a26-462e-b845-6daf0c6f9259.zip%22%2C%22name%22%3A%22output.zip%22%2C%22size%22%3A3328%2C%22type%22%3A%22application%2Fx-zip-compressed%22%2C%22ext%22%3A%22zip%22%2C%22progress%22%3A%7B%22percent%22%3A99%7D%2C%22status%22%3A%22done%22%2C%22percent%22%3A0%2C%22id%22%3A%22V3Fvd%22%2C%22card%22%3A%22file%22%7D)<a name="Wbkqq"></a>## 3.8 shuffle阶段数据的压缩机制<a name="0l6BD"></a>### 3.8.1 压缩算法数据压缩有两大好处,节约磁盘空间,加速数据在网络和磁盘上的传输!!<br />我们可以使⽤hadoop checknative 来查看我们编译之后的hadoop⽀持的各种压缩,如果出现 openssl为false,那么就在线安装⼀下依赖包!!```javayum install -y openssl-devel
| 压缩格式 | hadoop自带 | 算法 | 扩展名 | 是否可切分 | 换成压缩格式后,原来的程序是否需要修改 |
|---|---|---|---|---|---|
| DEFLATE | 是 | DEFLATE | .deflate | 否 | 不需要修改 |
| Gzip | 是 | DEFLATE | .gz | 否 | 不需要修改 |
| bzip2 | 是 | bzip2 | .bz2 | 是 | 不需要修改 |
| LZO | 需要安装 | LZO | .lzo | 是 | 需要建索引,还需要指定输入格式 |
| Snappy | 需要安装 | Snappy | .snappy | 否 | 不需要修改 |
常见压缩方式对比
| 压缩算法 | 压缩率 | 压缩速度 | 解压缩速度 |
|---|---|---|---|
| gzip | 21.6% | 17.5MB/s | 58MB/s |
| bzip2 | 13.2% | 2.4MB/s | 9.5MB/s |
| LZO-best | 24% | 4MB/s | 60.6MB/s |
| LZO | 34.9% | 49.3MB/s | 74.6MB/s |
3.8.2 压缩位置
- Map输入端压缩
此处使⽤压缩⽂件作为Map的输⼊数据,⽆需显示指定编解码方式,Hadoop会⾃动检查⽂件扩展名,如果压缩方式能够匹配,Hadoop就会选择合适的编解码⽅式对文件进⾏压缩和解压。
- Map输出端
Shuffle是Hadoop MR过程中资源消耗最多的阶段,如果有数据量过大造成网络传输速度缓慢,可以考虑使用压缩
- Reduce端输出压缩
输出的结果数据使用压缩能够减少存储的数据量,降低所需磁盘的空间,并且作为第⼆个MR的输入时可以复⽤压缩。
3.8.3 压缩配置方式
在驱动中通过Configuration直接设置使用的压缩方式,可以开启Map输出和Reduce输出压缩
// 设置map阶段压缩
Configuration configuration = new Configuration();
configuration.set("mapreduce.map.output.compress","true");
configuration.set("mapreduce.map.output.compress.codec","org.apache.hadoop.io.compress.SnappyCodec");
//设置reduce阶段的压缩
configuration.set("mapreduce.output.fileoutputformat.compress","true");
configuration.set("mapreduce.output.fileoutputformat.compress.type","RECORD");
configuration.set("mapreduce.output.fileoutputformat.compress.codec","org.apache.hadoop.io.compress.SnappyCodec");
配置mapred-site.xml(修改后分发到集群其它节点,重启hadoop集群),此种方式对运行在集群的所有MR任务都会执行压缩
<property>
 <name>mapreduce.output.fileoutputformat.compress</name>
 <value>true</value>
</property>
<property>
 <name>mapreduce.output.fileoutputformat.compress.type</name>
 <value>RECORD</value>
</property>
<property>
 <name>mapreduce.output.fileoutputformat.compress.codec</name>
 <value>org.apache.hadoop.io.compress.SnappyCodec</value>
</property>

若有收获,就点个赞吧
0 人点赞


